使用Elasticsearch和Jina进行AI视频搜索:精确找到你需要的素材秒数
原创
使用Elasticsearch和Jina进行AI视频搜索:精确找到你需要的素材秒数
原创
点火三周
发布于 2026-09-21 10:42:08
发布于 2026-09-21 10:42:08
输入 warm sunset light over a mountain,就能得到匹配的素材精确秒数。Omnishot 是一个 AI 视频搜索应用,它会监控一个文件夹,并在每个剪辑的场景边界处进行切割。它使用 jina-embeddings-v5-omni-small 将每个场景嵌入为一个 1024 维向量。同一个模型同时处理文本和视频,因此输入的文本查询和一段视频素材会落在同一个向量空间中,通过在 Elasticsearch 中进行最近邻搜索,找到与描述匹配的剪辑。一小时的视频素材大约变成 1200 个可搜索的向量,原本需要数小时才能完成摄入的文件夹,现在只需几分钟。
这个想法源自 Elastic 的一位视频编辑。她曾花费整个下午在 B-roll 文件夹中来回拖拽,只为找到某一个特定的画面。
按描述搜索素材库
该应用的主要功能如下:
- 选择一个素材文件夹。
- 通过视觉查询搜索剪辑(drone shot over a coastline)。
- 利用已存储的向量搜索相似剪辑。
- 在同一剪辑内查找相似片段。
- 在文件浏览器中显示该剪辑,随时可拖放到时间线上。
AI 视频搜索管道的工作原理
管道流程如下:
- 一个监控器每四秒轮询一次已关联的素材库文件夹(默认
clips/),检查是否有新素材。 - PySceneDetect 检测每个剪辑中的场景边界。
- FFmpeg 在这些边界处进行无损流复制切割,然后将每个场景片段转码为一个小型代理文件。
- 代理文件通过 Jina API 发送给 jina-embeddings-v5-omni-small,该模型采样 32 帧并返回一个 1024 维向量。
- 该向量被摄入到 Elasticsearch 的
dense_vector字段中,并附带一个层级可导航小世界(HNSW)索引(近似最近邻图)。在查询时,编辑器的文本经过同一模型,我们针对已存储的片段向量进行 k 近邻(kNN)搜索。
同一个模型同时嵌入文本和视频,这正是 Jina 全能模型如此多才多艺的原因。视频片段和文本查询被嵌入到同一个向量空间中,因此最近邻搜索实际上意味着:“找到看起来像我文本描述的那样素材。”
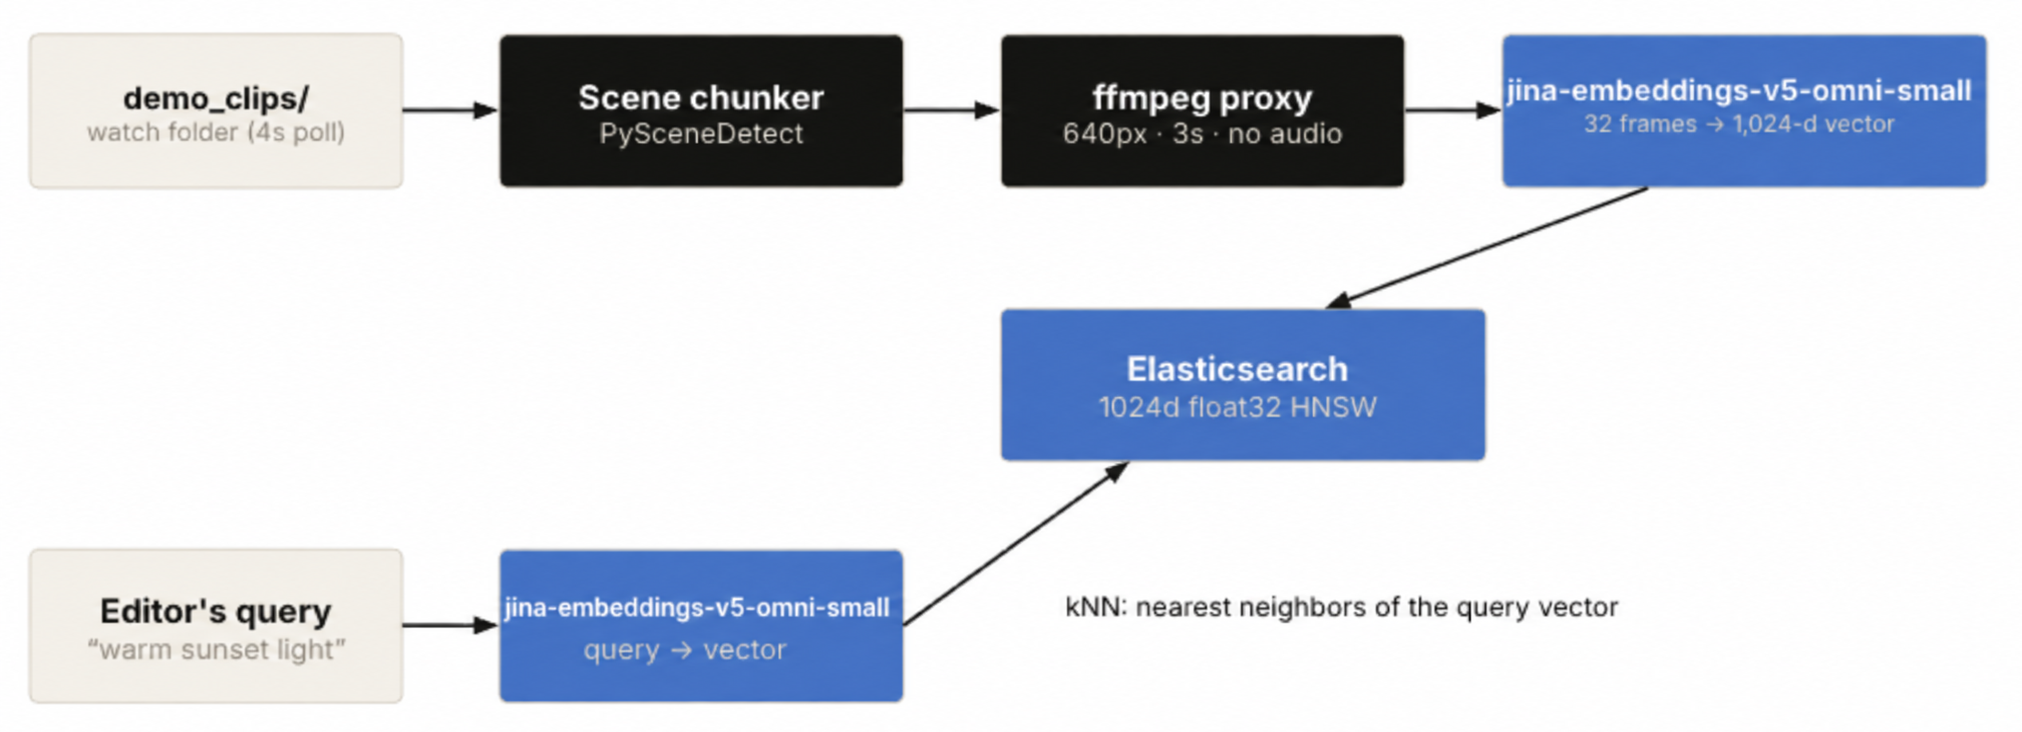
AI视频搜索管道:监控文件夹、PySceneDetect分块、ffmpeg代理、Jina嵌入、Elasticsearch kNN
构建 AI 视频搜索所需的条件
- Elasticsearch(Serverless 或 8.x+ 版本,支持稠密向量)
- Jina API 密钥
- PySceneDetect
- FFmpeg
- Python 3.9+
下载用于搜索的示例素材
如果你手头没有可供搜索的素材,仓库中包含两个下载脚本:一个用于从 Pexels API 下载短版权素材,涵盖自然、城市、动物等多个类别。另一个使用 yt-dlp 直接从 YouTube 获取较长的纪录片风格视频。
python scripts/download_pexels.py --out ./clips --total 50
python scripts/download_youtube.py --out ./clips --total 20
我们的目标是让短片和长片有一个良好的混合,以展示分块策略的重要性。这将在下一部分讨论。
如何为嵌入对视频进行分块
jina-embeddings-v5-omni-small 会从你发送的任何视频中均匀采样 32 帧。对于一个 10 秒的剪辑,32 帧是密集覆盖;几乎每一刻都能被捕捉到。对于一个 10 分钟的纪录片,同样的 32 帧被分散得太开,可能导致整个镜头被遗漏。下图展示了 Jina 模型如何采样每个视频剪辑以及长剪辑的局限性:
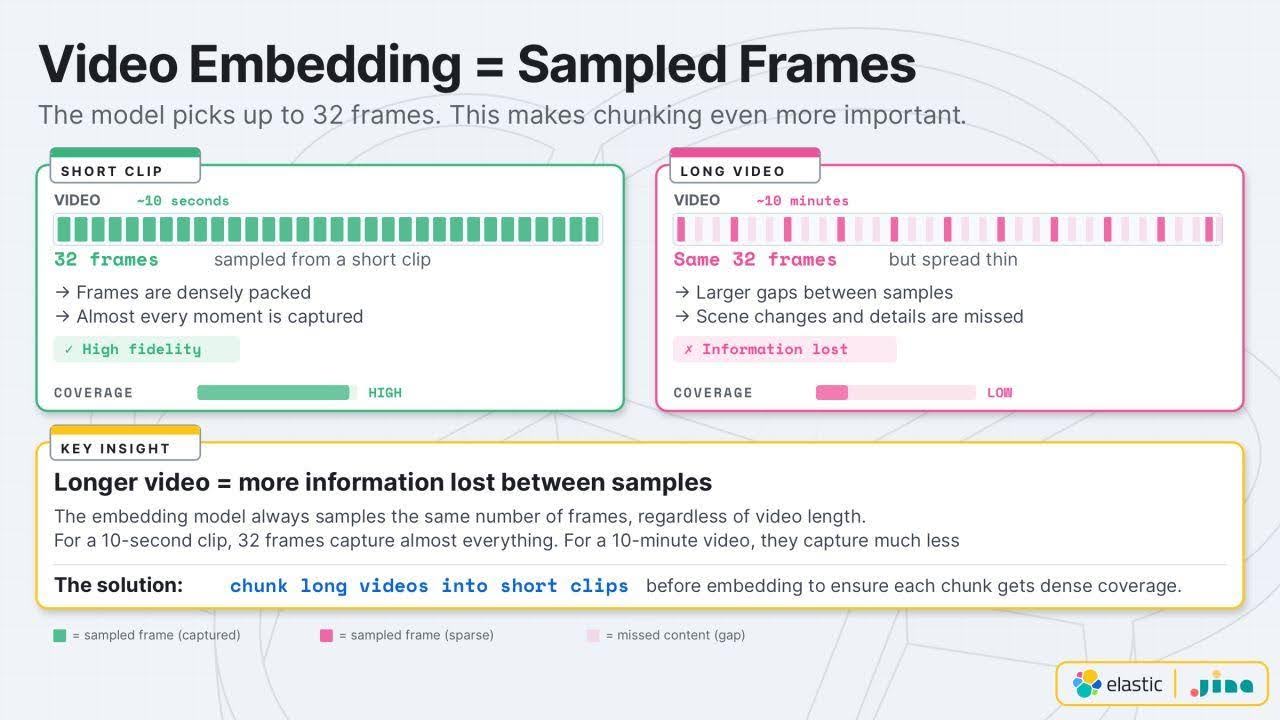
为什么需要对视频进行分块以进行嵌入:32 帧采样密集覆盖 10 秒剪辑,但在 10 分钟视频中会错过镜头
因此,在嵌入之前,我们首先进行分块。问题在于在哪里切割。下面是三种策略的对比图:
- 固定长度分块:按每 N 秒分割。简单且可预测,但切割点可能落在镜头中间。你最终可能得到一个半无人机镜头半人物访谈的片段,这会使搜索结果无法使用。这不适用于本场景。
- 基于转录的分块:首先对剪辑运行语音转文本以生成转录,然后对其应用文本分块技术,在主题边界处分割,并将这些边界映射回视频中的时间戳。这种策略非常适合播客、演讲和教育内容,但不适用于 B-roll,因为它通常没有对话。
- 基于场景的分块:在视觉变化处(如镜头切换、过渡和剪辑)进行分割。每个片段对应一个特定的视觉画面,这正是视频编辑要搜索的。这是我们用例的最佳选择。
三种策略并列对比:
策略 | 切割方式 | 最佳适用场景 | 弱点 |
|---|---|---|---|
固定长度 | 每 N 秒 | 均匀内容,可预测成本 | 切割点落在镜头中间,产生混合片段 |
基于转录 | 在语音转文本输出的主题边界处 | 播客、演讲、教育视频 | 对无对话的 B-roll 无效 |
基于场景 | 在视觉切换和过渡处 | B-roll 和素材库 | 依赖可靠的镜头检测 |
使用 PySceneDetect 检测场景边界
为了实现这一点,我们使用 PySceneDetect 找到切割点:
from scenedetect import AdaptiveDetector, detect

scenes = detect(str(video_path),
    AdaptiveDetector(
        adaptive_threshold=3.0,
        min_scene_len=int(min_scene_len_sec * 24),
    ),
)
AdaptiveDetector 将每一帧的变化与滚动平均值进行比较,从而避免将相机平移和手持抖动误判为切割。最小场景长度默认为 1.5 秒,在假设帧率为 24 fps 的情况下,相当于 36 帧,这样快速切换就不会产生小于一秒的碎屑。如果根本没有检测到边界,整个剪辑将作为一个单独的片段。然后,每个检测到的场景通过无损 FFmpeg 流复制(-c copy)被切割成各自的片段文件,因此在代理步骤之前不会进行重新编码。
这样一来,采样的 32 帧覆盖的是几秒内的一个特定视觉场景,而不是跨剪辑粗略扫描。
为什么发送 640 像素的代理文件而不是原始文件?
我们不会将原始的完整尺寸文件发送到嵌入 API。一个 4K ProRes 片段可能达到数百兆字节,而模型无论如何也用不到那么高的分辨率。它的视觉编码器大致每 28x28 像素块产生一个 token,并且 模型的默认配置 将每帧限制在 1280 个视觉 token(约 1 兆像素)。任何更大的内容在编码前都会被缩小以适应该预算,因此 4K 帧到达模型时大约只剩下八分之一的像素。上传全分辨率素材只会浪费带宽和时间,因为分辨率根本用不上。关于模型如何将帧转换为补丁 token 的更深入分析,请参见 我们的 jina-embeddings-v5-omni 架构深度解析。
相反,FFmpeg 将每个场景片段转码为一个轻量级代理文件:640 像素宽、去掉音频、使用较高压缩级别。
import base64
import subprocess
import tempfile
from pathlib import Path

def make_video_input(
    chunk_path: Path,
    max_width: int = 640,
    crf: int = 28,
    max_seconds: float = 3.0,
) -> dict:
    """Return a Jina video input dict with a short 640px proxy as base64."""
    with tempfile.NamedTemporaryFile(suffix=".mp4", delete=False) as tmp:
        proxy_path = tmp.name
    try:
        subprocess.run(
            [
                "ffmpeg", "-y", "-loglevel", "error",
                "-i", str(chunk_path),
                "-t", str(max_seconds),
                "-vf",
                f"scale='if(gt(iw,ih),{max_width},-2)':'if(gt(iw,ih),-2,{max_width})'",
                "-c:v", "libx264", "-crf", str(crf), "-preset", "veryfast",
                "-an",  # drop audio, the model never hears it
                "-movflags", "+faststart",
                proxy_path,
            ],
            check=True,
        )
        data = base64.b64encode(Path(proxy_path).read_bytes()).decode("ascii")
    finally:
        Path(proxy_path).unlink(missing_ok=True)
    return {"video": data}
让我们仔细看看函数中两个容易忽略的部分。缩放滤镜检查方向 gt(iw,ih),因此横向剪辑最大宽度为 640 像素,纵向剪辑最大高度为 640 像素,而不是被压缩变形。而 max_seconds 将每个代理文件限制在 3 秒以内。这是因为每个片段只有一个视觉画面,所以前几秒已经是一个很好的代表,而在 3 秒内采样 32 帧已经是密集覆盖。该函数返回 {"video": <base64>},这是 Jina API 期待的输入格式。
质量损失在一定范围内并不重要。嵌入 关心的是帧中的内容,而不是素材是否足够高清用于最终交付。但如果你压缩得过于激进,视觉细节开始消失,模型可能就无法可靠地分辨每一帧中的内容。目标是在不丢失重要视觉信息的前提下缩小文件。代理文件最终只有几百千字节,而不是几百兆字节,因此摄入一个素材文件夹从数小时缩短为几分钟。
每个代理文件随后以 base64 字符串的形式发送到 Jina API,API 返回该片段的 1024 维向量:
resp = requests.post(
    "https://api.jina.ai/v1/embeddings",
    headers={"Authorization": f"Bearer {JINA_API_KEY}"},
    json={
        "model": "jina-embeddings-v5-omni-small",
        "task": "retrieval.passage",
        "dimensions": 1024,
        "embedding_type": "float",
        "normalized": True,
        "input": [make_video_input(chunk_path)],  # {"video": "<base64>"}
    },
)
embedding = resp.json()["data"][0]["embedding"]  # 1024 floats
这里的 task 参数很重要。片段使用 task="retrieval.passage" 进行索引,而在搜索时,查询文本使用 task="retrieval.query" 进行嵌入。模型会为检索生成非对称嵌入,一侧用于文档,一侧用于查询。
我们还将 dimensions 固定为 1024,并将 normalized 设置为 true。归一化对于余弦相似度并非必需,因为余弦衡量的是向量之间的角度,长度永远不会影响分数。它的作用是让每个向量都变成单位长度,对于单位向量,点积等于余弦,因此引擎可以跳过幅值计算,直接用点积比较向量。
使用 Elasticsearch,你可以利用归一化向量,将字段映射为 similarity: "dot_product" 而不是余弦,从而跳过查询时的归一化开销。不过仓库中为了安全起见仍使用余弦,因为即使有非归一化向量混入,它也能正常工作。
在仓库中,这个请求存在于一个小型客户端类(backend/lib/embed_jina.py)中,该类还会在遇到速率限制和临时服务器错误时进行指数退避重试。获取到向量后,我们可以将它们摄入到 Elasticsearch 中。
将视频嵌入摄入到 Elasticsearch 中
首先,我们定义一个显式映射。Elasticsearch 可以在索引时动态推断字段类型,这意味着第一个到达的文档可以决定字段的映射方式。但这里我们希望明确指定:ID 应为 keyword;视频内时间戳(如 start_sec 和 end_sec)应为 float;最重要的是,嵌入字段需要配置为 1024 维的 dense_vector,使用余弦相似度和 HNSW 索引。
以下是该索引的映射:
mappings = {
    "properties": {
        "chunk_id": {"type": "keyword"},
        "clip_id": {"type": "keyword"},
        "path": {"type": "keyword", "index": False},
        "start_sec": {"type": "float"},
        "end_sec": {"type": "float"},
        "duration": {"type": "float"},
        "strategy": {"type": "keyword"},
        "uploaded_at": {"type": "date"},
        "uploader": {"type": "keyword"},
        "tags": {"type": "keyword"},
        "transcript": {"type": "text", "analyzer": "english"},
        "embedding": {
            "type": "dense_vector",
            "dims": 1024,
            "index": True,
            "similarity": "cosine",
            "index_options": {"type": "hnsw"},
        },
    },
}
几点说明:
dims为 1024 以匹配模型输出。similarity使用余弦,因为 Jina 嵌入是为余弦距离训练的;如前所述,dot_product在归一化向量上得分相同且速度略快,但为了安全起见我们保留余弦。index: True配合 HNSW 会在索引时构建一个近似最近邻图,因此查询时不会暴力搜索所有向量。start_sec/end_sec使我们能够直接将编辑器跳转到剪辑中的正确时刻,而不仅仅是正确的文件。- 其余字段是纯元数据:
path被存储但不可搜索("index": False),以便应用可以播放片段文件;duration和strategy描述片段的生成方式;tags/transcript为未来的关键词和转录搜索预留空间。
这意味着一个文档对应一个场景片段,而不是一个剪辑。一个 10 分钟的纪录片可能变成 80 个文档。关键在于每个文档都可以独立被找到。注意,Elasticsearch 中并不存储视频本身。一个文档只是向量加上几个元数据字段,包括指向磁盘上片段文件的 path。素材保留在原处,Elasticsearch 纯粹作为索引,告诉我们哪个文件以及其中的哪些秒数与查询匹配。
该应用针对本地文件夹运行,因此 path 是文件系统路径。如果你要构建一个托管服务,剪辑应该存放在对象存储(如 Amazon S3 或 Google Cloud Storage)中,该字段将保存存储中的对象指针,但架构保持不变。
对视频片段进行向量搜索
在查询时,编辑器的文本经过同一模型。Warm sunset light 变成一个 1024 维向量,与视频片段处于同一空间,然后我们向 Elasticsearch 请求其最近邻:
res = es.search(
    index="broll",
    knn={
        "field": "embedding",
        "query_vector": query_vector,
        "k": 50,
        "num_candidates": 100,
    },
    size=50,
    source_excludes=["embedding"],
)
hits = [{**h["_source"], "_score": h["_score"]} for h in res["hits"]["hits"]]
k 是返回的近邻数量;num_candidates 是每个分片在进行排名前考虑的候选数。更高的候选数意味着更好的召回率,但延迟略高。我们还在响应中排除了 embedding 字段,因为每个命中携带 1000 个浮点数会大大增加数据量,而 UI 根本不需要读取该字段。我们获取的数量多于显示的数量(50 个用于九宫格卡片),因为接下来还有操作。
“查找相似剪辑”的工作方式相同,只是查询向量是已存储的片段嵌入,而不是嵌入的文本。无需第二次模型调用;该向量已在索引中。
对同一剪辑的结果去重
我遇到的一个问题是:同一剪辑的太多片段填满了整个结果网格。搜索 mountains 时,一个 10 分钟的自然纪录片可能匹配十几个片段,将所有其他剪辑挤出顶部结果。这在技术上是正确的,但对于想要多种选择的编辑来说几乎没有实际用处。
解决方案是:保留每个剪辑中得分最高的片段作为结果卡片的代表,并允许用户展开卡片查看同一剪辑中的其他匹配片段:
def _hits_payload(hits, exclude_id: str | None = None, k: int = 9):
    """One card per clip (best chunk first), counting matched sibling scenes."""
    out = []
    cards_by_clip = {}
    for h in hits:  # hits arrive sorted by score
        if h["chunk_id"] == exclude_id:
            continue
        clip_id = h["clip_id"]
        card = cards_by_clip.get(clip_id)
        if card is None:
            card = {**_chunk_payload(h), "more_matches": 0}
            cards_by_clip[clip_id] = card
            out.append(card)
        else:
            # A lower-ranked scene from a clip we already show.
            card["more_matches"] += 1
    return out[:k]
这就是为什么我们要在查询时获取更多数据。拉取 50 个命中,折叠为每个剪辑一张卡片,然后显示 9 张。exclude_id 用于处理“查找相似”的情况,否则种子片段会作为自身的顶级命中返回。_chunk_payload 只是将每个命中精简为 UI 需要的字段。more_matches 计数会成为 UI 中的“+4 更多来自该剪辑”徽章。展开该徽章不会再次调用嵌入 API;应用会缓存最近的查询向量,并使用 clip_id 上的 term 过滤器重新运行仅针对该剪辑的 kNN 搜索。
结论:场景分块在规模上的成本
这就是完整的设置流程:从监控文件夹、在场景边界处切割、嵌入代理文件、索引向量,最后用自然语言进行搜索。编辑输入他们需要的视觉画面,素材就会带着时间戳和快速获取实际剪辑的方式呈现在他们面前。
这个索引中的每个向量都是 1024 个 float32 值,每个约 4 KB。即使是演示场景,数量也不大。我们的 70 个剪辑文件夹产生几百个片段,向量占几兆字节。但场景分块会迅速放大。按每个场景约 3 秒计算,一小时的素材已经是约 1200 个向量,因此一个 1000 小时的存档就超过一百万个向量和数 GB 的浮点数,而一个大型素材库可能达到数亿个向量,索引规模可达 TB 级。由于 HNSW 需要将这些向量驻留在内存中才能快速搜索,成本会迅速上升。在本系列的第 2 部分中,我们将研究 量化 与降维 —— 两种截然不同的缩小索引的方法,以及每种方法在召回率上的代价。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号