Agent运行机制拆解:上下文、检查点、任务恢复以及循环执行、资源管控完整流程23.3
原创
Agent运行机制拆解:上下文、检查点、任务恢复以及循环执行、资源管控完整流程23.3
原创
未闻花名
发布于 2026-09-22 12:35:20
发布于 2026-09-22 12:35:20
一、前言
我们很多人都用过AI智能体,却始终搞不懂它到底是怎么自主干活的。为什么Agent能连续完成多步骤任务、中途暂停后能无缝续跑、出错了还能自动重试,甚至需要人工介入时会及时叫停?其实所有智能Agent的自主工作能力,核心都依托一套标准化的执行循环和运行机制。
不同于单次问答的大模型对话,Agent的核心价值是“自主迭代、持续执行、可控可兜底”。它不是一次性输出答案,而是通过循环感知状态、调用工具、校验结果、保存进度,一步步拆解复杂任务,直到完成目标。
二、Agent执行循环
1. 循环核心逻辑
Agent的所有智能行为,都建立在闭环执行循环之上,这是它区别于普通大模型对话的核心。普通LLM对话是“输入prompt-输出结果”的单次线性流程,而Agent是“感知-思考-行动-反馈-更新”的无限迭代闭环,直到满足终止条件才会停止。
整套循环可以拆解为五个固定步骤,全程自动迭代、无需人工持续干预:
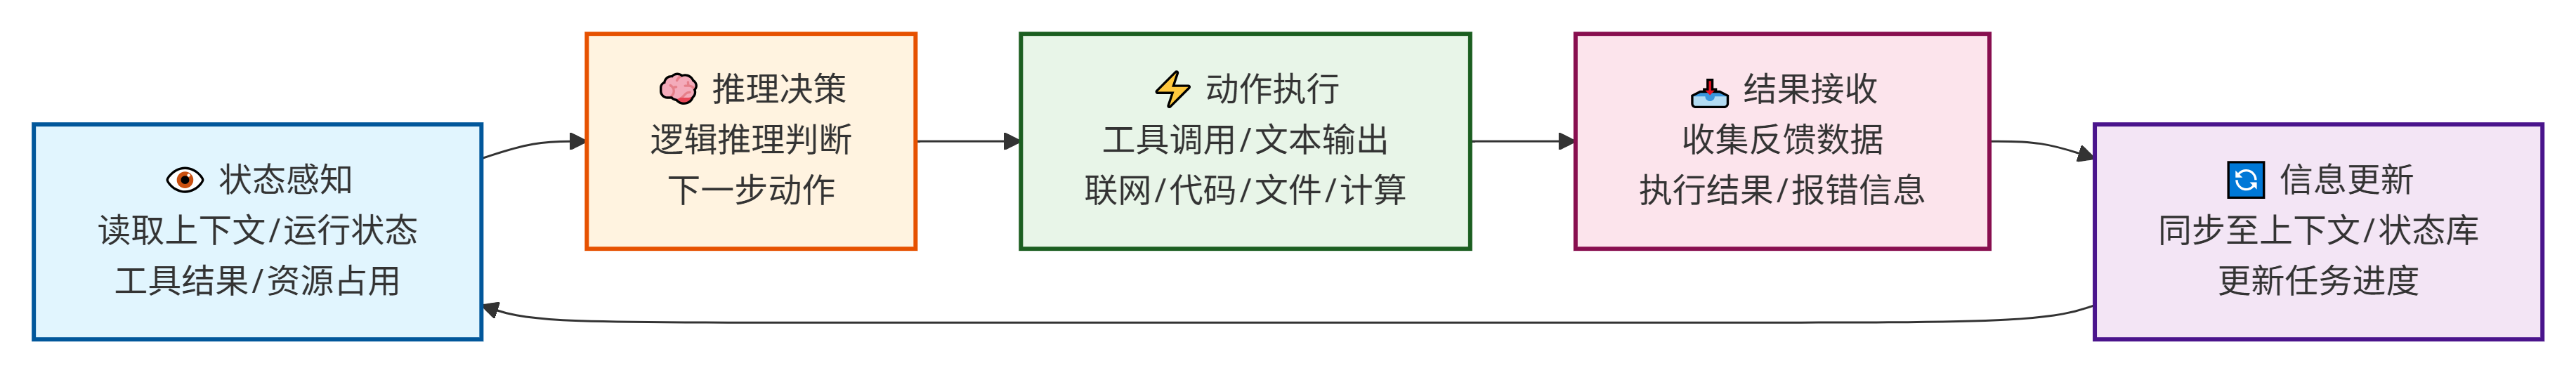
- 状态感知:Agent实时读取当前任务上下文、自身运行状态、工具返回结果、系统资源占用情况,梳理当前任务进度和待解决问题,明确当前所处执行阶段。
- 推理决策:大模型基于感知到的全部信息,进行逻辑推理,判断下一步需要执行的动作,包括继续文本推理、调用工具、修改任务策略、暂停任务等。
- 动作执行:根据决策结果落地具体操作,比如联网搜索、代码运行、文件读写、数据计算、对话回复等各类工具行为或文本输出行为。
- 结果接收:收集工具执行后的反馈数据、任务执行结果、报错信息等全部内容,整合为最新的任务信息。
- 信息更新:将新结果、新状态同步至上下文和状态库,更新任务进度,随后进入下一轮循环,重新感知、推理、执行。
这套循环的核心优势主要体现在两点:
- 容错性强:执行过程中遇到局部报错、工具异常不会直接崩盘,可通过重试、策略调整继续推进任务。
- 连续性高:能够承接上一轮执行结果,自主拆分子任务、逐轮迭代,适配数据分析、文案策划、自动化办公等复杂多步骤任务,不会因步骤繁多出现逻辑中断。
2. 循环运行特性
为了适配各类落地场景,Agent执行循环具备三个关键特性,也是保障其稳定运行的基础:
- 迭代可控:循环不是无限运行,每一轮迭代都会触发条件校验,满足停止条件后立即终止,避免无效资源消耗。
- 状态可追溯:每一轮循环的输入、决策、执行结果都会被记录,全程可追溯、可复盘,方便排查问题和优化任务流程。
- 动态自适应:会根据工具反馈、任务进度动态调整决策逻辑,遇到报错自动重试,遇到瓶颈自动调整执行策略,无需人工干预。
简单来说,Agent执行循环复刻了人类处理复杂工作的完整逻辑,可分为四个连贯环节:
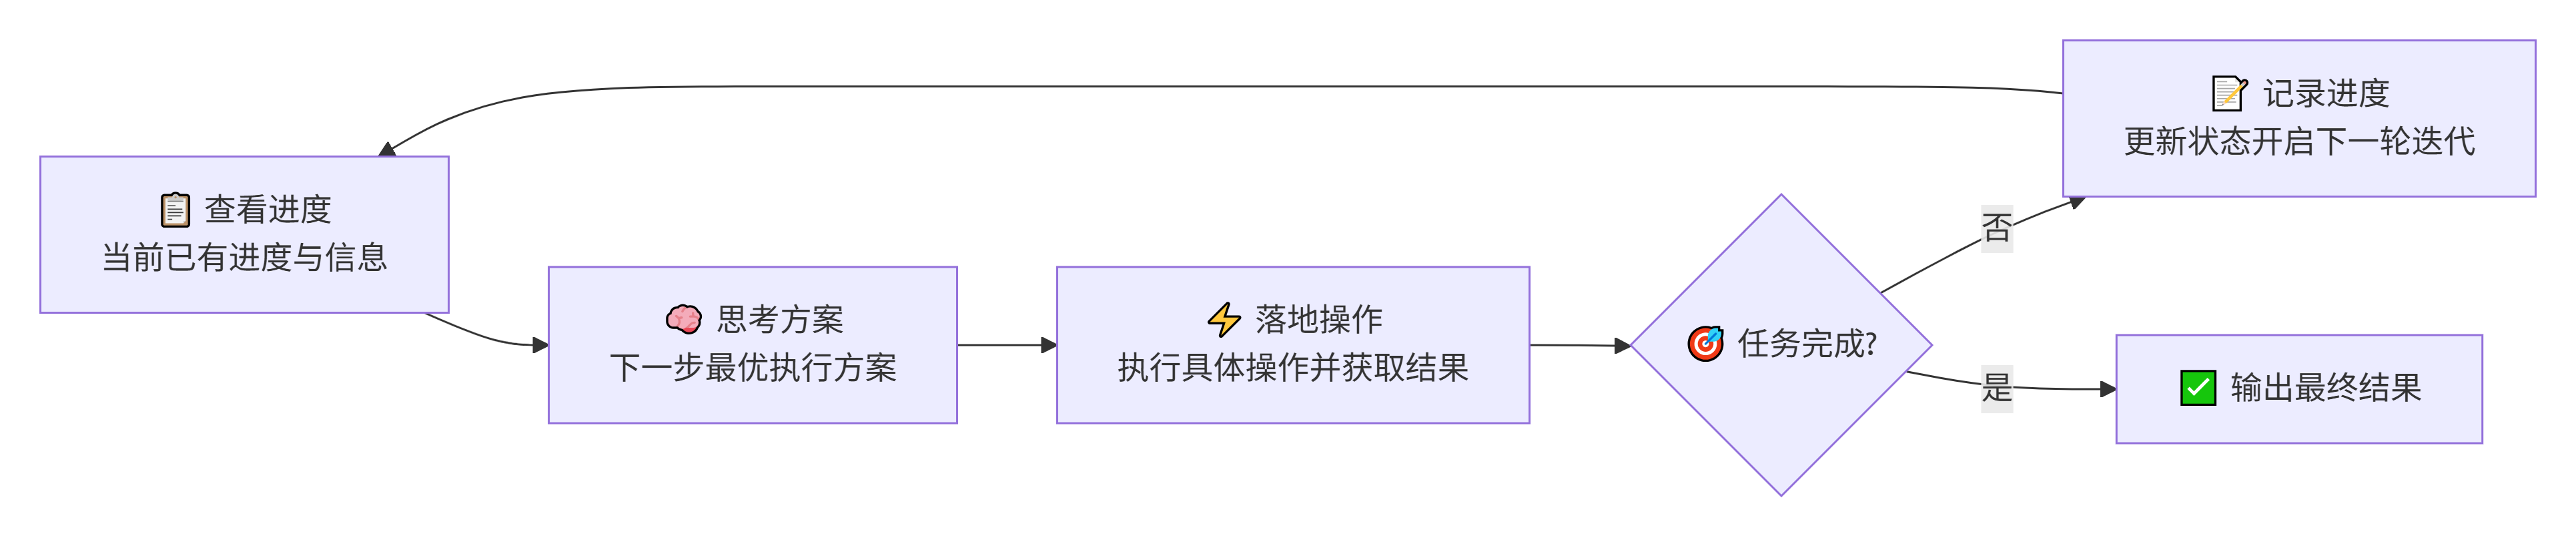
- 查看当前已有进度与信息
- 思考下一步最优执行方案
- 落地具体操作并获取结果
- 记录进度并开启下一轮迭代,直至任务完成
简单来说,Agent执行循环就像人类完成复杂工作的过程:先看当前进度、思考下一步怎么做、动手执行、查看结果、记录进度,再继续下一步,直到做完为止,完美复刻了人类的迭代工作逻辑。
三、上下文机制
1. 上下文核心作用
上下文是Agent的“记忆系统”,是整个执行循环的信息载体,所有核心运行数据均依托上下文存储流转,其核心作用主要体现在两点:
- 承载全量任务信息:状态数据、对话记录、工具结果、任务进度、历史决策等所有运行信息,都会统一存储在上下文中,为每一轮循环的推理决策提供完整依据。
- 保障任务连续性:没有上下文,Agent的每一轮执行都会是孤立的单次操作,无法承接历史逻辑、完成连续的复杂任务。
日常使用中常见的Agent“忘事、重复操作、逻辑断层”问题,根源均为上下文管理失效。完善的上下文机制,能够全程保障Agent连贯理解任务、延续执行逻辑、衔接历史操作,确保复杂任务稳步推进。
2. 上下文核心组成
完整的Agent上下文并非单纯的对话记录,而是结构化的多维数据集合,主要包含四大核心模块,各司其职、相互配合:
- 任务基线信息:包含初始用户指令、任务核心目标、任务约束条件、执行规则,是Agent全程遵循的核心基准,不会随迭代更新而改变。
- 历史交互记录:记录每一轮的用户输入、模型推理内容、工具调用指令、工具返回结果,完整还原每一步执行细节。
- 进度状态数据:记录已完成子任务、待执行子任务、任务完成占比、当前执行节点,让Agent清晰掌握任务整体进度。
- 临时变量数据:存储工具执行产生的临时数据、计算结果、缓存信息,供后续循环迭代调用,避免重复计算、重复调用工具。
3. 上下文更新与优化
在每一轮Agent循环结束后,系统会自动完成上下文更新,新增本轮的执行数据、结果和进度状态。但上下文并非无限叠加,无限制的信息累积会引发两大核心问题:
- 超出大模型上下文窗口,直接触发运行报错、任务中断;
- 冗余信息过多,干扰模型推理精度,大幅降低任务执行效率。
因此落地场景中,都会配套成熟的上下文优化策略,主流方式分为三种:
- 摘要压缩:对早期冗余的历史记录进行摘要提炼,保留核心关键信息,删除无效细节,精简上下文体量。
- 滑动窗口:只保留最近N轮的完整执行记录,超出窗口的历史内容以摘要形式存储,平衡连贯性和数据体量。
- 关键信息固化:将任务目标、核心约束、重要结果等关键信息固定在上下文头部,全程不被压缩、不被删除,保障核心逻辑不丢失。
四、状态管理机制
1. 状态与上下文区别
很多人会混淆上下文和状态,其实二者分工明确、相辅相成,核心区别可清晰区分:
- 上下文:偏向全量数据存储,是任务从启动到当前的完整台账,包含所有历史记录、数据、进度信息。
- 状态:偏向实时快照标识,是对当下运行情况的精准定义,无需解析全部数据即可识别任务状态。
状态的核心作用主要有两点:
- 让系统和用户一秒识别Agent当前运行情况,无需解析全部上下文;
- 快速判断任务是否正常、是否需要干预、是否可以继续执行,保障循环稳定可控。
2. 五大核心运行状态
Agent全程所有运行场景,都可以归纳为五种标准化状态,每一种状态对应不同的循环执行逻辑,覆盖全运行周期:
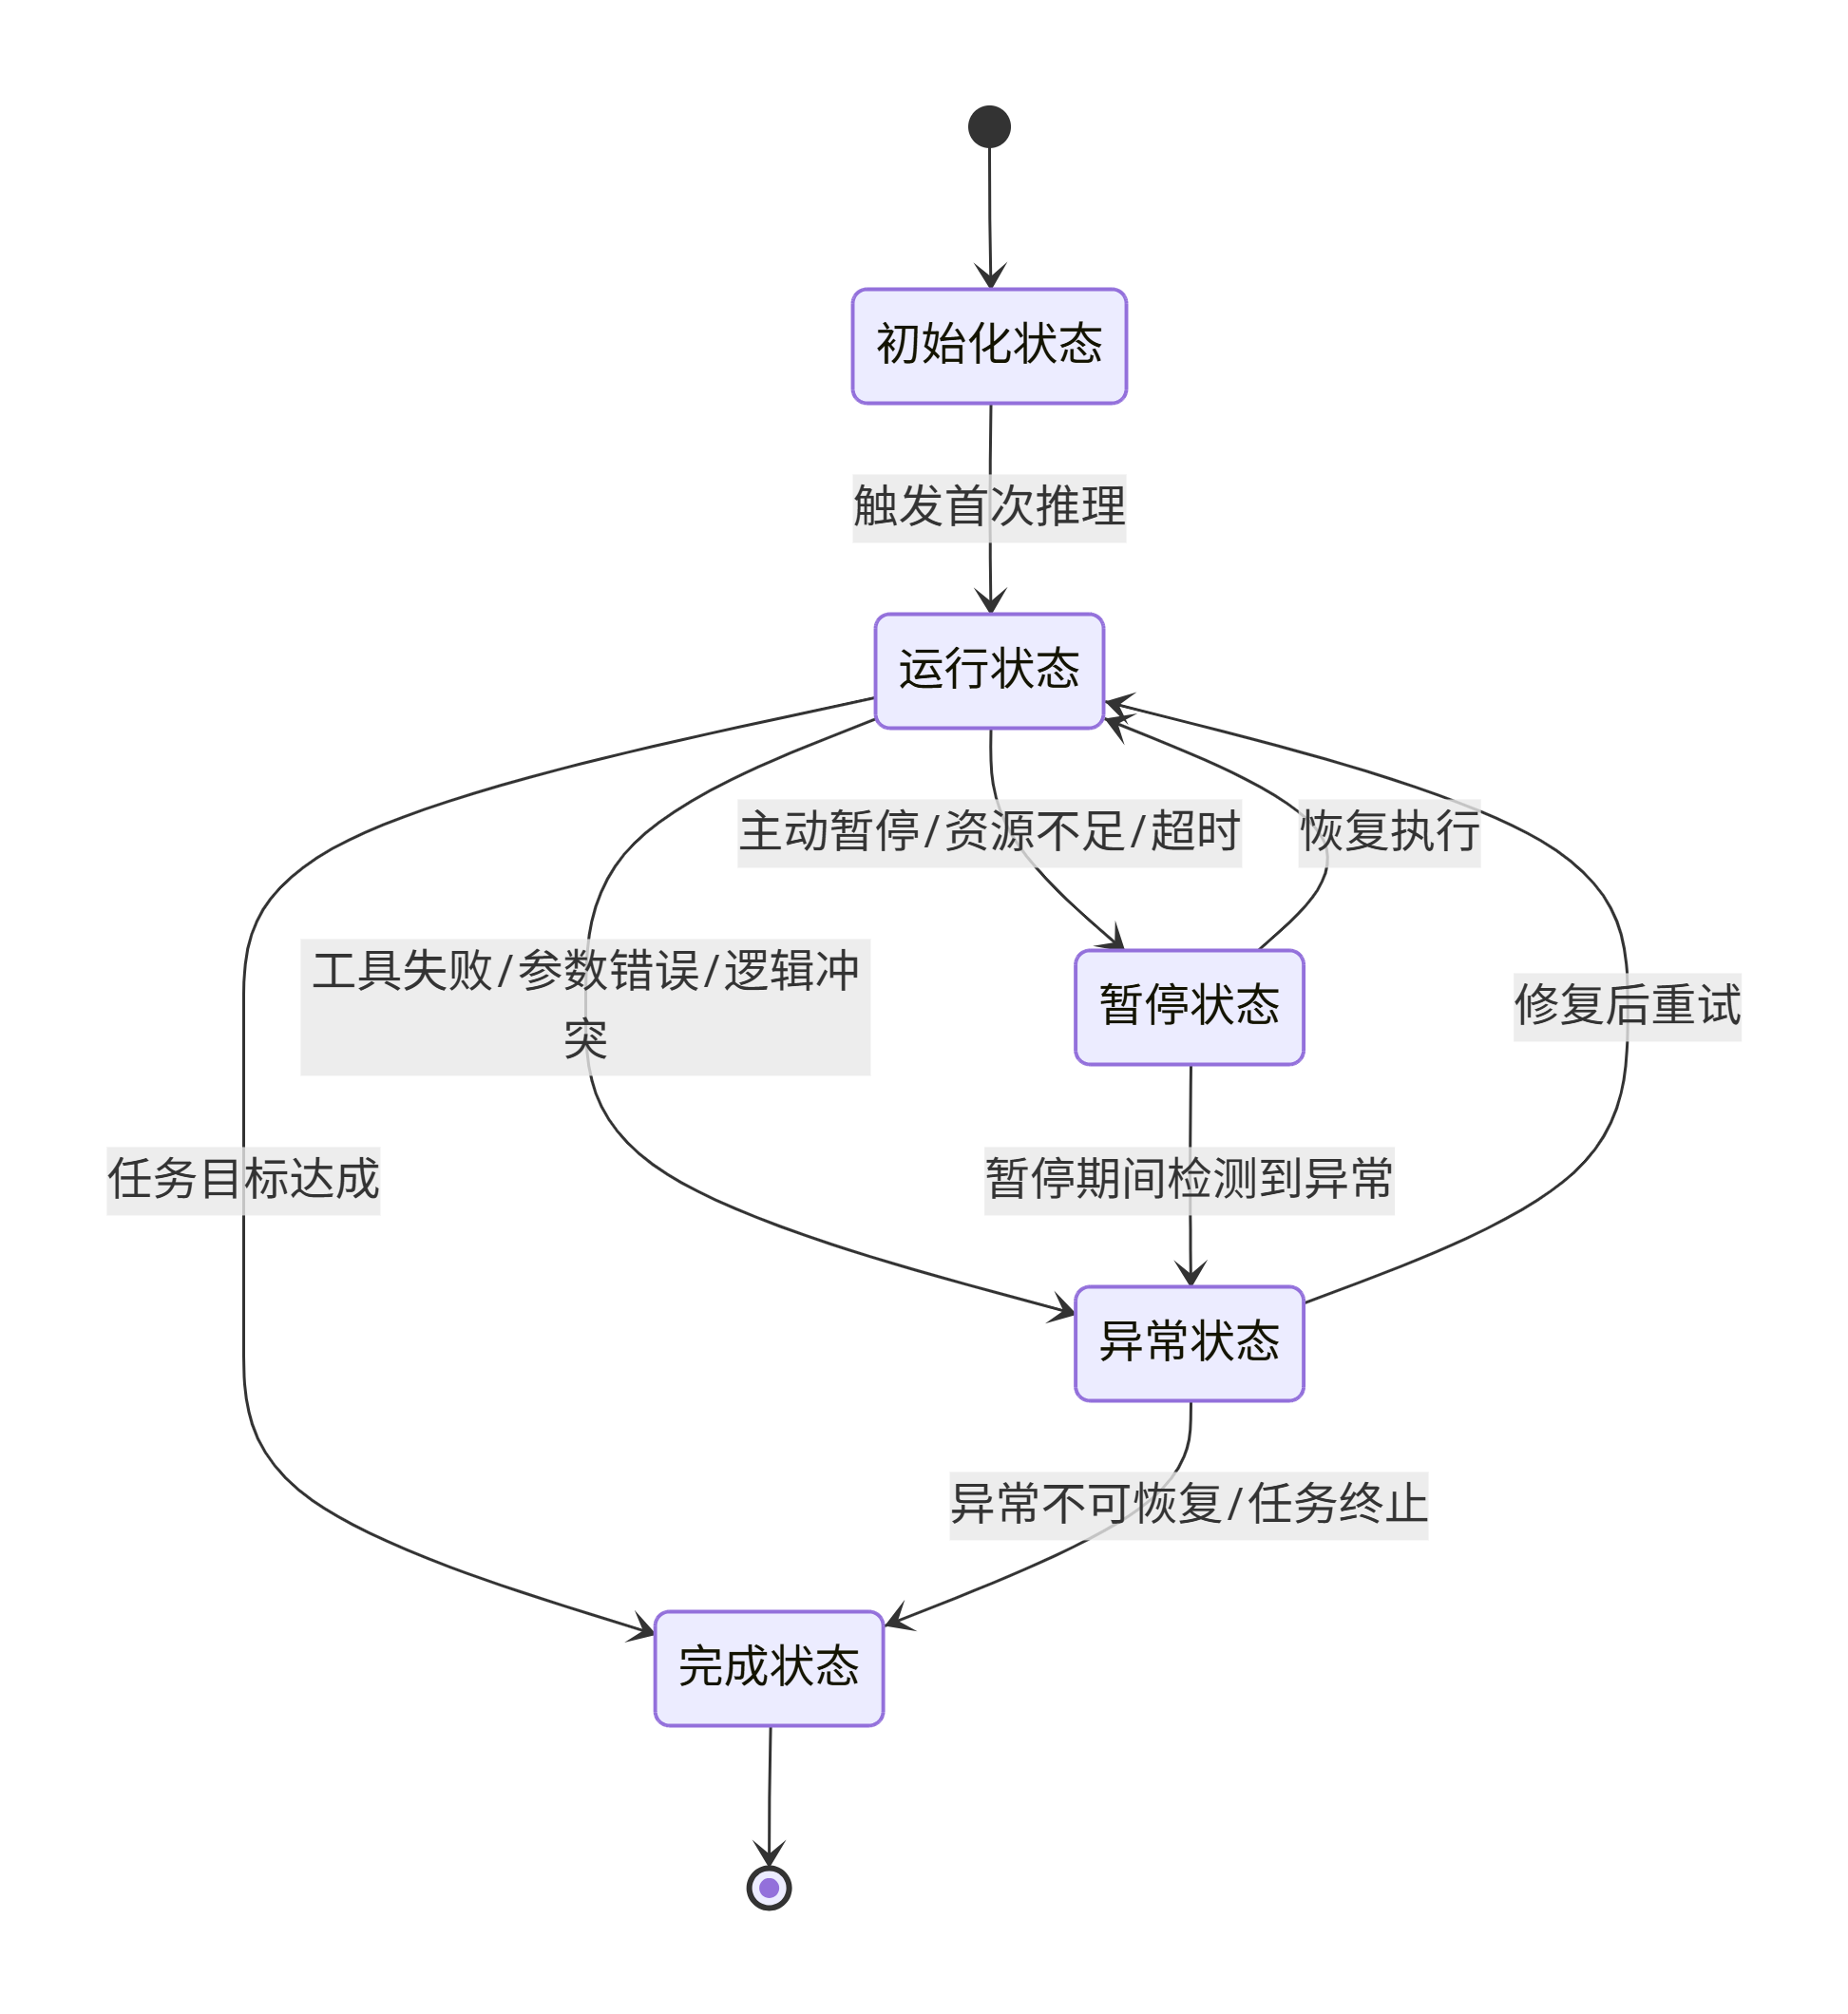
- 初始化状态:任务刚启动,系统完成上下文加载、参数初始化、工具权限校验,尚未进入第一轮循环,等待触发首次推理执行。
- 运行状态:Agent正常迭代循环,持续完成推理、执行、工具调用、结果更新,是最常见的工作状态。
- 暂停状态:主动触发暂停、资源不足、工具超时等场景触发被动暂停,循环暂时终止,完整保留当前状态和上下文,等待恢复指令。
- 异常状态:工具调用失败、参数错误、逻辑冲突、资源超限等问题触发异常,循环停止迭代,记录异常日志,等待重试或人工接管。
- 完成状态:任务目标全部达成,满足停止条件,终止执行循环,固化最终结果,结束任务流程。
3. 状态流转规则
所有状态都遵循固定的流转逻辑,不会随意切换,保障任务运行的稳定性,核心流转规则如下:
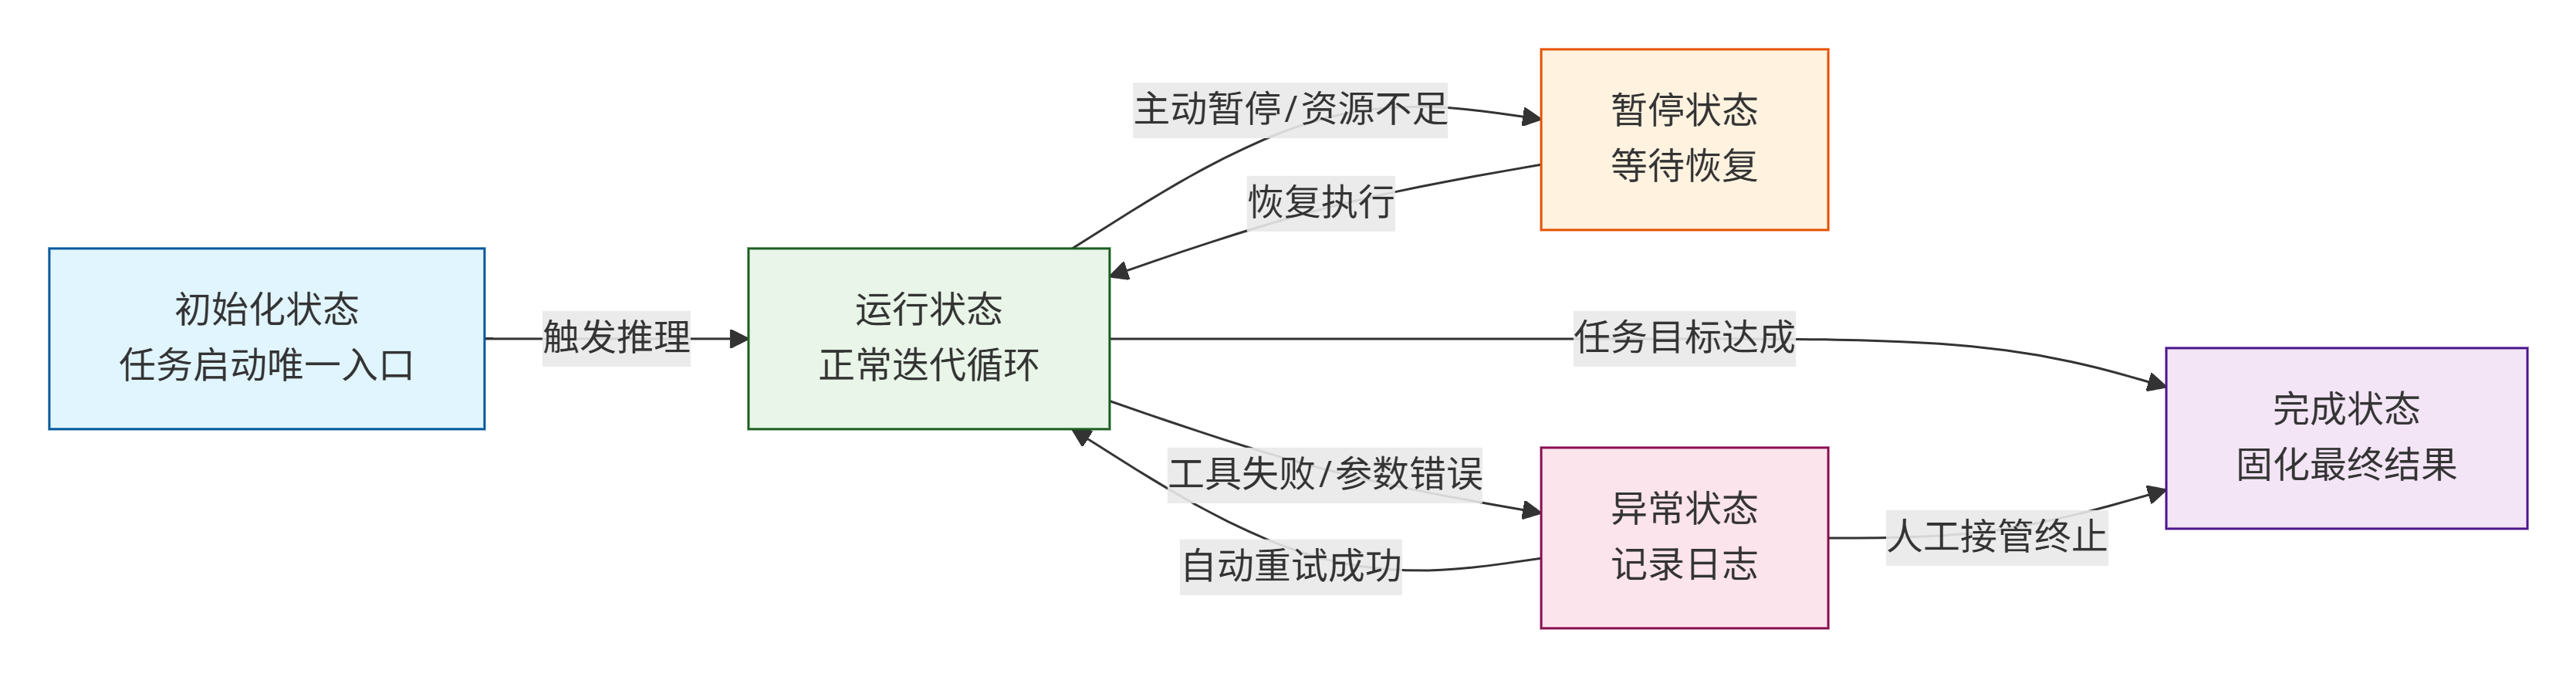
- 初始化状态:仅可切换为运行状态,是任务启动的唯一入口;
- 运行状态:可根据场景切换为暂停、异常、完成三种状态;
- 暂停状态:恢复后直接回归运行状态,接续任务迭代;
- 异常状态:自动重试成功则回归运行状态,重试失败可人工接管终止任务。
标准化的状态流转,让Agent的运行全程可管控、可预判,避免状态混乱导致的任务异常。
五、工具反馈机制
1. 工具反馈核心价值
大模型本身只具备文本推理能力,无法完成联网、计算、读写、操作设备等实操行为,Agent的强大之处,就是通过工具调用拓展能力边界。工具反馈的核心价值主要有两点:
- 衔接推理与实操:是连接模型推理和实操动作的唯一桥梁,让纯文本推理落地为具体可执行的业务动作;
- 驱动任务迭代:是Agent循环迭代的核心数据源,直接决定Agent的下一轮决策,是任务推进的核心依据。
2. 反馈全流程拆解
完整的工具反馈流程深度嵌入Agent执行循环,环环相扣、全程闭环,分为四个核心步骤:
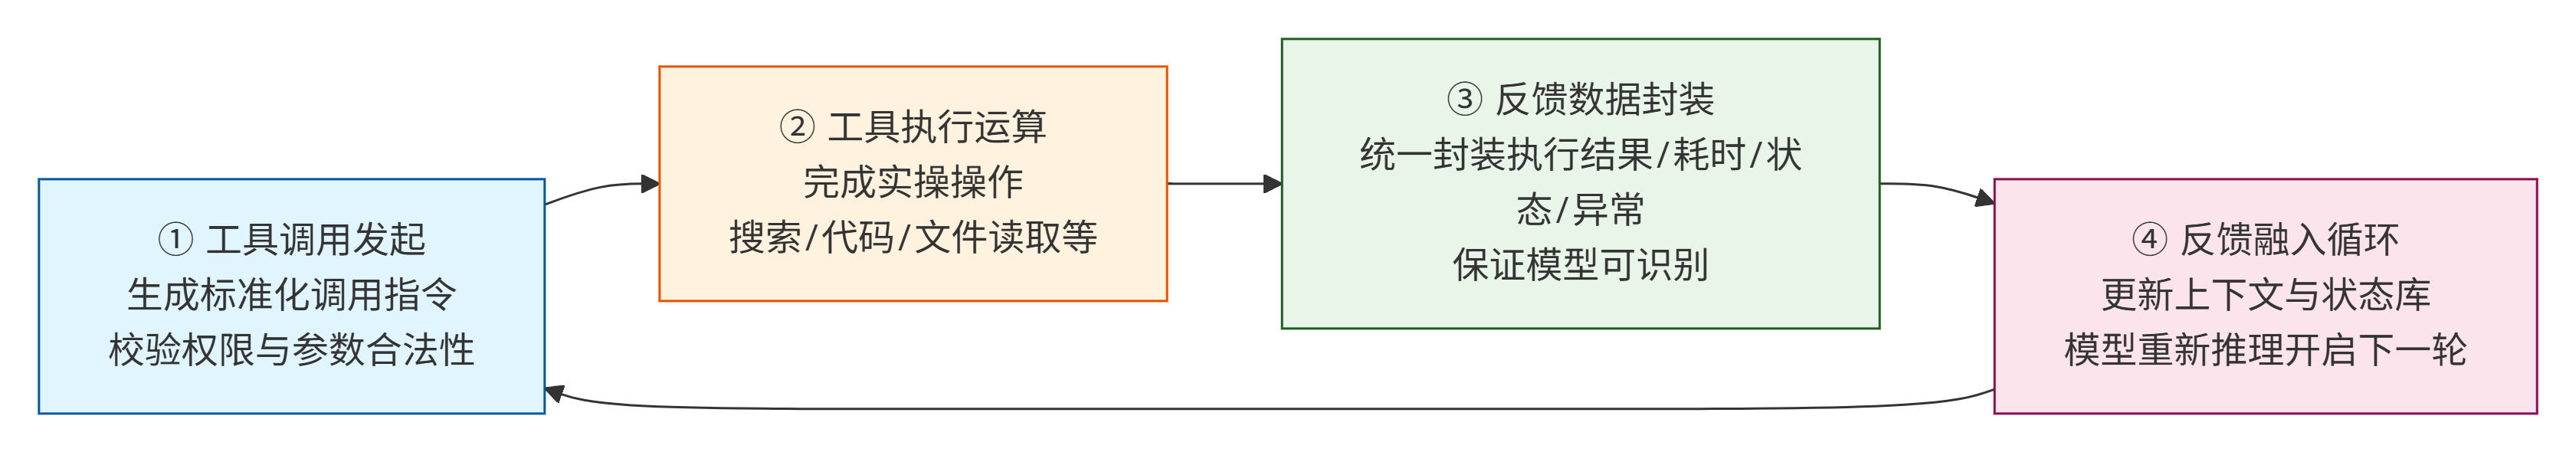
- 工具调用发起:模型推理后生成标准化工具调用指令,包含工具类型、入参、执行规则,系统校验权限和参数合法性后,发起调用。
- 工具执行运算:对应工具完成实操操作,比如搜索数据、运行代码、读取文件等,生成执行结果或报错信息。
- 反馈数据封装:系统将工具结果、执行耗时、状态码、异常信息等内容,统一封装为结构化反馈数据,保证格式统一、可被模型识别。
- 反馈融入循环:将封装后的反馈数据更新至上下文和状态库,模型基于新数据重新推理,开启下一轮迭代。
3. 异常反馈处理策略
工具调用并非百分百成功,网络超时、参数错误、权限不足、数据为空等问题频发,因此需要配套完善的异常反馈处理机制,保障任务稳定运行:
- 自动重试:针对超时、临时网络波动等瞬时异常,系统自动重试2-3次,无需人工干预。
- 参数修正:模型识别到参数错误后,基于反馈报错信息,自主修正参数后重新调用工具。
- 异常降级:多次调用失败后,终止工具调用,记录异常信息,切换为纯文本推理模式,或触发暂停等待人工处理。
六、检查点机制
1. 检查点核心定义
检查点是Agent的“进度存档点”,系统会在固定时机自动保存任务的完整快照,快照包含的核心内容如下:
- 当前最新上下文数据、实时运行状态
- 全部工具执行记录、完整任务进度
- 任务临时缓存数据、参数配置信息
检查点的核心价值主要体现在长周期复杂任务中,比如批量数据处理、长篇内容生成、多工具联动任务,能够有效解决两大问题:
- 应对系统中断、崩溃、异常终止等突发情况,一键恢复进度;
- 避免任务从头重启,杜绝重复劳作、大幅提升执行效率。
2. 检查点触发时机
为兼顾运行效率和进度安全性,检查点不会实时高频存档,避免资源浪费,仅在关键节点触发自动存档,主流触发场景分为四类:
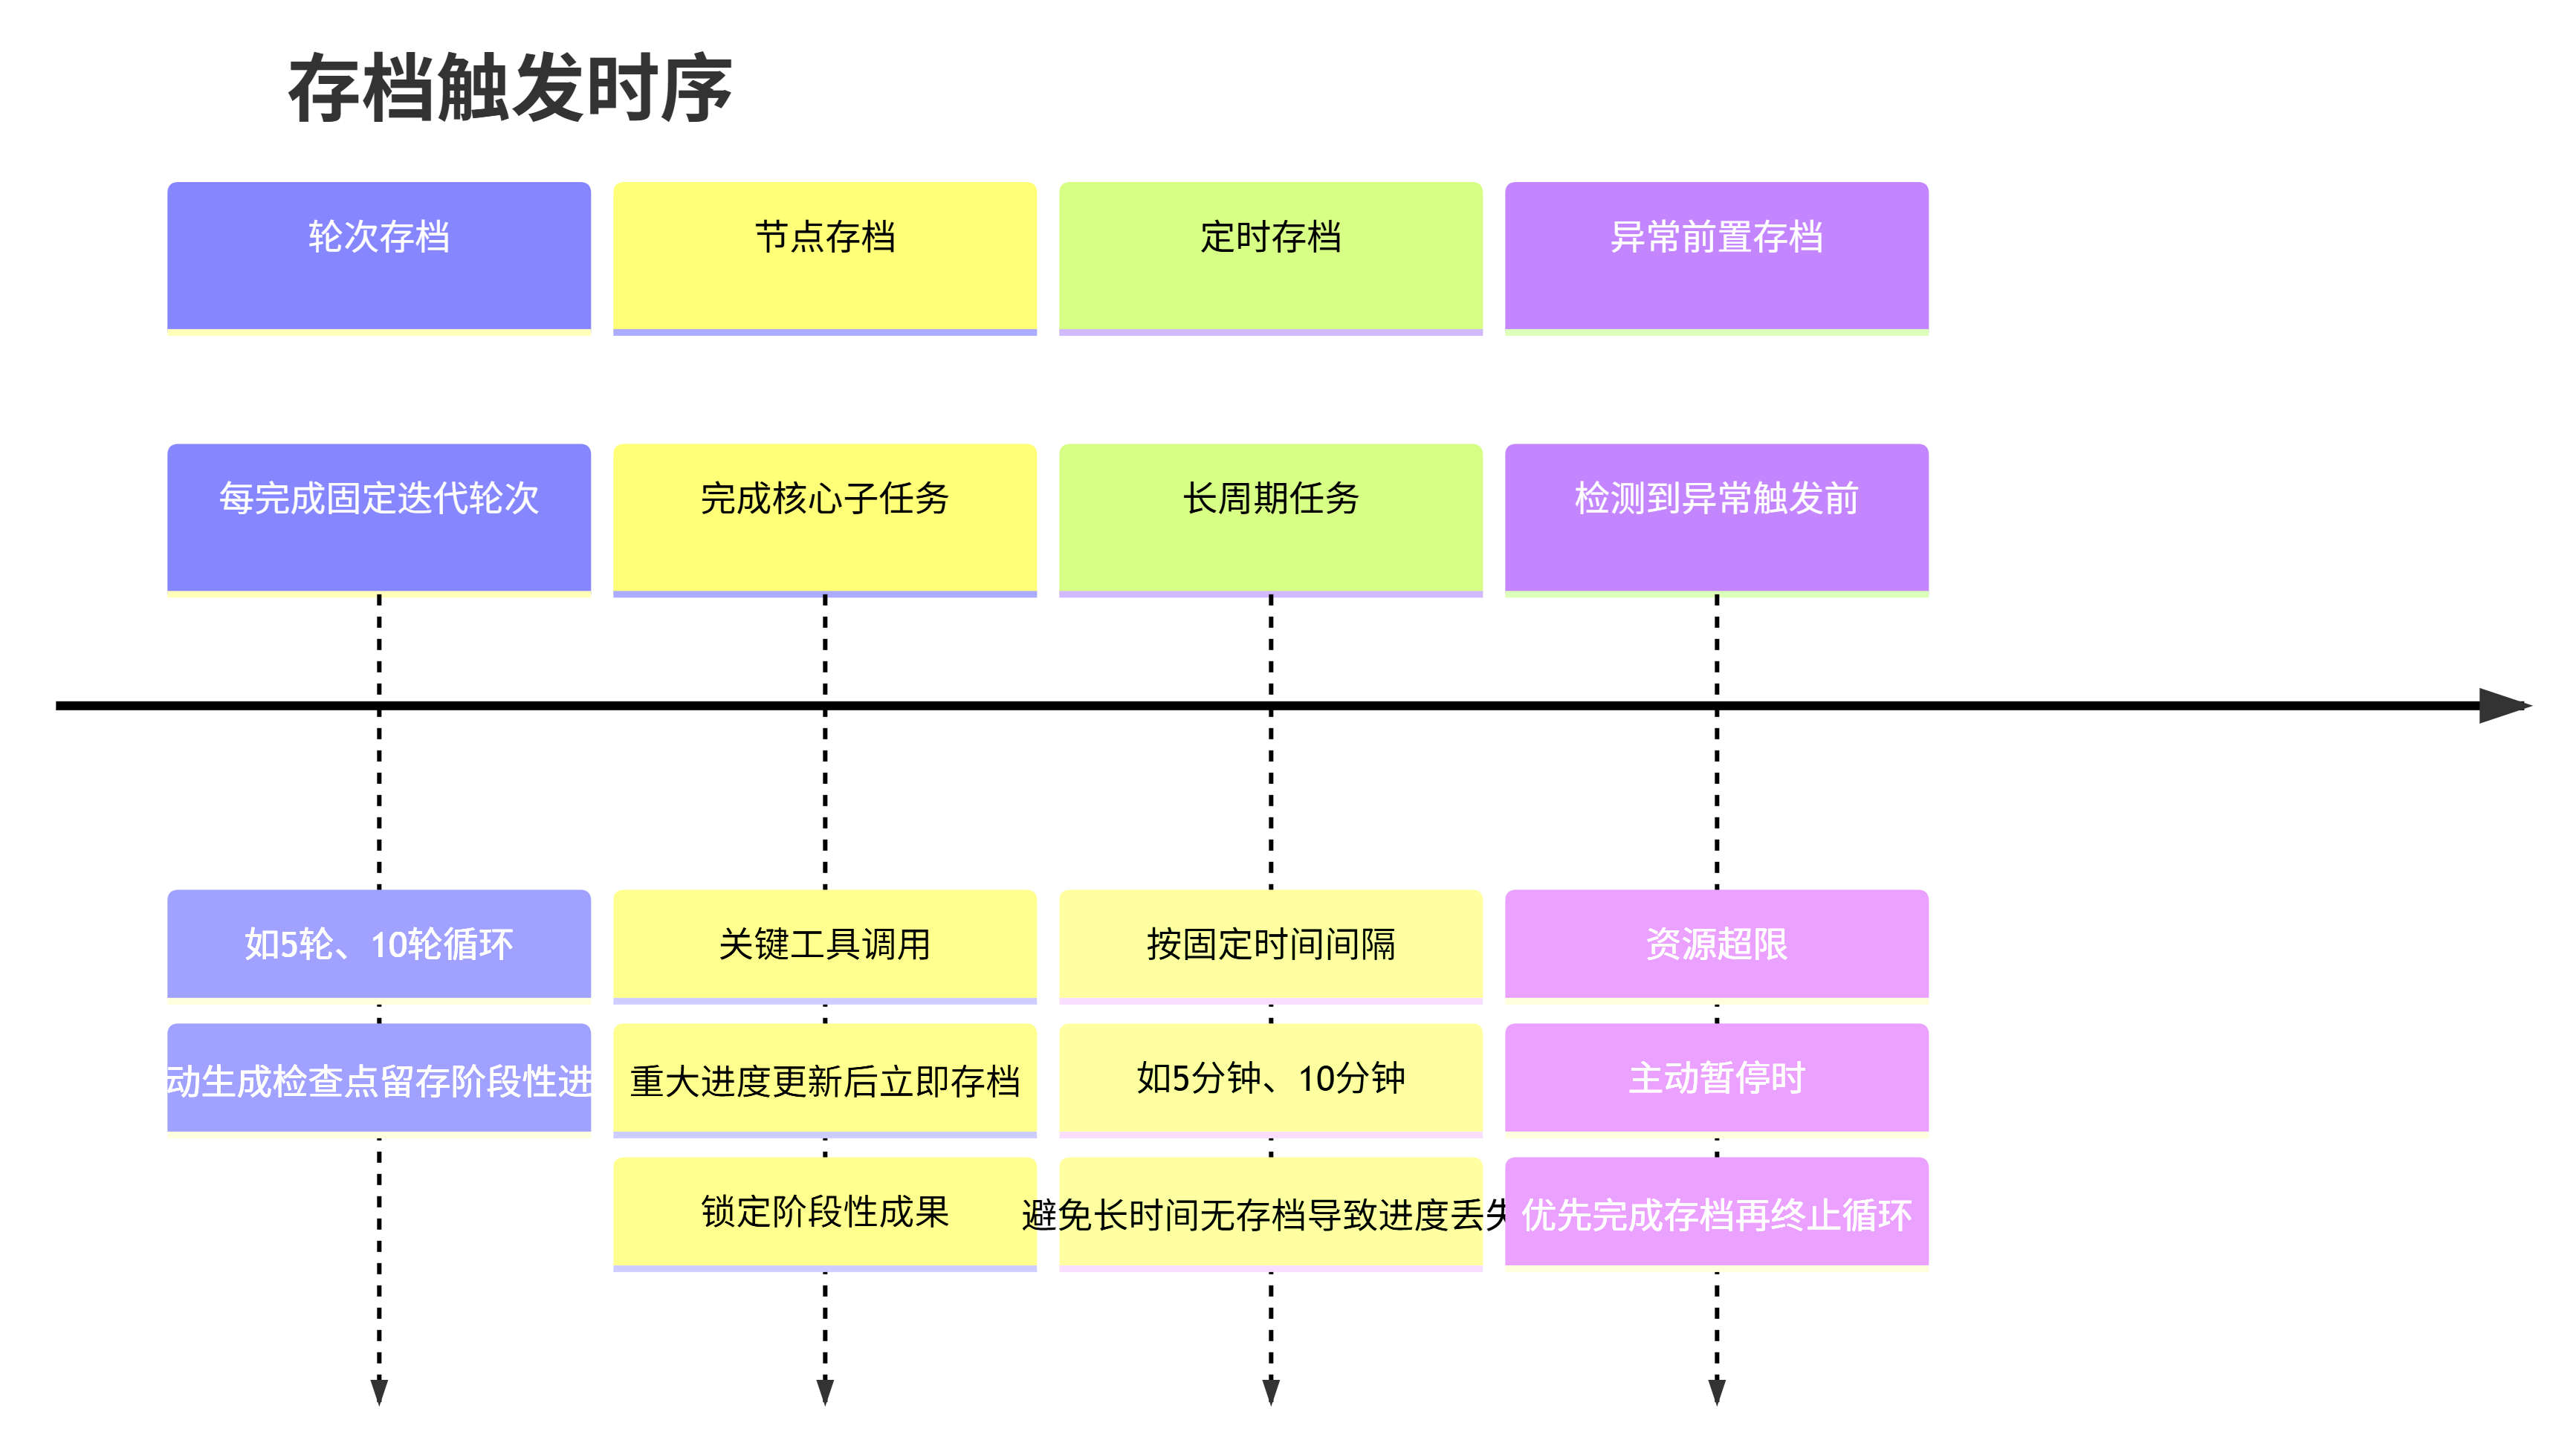
- 轮次存档:每完成固定迭代轮次(如5轮、10轮循环),自动生成一次检查点,留存阶段性进度。
- 节点存档:完成一个核心子任务、关键工具调用、重大进度更新后,立即存档,锁定阶段性成果。
- 定时存档:长周期任务按固定时间间隔(如5分钟、10分钟)定时存档,避免长时间无存档导致进度丢失。
- 异常前置存档:系统检测到即将触发异常、资源超限、主动暂停时,优先完成存档,再终止循环。
3. 检查点存储与复用
检查点采用轻量化结构化存储设计,整体资源占用极低,同时配套双重优化策略,保障可用性:
- 多版本留存:系统自动保留最新3-5个有效存档点,避免单一存档损坏、丢失导致无法恢复;
- 智能匹配恢复:任务中断后,自动筛选最新、最完整的检查点,完整还原任务上下文、运行状态和进度数据。
基于该机制,任务可实现无感续跑,做到零进度丢失、零重复操作,大幅提升长任务的稳定性。
七、停止条件机制
1. 停止条件核心意义
Agent执行循环是自主迭代的闭环,如果没有停止条件约束,会出现各类运行隐患,核心问题包括:
- 任务无限循环、无意义迭代,无法自主收尾;
- 持续消耗算力、内存等资源,造成大量无效浪费;
- 逻辑卡死、任务僵持,出现长期不结束、不报错的异常状态。
停止条件就是Agent的“终止开关”,当运行状态、任务进度、资源消耗满足预设规则时,立即终止迭代循环、结束任务,是保障Agent高效、低耗、稳定运行的核心防线。
2. 四类核心停止条件
落地场景中,Agent停止条件覆盖所有运行场景,主要分为四大核心类型,各司其职:
- 任务目标达成:最核心的主动停止条件,当模型判定任务核心目标全部完成、输出结果满足用户需求、所有子任务执行完毕,立即终止循环。
- 迭代轮次超限:预设最大迭代轮次,当Agent循环次数达到上限,无论任务是否完成,强制终止,避免无限迭代。
- 资源消耗超限:当算力、内存、耗时、调用次数等资源达到预设上限,触发强制停止,保护系统资源。
- 异常持续触发:工具调用连续失败、逻辑持续冲突、异常次数超限,自动终止任务,避免持续报错、无效运行。
3. 停止后置处理
Agent停止运行后不会直接结束流程,会完成标准化后置收尾处理,保障任务闭环可追溯,核心操作包含五点:
- 汇总本轮全部执行记录、梳理完整任务链路;
- 整理最终任务结果,输出标准化交付内容;
- 生成完整任务执行日志,记录迭代、调用、异常信息;
- 固化最终检查点,留存完整任务快照;
- 释放所有占用资源,标注任务终止原因(正常完成/资源超限/异常终止)。
整套后置处理,为任务复盘、问题排查、二次优化提供完整依据。
八、资源上限机制
1. 资源管控必要性
Agent自主运行过程中,会持续消耗算力、内存、网络、调用频次、时长等各类资源,若不设置上限管控,会引发多重风险:
- 单任务独占全部系统资源,导致平台卡顿、其他任务失效;
- 无节制迭代和工具调用,造成算力成本飙升;
- 资源溢出引发内存报错、系统崩溃、任务突发中断。
资源上限机制即为Agent运行设置“资源天花板”,核心价值是实现资源可控、均衡复用、成本可控、运行稳定。
2. 核心资源管控维度
主流Agent系统会从六大核心维度设置资源上限,全方位、无死角约束运行消耗,适配各类落地场景:
- 迭代轮次上限:限制单任务最大循环迭代次数,杜绝无限循环,常规场景设置20-50轮即可满足绝大多数需求。
- 运行时长上限:限制单任务最大运行时间,避免长任务持续占用资源,短时任务设置分钟级上限,长周期任务设置小时级上限。
- 工具调用上限:限制单任务、单轮次的工具调用次数,避免频繁调用接口导致限流、超时、成本过高。
- 内存占用上限:限制Agent上下文、临时数据、检查点的内存占用,避免内存溢出、系统卡顿。
- 算力消耗上限:限制单任务token消耗、推理算力占用,平衡任务效果和运行成本。
- 接口频次上限:管控外部工具接口的调用频次,防止触发第三方接口限流规则。
3. 资源超限处理逻辑
当任意一项资源达到预设上限时,系统不会直接崩溃报错,而是执行标准化兜底逻辑,保障风险可控,核心流程如下:

- 立即暂停迭代循环,冻结当前任务进度,避免资源持续消耗;
- 自动保存最新检查点,留存完整任务快照;
- 释放闲置占用资源,缓解系统压力;
- 记录超限日志,标注超限资源类型和触发原因;
- 推送资源告警,告知用户异常状态。
用户可根据实际需求,选择扩容资源、调整上限、继续执行或终止任务,全程可控无风险。
九、任务恢复与人工接管
1. 任务恢复机制
依托前文的检查点机制,Agent具备完善的任务恢复能力,可适配各类任务中断场景,核心覆盖场景包括:系统崩溃、网络中断、资源超限、主动暂停、异常终止等,且全程自动化恢复,无需人工梳理进度。
任务恢复核心流程分为三步:
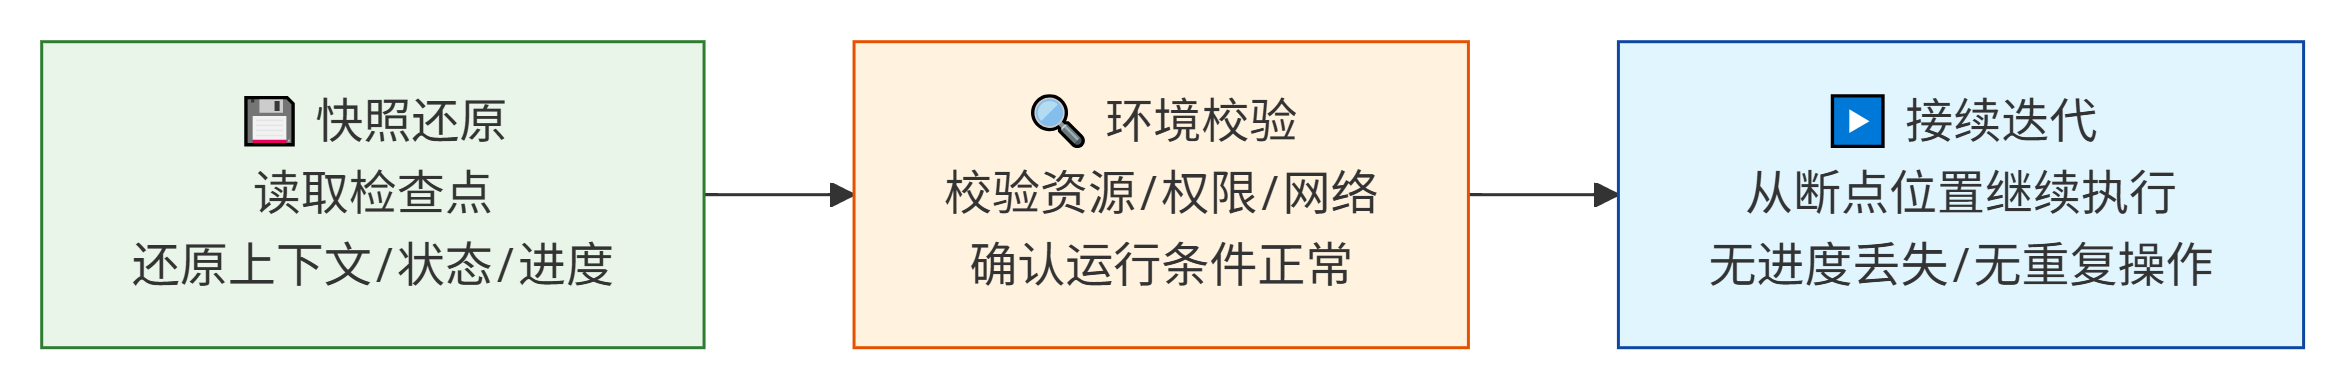
- 快照还原:系统读取最新有效检查点,完整还原任务上下文、运行状态、全部进度数据;
- 环境校验:自动校验资源状态、工具权限、网络环境,确认运行条件正常;
- 接续迭代:基于断点位置,接续原有循环逻辑继续执行,无进度丢失、无重复操作。
同时系统支持两种恢复模式,适配多元场景:手动恢复可按需启停,定时自动恢复适配自动化批量任务、离线任务场景。
2. 人工接管触发场景
Agent虽具备自主运行、自主决策能力,但在复杂、高风险场景中存在决策局限,需要人工介入兜底,规避自主决策出错风险。主流人工接管触发场景分为六类:
- 任务逻辑模糊、需求不明确,模型无法精准判定执行方向;
- 工具调用多次失败、常规重试策略无效,任务持续卡点;
- 任务存在决策风险、合规风险、业务风险,自主执行易出错;
- 资源即将超限,继续运行可能导致任务中断、成本超标;
- 任务输出结果偏差较大,不符合预期标准;
- 任务难度超出模型能力边界,无法自主推进。
3. 人工接管运行流程
人工接管采用“无缝介入、可退可续”的灵活机制,不打乱原有任务链路,具体运行流程如下:
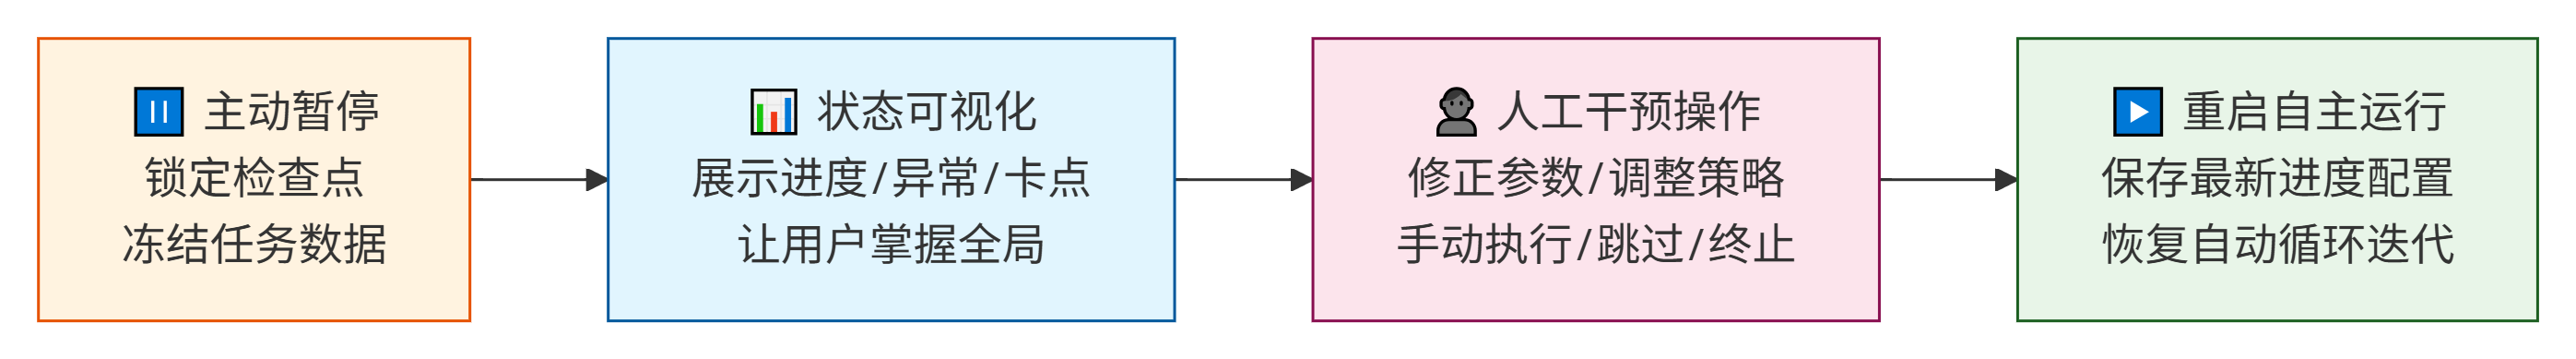
- 主动暂停:系统触发接管条件后,立即暂停循环迭代,锁定当前检查点,冻结所有任务数据,防止进度错乱。
- 状态可视化:向用户展示完整任务进度、异常问题、历史执行记录、当前卡点,让用户清晰掌握全部情况。
- 人工干预操作:用户可手动修正参数、调整任务策略、补充指令、手动执行工具操作、跳过异常步骤、终止任务等。
- 重启自主运行:人工处理完成后,保存最新进度和配置,Agent可恢复自动循环迭代,继续完成剩余任务。
这套机制实现了“机器自主执行为主,人工兜底干预为辅”的最优协作模式,既保证运行效率,又杜绝智能体自主决策的风险漏洞。
十、应用实践示例
该示例完整演示大模型Agent核心机制:
- 上下文记忆:AgentContext持久化任务基线、历史交互与临时数据
- 状态管理:AgentState覆盖初始化/运行/暂停/异常/完成五种状态
- 主循环:感知-推理-执行-反馈-更新五步闭环运行
- 资源控制:轮次上限30、时长上限60秒、工具调用上限20次三重约束
- 异常处理:15%随机失败触发重试,连续失败3次降级暂停待人工接管
- 检查点机制:定时存档快照,支持断点恢复继续执行
import time
import json
from typing import List, Dict

# ====================== 1. 全局配置(资源上限、停止条件)======================
MAX_ITER_ROUND = 30        # 迭代轮次上限
MAX_RUN_TIME = 60          # 运行时长上限(秒)
MAX_TOOL_CALL = 20         # 单任务工具调用上限

# ====================== 2. 核心数据结构(上下文 + 状态管理)======================
class AgentContext:
    """上下文记忆系统:对应文章上下文机制"""
    def __init__(self, task_prompt: str):
        self.task_base = task_prompt          # 任务基线信息(永久不丢失)
        self.history: List[Dict] = []         # 历史交互记录
        self.progress = "待执行"              # 任务进度
        self.temp_data: Dict = {}             # 临时变量数据

    def update(self, content: Dict):
        """每轮循环更新上下文"""
        self.history.append(content)
        self.temp_data.update(content.get("temp", {}))

    def snapshot(self) -> str:
        """生成检查点快照:对应文章检查点机制"""
        return json.dumps({
            "task_base": self.task_base,
            "history": self.history,
            "progress": self.progress,
            "temp_data": self.temp_data
        }, ensure_ascii=False, indent=2)

    def restore(self, snapshot: str):
        """从检查点恢复任务:对应文章任务恢复机制"""
        data = json.loads(snapshot)
        self.task_base = data["task_base"]
        self.history = data["history"]
        self.progress = data["progress"]
        self.temp_data = data["temp_data"]

class AgentState:
    """状态管理:初始化/运行/暂停/异常/完成"""
    INIT = "初始化"
    RUNNING = "运行中"
    PAUSE = "已暂停"
    ERROR = "异常终止"
    FINISH = "已完成"

# ====================== 3. 模拟工具与反馈机制 ======================
def mock_tool_call(cmd: str) -> Dict:
    """模拟工具调用 + 异常重试 + 反馈封装"""
    time.sleep(0.2)
    # 模拟随机异常,触发重试机制
    import random
    if random.random() < 0.15:
        return {"status": "error", "msg": "工具调用超时", "data": None}
    return {"status": "success", "msg": "执行成功", "data": f"工具执行结果:{cmd}"}

# ====================== 4. Agent 核心循环逻辑 ======================
class BaseAgent:
    def __init__(self, task: str):
        self.ctx = AgentContext(task)
        self.state = AgentState.INIT
        self.iter_count = 0
        self.tool_count = 0
        self.start_time = time.time()
        self.check_point = ""  # 保存最新检查点

    def save_checkpoint(self):
        """定时/节点存档"""
        self.check_point = self.ctx.snapshot()

    def run(self):
        """主执行循环:感知-推理-执行-反馈-更新"""
        # 初始化启动
        print("\n【Agent 启动】状态: 初始化 → 运行中")
        self.state = AgentState.RUNNING
        self.ctx.progress = "循环开始执行"
        self.save_checkpoint()
        print(f"  [OK] 已保存初始检查点(快照)")

        while True:
            # -------- 停止条件校验 --------
            if self.iter_count >= MAX_ITER_ROUND:
                print(f"\n  [WARN] 停止条件触发:迭代轮次已达上限({MAX_ITER_ROUND}轮)")
                self.ctx.progress = "迭代轮次超限,强制终止"
                self.state = AgentState.FINISH
                break
            if time.time() - self.start_time >= MAX_RUN_TIME:
                print(f"\n  [WARN] 停止条件触发:运行时长已达上限({MAX_RUN_TIME}秒)")
                self.ctx.progress = "运行时长超限,强制终止"
                self.state = AgentState.FINISH
                break

            self.iter_count += 1
            print(f"\n{'='*50}")
            print(f"【第 {self.iter_count} 轮迭代】")

            # 1. 感知:读取上下文+状态
            current_info = f"第{self.iter_count}轮,当前进度:{self.ctx.progress}"
            print(f"  [感知] 读取上下文 -> {current_info}")

            # 2. 推理:模拟模型决策
            if self.tool_count < MAX_TOOL_CALL:
                action = "调用工具执行任务"
                print(f"  [推理] 模型决策 -> 需要调用工具(已调用 {self.tool_count}/{MAX_TOOL_CALL})")
            else:
                action = "无需工具,文本总结收尾"
                print(f"  [推理] 模型决策 -> 工具调用已达上限,生成文本总结")

            # 3. 执行 + 工具反馈
            tool_res = {}
            if action == "调用工具执行任务":
                self.tool_count += 1
                tool_res = mock_tool_call(f"轮次{self.iter_count}执行操作")
                print(f"  [执行] 调用工具 -> 返回状态: {tool_res['status']}")

                # 异常处理策略:重试、降级
                if tool_res["status"] == "error":
                    print(f"  [反馈] 工具调用异常!已累计失败 {self.tool_count} 次")
                    if self.tool_count % 3 == 0:
                        print(f"  [降级] 连续失败达阈值,任务暂停等待人工接管")
                        self.ctx.progress = "多次调用失败,任务暂停待人工接管"
                        self.state = AgentState.PAUSE
                        self.save_checkpoint()
                        break
                    else:
                        print(f"  [重试] 将继续尝试调用工具...")
            else:
                print(f"  [执行] 跳过工具调用,直接文本输出")

            # 4. 更新上下文与状态
            self.ctx.update({
                "round": self.iter_count,
                "info": current_info,
                "action": action,
                "result": tool_res
            })
            print(f"  [更新] 上下文已刷新(历史记录: {len(self.ctx.history)} 条)")

            # 模拟任务完成判定
            if self.iter_count >= 5:
                print(f"\n  [完成] 任务目标全部达成,循环正常结束")
                self.ctx.progress = "任务目标全部达成"
                self.state = AgentState.FINISH
                break

            # 每5轮自动存档
            if self.iter_count % 5 == 0:
                self.save_checkpoint()
                print(f"  [存档] 已生成检查点快照")

        # 后置收尾处理
        print(f"\n【Agent 收尾】最终状态: {self.state},保存终态检查点")
        self.save_checkpoint()
        return self._get_summary()

    def resume(self):
        """断点恢复运行"""
        if self.state == AgentState.PAUSE and self.check_point:
            self.ctx.restore(self.check_point)
            self.state = AgentState.RUNNING
            return self.run()

    def _get_summary(self):
        return {
            "最终状态": self.state,
            "总迭代轮次": self.iter_count,
            "工具调用次数": self.tool_count,
            "任务进度": self.ctx.progress
        }

# ====================== 5. 运行测试 ======================
if __name__ == "__main__":
    print("=" * 60)
    print("  大模型 Agent 机制完整示例")
    print("  涵盖:上下文管理 | 状态机 | 检查点 | 异常重试 | 资源控制")
    print("=" * 60)

    agent = BaseAgent(task="完成大模型Agent机制测试任务")
    result = agent.run()

    print("\n" + "=" * 60)
    print("  Agent 运行结果汇总")
    print("=" * 60)
    for k, v in result.items():
        print(f"  > {k}:{v}")

    # 打印最终检查点内容
    print("\n" + "=" * 60)
    print("  最终检查点快照(可恢复状态)")
    print("=" * 60)
    print(agent.check_point)
    print("\n说明:检查点包含完整任务上下文,可在意外中断后通过 resume() 恢复。")
输出结果:
============================================================ 大模型 Agent 机制完整示例 涵盖:上下文管理 | 状态机 | 检查点 | 异常重试 | 资源控制 ============================================================ 【Agent 启动】状态: 初始化 → 运行中 [OK] 已保存初始检查点(快照) ================================================== 【第 1 轮迭代】 [感知] 读取上下文 -> 第1轮,当前进度:循环开始执行 [推理] 模型决策 -> 需要调用工具(已调用 0/20) [执行] 调用工具 -> 返回状态: error [反馈] 工具调用异常!已累计失败 1 次 [重试] 将继续尝试调用工具... [更新] 上下文已刷新(历史记录: 1 条) ================================================== 【第 2 轮迭代】 [感知] 读取上下文 -> 第2轮,当前进度:循环开始执行 [推理] 模型决策 -> 需要调用工具(已调用 1/20) [执行] 调用工具 -> 返回状态: success [更新] 上下文已刷新(历史记录: 2 条) ================================================== 【第 3 轮迭代】 [感知] 读取上下文 -> 第3轮,当前进度:循环开始执行 [推理] 模型决策 -> 需要调用工具(已调用 2/20) [执行] 调用工具 -> 返回状态: success [更新] 上下文已刷新(历史记录: 3 条) ================================================== 【第 4 轮迭代】 [感知] 读取上下文 -> 第4轮,当前进度:循环开始执行 [推理] 模型决策 -> 需要调用工具(已调用 3/20) [执行] 调用工具 -> 返回状态: success [更新] 上下文已刷新(历史记录: 4 条) ================================================== 【第 5 轮迭代】 [感知] 读取上下文 -> 第5轮,当前进度:循环开始执行 [推理] 模型决策 -> 需要调用工具(已调用 4/20) [执行] 调用工具 -> 返回状态: success [更新] 上下文已刷新(历史记录: 5 条) [完成] 任务目标全部达成,循环正常结束 【Agent 收尾】最终状态: 已完成,保存终态检查点 ============================================================ Agent 运行结果汇总 ============================================================ > 最终状态:已完成 > 总迭代轮次:5 > 工具调用次数:5 > 任务进度:任务目标全部达成 ============================================================ 最终检查点快照(可恢复状态) ============================================================ { "task_base": "完成大模型Agent机制测试任务", "history": [ { "round": 1, "info": "第1轮,当前进度:循环开始执行", "action": "调用工具执行任务", "result": { "status": "error", "msg": "工具调用超时", "data": null } }, { "round": 2, "info": "第2轮,当前进度:循环开始执行", "action": "调用工具执行任务", "result": { "status": "success", "msg": "执行成功", "data": "工具执行结果:轮次2执行操作" } }, { "round": 3, "info": "第3轮,当前进度:循环开始执行", "action": "调用工具执行任务", "result": { "status": "success", "msg": "执行成功", "data": "工具执行结果:轮次3执行操作" } }, { "round": 4, "info": "第4轮,当前进度:循环开始执行", "action": "调用工具执行任务", "result": { "status": "success", "msg": "执行成功", "data": "工具执行结果:轮次4执行操作" } }, { "round": 5, "info": "第5轮,当前进度:循环开始执行", "action": "调用工具执行任务", "result": { "status": "success", "msg": "执行成功", "data": "工具执行结果:轮次5执行操作" } } ], "progress": "任务目标全部达成", "temp_data": {} } 说明:检查点包含完整任务上下文,可在意外中断后通过 resume() 恢复。
十一、总结
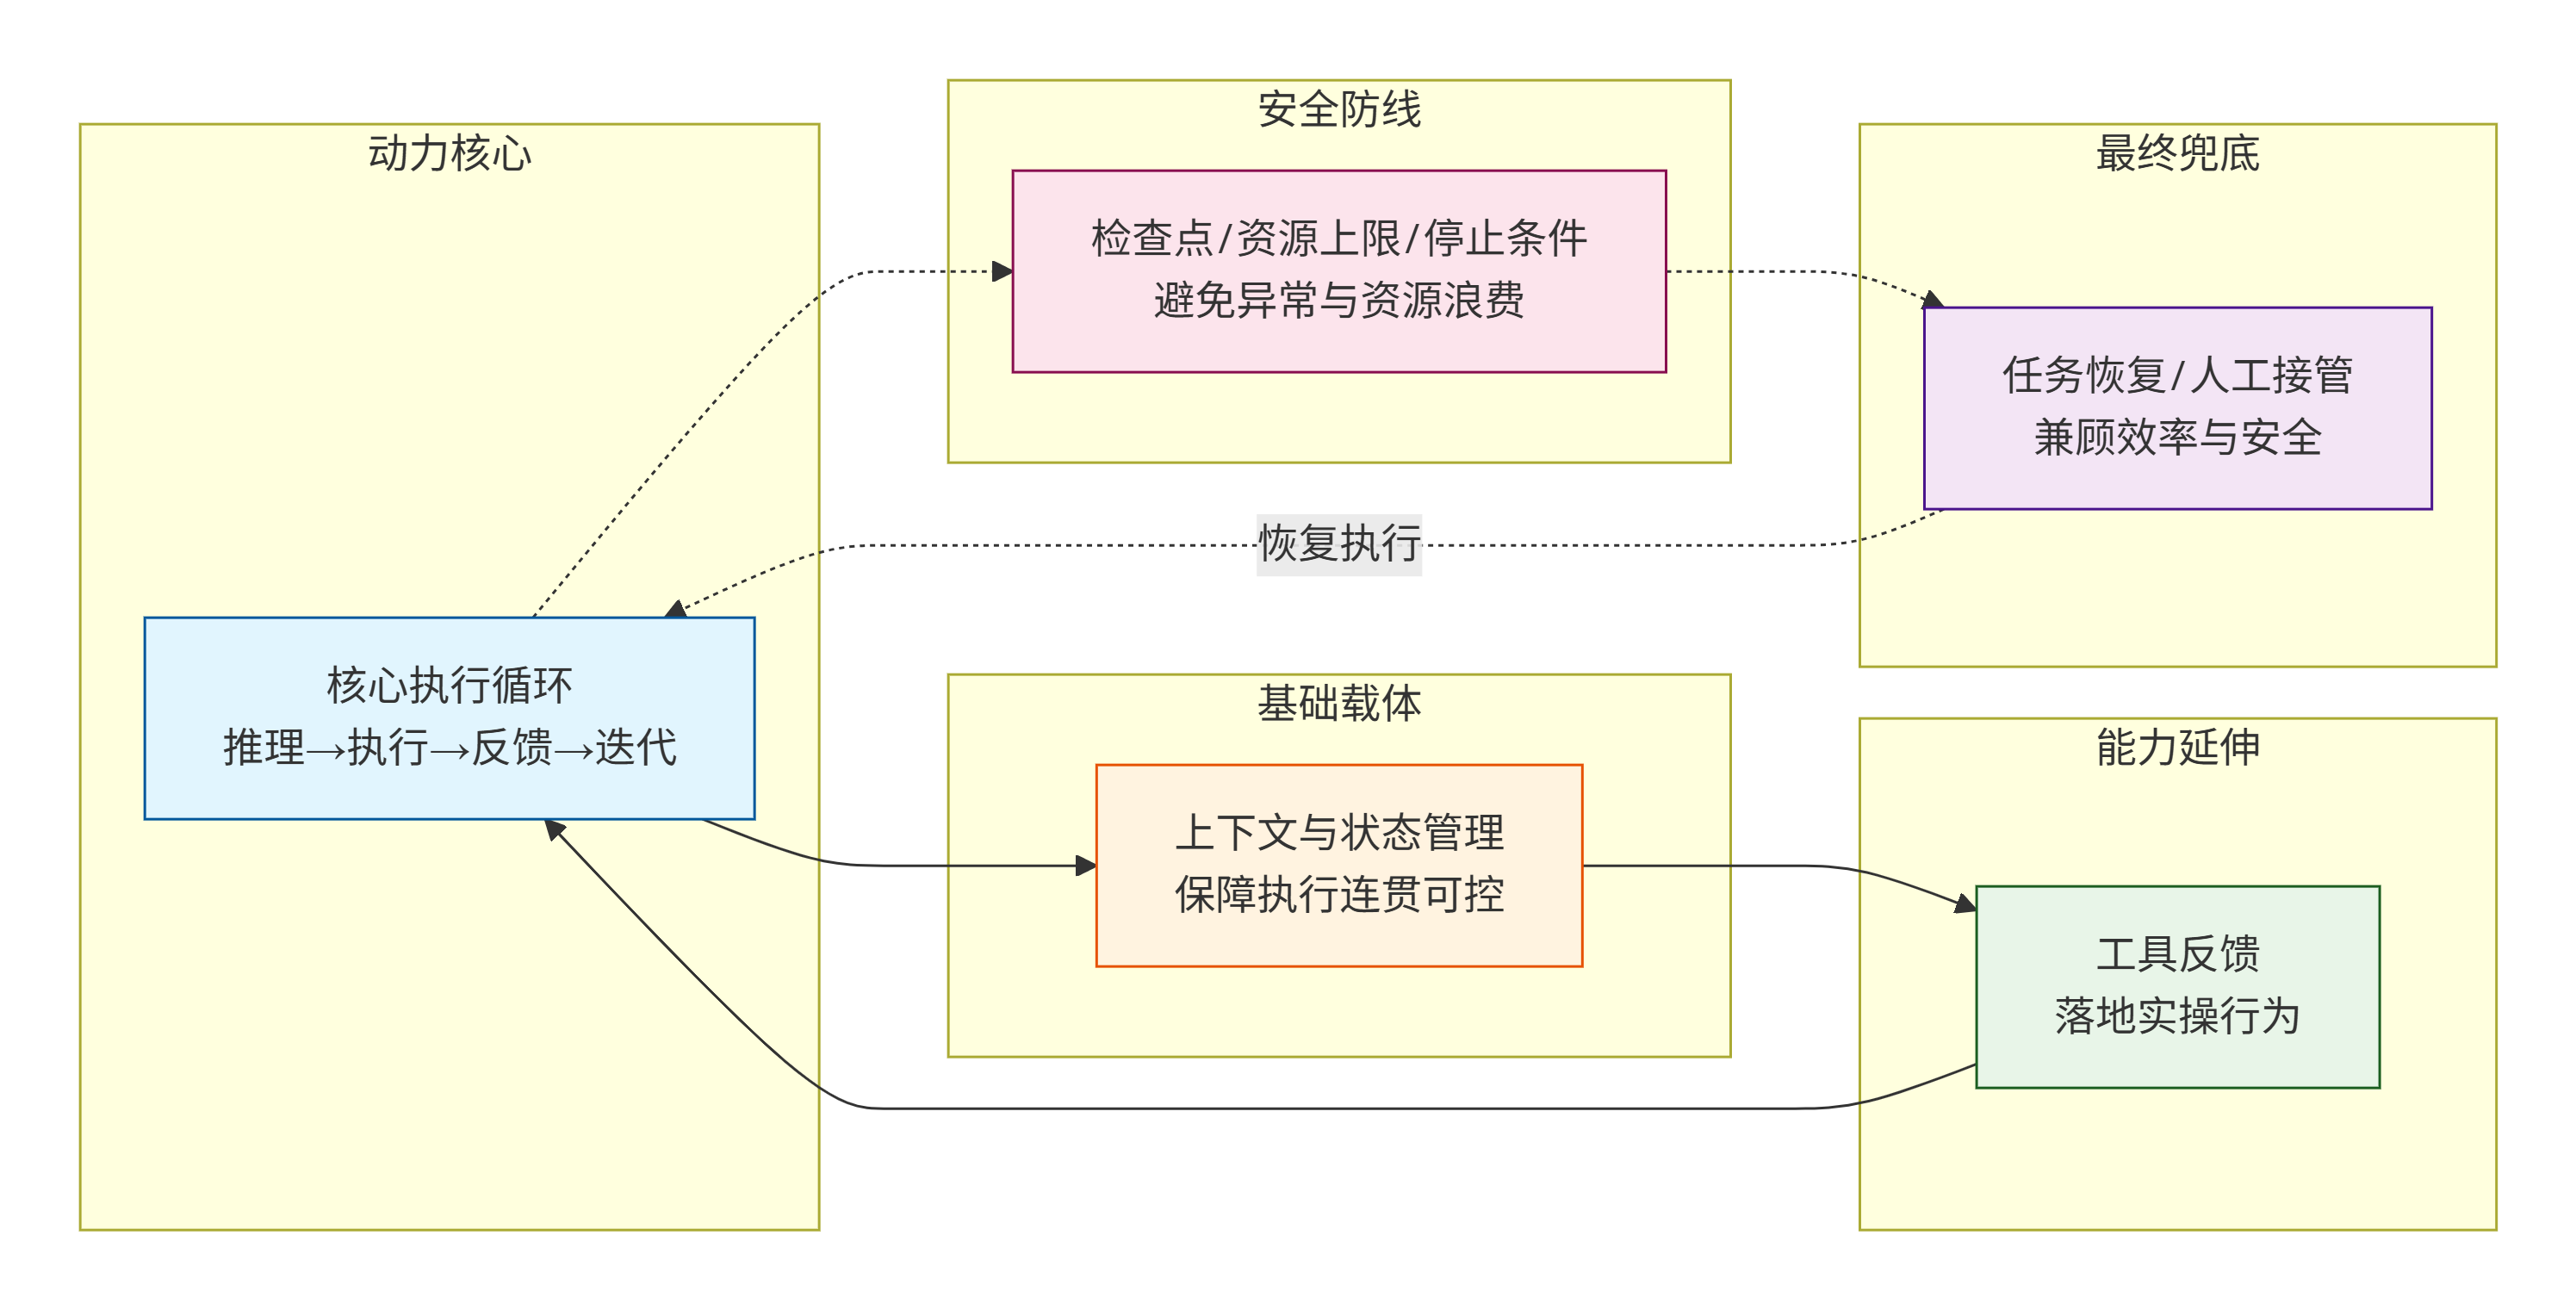
大模型Agent的底层运行逻辑。本质上Agent的所有智能自主能力,都来自标准化的循环执行体系+全方位的管控兜底机制。核心执行循环是Agent的动力核心,驱动任务持续迭代推进;上下文和状态管理是基础载体,保障执行连贯可控;工具反馈是能力延伸,让模型落地实操行为;检查点、资源上限、停止条件是安全防线,避免任务异常、资源浪费;任务恢复和人工接管是最终兜底,兼顾自动化效率和场景安全性。
不同于单次问答的简单交互,Agent的核心优势是自主迭代、可控可溯、容错可恢复。了解Agent的核心运行机制,不仅能帮我们看懂各类智能Agent的工作原理,更能指导我们在实际开发、场景落地中,搭建更稳定、更智能、更安全的大模型智能体应用,真正释放大模型的自动化价值。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号