案卷不再大海捞针:Jev 先把无关材料筛掉再交给律师
原创
案卷不再大海捞针:Jev 先把无关材料筛掉再交给律师
原创
克劳德2048
发布于 2026-09-23 21:38:55
发布于 2026-09-23 21:38:55
办案时,律师常要面对一大堆案件材料,其中真正和争议焦点相关的往往只是一部分,但为了不漏关键证据,只能一份份读完。这一周我用 Jev 先做一道相关性判断,把无关材料筛掉,律师的阅读量一下就降了。这篇讲清楚这个场景应用前后的差别:相关性判断怎么做、律师阅读量降了多少、关键证据怎么更快浮现。文中对比为基于实测口径的方案性测算,非某案真实数据,Jev 仍处早期访问阶段。
一、原来的做法:逐份读完全部材料
应用前,律师要把案件材料逐份阅读,一边读一边判断哪些和本案争议相关、哪些是关键证据。
问题在于,大量材料其实和争议焦点无关,但律师为了不漏掉关键证据,只能全部过一遍。无关材料占用了大量阅读时间,关键证据也淹没在其中,需要人工一点点筛。
二、改造后的做法:Jev 判相关性,先筛后读
应用后,我在律师阅读前加一道 Jev 判断。
案件材料片段配上本案争议焦点,一起进 Jev:判断这份材料是否与本案相关、是否疑似关键证据,用 Choice 和 Noul 就能覆盖。无关材料被过滤,疑似关键证据被标记出来,律师优先看筛选后的相关材料,而不是从头读到尾。
下面这张图是应用前后的对照:
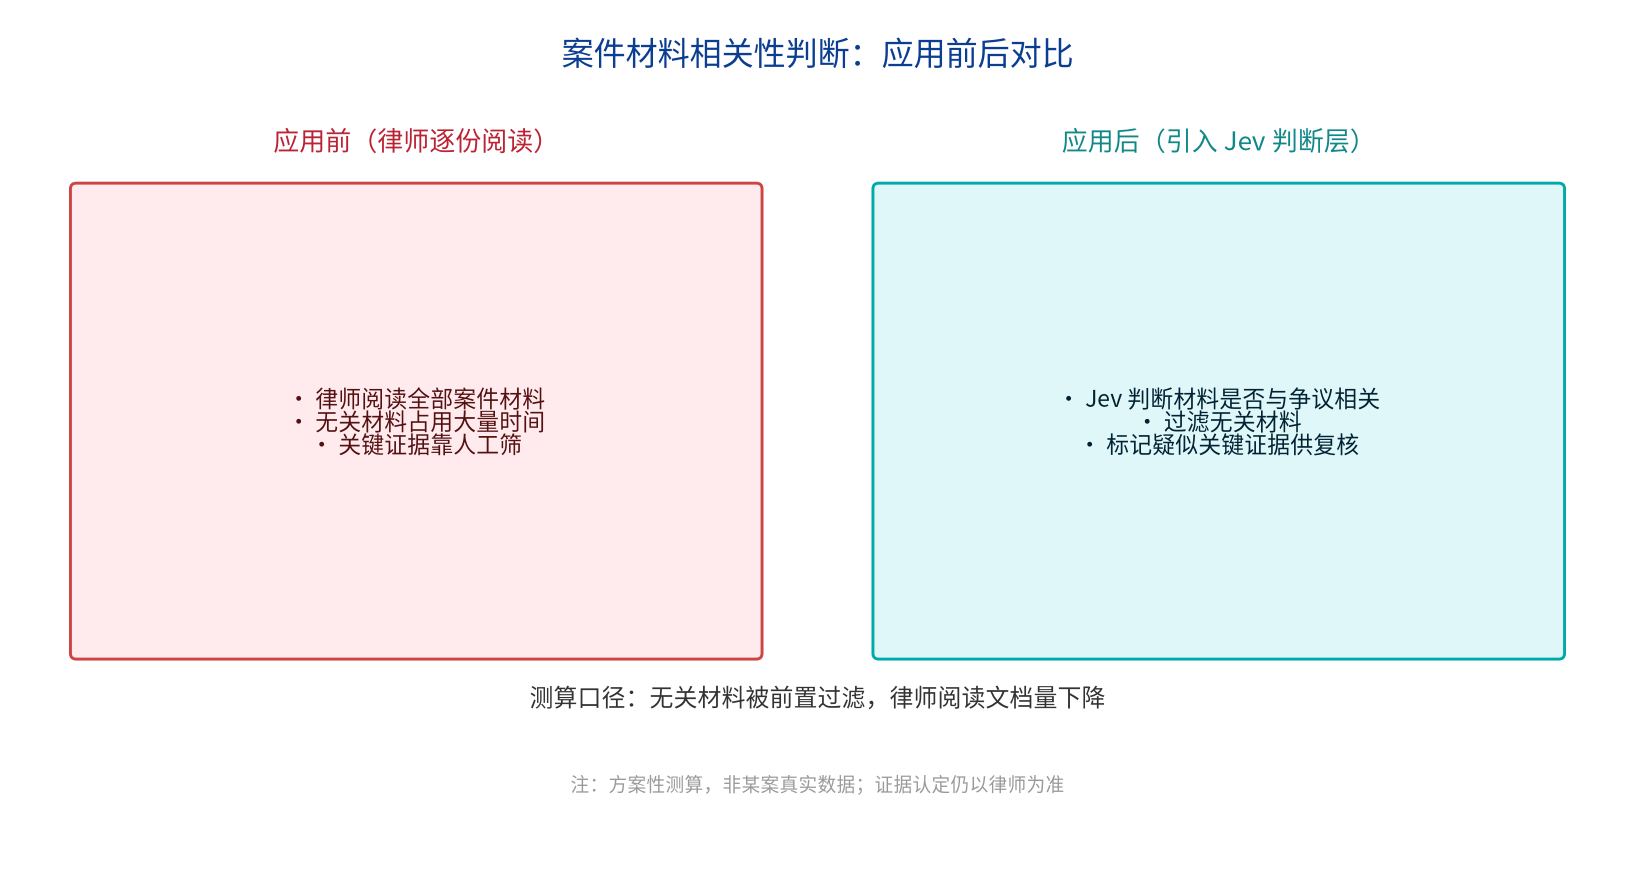
案件材料相关性判断:应用前后对比
三、价值对比:阅读量与证据定位
收益体现在两处。
阅读量上,无关材料被前置过滤,律师需要精读的文档量下降,办案前期的材料梳理提速。
定位上,疑似关键证据被 Jev 标记出来,律师能更快聚焦到重要材料上,而不是在海量文档里逐份翻找。
四、这套方案的边界
Jev 在这里做的是"相关性初筛",不做证据认定和法律判断。它只判断"像不像相关、像不像关键",可能误筛,所以被过滤的材料不能直接丢弃,重要案件仍需律师抽样复核,避免漏掉被误判为无关的关键材料。是否采纳为证据、如何论证,全部由律师决定。收益为测算口径,真实筛选准确率要以自己的案件材料为准。
五、最终效益
这套改造的效益是"用一道相关性初筛,把律师从大海捞针里解放出来"。无关材料被过滤后,律师阅读量下降、证据定位更快,办案前期的效率明显提升。把"这份材料相不相关、是不是关键"的初筛交给 Jev、把"能不能作为证据、怎么用"的判断留给律师,案卷梳理既省时又不失严谨。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号