课后补充--先导化合物的优化策略
原创
课后补充--先导化合物的优化策略
原创
追风少年i
发布于 2026-09-28 08:56:12
发布于 2026-09-28 08:56:12
作者,Evil Genius
世事无常,红白事接踵而至,看着父母这一代开始有人陆续下车了,心里总是有一种说不出来的感伤。
现实其实也是很多磨难,大家如果选择回到家乡,就要接受家这边的各种不公,例如公司拖欠工资,断交社保等等,我都经历过了,以后怎么样,看天意吧,普通人维权真的非常难,常州星宇车灯股份有限公司的那件事,非常令人钦佩,什么时候国内的环境可以好一点,我们都已经世界第二了,为什么还有这些拖欠工资的事情发生,不应该企业精神也是世界前列么?
社保局,劳动局的人员都是公务员,基本也都是普通人考上去的,上岸了以后也基本都忘记自己原来的身份了,现在普通人维权,这些当初跟我们一样的普通人,早已置身事外了,什么时候我们普通人维权变得容易了,和西方看齐了,才能真正的说我们可以了。
这一篇我们来汇总先导化合物的优化策略。
对于经过虚拟筛选(Virtual Screening, VS)得到的候选化合物,下一步不是简单地“继续对接”,而是进入 Hit → Lead → Lead Optimization(先导化合物优化) 阶段。核心目标通常是同时优化 活性、选择性、ADMET、成药性和合成可行性。虚拟筛选得到的 hit 往往只满足其中一部分要求,后续需要通过 SAR 和反复的 Design–Make–Test–Analyze(DMTA)循环进行优化。
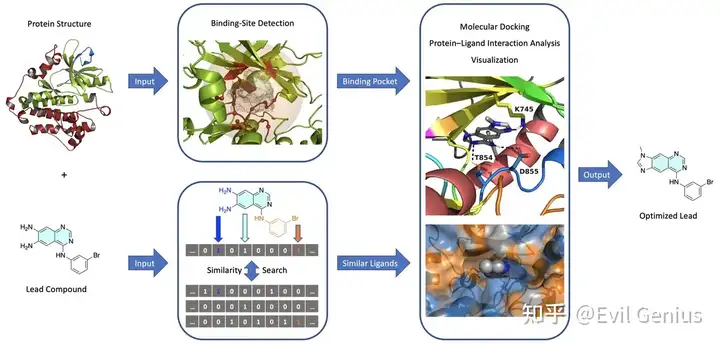
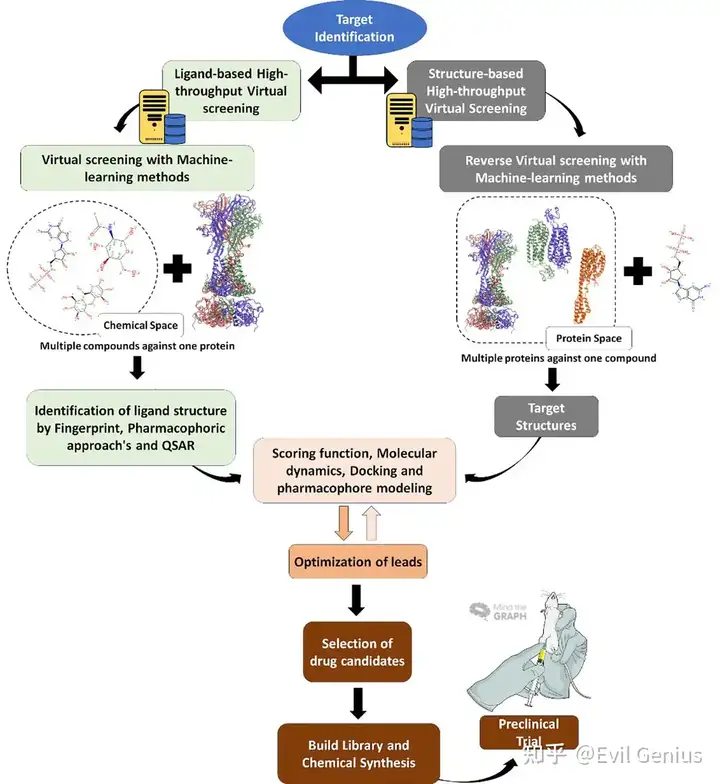
一、虚拟筛选之后,完整的优化路线
可以把整个过程设计成:
虚拟筛选
               ↓
        1000–10000 compounds
               ↓
       Docking / Pharmacophore
               ↓
          Top 50–200
               ↓
      ┌─────────────────┐
      │ Hit确认           │
      │ 生化/细胞实验     │
      └─────────────────┘
               ↓
          5–20个 Hit
               ↓
       Hit-to-Lead优化
               ↓
       ┌───────────────┐
       │ SAR分析       │
       │ Scaffold分析  │
       │ Docking       │
       │ MD            │
       │ 3D-QSAR       │
       │ ADMET         │
       └───────────────┘
               ↓
        设计几十~几百个
          新的类似物
               ↓
        合成 + 活性实验
               ↓
        SAR数据不断积累
               ↓
        Lead Optimization
               ↓
候选药物 Candidate这也是结构基础药物设计中常见的思路:VS负责发现候选结构,而后续的结构优化负责把候选结构变成更有开发价值的先导化合物。
二、第一步:先确定“这个Hit到底值不值得优化”
假设虚拟筛选得到:
Compound | Docking | IC50 | MW | LogP | HBD | HBA |
|---|---|---|---|---|---|---|
Hit01 | -9.1 | 2.5 μM | 420 | 4.8 | 1 | 7 |
Hit02 | -8.7 | 0.8 μM | 380 | 3.2 | 2 | 6 |
Hit03 | -8.5 | 12 μM | 510 | 5.9 | 1 | 9 |
Hit04 | -8.2 | 1.5 μM | 350 | 2.7 | 2 | 5 |
这时候不能直接按照 docking score 排名。
更合理的是:
Docking
   ↓
结合模式
   ↓
关键残基相互作用
   ↓
实验活性
   ↓
选择性
   ↓
ADMET
   ↓
合成可行性
   ↓
确定Lead series
因为 docking score 和真实实验活性并不是简单的一一对应关系。
三、第二步:确定“哪个位置可以改”
这是药物活性优化最核心的部分。
假设得到一个 Hit:
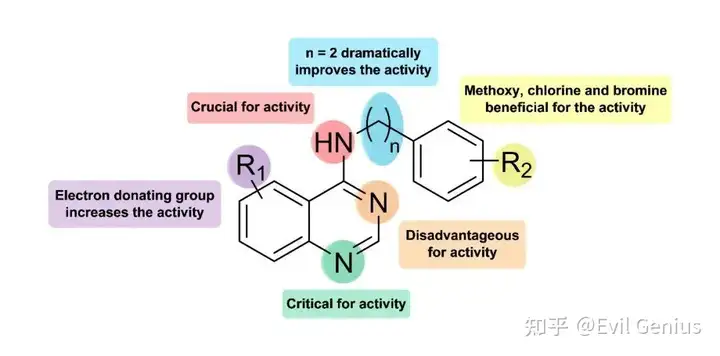
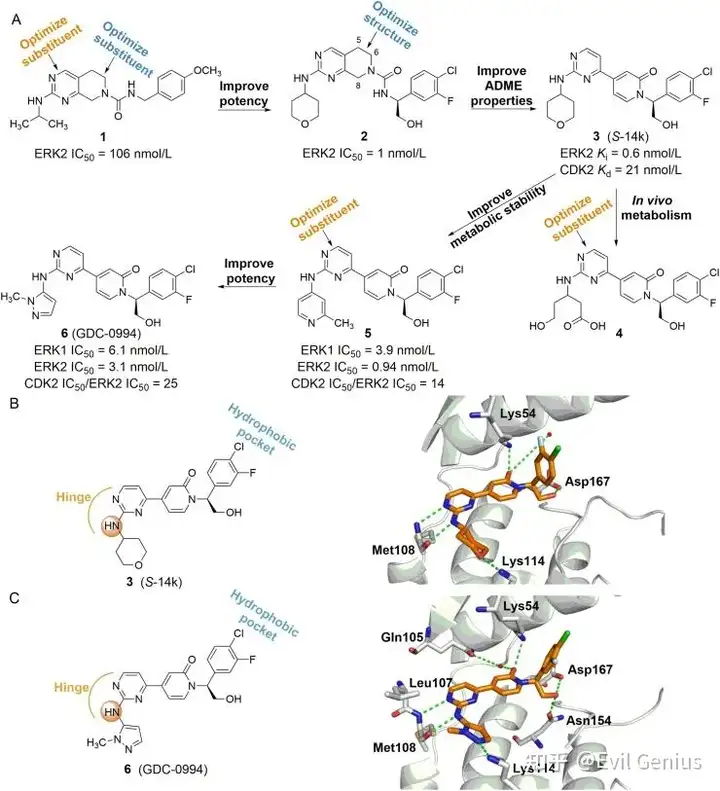
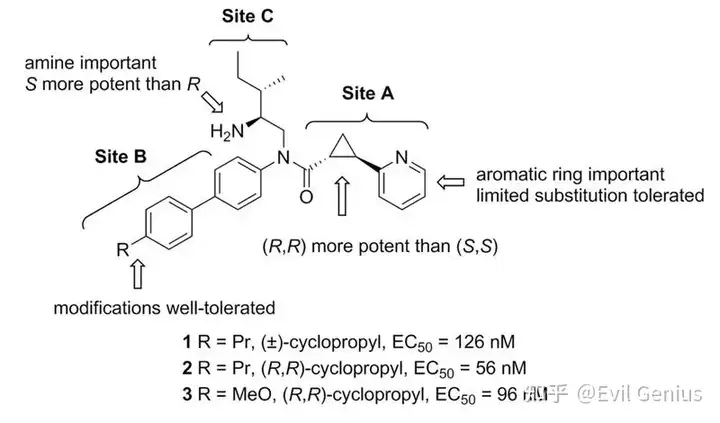
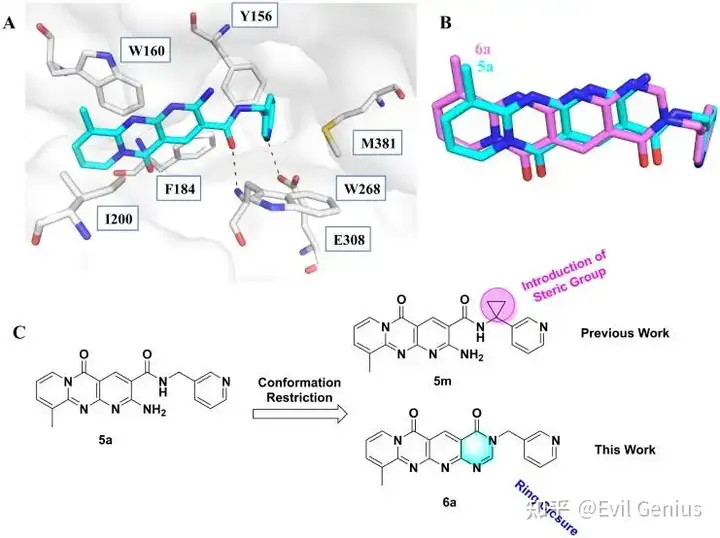
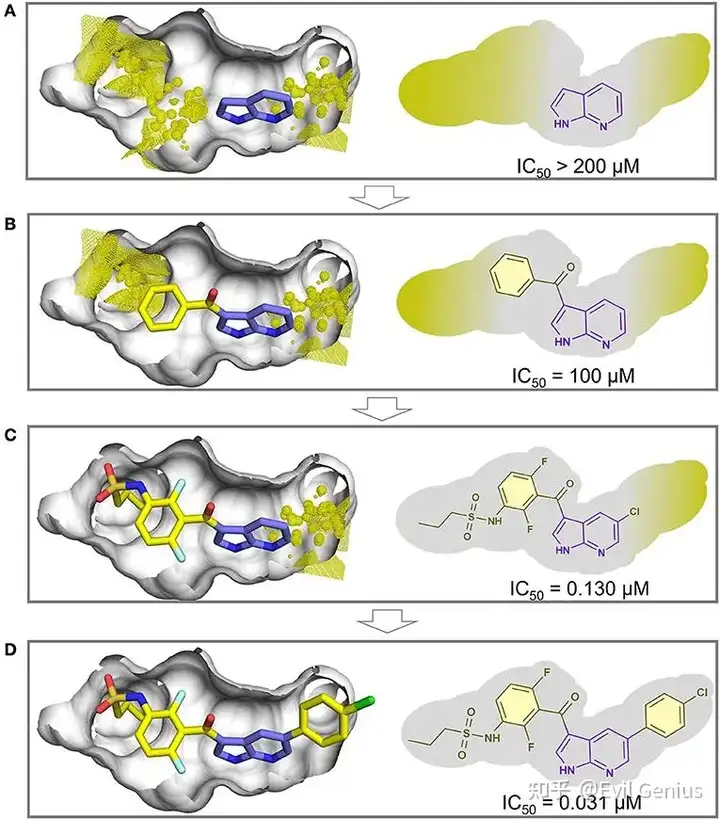
把分子拆成:
R1
              |
        ┌──────────┐
        │          │
   R2 ──│  CORE    │── R3
        │          │
        └──────────┘
              |
             R4
然后逐个研究:
R1能不能改变?
例如:
R1 = H
R1 = CH3
R1 = F
R1 = Cl
R1 = OCH3
R1 = CF3
R1 = CN
R2能不能改变?
phenyl
   ↓
pyridyl
   ↓
pyrimidyl
   ↓
cyclopropyl
linker能不能改变?
-Core-CH2-CH2-N-
       ↓
-Core-CH2-N-
       ↓
-Core-NH-
       ↓
-Core-O-
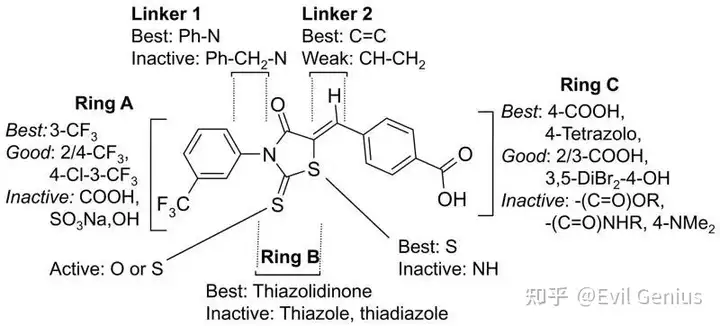
这就是经典的 SAR(Structure–Activity Relationship)分析。
SAR 的核心就是观察:
“分子的哪个结构变化导致活性增加或降低?”
这类结构—活性关系是先导优化的核心依据。
四、方案①:R-group优化——最常用
这是虚拟筛选 hit 最容易开展的一种优化。
例如:
R
          |
       ┌─────┐
       │Core │
       └─────┘
          |
        NH-CH3
第一轮不要大改核心骨架。
而是:
R = H
R = F
R = Cl
R = Br
R = CH3
R = OCH3
R = CF3
R = CN
得到:
Compound | R | IC50 |
|---|---|---|
1 | H | 2.4 μM |
2 | F | 1.1 μM |
3 | Cl | 0.42 μM |
4 | Br | 0.65 μM |
5 | CH3 | 1.8 μM |
6 | OCH3 | 0.35 μM |
7 | CF3 | 0.12 μM |
于是得到一个非常有价值的 SAR:
H       2.4 μM
│
├── CH3       1.8 μM
│
├── F         1.1 μM
│
├── Cl        0.42 μM
│
├── OCH3      0.35 μM
│
└── CF3       0.12 μM
这时再进行:
Docking → MD → 结合模式分析 → 新一轮设计
而不是一次性大量乱改。
五、方案②:结合口袋“空腔填充”
假设 docking 显示:
Protein
   ┌─────────────────┐
   │                 │
   │    ┌───────┐    │
   │    │Ligand │    │
   │    └───────┘    │
   │          ↑      │
   │       空腔      │
   └─────────────────┘
如果 ligand 周围存在明显空腔:
Ligand ────────→ 空腔可以增加:
CH3
F
Cl
phenyl
cyclopropyl
heterocycle
例如:
Hit
 │
 ├── +CH3
 │
 ├── +ethyl
 │
 ├── +phenyl
 │
 └── +heteroaryl
然后重新:
生成3D结构
      ↓
能量优化
      ↓
Docking
      ↓
MD
      ↓
MM-PBSA
      ↓
ADMET
结构基础优化中,分子建模可以帮助分析 docking pose、药效团和 SAR,从而缩小实际需要合成的化合物范围。
六、方案③:利用氢键优化活性
假设原始 Hit:
Ligand-NH
      │
      │ H-bond
      ↓
     ASP
那么可以研究:
-NH2
-NHCH3
-NHCO-
-O-
-S-
例如:
修改 | H-bond | 活性 |
|---|---|---|
原始 NH | 1 | 2.1 μM |
NHCH3 | 1 | 0.8 μM |
NHCO | 2 | 0.35 μM |
O | 0 | 15 μM |
这就能够判断:
这个位置是不是必须保留 H-bond donor?
这类分析可以结合 docking pose、晶体结构和 MD 来判断。
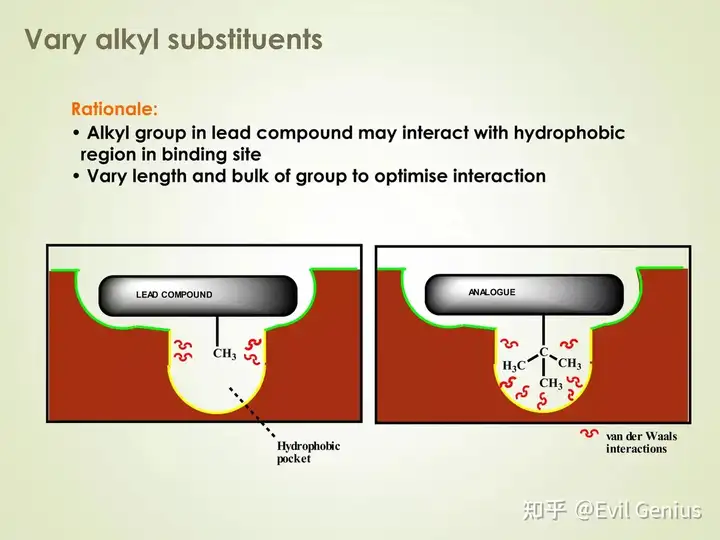
七、方案④:疏水口袋优化
如果 docking 显示:
Phe
Leu
Val
Ile
Met
形成一个疏水口袋:
Phe
      \
Leu — Ligand — Val
      /
     Ile
那么可以尝试增加疏水基团:
CH3
ethyl
isopropyl
cyclopropyl
phenyl
CF3
但是这里存在一个非常重要的原则:
不是疏水基团越大越好。
例如:
CH3       ↑
ethyl     ↑
phenyl    ↑↑
biphenyl  ↓
当体积超过 pocket 容量以后,反而可能导致:
- steric clash
- ligand displacement
- binding pose变化
- 活性下降
八、方案⑤:提高选择性——做“选择性口袋”
这个策略非常重要。
假设靶点:
Target A
Target B
两个蛋白 ATP pocket 很相似。
可以比较:
Target A
     ↓
关键残基
     ↓
可以形成额外 H-bond

Target B
     ↓
对应位置不同
     ↓
无法形成 H-bond
然后针对这个差异设计:
Ligand
          │
          ↓
      特异性基团
          │
     ┌────┴────┐
     ↓         ↓
 Target A   Target B
   强结合     弱结合
因此优化目标不应该只有:
IC50 ↓
还应该关注:
Target A IC50 ↓ + Target B IC50 ↑
也就是:
potency + selectivity 同时优化。
九、方案⑥:利用3D-QSAR指导优化
例如已经获得:
30个类似物
       ↓
实验 IC50
       ↓
pIC50
       ↓
分子叠合
       ↓
CoMFA / CoMSIA
得到 contour map:
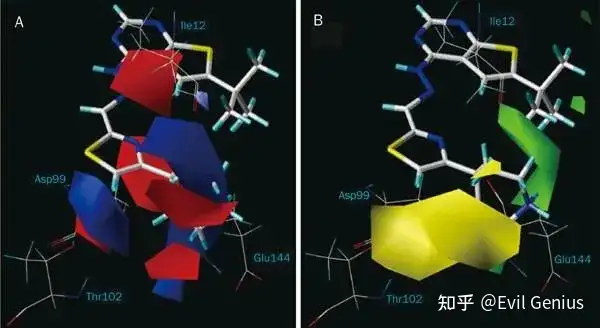
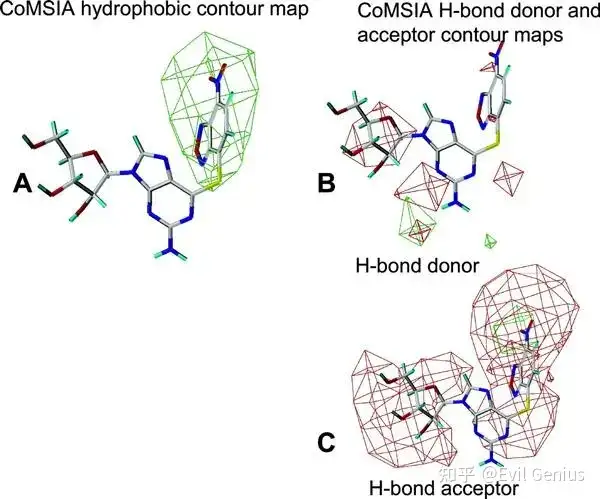
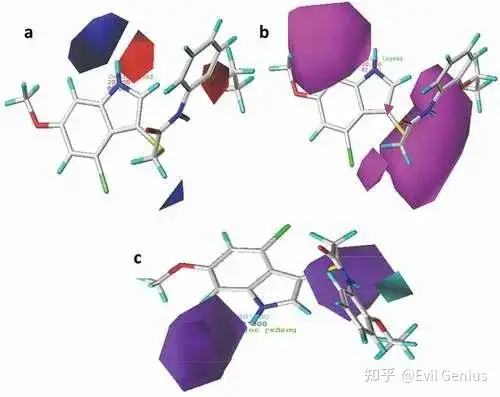
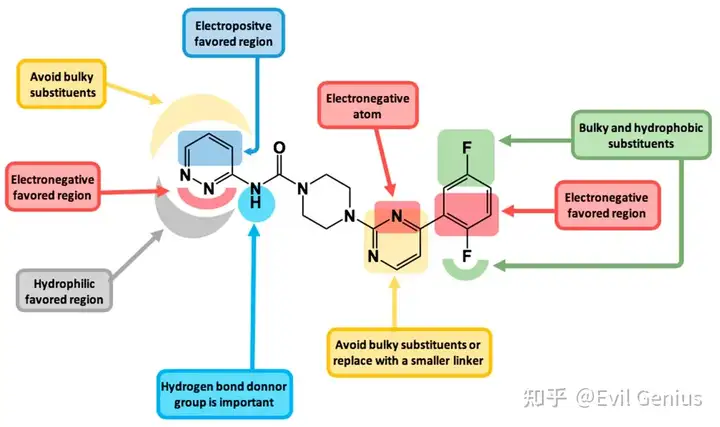
例如:
GREEN
   有利于体积增加
          ↓
      ┌───────┐
      │Ligand │
      └───────┘
          ↑
       YELLOW
    不适合增加体积
那么下一代化合物可以直接按照 contour:
绿色区域
   ↓
增加 CH3 / phenyl

黄色区域
   ↓
减少体积
这就从:
“凭经验改结构”
变成:
“根据3D-QSAR空间场改结构”。
十、方案⑦:Docking + MD 做二次筛选
假设设计了:
100个新化合物
没必要全部进入实验。
可以:
100 compounds
      ↓
Docking
      ↓
50
      ↓
Interaction fingerprint
      ↓
30
      ↓
MD
      ↓
20
      ↓
MM-PBSA
      ↓
10
      ↓
ADMET
      ↓
5–10
      ↓
实验合成
尤其可以观察:
RMSD
Ligand RMSD
Protein RMSD
Hydrogen bonds
Ligand
 │
 ├── ASP
 ├── GLU
 └── HIS
Binding free energy
例如:
Compound | Docking | ΔGbind |
|---|---|---|
Hit | -8.1 | -42 |
A1 | -8.7 | -51 |
A2 | -9.0 | -57 |
A3 | -8.9 | -48 |
这些指标可以作为候选排序和机制分析的辅助证据,而不是把单一计算指标当作实验活性的替代物。
十一、方案⑧:ADMET优化
假设:
Hit
IC50 = 0.3 μM
看起来很好。
但是:
CYP inhibition      ✗
hERG                 ✗
Solubility           ✗
Metabolic stability  ✗
Permeability         ✗
那么这个分子仍然可能不是好的 lead。
因此下一轮优化应该变成:
Lead
                     │
        ┌────────────┼────────────┐
        ↓            ↓            ↓
      Potency     Selectivity    ADMET
        │            │            │
       IC50         IC50         CYP
       EC50         panel        hERG
       Ki                         solubility
                                  stability
现代先导优化通常就是在这些目标之间进行多参数平衡,而不是只追求最高 potency。
十二、一个非常典型的实际优化案例
假设 VS 得到:
Hit-01
F
         │
   Ph—NH—Core—CH3
实验:
IC50 = 3.2 μMDocking发现:
Phe
          │
      ┌──Ligand──┐
      │           │
     ASP         Leu
发现右侧存在一个疏水空腔。
第一轮:R-group scanning
Hit-01
  │
  ├── CH3
  ├── F
  ├── Cl
  ├── CF3
  └── phenyl
假设结果:
化合物 | IC50 |
|---|---|
Hit-01 | 3.2 μM |
A1 | 1.5 μM |
A2 | 0.8 μM |
A3 | 0.31 μM |
A4 | 0.15 μM |
A5 | 0.72 μM |
发现:
CF3最好,phenyl反而下降。
说明 pocket 可以容纳一定体积,但不是无限扩大。
第二轮:优化 linker
CF3
       │
Core-NH-CH2-
测试:
NH-CH2
NH-CH2-CH2
NH
O-CH2
S-CH2
找到:
Core-NH-CH2-CF3活性:
0.15 μM
 ↓
0.035 μM
第三轮:选择性优化
发现:
Target A     35 nM
Target B     2.8 μM
选择性:
Target B / Target A
≈ 80-fold
这时候才开始真正进入:
Lead Optimization
十三、另一个经典思路:Fragment Growing
如果 VS 得到的不是一个很强的 hit,而是:
IC50 > 100 μM但是 docking 显示它稳定占据 pocket 的一个热点区域,那么可以进行:
Fragment Growing
Fragment
           ↓
       ┌───────┐
       │       │
       └───────┘
           ↓
       增加基团
           ↓
    ┌────────────┐
    │ Fragment   │──R
    └────────────┘
           ↓
     占据新亚口袋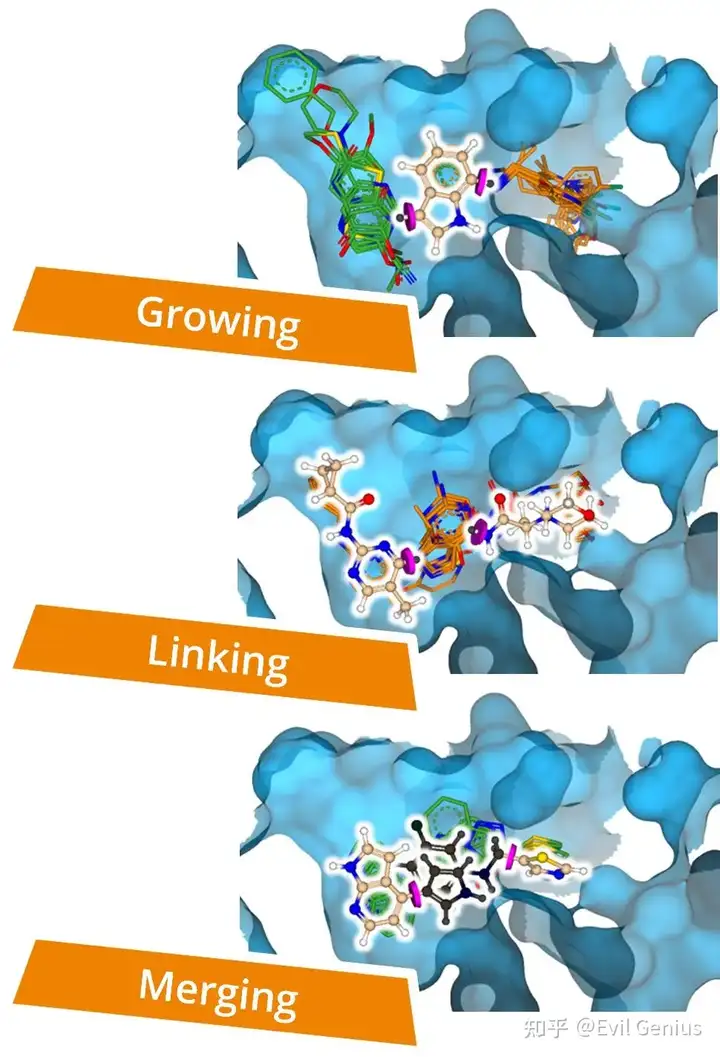
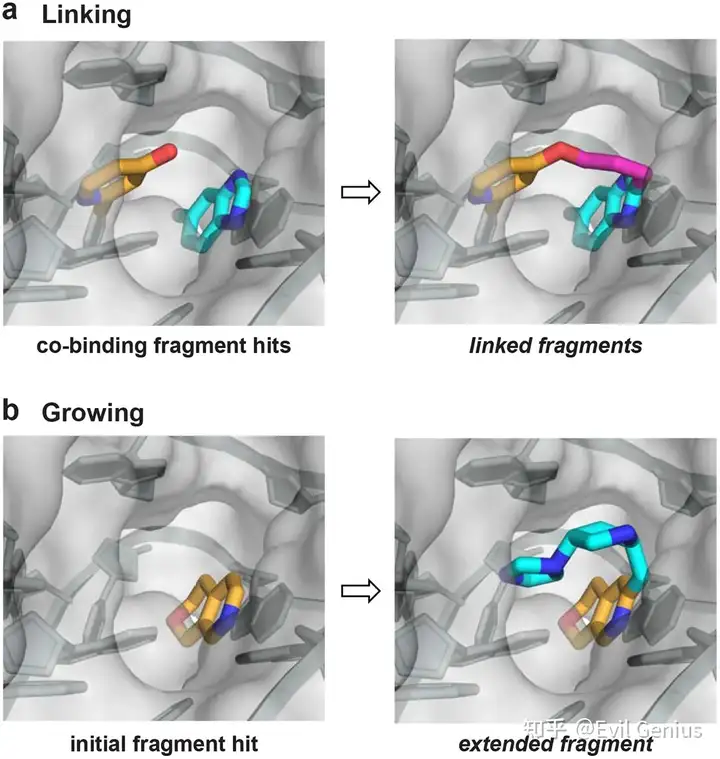
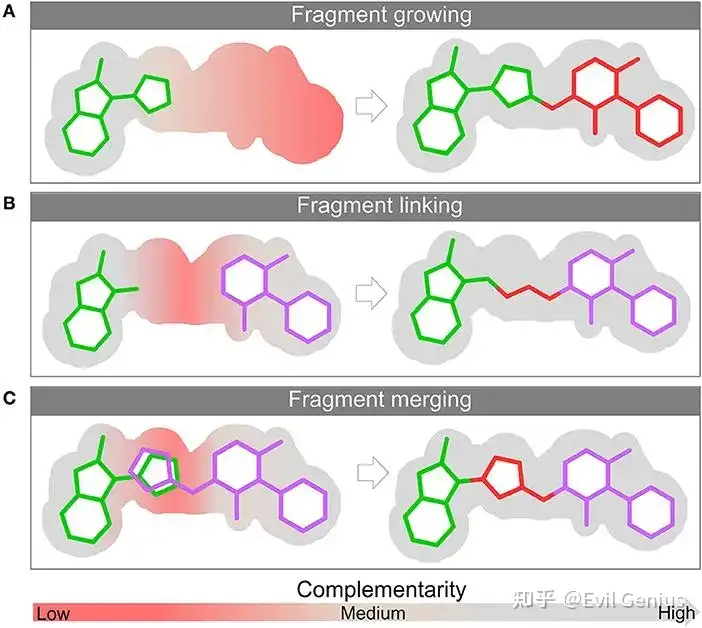
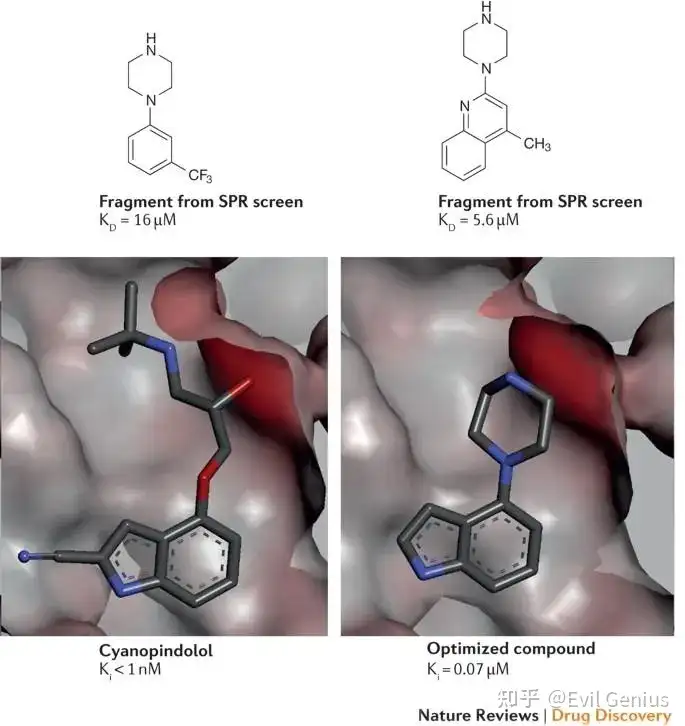
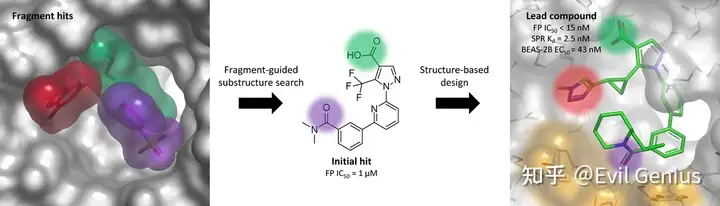
真实的 fragment-to-lead 工作中,经常会使用 growing、linking、merging 等策略,把弱结合 fragment 逐渐扩展为更高亲和力的先导结构。
十四、一个非常直观的“药物优化三步法”
第一阶段:找哪里可以改
Docking
  ↓
Binding pocket
  ↓
H-bond
Hydrophobic
π-π
Salt bridge
  ↓
找R1/R2/R3
↓
第二阶段:系统改变
R1
├── H
├── F
├── Cl
├── CH3
├── OCH3
└── CF3

R2
├── phenyl
├── pyridyl
├── pyrimidyl
└── cyclopropyl
↓
第三阶段:数据驱动
实验活性
    ↓
SAR
    ↓
3D-QSAR
    ↓
Docking
    ↓
MD
    ↓
ADMET
    ↓
下一轮化合物这就是一个完整的计算辅助药物先导优化闭环。
十五、完整流程
虚拟筛选
                   ↓
             AutoDock Vina
                   ↓
            筛选 Top hits
                   ↓
             Hit验证
                   ↓
         ┌─────────┴─────────┐
         ↓                   ↓
    Binding analysis       SAR
         ↓                   ↓
      Docking             R-group
         ↓                   ↓
         └─────────┬─────────┘
                   ↓
             3D-QSAR
        ┌──────────┴──────────┐
        ↓                     ↓
      CoMFA                  CoMSIA
        └──────────┬──────────┘
                   ↓
             设计新化合物
                   ↓
             Docking筛选
                   ↓
               GROMACS
                   ↓
           MD / RMSD / H-bond
                   ↓
             MM-PBSA
                   ↓
              ADMET预测
                   ↓
            合成候选化合物
                   ↓
              实验验证
                   ↓
              新一轮SAR
↺这个流程特别适合虚拟筛选 → 3D-QSAR → 分子动力学体系。
另外,一个很实用的原则是:不要把“活性优化”理解成单纯让 docking score 变得更负。 现代先导优化更强调 potency、selectivity、物化性质、ADME/Tox 和合成可行性的多参数平衡;优化过程中往往伴随结构复杂度、sp³碳、HBA等多方面变化,而不是单一指标的改善。
生活很好,有你更好。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号