个人知识库从 0 到 1:ima 结构化笔记法
原创
个人知识库从 0 到 1:ima 结构化笔记法
原创
华东子
发布于 2026-09-29 07:07:40
发布于 2026-09-29 07:07:40
写给收藏了几百篇文章、要用时却一篇找不到的你:收藏不等于拥有。这篇用 ima(腾讯 AI 知识库(Knowledge Base)工具)从零搭一个"会答你话"的个人知识库,四步走完,今晚就能建好骨架。
一、问题 收藏夹不等于知识库
先对一对,这些症状你有没有:
- 收藏即终点。微信里收藏的文章、浏览器里的书签、硬盘里的 PDF,存的时候心想"以后用得上",两年过去一篇没打开过。
- 要用时靠"记忆检索"。明明记得看过一篇讲"提示词怎么写"的文章,翻遍三个收藏夹愣是找不到,最后重新搜了一遍。
- 笔记散落不成体系。手机备忘录一条、ima 一条、聊天记录里还有几条——同一个主题的知识散在四处,永远拼不成一张图。
问题的根子不在"你存得不够多",而在只有"收集"这个动作,没有"结构"。资料没有骨架、没有标签、没有沉淀回路,存多少都是乱的——官方教程里有个说法:文件过了 100 份,没有方法的知识库就开始混乱。
好消息是:从 0 到 1 建一个不乱的知识库,方法比工具重要,而方法四步就能说清。下面用 ima 完整走一遍。
二、如何解决 使用ima 结构化笔记法四步
核心思路一句话:先搭骨架、再收料,用文件夹+标签双维度归位,让 AI 把厚资料提炼薄,最后每周把成熟笔记回灌知识库——形成"收→炼→记→沉"的闭环。
先看清 ima 里两套东西的关系(官方定义):知识库 = 收藏的资料,笔记 = 你自己写的内容;笔记里可以随时引用知识库的资料,成熟笔记还能回流知识库。这套笔记法就是把两套东西用一个闭环串起来:
第一步:搭骨架(15 分钟,只做一次)
打开 ima → 点「+」→ 新建知识库,按你的使用场景(而不是资料类型)建一级分类。官方教程给的原则很硬:一级分类不超过 7 个,文件夹层级不超过 3 层。比如职场人的综合库:
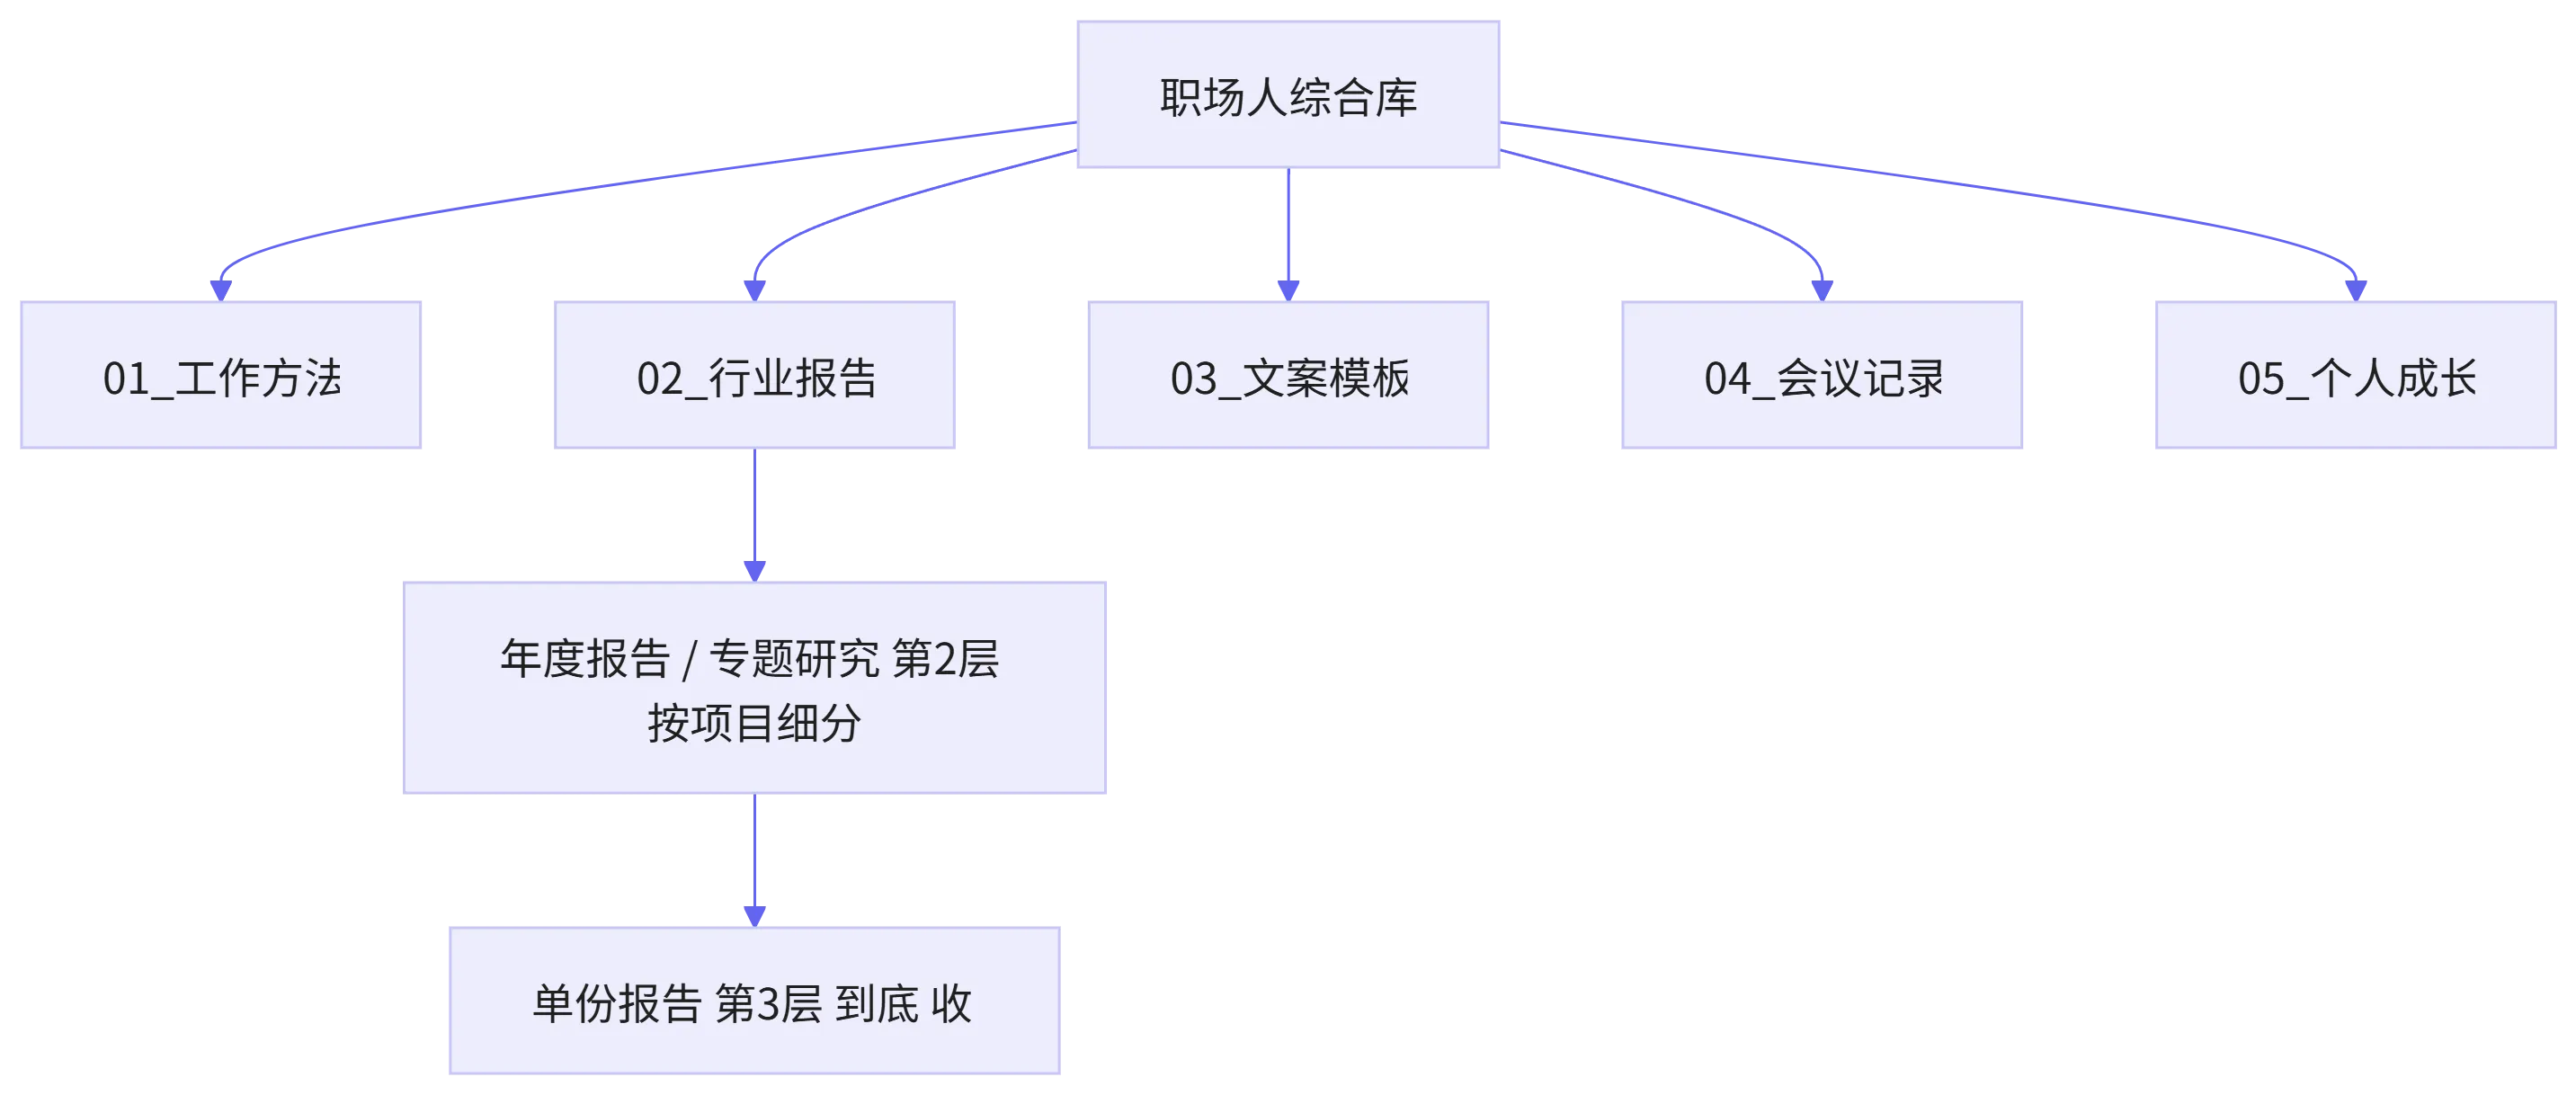
flowchart TD
    R["职场人综合库"] --> C1["01_工作方法"]
    R --> C2["02_行业报告"]
    R --> C3["03_文案模板"]
    R --> C4["04_会议记录"]
    R --> C5["05_个人成长"]
    C2 --> S1["年度报告 / 专题研究<br />第2层 按项目细分"]
S1 --> S2["单份报告<br />第3层 到底 收"]注释(判定标准):分类按"你会怎么用它"划分,不按"资料长什么样"划分——判断一条资料放哪,3 秒内能决定就说明骨架合格;要犹豫超过 10 秒,说明分类太细或边界模糊,砍掉一层。
第二步:双维度归位(文件夹管存放,标签管检索)
骨架只是"往哪放",真正让检索快起来的是标签这一第二维度。ima 支持给文件/笔记打标签(长按文件 →「编辑标签」),官方教程的打法是两类标签配合:
标签类型 | 例子 | 作用 |
|---|---|---|
主题标签 | #提示词 #项目管理 #AI工具 | 跨文件夹检索——一篇讲"AI 写周报"的文档,放在 01_工作方法,但打上 #提示词 就能和别的 AI 素材串起来 |
状态标签 | #待整理 #已提炼 #可引用 #已过时 | 管内容生命周期——一眼看出哪些还没消化、哪些能用 |
命名也有讲究,官方知识博主的格式可直接抄:【核心主题】具体标题-关键词1-关键词2-日期。配合全文搜索和 AI 问答,文件过百也能秒定位。
第三步:AI 提炼,让资料"变薄"
存进来的资料不是终点。ima 的 AI 能力(问答基于检索增强生成(RAG,Retrieval-Augmented Generation))可以把 50 页报告 3 分钟变成结构化笔记:
- 让 AI 生成要点:导入报告后问"提炼每章 3-5 个核心观点",把 AI 拆解结果和自己的理解对照着读;
- 写知识卡片:每个重要文件写一张卡——主题 + 核心问题 + 关键结论 + 适用场景,存为一条笔记;
- 笔记里用「AI 帮写」:输入
/调出 AI 助手,让它在笔记里续写、润色、总结;对话里得到的好答案,点结果右侧的「笔记」按钮一键保存到笔记中心。
关键动作:AI 提炼的结果必须过你的脑子——和原文对照、补上你的判断,再存。跳过这一步,知识库就变成"AI 说的存放处",不是你的第二大脑。
第四步:每周沉淀,形成复利闭环
官方教程里面推荐了一个比较简单的做法:每周五花 15 分钟,把本周成熟的笔记导入知识库(笔记 → 知识库沉淀通道)。这样下周问答时,AI 就能引用你自己的笔记来回答——你写的东西变成了会答你话的资料。
四步连起来,就是这张闭环图:
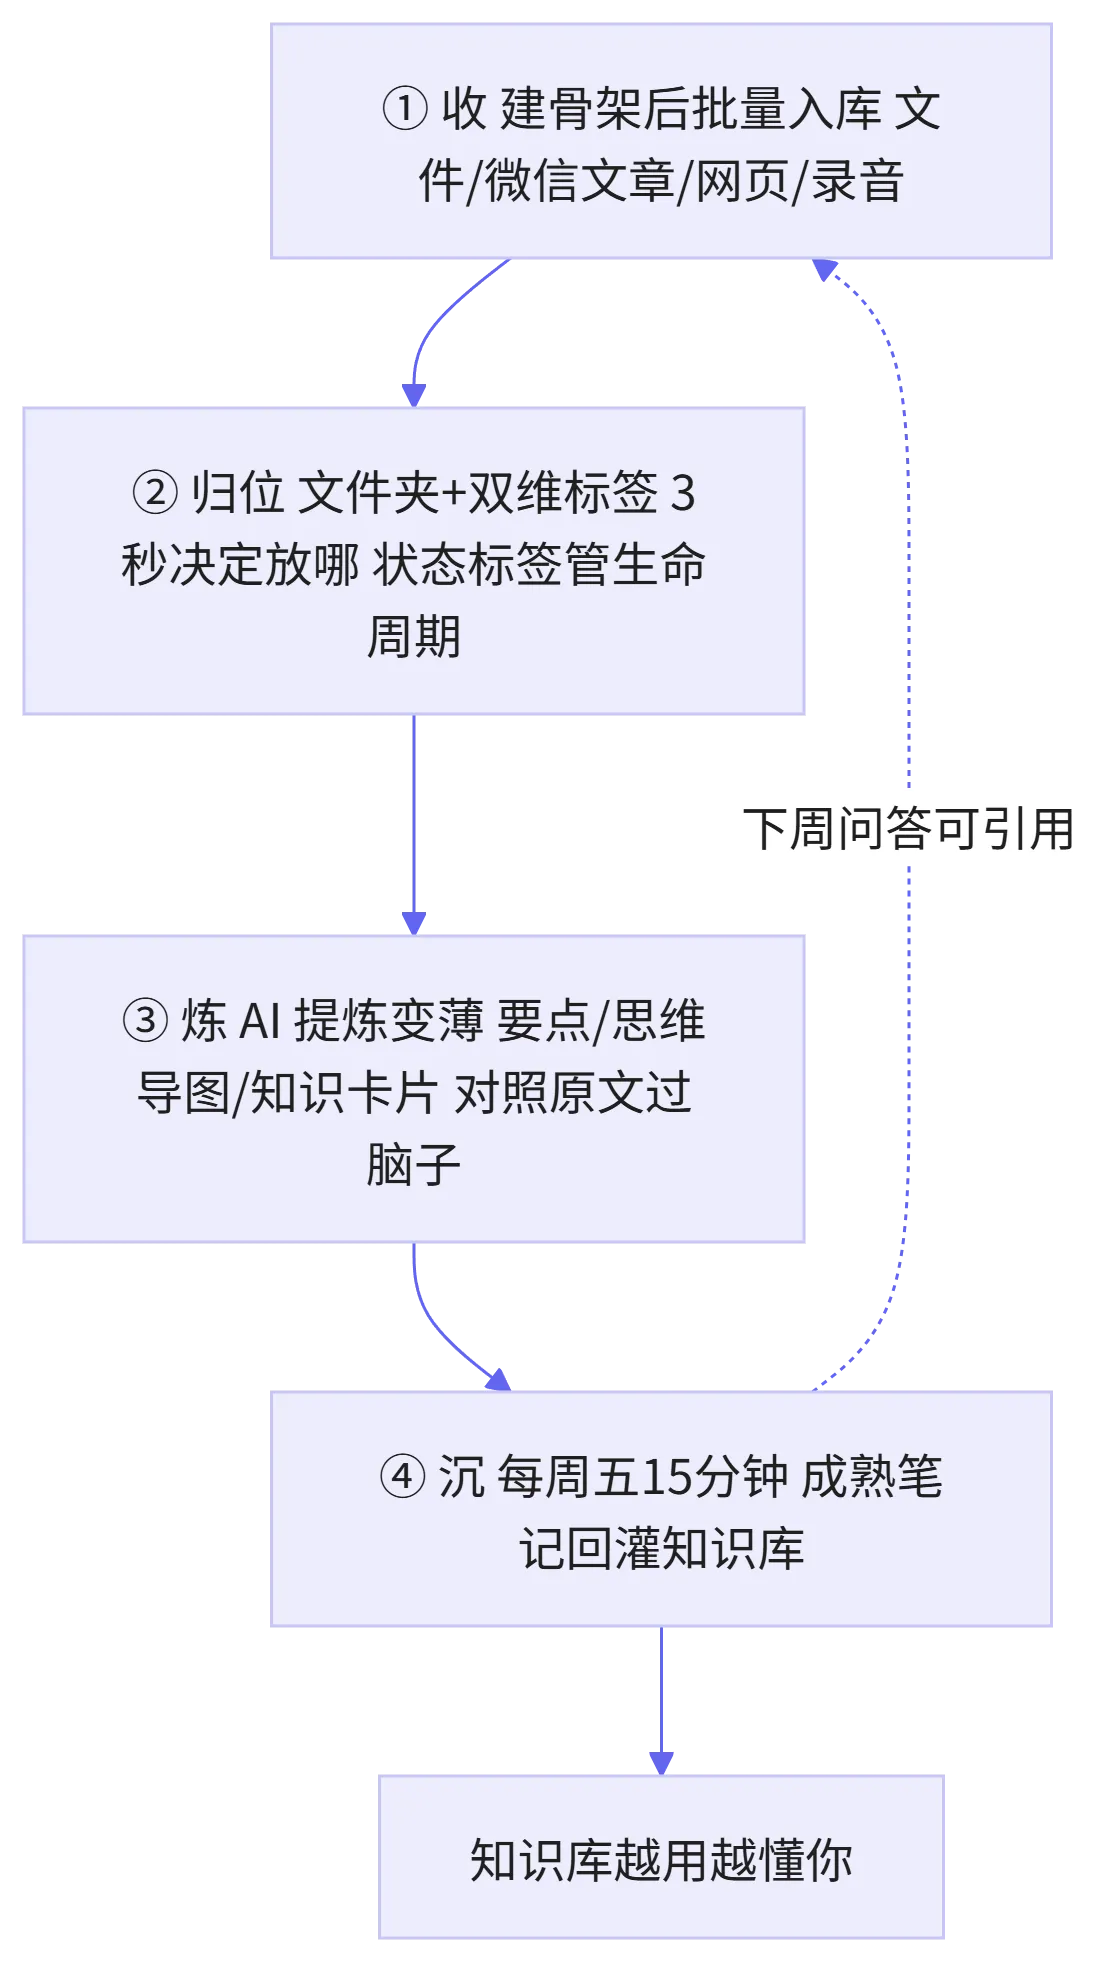
flowchart TD
    A["① 收 建骨架后批量入库<br />文件/微信文章/网页/录音"] --> B["② 归位 文件夹+双维标签<br />3秒决定放哪 状态标签管生命周期"]
    B --> C["③ 炼 AI 提炼变薄<br />要点/思维导图/知识卡片<br />对照原文过脑子"]
    C --> D["④ 沉 每周五15分钟<br />成熟笔记回灌知识库"]
    D -.->|下周问答可引用| A
D --> E["知识库越用越懂你"]注释说明一下(管控要求):闭环的发动机是第④步——没有"沉",前面三步只是整理;有了"沉",你写的每条笔记都在给下周的问答喂料,这才是"从 0 到 1 之后还能从 1 到 100"的原因。
一条资料从收到能引用,完整生命周期如下(照着判断每条资料走到哪了):
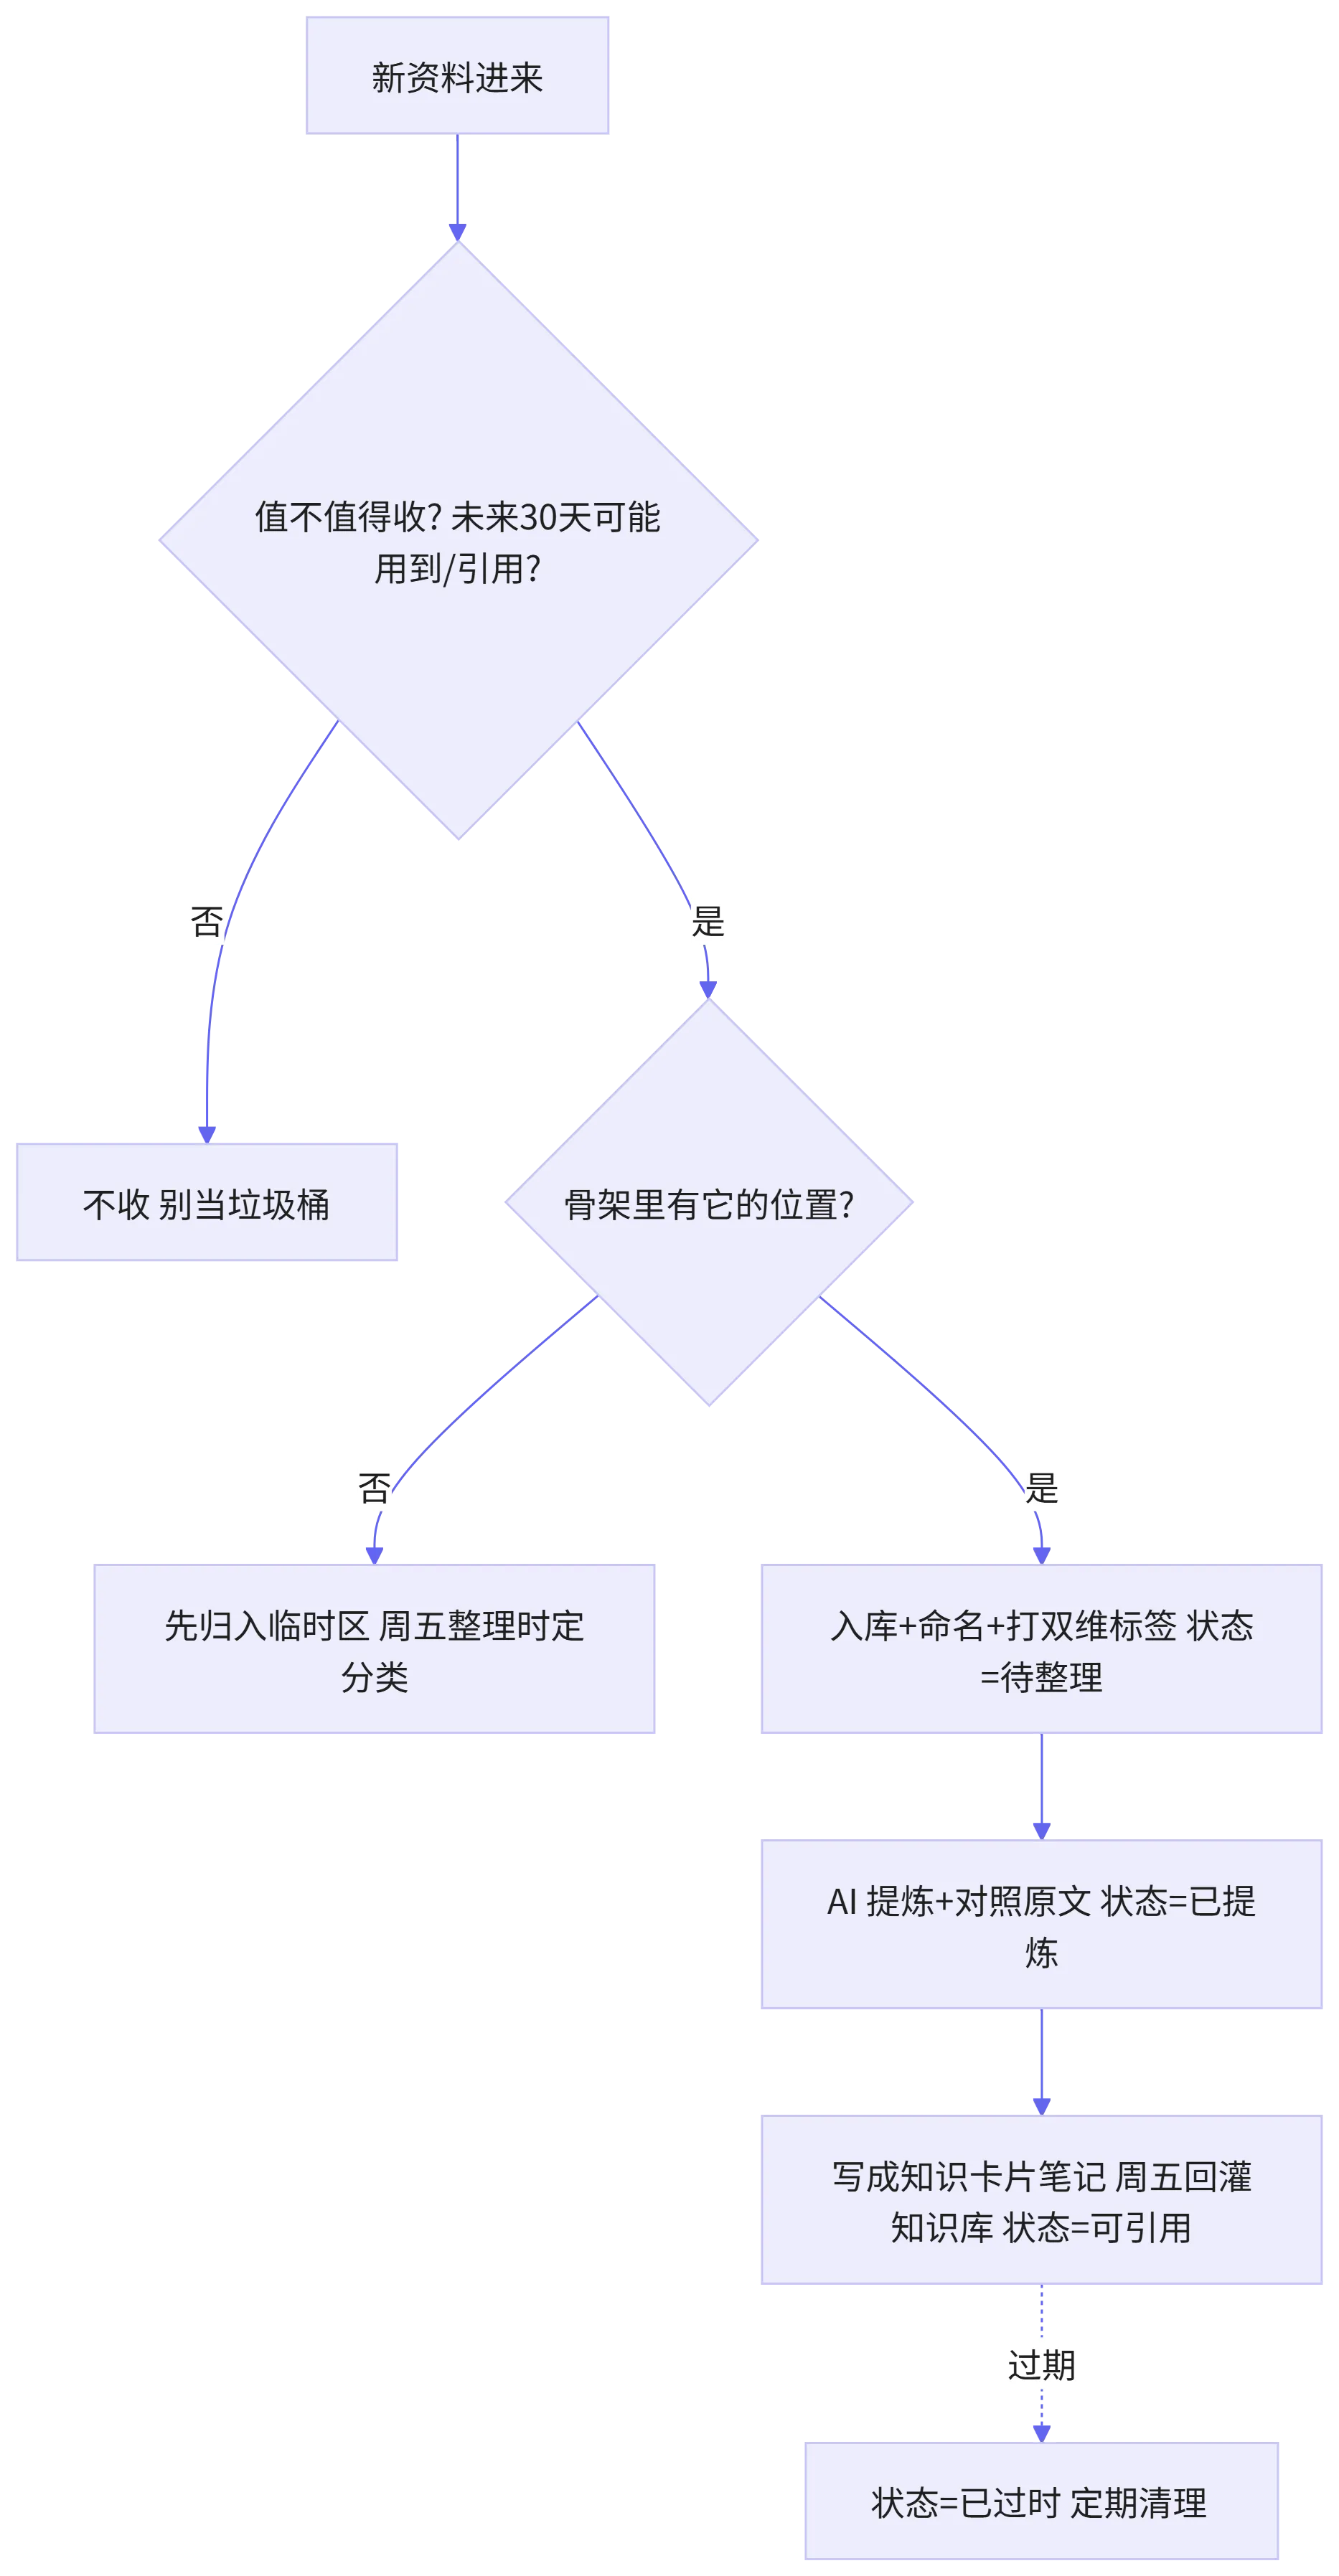
flowchart TD
    N["新资料进来"] --> Q1{"值不值得收?<br />未来30天可能用到/引用?"}
    Q1 -->|否| X["不收 别当垃圾桶"]
    Q1 -->|是| Q2{"骨架里有它的位置?"}
    Q2 -->|否| F["先归入临时区<br />周五整理时定分类"]
    Q2 -->|是| W["入库+命名+打双维标签<br />状态=待整理"]
    W --> R["AI 提炼+对照原文<br />状态=已提炼"]
    R --> P["写成知识卡片笔记<br />周五回灌知识库 状态=可引用"]
P -.->|过期| O["状态=已过时 定期清理"]注释(判定标准):每个状态标签对应一个明确动作——"待整理"必须归位、"已提炼"必须过脑、"可引用"才算资产;月末扫一遍"已过时"标签,敢删才敢存。
三、为什么这套方法有效
1. 结构降低决策成本,AI 补上检索短板。 知识管理最贵的不是存储,是"每次决定往哪放、怎么找"的注意力。≤7 分类 + ≤3 层 + 双维标签,把"往哪放"的决策压到 3 秒;而 ima 的 RAG 问答让你不必记住"存在哪"——你只管问,它负责找。结构管确定性,AI 管模糊性,正好互补。
2. "笔记 → 知识库"回流是复利的来源。 传统笔记工具里,你写的东西只是"存着";ima 里,回灌的笔记会进入向量索引,成为问答的引用来源。这意味着你越写,AI 越懂你的上下文——第一次问"我的选题方法是什么"它只能答通用内容,沉淀三个月后它能用你自己的笔记回答你。这是"从 0 到 1"和"从 1 到 100"的分界。
3. 状态标签对抗"知识库熵增"。 库乱的本质是资料只有"进"没有"出"和"清"。待整理/已提炼/可引用/已过时四个状态,逼着每条资料走完生命周期,而不是永远躺在"待整理"里假装被拥有。
四、总结提示
- 第一周别追求完美分类。 骨架先粗后细:先按使用场景建 3-5 个大分类跑两周,发现某类总犹豫再拆。一步到位的完美主义,是知识库烂尾的第一原因。
- 别把 ima 当垃圾桶。 "可能有用"不是收藏理由,"30 天内会用到/引用"才是。收藏前的 10 秒判断,省掉之后 100 分钟的清理。
- 敏感资料先脱敏再入库。 ima 是云端库,合同、账号、客户信息这类内容,入库前抹掉关键字段;更私密的笔记,配合本地工具(如 Obsidian)分工——这正是 #5 说的"入口图快、仓库图稳"。
- AI 提炼≠你可以不读。 让 AI 出要点是为了"对照着读更省力",不是为了替你读。知识卡片里"你的判断"那一栏才是资产,AI 给的只是草稿。
- 每周 15 分钟,雷打不动。 沉淀动作一旦断两周,闭环就断,库重新变乱。设个固定提醒(用 WorkBuddy 的自动化也行),把它变成周结仪式。
- 能力有时效。 本文功能与教程口径基于 2026 年 9 月 ima 官方 wiki 与公开资料;功能入口与版本迭代快,具体以你手上的 ima 当前版本为准。
知识库建好了、闭环跑起之后,后面可以有两个自然的进阶方向:
共享知识库(把个人库方法用到团队,ima 支持共享库与成员权限);
与本地笔记分工(ima 收散料问答、Obsidian 沉淀长青笔记,接力不打架)。
至此,首月 12 篇全部完结——从"选哪个大模型"一路讲到"个人知识体系"
- 关注本专栏,下月进入第二个月度循环(实战月):智能体工作流实战 + 可运行案例连载。
披露声明(AI 辅助创作,含 AI 生成内容):本文由作者基于真实的知识库搭建经验撰写,使用 AI 工具辅助润色;文中含 AI 生成内容,经作者审核修订。核心观点、四步笔记法组织与结论均由作者负责。文中 ima 功能与官方教程口径基于 2026 年 9 月公开资料(官方 wiki/教程),具体以产品当前版本为准。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号