判断引擎落地 .NET 的四条路线、一个客户端与一份生产样本

判断引擎落地 .NET 的四条路线、一个客户端与一份生产样本
张善友
发布于 2026-09-29 08:21:26
发布于 2026-09-29 08:21:26
很多业务场景要的其实不是一段话。
客服系统收到一条消息,要的是"转账单组还是技术组";审核系统拿到一张图,要的是"过还是不过";工单系统要的是一个严重度评分。答案就是一个选项、一个概率、一个分数,程序拿到就走自己的逻辑,没有人去读它。
但过去的通行做法是:把整段文本发给前沿大模型,让它"按 JSON 格式输出",然后祈祷它这次不要多写一句解释、不要漏一个括号。格式错了就重试,字段类型不对再修一遍——用过的人都知道这条路有多烦。
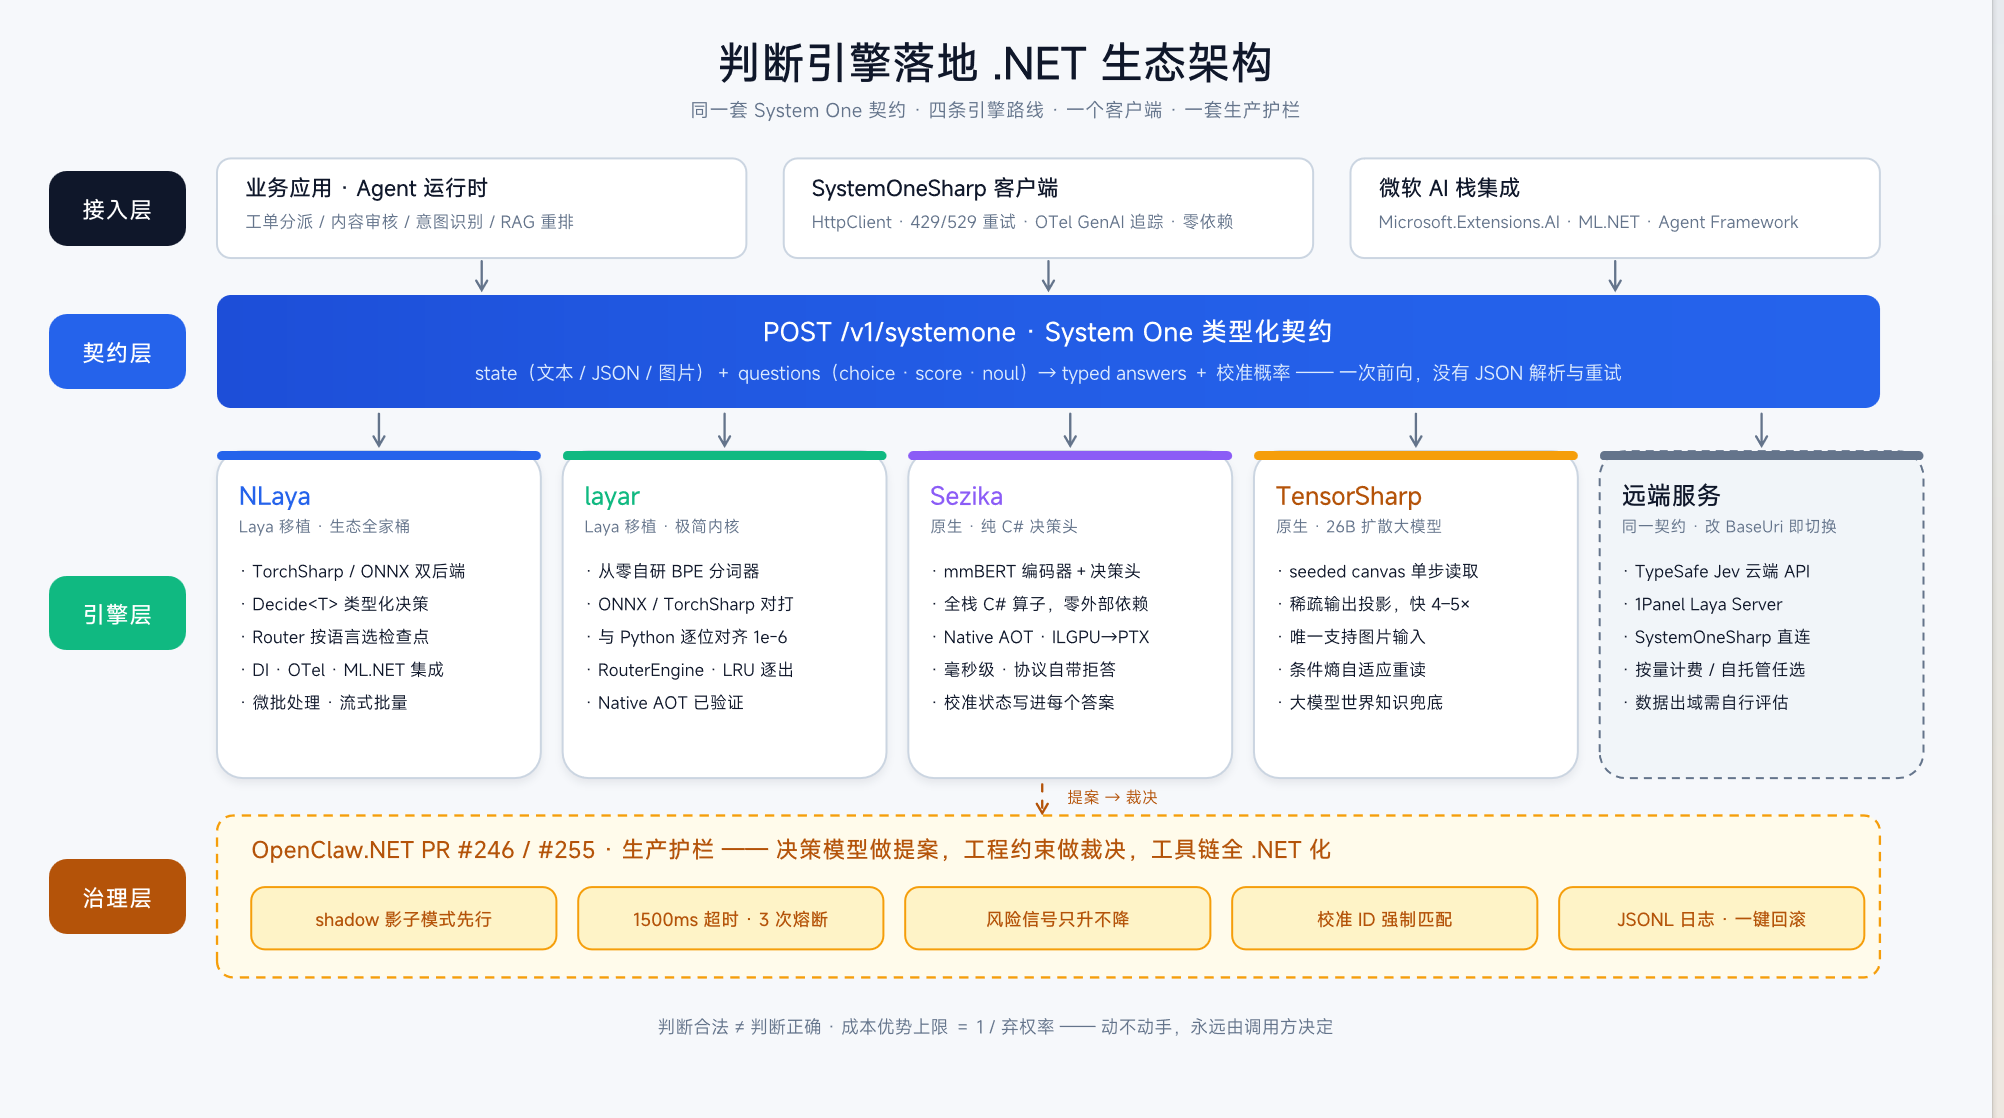
最近一个月,这个局面被一个叫 Jev 的闭源模型和它的开源对手 Laya 彻底搅动了。更有意思的是,这股浪潮几乎立刻冲进了 .NET 生态:先是 Laya 的两个独立移植 NLaya 和 layar 前后脚出现,紧接着又出现了两条思路截然相反的 .NET 原生实现路线——用 26B 扩散大模型"单步读取"的 TensorSharp,和用小编码器加决策头的 Sezika;与此同时,社区还补上了客户端这一环——SystemOneSharp,一个把所有兼容服务统一起来的类型化 HTTP 客户端。而自托管 Agent 运行时 OpenClaw.NET 的 PR #246 与紧随其后的 PR #255,则演示了把这套东西真正接进生产需要过多少道关卡——以及它最终如何收敛成一个纯 .NET 的技术栈。
这篇文章把这条链路从头拆到尾:判断引擎到底是什么、它解决了什么问题,以及在 .NET 里你有哪四条引擎路线、一个客户端可以走,最后看一份把它开上生产路的真实样本。
image
一、先看懂背景:Jev 与 Laya 的"九天三国杀"
2026 年 9 月 15 日到 9 月 24 日,九天里发生了三件事:TypeSafe AI 发布闭源决策模型 Jev;Convai Innovations 开源了对标的 Laya;1Panel 把 Laya 封装成 Laya Server 上架应用商店。
三件事单独看都是新闻,串起来看是一条完整的产业信号:"判断"正在从"生成"里被剥离出来,成为一层独立的基础设施。
Jev:System 1 模型
Jev 出自 TypeSafe AI,创始人 Diogo Almeida 是前 OpenAI 研究员、RLHF 的共同发明者之一。他反复问的一个问题是:模型在对话上超越人类已经好几年了,那么自动化到底在哪里?
他自己的回答是:我们一直用最贵、最慢、最不确定的工具,去干最廉价、最需要确定性的活。
Jev 的名字取自 Daniel Kahneman 的双系统理论——System 1 是快速、直觉的判断,System 2 是缓慢、审慎的推理。Chat 模型和推理模型都在追 System 2(一步一步想),Jev 做的是 System 1:像一个熟练的客服扫一眼工单就知道该转给谁,不解释、不展开、不写理由,只给结论和把握程度。
调用形态被压缩成两个概念:
- state:一段上下文。可以是一封邮件、一条工单、一条告警记录、一段 JSON;
- questions:一组你事先定义好类型的问题。
模型一次前向传播把整批问题全部算完,返回带概率的答案。没有 token 逐个采样,没有 JSON 需要修复。它的全部表达能力由三种原语构成:
原语 | 作用 | 返回 | 典型用法 |
|---|---|---|---|
choice | 从离散选项里挑一个 | 选中的选项 + 概率分布 + 置信度 | 这个工单归 billing / technical / sales? |
score | 在固定等级上打分 | 一个数值 + 分布 + 置信度 | 客户愤怒程度 0–2 打几分? |
noul | 是非判断 | 校准后的 P(true) | 这条消息是否要求退款? |
这里有两个关键设计值得展开。
关键一:答案空间在调用之前就锁死了。 传统做法是在输出之后做校验;Jev 的做法是程序先声明"我要问什么、允许答什么",模型只负责在约束内填概率。它不可能返回错误的类型或畸形结构——这是构造性保证,不是训练出来的好习惯。但它依然可以判错:它保证的是"答案合法",不是"答案正确"。
关键二:校准过的置信度才是判断能进生产的前提。 Jev 和 Laya 都用 RLCD(Reinforcement Learning for Calibrated Decisions)训练,奖励函数是严格 proper scoring rule——只有当模型诚实报告自己的概率时,期望奖励才最大。于是代码可以写成:
if conf >= 0.85:
    route_automatically(dept)      # 高置信度:自动执行
else:
    escalate_to_human(dept)        # 低置信度:转人工,或升级到大模型
"自动化处理大多数 + 阈值兜底少数",才是决策模型真正的产品形态。
代价是:Jev 闭源,只能调 API,数据要出网。这个缺口存在了三天。
Laya:三天后的开源对手
Laya 由 Convai Innovations 于 9 月 18 日发布,Apache 2.0 许可,权重、代码、训练数据全部公开,接口设计几乎一比一对应 Jev。它发布了三个 checkpoint:
Checkpoint | 基座 | 参数量 | 上下文 | 说明 |
|---|---|---|---|---|
laya | ModernBERT-large | 421M | 512 tokens | 英文基础版 |
laya-multilingual | mmBERT-base | 322M | 1024 tokens | 100+ 语言,中文场景用这个 |
laya-typed-decisions | ModernBERT-large | 421M | 512 tokens | 在客服、发票、安全事件、Agent trace 四个工作流上微调 |
但必须泼一盆冷水,Laya 的 model card 自己写得很直白:零样本 typed-decisions 准确率只有 0.362,连"永远猜最多那一类"的多数类基线(0.461)都不如;逐题型重拟合温度参数后,平均 ECE 才能从 0.466 降到 0.081。项目方的原话是:"Laya is a fast base to specialise, not a zero-shot decision engine."——它是一个可快速特化的底座,不是开箱即用的零样本决策引擎。
还有一条来自第三方测算的规律必须记住:成本优势的上限 = 1 / 弃权率。 无论单次判断多便宜,只要有 30% 的判断要回退给大模型,整体最多省 3.3 倍。自托管只省掉了单价,不省掉弃权。
二、NLaya 与 layar:Laya 的两个 .NET 移植
对 .NET 开发者来说,最直接的上车方式是移植版。有意思的是,Laya 发布没多久,.NET 社区就冒出了两个互相独立的移植:NLaya(TorchSharp + ONNX Runtime)和 layar(ONNX Runtime + TorchSharp)。两个都号称与 Python 原版逐位对齐,三个 checkpoint 全部支持,但设计取向不太一样——NLaya 走"生态全家桶"路线,layar 走"精简内核 + 双后端对打"路线。先看 NLaya。
技术栈:站在微软 ML 栈的肩膀上
职责 | 组件 |
|---|---|
分词 | Microsoft.ML.Tokenizers(BpeTokenizer,直接读 checkpoint 的 tokenizer.json) |
张量运算 | System.Numerics.Tensors |
原生推理 | TorchSharp,直接加载 model.safetensors |
ONNX 推理 | Microsoft.ML.OnnxRuntime,跑官方导出的 encoder.onnx + head.onnx |
后端只负责把一批 token id 变成 logits(ILayaBackend.Run),分词、prompt 布局、校准、解码全部在核心库里,所以两个后端给出的答案完全一致。
三分钟上手
using NLaya;
using NLaya.TorchSharp;

await using var agent = await Laya.LoadAsync(
    "convaiinnovations/laya-multilingual", o => o.UseTorchSharp());

var questions = new Questions()
    .Choice("department", "Which team should handle `body`?",
        ("billing", "invoices, payments, refunds"),
        ("technical", "bugs and outages"),
        ("sales", "pricing"))
    .Score("urgency", "How urgent is this?",
        "not urgent", "somewhat urgent", "very urgent")
    .Noul("refund_requested", "Does the sender ask for money back?");

var result = agent.Predict(
    new { body = "I was charged twice for invoice 4411. Please refund me today." },
    questions,
    new PredictOptions { MaxLen = 8192 });

Console.WriteLine(result.Choice("department").Choice);
NLaya 不替你下载模型,用 Hugging Face CLI 拉到标准缓存目录即可;缺模型时报错信息会直接告诉你该跑哪条 hf download 命令。
类型化决策:把答案写成一个 C# record
这是 NLaya 最" .NET 味儿"的能力——用 C# 类型描述答案,拿回来的就是这个类型。每个属性对应一个问题:枚举是 choice,bool 是 noul,带 [Range] 的整数是 score;[Description] 就是 instructions。
public enum Team
{
    [Description("Payments, invoices and refunds")] Billing,
    [Description("Bugs and outages")] Support,
    Other,
}

public sealed record Triage(
    [property: Description("Which team should handle `body`?")] Team Team,
    [property: Description("How urgent is this?"), Range(1, 3)] int Urgency,
    bool NeedsHuman);

[JsonSourceGenerationOptions(UseStringEnumConverter = true)]
[JsonSerializable(typeof(Triage))]
internal partial class AppJson : JsonSerializerContext;

Triage t = agent.Decide(email, AppJson.Default.Triage);   // AOT 安全
配合源生成的 JsonSerializerContext,整条链路在 Native AOT 下可发布、可裁剪——四个核心包都标记了 IsAotCompatible。
生产级的细节一个不少
NLaya 不是玩具移植,它把 Python 库的工程化能力几乎搬全了:
- Router:按请求自动选 checkpoint,非拉丁文字自动路由到 multilingual,支持懒加载、预加载和并发共享加载;
- 批量与流式:
PredictBatch共享前向传播,PredictStreamAsync对接数据库游标、CSV、消息队列,内存有界; - 微批处理:
MicroBatchingPredictor把并发请求攒几毫秒合成一个 batch,这是 GPU 吞吐的正确打开方式; - DI 与可观测性:
AddLaya/AddLayaRouter注册单例,tracing 和 metrics 走标准ActivitySource/Meter,OpenTelemetry 零配置接入; - Microsoft.Extensions.AI 集成:
UseLayaGuardrail在 LLM 看到用户输入之前先做护栏筛查,LayaRouterChatClient用一道 choice 题给请求选模型,还能把判断能力作为工具挂进 Agent 循环; - ML.NET 管道:
mlContext.Transforms.Laya(...)直接在IDataView上追加答案列,CSV 进、分好类的表出。
最后一个场景特别值得展开:用 Laya 给大模型当门卫和路由。每个用户请求先过一道几十毫秒的判断——该不该拦、该给哪个模型答——只有真正需要生成和推理的请求才触达大模型。这正是 Laya 内置 router / guard / moderation 三个 preset 的设计意图,也是 1Panel AI 网关用 Laya Server 替代 Embedding 相似度路由的同款思路:路由规则用自然语言写成 criteria,改一行字就能调整路由行为,不需要标注样本、重建向量、重新部署。
layar:另一个移植,把两个后端放在一起打擂台
layar(nullean 出品)是另一个独立移植,气质和 NLaya 很不一样:它不做生态集成,而是把内核做到极简,然后认真回答一个工程问题——ONNX Runtime 和 TorchSharp 到底哪个快?
它的设计里有几个点很见功力:
- 从零写的 BPE 分词器:
Layar.Tokenization直接读 Hugging Face 的tokenizer.json(byte-level GPT-2 式 + Metaspace/SentencePiece 式都支持),不依赖任何外部分词包,运行时零 Python; - 双后端同一接口:
Layar.Onnx和Layar.TorchSharp都实现IDecisionBackend,可以在同一批请求上互相对打基准;TorchSharp 后端加载的是torch.jit.trace导出的 TorchScript 模块,而不是手工移植的网络结构; - 类型化 Schema 绑定:
IQuestionSchema<T>把固定问题集和答案绑回 record 的方式合在一起,PredictAsync直接返回TriageResult,不用字符串 key 去查字典; - 工程细节拉满:模型生命周期 Router(加载、预载、LRU 逐出)、超 20 个选项时的 embedding 初筛(
Shortlist,精确对齐 Python 的shortlist.py,连 NaN 和零向量的边界行为都对齐)、按需下载 checkpoint 的CheckpointCache(库版本和模型版本用两套独立 tag 发布,互不惊动)。
最硬的是它的验证方式:两个后端都与 Python 原版的输出逐位对齐(置信度一致到 1e-6),而且是提交进仓库的回归测试,不是一次性的手工核对。 BenchmarkDotNet 实测(Apple M2、CPU、多语言 checkpoint、一次 3 题批量请求):
后端 | 均值 | 相对 | 分配内存 |
|---|---|---|---|
TorchSharp | 70.9 ms | 0.48x | 85.3 KB |
ONNX Runtime | 148.7 ms | 1.00x | 82.6 KB |
TorchSharp 在这里快约 2.1 倍——作者还坦白交代了 ONNX 侧的 SessionOptions 调优没能补上差距。两个后端还各自带一个 Native AOT 冒烟测试,本地已验证 AOT 二进制能加载真实 checkpoint 并给出正确预测。
两个移植怎么选
你的需求 | 选谁 |
|---|---|
要 DI、OpenTelemetry、ML.NET、Extensions.AI 护栏/路由等生态集成 | NLaya,全家桶开箱即用 |
想要极简内核、自己控制依赖、或在两个后端间做性能对比 | layar,接口更小,基准数据现成 |
重度 AOT 场景 | 两者都已验证 AOT 兼容 |
不想引入外部分词依赖 | layar(分词器从零自研) |
一个赛道出现两个高质量移植不是坏事——它们的 parity 测试互为交叉验证,等于给"这个判断引擎在 .NET 里到底靠不靠谱"上了双保险。
三、另外两条 .NET 路线:同一个契约,两种引擎
NLaya 和 layar 是"移植",而 TensorSharp 和 Sezika 代表的是"原生实现"——它们共享同一套 Choice / Score / Boolean 契约,但引擎几乎是反着走的。
路线一:TensorSharp——26B 扩散大模型"单步读取"
先看上游发生了什么。9 月 22 日,vLLM 合并了 PR #57250,把 Google 的文本扩散模型 DiffusionGemma 改造成了一台结构化读取引擎:扩散模型生成文本时在一块叫 canvas 的区域里反复去噪,vLLM 把这个机制反过来用——canvas 缩到 16 或 32 宽,预填一份答案模板(如 "billing": "?"),只在答案位置留 mask,然后只跑一步去噪,直接读空位上各候选词的 logprobs。全程没有逐 token 生成,自然没有格式错误和重试。
TensorSharp(纯 .NET 的本地 LLM 推理引擎)第二天就把这套机制搬进了 .NET,实现了 Jev 兼容的 POST /v1/systemone,底层跑 26B-A4B 的 DiffusionGemma,并且做了两件原型没有的事:
- 稀疏输出投影:不计算完整词表的 logits,只算答案位置 × 候选标签的那几行,同硬件下比"生成 JSON 再解析"快 4–5 倍;
- 图片输入:请求里内联最多 8 张 base64 图片直接参与决策。由于市面上的 DiffusionGemma GGUF 都是纯文本的,TensorSharp 干脆直接读上游官方 checkpoint 的第 11 个 safetensors 分片(2.84 GB,装着视觉塔全部 356 个张量),不转格式。
项目自带的红绿灯例子设计得很巧:state 文本只说"车辆正在接近路口",一个字没提灯,但请求里嵌了一张绿灯照片——模型回答绿灯、不用停车,答案只能来自像素。更妙的是文档自带反事实实验:同一个请求去掉图,模型会很有把握地答"红灯,必须停车"。
安全细节也到位:服务器没加载视觉塔时收到带图请求返回 503 明确拒绝;远程图片 URL 和本地文件路径一律拒收,免得推理服务器被当成免费代理。
路线二:Sezika——不用大模型,编码器加决策头就够了
IoTSharp 团队的 Sezika 走的是完全相反的方向:既然只要一个判断,为什么要用 26B 的生成模型?
它的底座是 mmBERT-base 级别的多语言编码器(正是 Laya multilingual 的同款基座),上面接类型化决策头。输入进来编码器过一遍,决策头直接给每个候选打分——没有 canvas,没有去噪,连"一步"都不需要。
这个项目最吸引人的是它的纯粹程度:整个推理栈都是 C# 写的——embedding、attention、RoPE、归一化、MLP、决策头,CPU 上有标量 FP32 / SIMD FP32 / W8A32 量化三条路径,不碰 Python、PyTorch、ONNX Runtime。GPU 路径的做法在 .NET 圈很少见:构建期用 ILGPU 把 kernel 编译成 PTX,运行时 Native AOT 程序通过静态绑定直接调 CUDA Driver,绕开了与 AOT 不兼容的运行时代码生成,cuBLAS、cuDNN 一概不用。
性能数据给得很克制:Core Ultra 9 185H + RTX 4070 Laptop、CUDA FP32 后端,1 个问题热路径约 40 ms,32 个约 1.23 秒。而且作者把限定条件写得很全:只预热一次、采样五次,明说"五次采样不足以证明稳定的尾延迟";W8A32 量化目前比 SIMD 还慢,照实写;所有输出标记为 uncalibrated,没校准就是没校准。这种"丑话说在前面"的文档风格,在人人吹 benchmark 的年代挺少见。
字段像到什么程度?像,但语义不一样
两边的请求骨架(model / state / questions / criteria)几乎同构,但有几个语义差异比字段差异更值得注意:
confidence和concentration不是一个东西。 TensorSharp 的 confidence 是条件分布的最大概率;Sezika 的 concentration 是归一化熵算出的集中度。同一个请求两边跑出来的数没有可比性,别混用。- 对"不确定"的处理思路相反。 TensorSharp 遇到不确定的题会自己多读几次(
samples: "auto",条件熵超阈值自动触发),给平均值和多次读取间的标准误;Sezika 是确定性的,一次前向一个答案,但把"信不信得过"做成协议的一部分——低于浓度门槛标记abstained,由调用方决定怎么办。一个靠"多想几遍",一个靠"明说不敢答"。 - 可复现性的含义不同。 TensorSharp 有 seed,但只保证同运行时同后端可复现;Sezika 压根没有随机源,复现性靠固定模型版本加逐张量 hash 校验链。
四条路线怎么选
场景 | 建议 |
|---|---|
想要 Laya 完整生态:Router、校准、ML.NET、Extensions.AI | NLaya,移植保真度最高,DI/AOT 全套支持 |
想要极简内核、自研分词器、双后端性能对比 | layar,ONNX 与 TorchSharp 任选,逐位对齐 Python |
高频低延迟的本地判断:意图识别、路由、RAG 重排 | Sezika,毫秒级,AOT 编译嵌进进程即可 |
需要大模型的世界知识和语义理解 | TensorSharp Jev |
答案在图里:质检、票据、红绿灯这类视觉判断 | TensorSharp Jev,目前只有它支持图片 |
业务流程里需要显式拒答和校准状态 | Sezika,协议自带 abstained / calibration |
不确定时希望模型自己多算几遍 | TensorSharp Jev 的 samples: "auto" |
引擎在别处(云端 Jev / Laya Server),只要一个顺手的调用方 | SystemOneSharp,一个客户端通吃所有兼容服务 |
其实四者并不冲突。接口契约几乎一样,完全可以分层用:Sezika、NLaya 或 layar 放前面做高频路由和初筛,拿不准的、需要看图或者需要常识的,再丢给 TensorSharp Jev 或大模型。小引擎守门口,大引擎做终审。
四、客户端这一环:SystemOneSharp,一个客户端打所有兼容服务
前面四个项目都是"引擎"——模型在你这边跑。但还有一种同样常见的形态:引擎在别处(TypeSafe 的云端 Jev、1Panel 的 Laya Server、自己部署的 TensorSharp /v1/systemone),你的程序只是调用方。这层需求由 SystemOneSharp 补上:一个 .NET 10 的 System One API 类型化客户端,零运行时依赖,同一个 POST /v1/systemone 请求,云端 Jev 和本地 Laya 服务器通吃。
它的存在本身就是"接口契约统一"这条主线最好的注脚:因为大家都讲同一套协议,一个客户端就够了。
using SystemOneSharp;

using var http = new HttpClient();
ISystemOneClient client = new SystemOneClient(http, new SystemOneOptions
{
    ApiKey = Environment.GetEnvironmentVariable("TYPESAFE_API_KEY")
});

var request = new SystemOneRequestBuilder()
    .WithState("Please refund my duplicate charge")
    .AddChoice("team", "Which team should handle this?", choice => choice
        .Option("billing", "Payments and refunds")
        .Option("support", "Product issues"))
    .AddScore("urgency", "How urgent is this?", score => score
        .Level("routine").Level("soon").Level("critical"))
    .AddNoul("refund", "Does the customer ask for a refund?")
    .Build();

var response = await client.DecideAsync(request);
var team = response.GetChoice("team");
var refundProbability = response.GetNoul("refund").Noul;
切到本地 Laya Server 只需把 BaseUri 指向 http://127.0.0.1:8000、按需省略 ApiKey——改一行配置就换了供应商。
客户端库的分量不在 Demo,在边角处理,SystemOneSharp 这几点做得挺扎实:
- 重试策略内置:自动重试 HTTP 429 / 529,遵守
Retry-After,失败时抛出区分传输层、API 层、协议层的类型化异常; - 可观测性:每次
DecideAsync走名为SystemOneSharp的ActivitySource,采用 OpenTelemetry GenAI 属性命名(模型、各类型问题数、重试次数、token 用量、结果),且明确承诺不记录 state、instructions、criteria、答案和 API Key; - AOT 友好:
WithState可传JsonNode/JsonElement/ 任意 C# 对象,配合JsonSerializerContext的JsonTypeInfo<T>可完全避开反射; - 宽容的响应处理:契约之外的字段(比如 Laya 特有的
routing)收进AdditionalProperties原样保留,不做强行校验——这正是"客户端不该比协议更聪明"的正确姿势。
另外还有三个可选包对接微软 AI 栈:SystemOneSharp.Extensions.AI(把 ChatMessage 对话规范地投影成 System One state)、SystemOneSharp.Extensions.AI.Evaluation(一次请求产出多个 MEAI 评估指标)、SystemOneSharp.AgentFramework(给 Microsoft Agent Framework 提供 LoopEvaluator 和函数调用中间件)。
要说明一点:它是社区维护的非官方客户端,与 TypeSafe 和 Laya 官方都没有隶属关系。
五、生产样本:OpenClaw.NET PR #246 与 #255——把决策模型关进工程的笼子
前面讲的都是引擎和客户端。真正的问题来了:把概率模型的输出接进一个正在跑业务的 Agent 系统,需要多少工程护栏? 自托管 Agent 运行时 OpenClaw.NET 的 PR #246(贡献者 Telli,《feat: add hosted Jev and local Laya decision routing》)给出了一份教科书级的答案——它把托管 Jev 和本地 Laya 同时接进了回合路由层,而其工程形态远比"接一个 API"复杂。
它叠加在什么之上
OpenClaw.NET 原本就有一套 ONNX 小模型做的动态回合路由:每个用户回合被分类到 T0–T3 四个成本层级,路由结果投影到模型档案、工具过滤和推理档位上。这套基线的文档诚实得近乎自贬——Macro-F1 只有约 0.65,并配了一张严苛的上线门禁表(标注集 Macro-F1 ≥ 0.90、路由附加延迟 p95 ≤ +80ms、任何 Sev1 事故立即回滚)。换言之,在 PR #246 之前,路由的骨架与门禁文化已经在了,缺的只是一个更好的"判断器官"——ONNX 小模型是第一代,Jev/Laya 是第二代候选。
Jev 是装饰器,不是提供商
PR 为 Jev 设计了版本化 rubric openclaw-tiers-v1,一次请求并行问三道题:tier(T0–T3/abstain 的 Choice)、high_risk(Noul)、requires_tools(Noul)——正是 Jev"一次前向并行多题"能力的最小生产形态。送往云端的 state 只含当前请求和至多四条最近消息,脱敏管道先行。
可靠性设计的密度令人印象深刻,值得逐条列出:
- 1500ms 有界超时覆盖全程,关键路径不重试;并发槽占满立即回退而非排队;连续失败 3 次熔断 30 秒;
abstain、不确定、未知层级、模型版本不符、凭据缺失、HTTP 错误、超时——全部收敛到同一个动作:保留基线;- 风险与工具信号只能上调层级地板,不能下调;降级方向要求更高置信度(
DowngradeMinConfidence0.95 对MinConfidence0.80,外加前两名概率间距 ≥ 0.15); - active 模式只允许改动模型档案与推理档位,不授予任何工具权限,文档原话:"Jev 是装饰器,不是聊天提供商",并禁止把它的模型 ID 写进模型档案。
Laya 侧:一条强制的校准工具链
本地路径回答的是"数据不能出厂"的同一个问题。Laya 服务被做成独立 Python 进程(PyTorch 刻意挡在 .NET 网关和 NativeAOT 二进制之外),只听 127.0.0.1,同一时刻只处理一条推理;模型资产钉死 Hugging Face 修订号、生成 SHA-256 清单、强制离线模式。最重的投入在校准:运营者必须先用自有标注数据按检查点/题型/选项数分桶拟合温度参数,把校准产物的 SHA-256 写进配置,active 模式强制要求响应中的校准 ID 与配置匹配——不达标就永远停在影子模式。这直接回应了 Laya 出厂 ECE 高达 0.466 的已知短板。
影子模式不是建议,是默认姿势
PR 的发货默认值是 disabled;启用后的第一站是 shadow 模式——基线决策原样返回,但系统在有界期限内等待一次真实评估,把基线层级、提案层级、概率、置信度、延迟与估算成本追加进元数据日志(刻意不记录对话文本和凭据)。配套 Python 评估脚本计算准确率、混淆矩阵、ECE 与风险-覆盖曲线;无标注时报告明确不做任何准确率断言。回滚是一行配置加重启。
这套设计的立场可以概括成一句话:决策模型做提案,工程约束做裁决。 每次决策无论采纳与否都可事后重放——"模型当时为什么这么想"是事实,不是猜测。
同样需要如实记录边界:PR 只覆盖回合路由——Agent 系统里频率最高、爆炸半径最小的决策点;技能选择、记忆重排、心跳分诊被列为未来工作。先在最安全的焊点上建好"决策模型 + 护栏 + 日志 + 校准"的全套规程,再向高风险焊点推广——这个顺序本身,就是给所有想把判断引擎接入业务的团队最有价值的示范。
后续:PR #255——把最后的 Python 也换成 .NET
PR #246 留下的唯一遗憾是:本地路径的核心部件还是 Python——tools/laya_service 是个独立的 Python 进程,评估脚本也是 python3 scripts/evaluate-jev-routing.py。当时的理由是"把 PyTorch 刻意挡在 .NET 网关和 NativeAOT 二进制之外",但 NLaya 的成熟让这道隔离墙失去了存在的必要。
紧随其后的 PR #255(贡献者 geffzhang,《Laya to dotnet》)干的就是这件事:把 tools/laya_service 整体迁移为 .NET 10 + NLaya 的工具链。PR 里的迁移计划覆盖了八个任务:CLI 脚手架、安全的 loopback 协议与服务行为、模型下载与清单校验、运行时集成、评估/校准/报告的逐项对齐、CI 与解决方案接线、Python 清理、文档更新。落地后的对比非常直观:
# 之前(PR #246):Python 评估脚本
python3 scripts/evaluate-jev-routing.py ./jev-decisions.snapshot.jsonl --output /tmp/jev-report.json

# 之后(PR #255):同一条命令,纯 .NET
dotnet run --project tools/laya_service -c Release -- report \
  ./jev-decisions.snapshot.jsonl --output /tmp/jev-report.json
测试入口也同步从 python3 -m unittest 换成了 dotnet test。细节上的较真程度延续了 PR #246 的风格:校准拟合时拒绝非数值的原始概率、强制答案概率为 [0,1] 有限值、概率和允许 ±0.002 的舍入漂移并在缩放前重新归一化;CLI 把 checkpoint_not_installed、requested_device_unavailable 等启动失败映射为明确的退出码和 stderr 输出,不让运维者猜。
这一步的意义超出"少装一个 Python":NLaya 从社区移植变成了被生产级 Agent 运行时选中的正式底座,而整条决策路由链路——引擎、服务、校准、评估、报告——第一次完整收敛到了纯 .NET 技术栈内,Native AOT 发布、单一工具链构建、统一的可观测性全都顺理成章。回头看,这正是 PR #246 把决策客户端抽象成 OpenClaw.Routing.Decisions 时就铺好的路:契约对了,引擎换心只是配置问题。
六、上线前的冷静清单
判断引擎这类东西,接入业务的门槛从来不在 API 好不好调,而在你敢不敢信它。无论你选哪条路线,这五件事绕不开:
- 别零样本上生产。 Laya 零样本准确率 0.362,接近随机,实用能力全部来自微调。准备好自己的标注数据,先跑一批真实样本看基线。
- 置信度要先校准。 逐题型拟合温度参数,把 ECE 从 0.466 压下来,否则
conf >= 0.85这种阈值没有意义。 - 路由目标别贪多。 高基数是明确短板(Banking77 上只有 0.425),两到五个目标最稳。
- 延迟按自己的环境重新测。 官方 GPU 基准是几十毫秒,CPU 部署实测可能落在几百毫秒到秒级——这个开销每次请求都要付,必须计入整体 P99。
- 兜底必须配。 决策失败、超时、置信度不足,都要有明确的降级路径,不能让判断层成为新的单点故障。
对照上一章 OpenClaw.NET 的做法会发现,这五条清单在它的 PR 里全部硬化成了配置和代码:校准对应"校准 ID 强制匹配",兜底对应"一切异常收敛到保留基线"。清单是态度,护栏是实现,两者都要。
最后记住那条最重要的数学规律:成本优势的上限 = 1 / 弃权率。 真正决定 ROI 的,从来不是"一次判断多少钱",而是"你自己的数据能把弃权率压到多少"。
模型给出的概率只是概率,没校准过就不是正确率。这几个项目至少在这点上都很清醒——先把丑话写进协议里,再谈怎么用。判断合法不等于判断正确,动不动手,永远由调用方决定。
参考资料
- Jev 发布三天就被开源了:33 毫秒做一次判断的 Laya,值不值得进生产?https://www.cnblogs.com/xiaobaiysf/p/23127340
- 不让模型写作文,直接从它脑子里读答案:Jev 决策在 .NET 的两条路线:https://www.cnblogs.com/shanyou/p/23117082
- NLaya(Laya 的 .NET 移植):https://github.com/ljfio/NLaya
- layar(Laya 的另一个 .NET 移植):https://github.com/nullean/layar
- TensorSharp:https://github.com/zhongkaifu/TensorSharp/
- Sezika:https://github.com/IoTSharp/Sezika
- SystemOneSharp(System One API 的 .NET 客户端):https://github.com/pinkroosterai/SystemOneSharp
- OpenClaw.NET PR #246(决策路由接入 Jev/Laya):https://github.com/clawdotnet/openclaw.net/pull/246
- OpenClaw.NET PR #255(laya_service 迁移到 .NET 10 + NLaya):https://github.com/clawdotnet/openclaw.net/pull/255
- vLLM PR #57250:https://github.com/vllm-project/vllm/pull/57250
文中性能数据均来自各项目公开文档,测试条件以原文为准。
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2026-09-28,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号