Elasticsearch 携手 NVIDIA cuVS 实现 GPU 加速的向量索引:10 分钟内完成 1.38 亿个向量索引
原创
Elasticsearch 携手 NVIDIA cuVS 实现 GPU 加速的向量索引:10 分钟内完成 1.38 亿个向量索引
原创
点火三周
发布于 2026-09-30 06:47:44
发布于 2026-09-30 06:47:44
现代企业应用正在以 TB 到 PB 级规模摄取非结构化数据,以驱动语义搜索、基于大语言模型(LLM)的检索增强生成(RAG)以及推荐系统。在此数据规模下,基于 CPU 的向量索引可能需要数天甚至数周时间,从而拖慢实验进度,并使大规模索引更新的运维成本居高不下。这一问题对那些需要定期重建索引的工作负载尤为突出,例如由频繁的数据更新或嵌入模型更新所驱动的场景。例如,一些电商团队每晚刷新产品目录并训练自己的嵌入模型,每次更新都需要重建索引。
当索引构建与搜索同时发生时,基于 CPU 的索引还会显著降低搜索性能,这在电商平台和广告投放管道等在线系统中尤为明显。原因在于索引构建会消耗大量 CPU 资源,使得可分配给查询处理的周期减少,从而推高搜索延迟及延迟波动。即使索引构建完成,延迟仍可能因索引碎片化而居高不下。客户通常会执行强制合并来合并段,但这一操作在 CPU 上可能非常缓慢,进一步将恢复至预期搜索延迟的时间延长数小时甚至数天。
Elasticsearch 已引入由 NVIDIA cuVS 驱动的 GPU 加速向量索引。在本文中,我们将展示 Elasticsearch 如何通过将分层可导航小世界图(HNSW)索引构建任务卸载至 GPU,实现最高 7 倍的向量索引吞吐量提升——使用八块 NVIDIA RTX PRO 6000 GPU 在不到 10 分钟内索引了 1.38 亿个向量。
在不到 10 分钟内索引超过 1 亿个向量
图 1 展示了针对 MS MARCO 数据集中 1.38 亿个 1024 维向量(约 4 TB 多模态文档)的向量索引吞吐量。该基准测试使用 Elasticsearch 的宏观基准框架 Rally 运行。测试服务器配置为 8 块 NVIDIA RTX Pro 6000 GPU 和双路 AMD EPYC 9555 CPU。GPU 测试时开启 GPU,CPU 测试时关闭 GPU。结果显示,Elasticsearch 实现了 7 倍更高的索引吞吐量:在 CPU 上索引 1.38 亿个向量需要 1 小时,而在 GPU 上则缩短至不到 10 分钟。
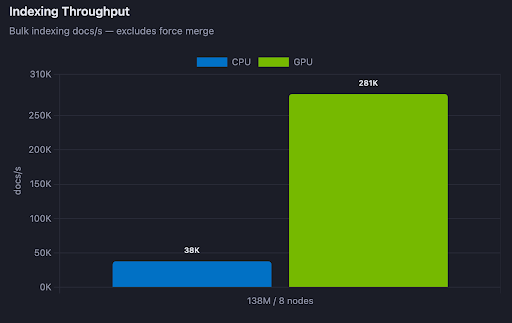
向量索引吞吐量柱状图:GPU 上 281K 文档/秒,CPU 上 38K 文档/秒,处理 1.38 亿个向量
图 1:本地部署时的索引吞吐量比较(开启 GPU:8× NVIDIA RTX Pro 6000 + 双路 AMD EPYC 9555;关闭 GPU:仅双路 AMD EPYC 9555)。目标召回率为 95%。
GPU 向量索引是否会改变召回率?
如果 GPU 上构建的索引搜索质量低于 CPU,那么索引加速便毫无意义。GPU 构建与 CPU 构建的索引的吞吐量-召回率曲线完全重叠,表明 GPU 索引提供了与 Elasticsearch 基于 CPU 的索引路径相同的召回率分布,且精度或搜索时性能损失极小(图 2)。
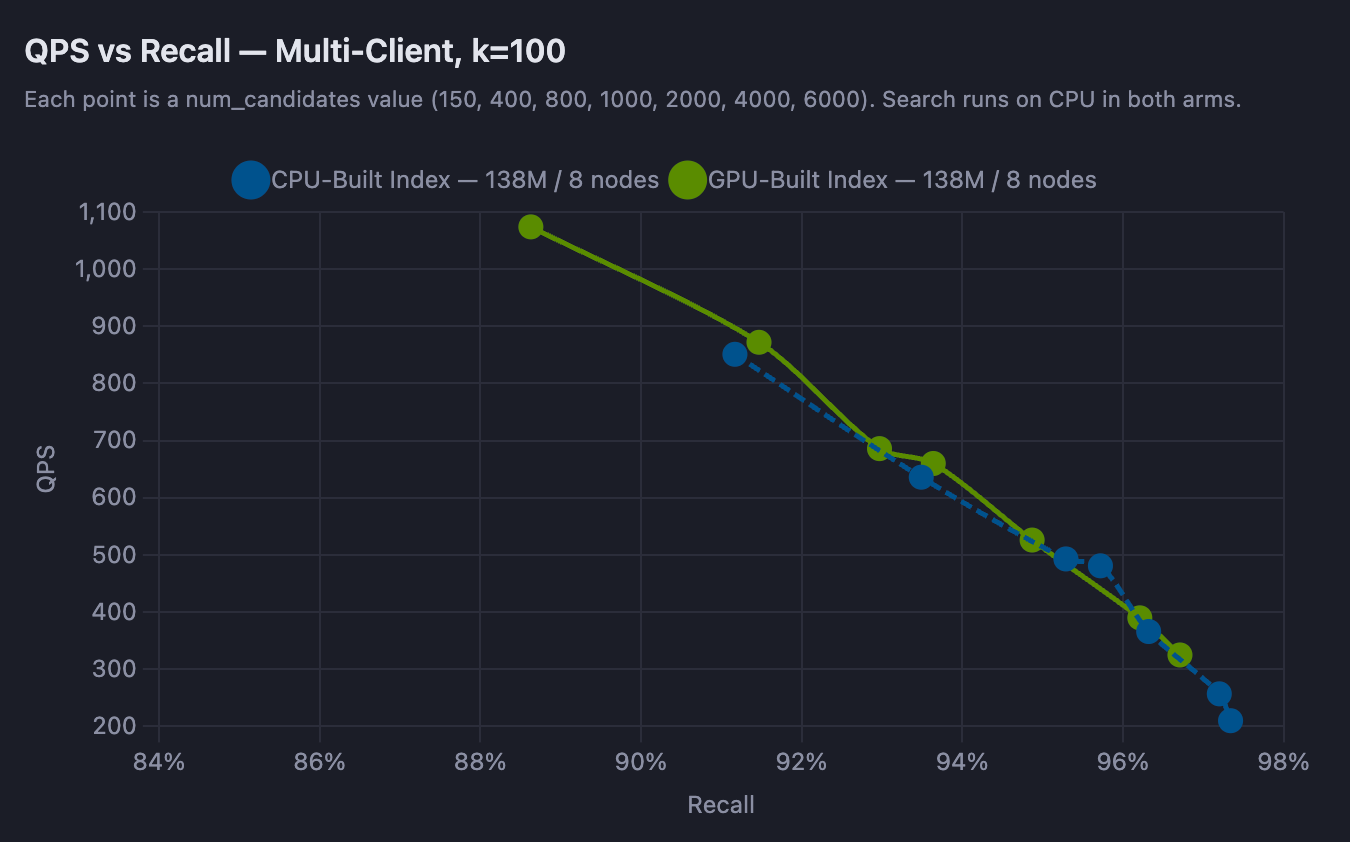
QPS 与召回率的关系图,显示 GPU 构建和 CPU 构建的向量索引在 k=100 时曲线重叠
图 2:GPU 构建与 CPU 构建的 HNSW 索引的召回率-吞吐量权衡曲线。
并发索引负载下的搜索延迟
将索引卸载至 GPU,使索引与搜索同时运行时的 CPU 搜索延迟降低了 6 倍(图 3),因为 GPU 上的索引释放了 CPU 资源,从而加速了搜索响应。这使得单个 Elasticsearch 集群能够同时支持实时数据摄取和低延迟检索,而无需在数据新鲜度与搜索性能之间做出取舍。
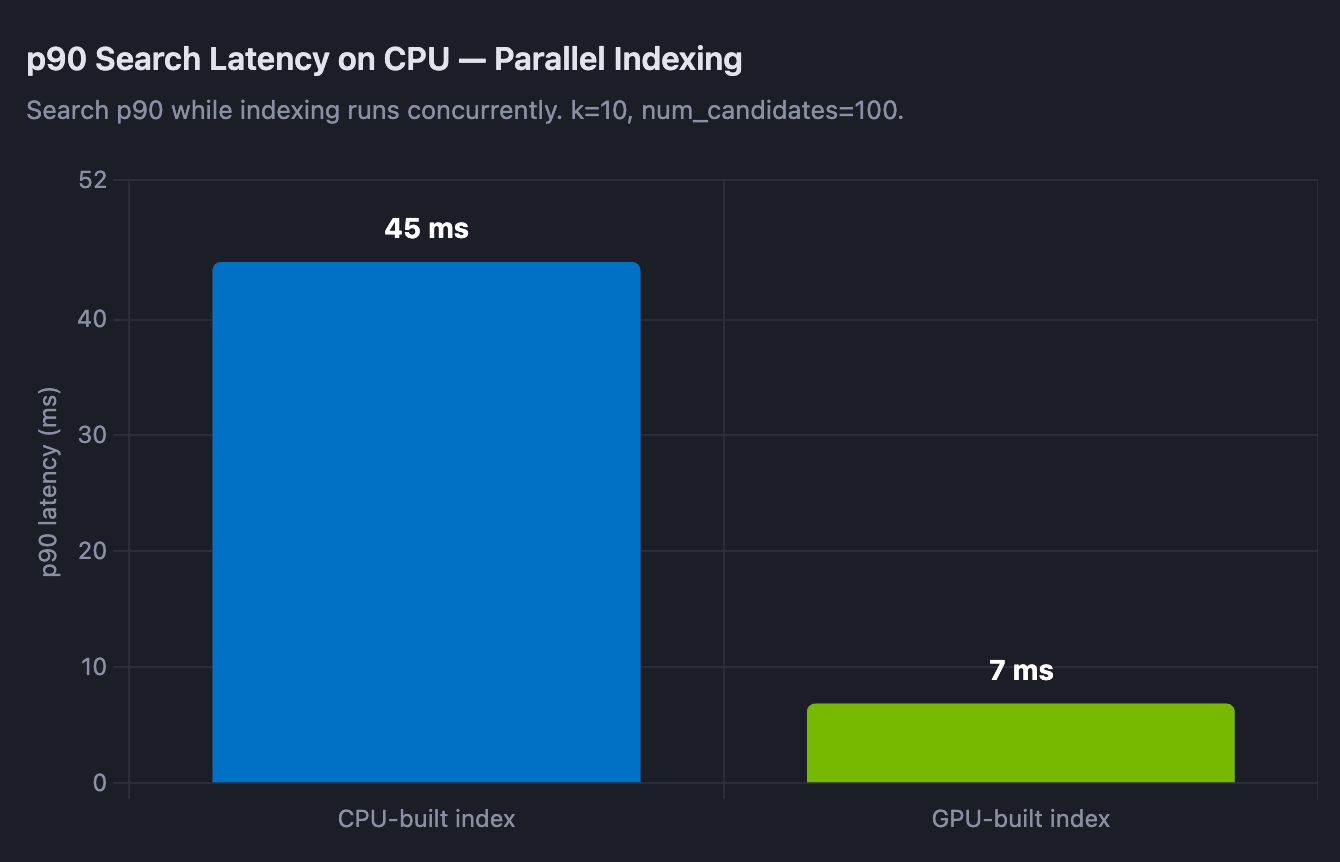
索引期间 p90 搜索延迟的柱状图:GPU 构建索引为 7 毫秒,CPU 为 45 毫秒
图 3:并发索引负载下 CPU 搜索的 p90 延迟。
HNSW 索引的 GPU 与 CPU 强制合并时间
此外,Elasticsearch 中的 GPU 加速索引将强制合并时间从大约 4 小时缩短至 5 分钟,帮助实时恢复低延迟搜索(图 4)。注:强制合并用于将每个分片合并为四个段。
以下是 Elasticsearch 中 GPU 与 CPU 向量索引的完整结果:
指标 | CPU | GPU | 变化幅度 |
|---|---|---|---|
1.38 亿个向量的索引构建时间 | ~1 小时 | 不到 10 分钟 | 7 倍吞吐量 |
索引负载下的 p90 搜索延迟 | 基准值 | 降低 6 倍 | 6 倍 |
强制合并(每个分片 4 个段) | ~4 小时 | ~5 分钟 | ~48 倍 |
目标召回率 | 95% | 95% | 不变 |
GPU 向量索引对 Elasticsearch 用户的意义
Elasticsearch 与 NVIDIA cuVS 的集成,将 GPU 加速向量索引引入生产级 AI 搜索场景:搜索延迟降低超过 84%,索引吞吐量提升 640%,同时 CPU 开销更低,基础设施权衡更少。这解锁了全新类型的应用,例如更快的 RAG 管道、语义搜索、多模态检索以及大规模欺诈检测。
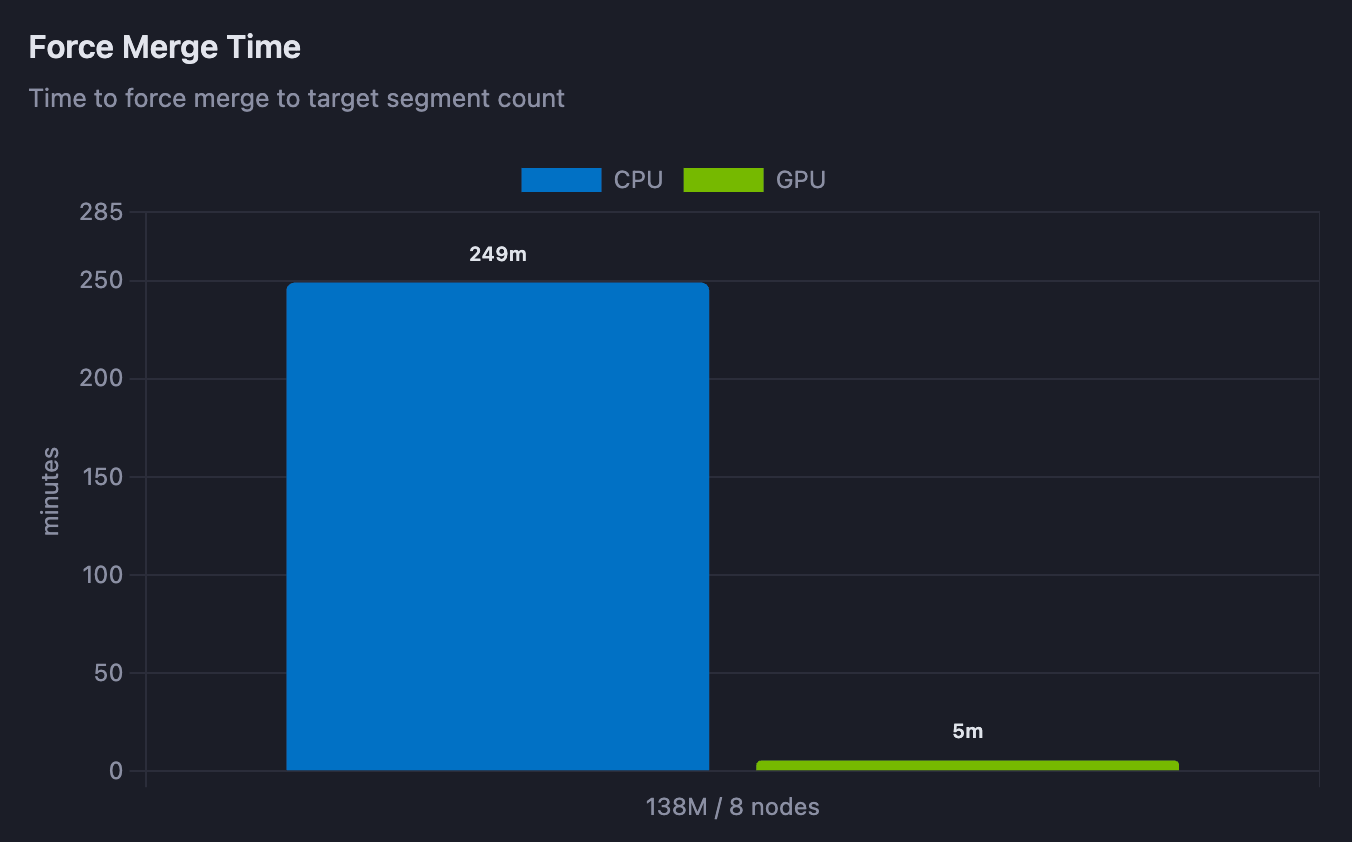
GPU 与 CPU 强制合并时间对比柱状图:GPU 5 分钟,CPU 249 分钟,处理 1.38 亿个向量
图 4:GPU 与 CPU 的强制合并时间对比。
在 Elasticsearch 中开始使用 GPU 向量索引
请按照这些说明安装带有 GPU 加速向量索引的 Elasticsearch。使用 GitHub Issue 中的参数运行 Rally msmarco 测试轨道,即可复现上述基准测试。访问 NVIDIA cuVS 了解更多关于 GPU 加速的向量索引、搜索和预处理的信息。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号