最佳LLM在59%的情况下能写出正确的Elasticsearch ES|QL。以下是导致其余41%失败的症结所在
原创
最佳LLM在59%的情况下能写出正确的Elasticsearch ES|QL。以下是导致其余41%失败的症结所在
原创
点火三周
发布于 2026-09-30 11:18:19
发布于 2026-09-30 11:18:19
我们向四个模型提供了来自BIRD Mini-Dev集的500个自然语言问题,要求每个模型生成一条Elasticsearch查询语言(ES|QL)查询,并根据是否返回了正确的行来评分所有6,000条答案。最佳模型在仅凭索引映射的单一尝试中获得了59%的正确率,且在500次查询中仅出现7次解析失败。语法不再是天花板。在提示词中嵌入一份紧凑的ES|QL参考手册,对较小模型的价值约为10个百分点的提升,但对最强模型却造成了10个百分点的下降。在仍然失败的查询中,大约一半会抛出精确的Elasticsearch错误,只需一次重试即可修复。另一半则顺利运行却返回空结果,原因是模型猜测的值不在数据中。
我们的起点是Text-to-ES Bench(ACL 2025),该基准衡量大型语言模型使用Query DSL查询Elasticsearch的能力。其模型将DSL查询与Python后处理配对,由pandas组装多索引答案。我们希望观察当模型能在查询内部进行连接时会发生什么变化。LOOKUP JOIN原生地连接索引,因此一个多索引问题变成了一个由Elasticsearch端到端执行的单一语句。
数据集:BIRD基准测试,Mini-Dev集
卡通鸟拿着写有SQL关键字的笔记,说明LLM文本到ES|QL查询生成
Text-to-ES Bench的问题来源于BIg Bench for LaRge-scale Database Grounded Text-to-SQL Evaluation (BIRD),这是一个广泛使用的文本到SQL基准。我们同样采用BIRD的Mini-Dev集:500个基于真实关系数据库的自然语言问题。每个任务提供三样东西:
- 一个英文问题: 模型需要翻译的提示词。
- 一条参考SQL查询: 产生正确答案的参考查询。
- 返回的行: 用于评分标准答案。
我们依赖的关键点是:基准真相是行,而不是SQL。我们从不将生成的查询文本与参考SQL进行比较;一条预测仅根据其返回的行来评分。如果查询无法解析,则返回空行,空行即为零分。“平均进站时间最短的三位车手的名字”这个问题,无论你用SQL、ES|QL还是手工计算,都应该产生相同的答案。因此,我们保留了BIRD的问题和BIRD的标准答案,仅替换模型编写的语言。
以下是来自student_club数据库的一个任务示例:
Question:  List out the full name and total cost that member id "rec4BLdZHS2Blfp4v" incurred?Evidence:  full name refers to first_name, last_name
Gold SQL:  SELECT T1.first_name, T1.last_name, SUM(T2.cost)           FROM member AS T1           INNER JOIN expense AS T2 ON T1.member_id = T2.link_to_member           WHERE T1.member_id = 'rec4BLdZHS2Blfp4v'
Gold rows: [["Sacha", "Harrison", 866.25]]那个[["Sacha", "Harrison", 866.25]]就是标准答案。我们还照原样传递BIRD的“证据”提示(上面的full name refers to...行);问题的编写假定你拥有这些提示。
将BIRD数据导入Elasticsearch
每个表都成为独立的索引,刻意不做反范式化。提前扁平化模式会悄悄地为模型解决难题,最终我们衡量的是自己的数据建模能力,而非模型的查询能力。
LOOKUP JOIN右侧的索引必须使用lookup index模式:
es.indices.create(index=idx, settings={"index.mode": "lookup"}, mappings=mapping)并且,你需要连接或分组的字段必须是keyword类型,而不是text字段。因此,文本列被设置为keyword并加上ignore_above防护,以确保它们在WHERE相等判断、STATS ... BY、LOOKUP JOIN和LIKE中可用,同时保持在Lucene的术语长度限制之下:
KEYWORD_IGNORE_ABOVE = 8000  # 保持UTF-8字节长度低于Lucene的32766术语长度限制
props[field] = {"type": "keyword", "ignore_above": KEYWORD_IGNORE_ABOVE}
总体而言,这大约涉及75个索引中的390万份文档,运行在Elasticsearch 9.5上。如果你以前没有构建过这样的连接,这篇关于Elasticsearch原生连接的演练会更深入地介绍索引模式的要求。
我们如何提示模型并评分ES|QL准确性
提示词遵循BIRD的零样本协议:一个模式块、证据提示、问题,以及只返回查询的指令。唯一的区别在于,模式以Elasticsearch索引映射的形式呈现,而不是CREATE TABLE DDL,因为目标语言是ES|QL。
SYSTEM_PROMPT = ( "You are an expert Elasticsearch ES|QL query writer. You translate a natural-language " "question into ONE valid ES|QL query that runs against the provided indices.\n\n" "ES|QL is a piped query language: FROM <index> | WHERE ... | STATS ... BY ... | SORT ... | LIMIT ...\n" "It is NOT SQL and NOT Elasticsearch Query DSL. To join indices, use LOOKUP JOIN.\n\n" "Think step by step, then return ONLY the final ES|QL query.")每条查询只有一次尝试机会。这是有意为之,因为单次调用加一个提示词能隔离模型自身知识,而不受外部脚手架可能的恢复能力影响。
我们对四个模型运行了三种提示词变体:
- base: 模式、证据、问题;模型已有的ES|QL知识。
- focused skill: 在上述内容前加上ES|QL技能的一个紧凑子集(来自agent-skills仓库):包括其
SKILL.md概述、语言参考、生成技巧和查询模式。省略了与关系查询、时间序列、PromQL和全文搜索无关的部分。 - full skill: 相同,但附加了完整的技能和所有参考文件。
在两种技能变体中,文件作为静态块粘贴到提示词中。通常,技能是通过触发器、代理决定需要参考并加载它来传递给模型的。我们跳过了这一步,因此被测试的变量是参考内容本身。
测试的模型包括:gpt-5.5、claude-opus-4-8、claude-sonnet-4-6和gpt-5.4-mini。
评分过程通过_query API运行生成的ES|QL,并将结果与BIRD的标准行进行集合比较。忽略行顺序、重复行、列顺序和额外返回的列。标准只有一个:查询返回了正确的数据。
我们决定忽略展示细节,因为它们无法说明模型是否理解了问题。以之前的student_club任务为例,假设模型答案被严格的元组比较拒绝:
gold: [["Sacha", "Harrison", 866.25]]pred: [["Sacha Harrison", 866.25]]模型构建了一个full_name,而参考SQL将first_name和last_name分开存储。它们产生了相同的数据、相同的行。额外列属于同一类问题,且更常见;如果一个模型回答了KEEP atom_id, element而问题只要求元素,它仍然找到了元素。
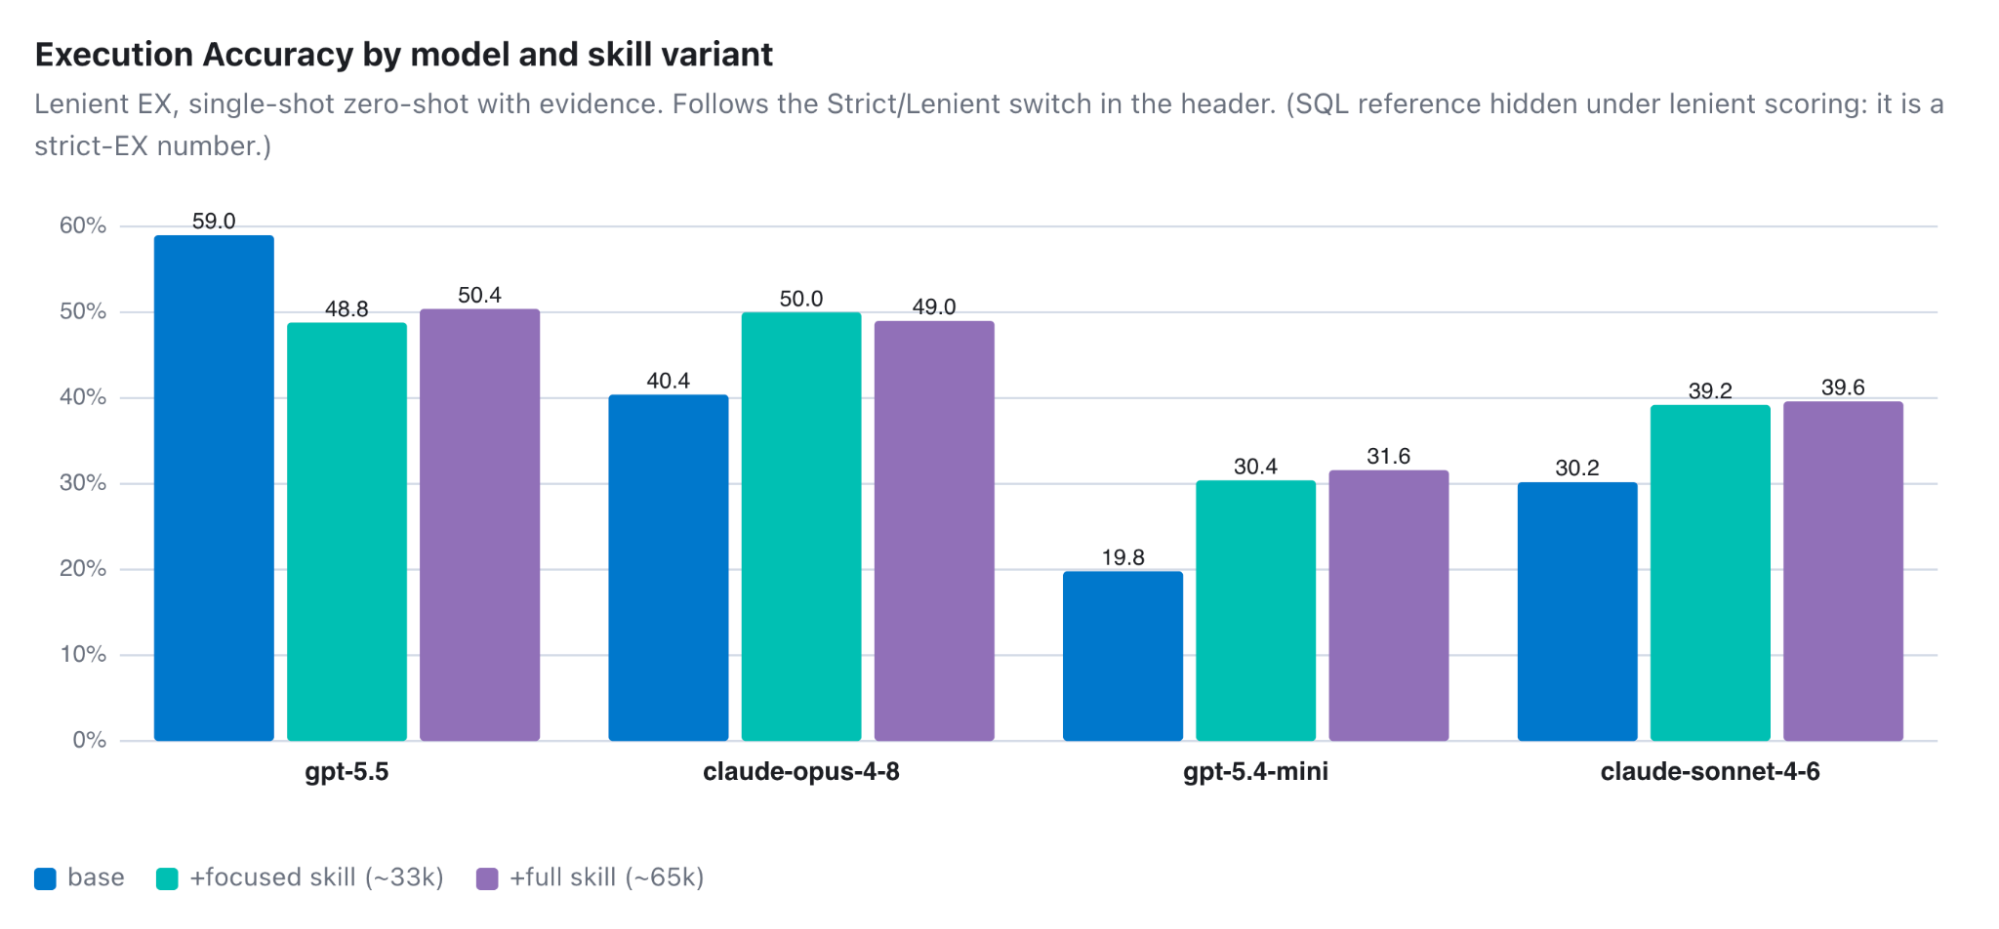
LLM编写的ES|QL准确性如何?
按模型(base、focused skill、full skill三种提示词变体)统计的ES|QL执行准确率柱状图
每格500个问题的执行准确率:
模型 | base | focused skill | full skill |
|---|---|---|---|
gpt-5.5 | 59.0% | 48.8% | 50.4% |
claude-opus-4-8 | 40.4% | 50.0% | 49.0% |
claude-sonnet-4-6 | 30.2% | 39.2% | 39.6% |
gpt-5.4-mini | 19.8% | 30.4% | 31.6% |
两点值得关注:
- 参考手册对除最强模型外的所有模型价值约10个百分点: Opus、Sonnet和gpt-5.4-mini从聚焦技能中获得了9.0到10.6个百分点的提升;gpt-5.5则下降了10.2个百分点。它仅凭模式就已经达到了59.0%,并且500次查询中仅出错了7次,因此它没有语法问题需要参考手册来修复,而提供参考手册对它的损害大于可能的收益。
- 提升幅度小于错误数量所暗示: 技能几乎消除了运行中最大的失败类型:在所有6,000次查询中,连接错误从939次下降到了354次。但总体准确率并没有变化。原因出现在另一列中,作为一种几乎不存在的新错误类型:
Found ambiguous reference从120次增加到了706次。错误并未被真正修复,只是被重命名了,我们将在下一节中详细分析这一点。文档教会了模型ES|QL的语法,但并未教会它你数据的形状。
ES|QL生成的四种失败模式
以下百分比基于失败查询。失败 指任何未返回正确数据的查询,无论是无法运行还是运行后返回了错误行。数据正确但形状错误不计入失败。
<table class="w-full border border-solid border-default"><tbody><tr class="border-b border-solid border-default"><td class="px-4 py-2 text-sm">失败类别</td><td class="px-4 py-2 text-sm">应对方法</td></tr><tr class="border-b border-solid border-default"><td class="px-4 py-2 text-sm">连接键名在两侧不同</td><td class="px-4 py-2 text-sm">在连接前使用 RENAME,使外键名匹配主键名,或使用 9.2 版本的连接谓词</td></tr><tr class="border-b border-solid border-default"><td class="px-4 py-2 text-sm">ES|QL 解析器拒绝的 SQL 语法</td><td class="px-4 py-2 text-sm">在提示词中放入一页的语法卡片</td></tr><tr class="border-b border-solid border-default"><td class="px-4 py-2 text-sm">在一对多 LOOKUP JOIN 之后计数</td><td class="px-4 py-2 text-sm">对实体使用 COUNT_DISTINCT,或在连接前聚合</td></tr><tr class="border-b border-solid border-default"><td class="px-4 py-2 text-sm">模型猜测了一个不在数据中的值</td><td class="px-4 py-2 text-sm">在提示词中提供样本行和唯一值</td></tr></tbody></table>
1. ES|QL LOOKUP JOIN 要求两侧字段名相同
连接键命名是最大的失败类别:在Opus的298个base失败中占134个,约45%。SQL可以用不同名称连接列,而BIRD的模式依赖于此(superhero.skin_colour_id 连接 colour.id)。ES|QL的基本连接形式不支持。LOOKUP JOIN <index> ON <field> 采用单个字段名,且该字段名必须在两侧都存在,更接近SQL的 JOIN ... USING 而非 JOIN ... ON。Elasticsearch 9.2 增加了一种新形式来解除这个限制,但仅当两个键名称不同时。这正是我们的运行出现问题的地方,我们将在本节末尾回到这一点。
一个模型尝试使用SQL连接语法时会写出这样的代码:
FROM superhero__superhero| LOOKUP JOIN superhero__colour ON skin_colour_id = id| WHERE colour == "Green"line 2:51: mismatched input '=' expecting {<EOF>, '|', 'and', ...}给它技能后,它学会了 ON <field> 形式,但紧接着又犯了错,仍然试图使用左侧名称(expense.link_to_budget 指向 budget.budget_id):
line 3:39: Unknown column [link_to_budget] in right side of join在整个运行过程中,有212个连接查询根本无法解析(包括SQL形式的 ON a = b),另外226个解析成功但因右侧名称错误而被拒绝。根据你控制的范围,有三种解决方法。
1. 查询时重命名。 在连接前添加一行:
FROM student_club__expense| WHERE expense_description == "Post Cards, Posters" AND expense_date == "2019-8-20"| RENAME link_to_budget AS budget_id| LOOKUP JOIN student_club__budget ON budget_id| KEEP event_status一个需要注意的地方:RENAME 会替换目标列,如果你重命名的名称左侧已经存在。连接 superhero 到 colour 正是这种情况,因为两者都带有 id,所以在同一条命令中避开冲突(重命名从左到右应用):
FROM superhero__superhero| RENAME id AS hero_id, skin_colour_id AS id| LOOKUP JOIN superhero__colour ON id| WHERE colour == "Green"2. 在数据模型中修复。 让外键与它们指向的主键同名,问题就会永久消失。在设计阶段这样做成本很低,因此我们称之为建模习惯。
3. 使用连接谓词(Elasticsearch 9.2及更新版本)。 Elasticsearch 9.2 添加了复杂的连接谓词,可以直接比较不同名称的字段,就像SQL教你的那样:
| LOOKUP JOIN student_club__budget ON link_to_budget == budget_id谓词中的每个名称都必须明确,因此这种形式无法解决键已在两侧都存在的情况。这正是BIRD中的大多数情况,也是我们的编辑技能适得其反的地方。让模型偏好使用谓词而非 RENAME 后,gpt-5.5 在其连接中使用 RENAME 的比例从47%下降到11%,而 RENAME 原本防止的错误出现了:
Found ambiguous reference to [id]; matches any of [line 1:1 [id], line 3:15 [id]]在整个运行过程中,这个错误从120次增加到706次,而连接错误从939次下降到354次;几乎完全抵消。9.2版本发布博客介绍了新的连接形式。
2. ES|QL解析器拒绝的SQL语法
最挣扎的模型是那些沿用SQL习惯的模型。这是gpt-5.4-mini在500个base查询中丢失236个、Sonnet丢失181个的原因。
模型写出的内容 | ESQL 期望的内容 |
|---|---|
WHERE x = 5 | WHERE x == 5 |
WHERE name = 'Bob' | WHERE name == "Bob" |
CASE WHEN x > 1 THEN 'a' ELSE 'b' END | CASE(x > 1, "a", "b") |
COUNT(DISTINCT id) | COUNT_DISTINCT(id) |
DIVIDE(a, b), YEAR(d) | 这些函数不存在 |
相关子查询 | 用 STATS 和连接重写 |
单引号是其中最隐蔽的,因为在ES|QL中,双引号定界字符串,单引号不行。这里Sonnet同时使用了两个习惯:裸的=和单引号字符串,解析器在引号处停止:
FROM financial__client| WHERE gender = 'F'line 2:18: token recognition error at: '''这是唯一一个上下文文档有帮助的类别。Sonnet的181个语法错误减少到86个,gpt-5.4-mini的236个减少到150个。如果你要让较小的模型使用ES|QL,一页的语法卡片是你能放进提示词中回报率最高的东西。完整的语言参考并不更好。
3. 在一对多LOOKUP JOIN之后计数
LOOKUP JOIN 会像SQL连接一样产生扇出;当左侧一行与查找索引中的多行匹配时,你会为每个匹配得到一行输出。忘记这一点的模型会对连接后的行进行计数,而不是对问题询问的实体进行计数。这大约占“运行但错误”桶的32%。
将一个成员与其支出连接,你会为每条支出得到一行,因此简单的计数回答的是“多少笔支出”,而问题问的是“多少个成员”:
FROM student_club__expense| RENAME link_to_member AS member_id| LOOKUP JOIN student_club__member ON member_id| STATS members = COUNT(*)这里的 COUNT(*) 计数的是支出行。修复方法是计数你实际指代的实体,或者在连接前进行聚合而不是之后:
| STATS members = COUNT_DISTINCT(member_id)4. 模型猜测了一个不在数据中的值
第四类失败是模型发明了一个看起来合理但实际并不存在的值。
BIRD的数据库中充满了这类情况。一种交易类型存储为 'VYBER',而不是 'withdrawal'。要求取款时,gpt-5.4-mini 写下了英文单词,什么也匹配不到:
FROM financial__trans| WHERE account_id == 3 AND type == "withdrawal"| STATS requests = COUNT(*) BY k_symbol这条查询是有效的ES|QL,且顺利运行。但它返回空结果,因为该列中没有任何数据包含 withdrawal。同样的模式遍布整个数据集:
- 实验室结果为
'negative',而不是'-'或false - 日期通常以关键字字符串形式存在,而不是日期字段,这导致模型使用的任何日期函数失效,单独就造成了约17%到24%的错误结果
- 排序问题混淆了位置与存储的排名字段
模式块无法解决这个问题,因为模式告诉你列是 keyword,但永远不会告诉你其中包含哪些关键字。修复方法是在提示词中提供样本值:几行数据或低基数列的唯⼀值。这是检索有帮助而文档无帮助的失败类别。
结论:这对生产环境中文本到ES|QL意味着什么
我们从本次运行中得出三点结论:
- 最新的模型已经能写出不错的ES|QL: 单次调用、零样本、仅凭模式,最强模型在大多数问题上仍能正确返回数据,且几乎从未写出无法运行的查询。ES|QL对前沿模型来说已不再是生僻语言。
- 新的语言特性不会自动成为胜利: Elasticsearch 9.2 的连接谓词移除了我们最大失败类别背后的限制,让模型使用它确实将该类别从939个错误减少到354个。但总体准确率没有变化,因为模型将节省下来的“预算”花在了新的错误上。只有当你提供的指导说明何时不使用它时,特性才会带来收益。
- 除最强模型外,提示词增强对其他模型都有效: 一份紧凑的语法参考对较小模型价值约10个百分点,更完整的参考并未带来更多帮助,而前沿模型两者都不需要。给它不需要的建议,你可能反而会让它损失10个百分点。
大约一半的失败会抛出精确且可操作的Elasticsearch错误(Unknown column [gender_id] in right side of join 准确告诉你该修复什么),因此在使用像Elastic Agent Builder这样的代理时,只需一次重试并附上错误文本就能恢复大部分失败。
另一半则因猜测值而静默失败,重试也无济于事;这些需要在提示词中提供样本行和值查找。语法不再是天花板。了解你的模式和值才是,而这是一个检索问题,一个更加可控的问题。
资源
- 浏览基准测试框架及所有6,000条评分查询,或在实时交互式报告中筛选
LOOKUP JOIN命令参考,包括多字段连接和谓词形式- Elasticsearch 9.2 ES|QL版本发布博客,介绍新的连接形式
- Text-to-ES Bench (ACL 2025),本工作所基于的Query DSL基准
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号