【制造·硬件】一个 3544 轮的会话跑了 20MB:我把 WorkBuddy 的积分账单拆成 5 个能改的开关
原创
【制造·硬件】一个 3544 轮的会话跑了 20MB:我把 WorkBuddy 的积分账单拆成 5 个能改的开关
原创
用户12774540
发布于 2026-10-05 20:07:08
发布于 2026-10-05 20:07:08
一、为什么要先给积分盘账
我是做电池保护板(PCM)的硬件工程师,WorkBuddy 在我这里是每天开机的生产力工具:整理客户项目资料、写技术文档、跑定时任务、维护知识库。积分是这套东西的硬通货——签到能攒,但用起来更快。
网上讲「省积分」的文章大多是习惯清单:少问点、问短点。我不太信任这种凭感觉的省法。积分是花在每一次请求上的,而每一次请求的代价差别极大,不把账单拆开看,省的都是零头。所以在动手省之前,我先花了一个下午,把本机攒了一个月的真实数据盘了一遍。
二、输入材料:三份现成的本机数据
好消息是,WorkBuddy 的工作数据全在本机,盘账不需要任何额外工具,三条路全是现成的:
1. 会话工作区 E:\WorkBuddyData:56 个按时间戳命名的会话目录;
2. 会话记录(.jsonl):每轮对话、每次工具调用都有流水;
3. 动作审计日志(audit-log):30 天里的每一次工具执行,共 4306 条记录。
盘账当天跑的命令和真实回显如下,未做任何删改:
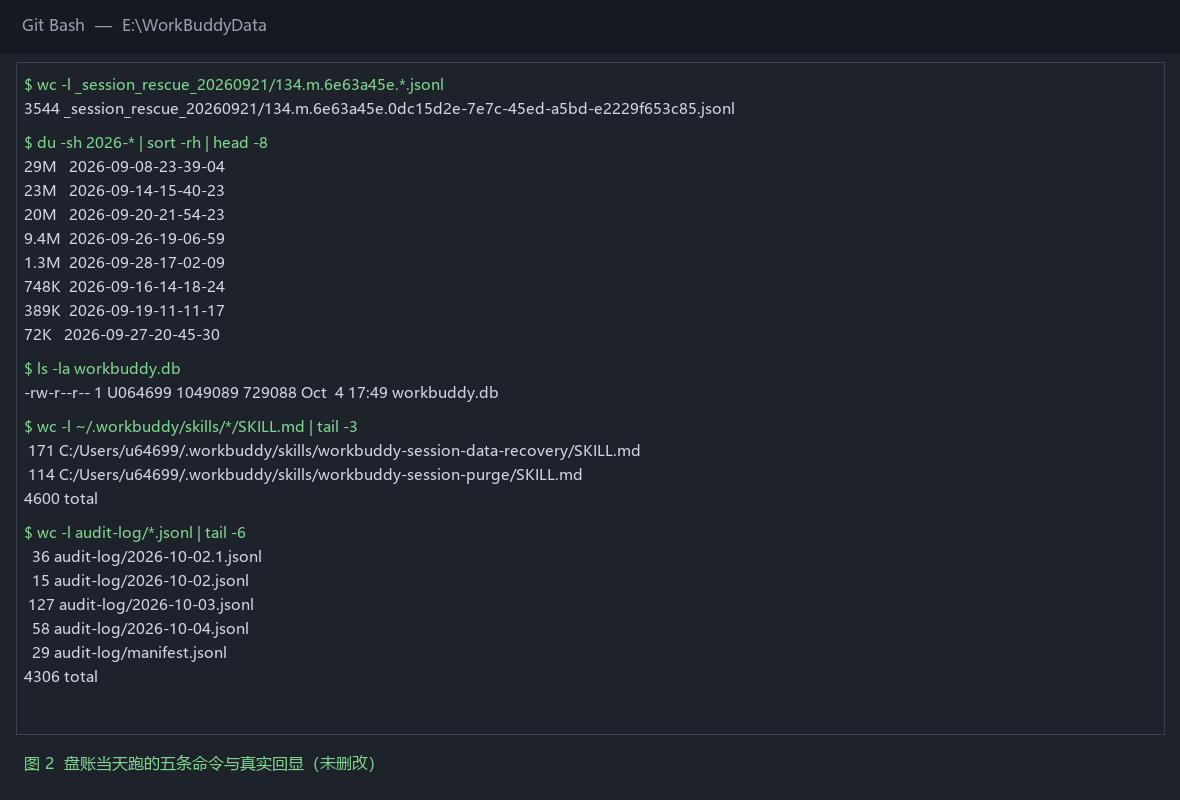
▲ 盘账实录
账面先摆出来:56 个会话合计 78.5 MB,其中最大的三个分别是 29M、23M、20M;而排在第 5 名之后的几十个会话,大多不到 1MB。数据库本体反而只有 712KB。也就是说,用量不是均匀摊在每天,而是高度集中在几条超长会话里——这就是第一个该开刀的地方。
三、盘账结果:积分是花在「重复」上的
把最大的那个会话(3544 轮)逐行累计,得到一条上下文滚雪球曲线:
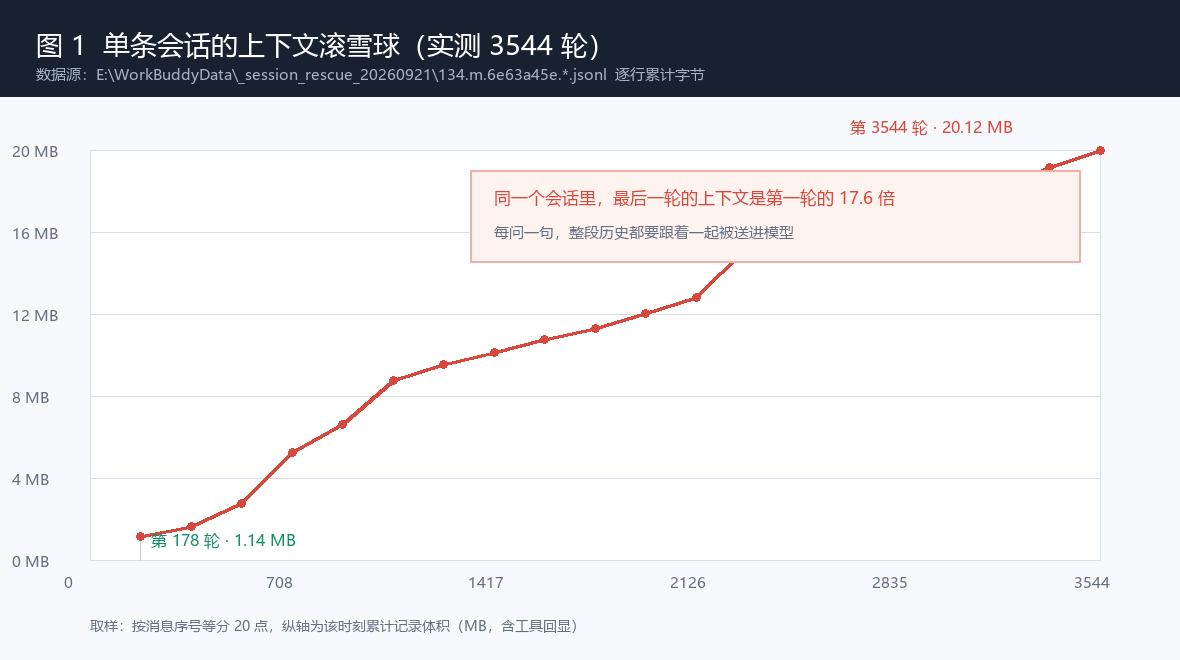
▲ 上下文滚雪球
第 178 轮时累计 1.14 MB,到第 3544 轮已经是 20.12 MB——同一个会话里,最后一轮的上下文是第一轮的 17.6 倍。原因不复杂:对话式 AI 每回答一句,都要把此前整段历史一起送进模型。会话越长,每一句都越贵,而且是整体变贵,不是增量变贵。
按这条曲线的 20 个采样点估算,这个会话后半段(第 1773 轮起)的平均上下文约 16.5 MB。对照排在后面的几十个 1MB 以下的短会话:同样问一个问题,在长会话尾巴上问,和在干净会话里问,成本差一个数量级。这就是「重复」的第一种形态:重复携带历史。
四、WorkBuddy 配置:我手里有哪些开关
盘完账,对照我在 WorkBuddy 里实际配置过的能力,能动的开关其实不少:
• Skill(自建技能):19 个,SKILL.md 主文件合计 4600 行——把「每次重新讲一遍」的流程固化成文件;
• 定时云端任务(automation):每日 4 个整点的积分签到与旅行任务,提示词自包含、无人值守;
• 本地文件读写:脚本、台账、日志都在工作区,跨会话可复用,不必每次把背景重新贴进对话;
• 蒸馏机制:把长会话的结论沉淀进话题知识库,供新会话直接继承。
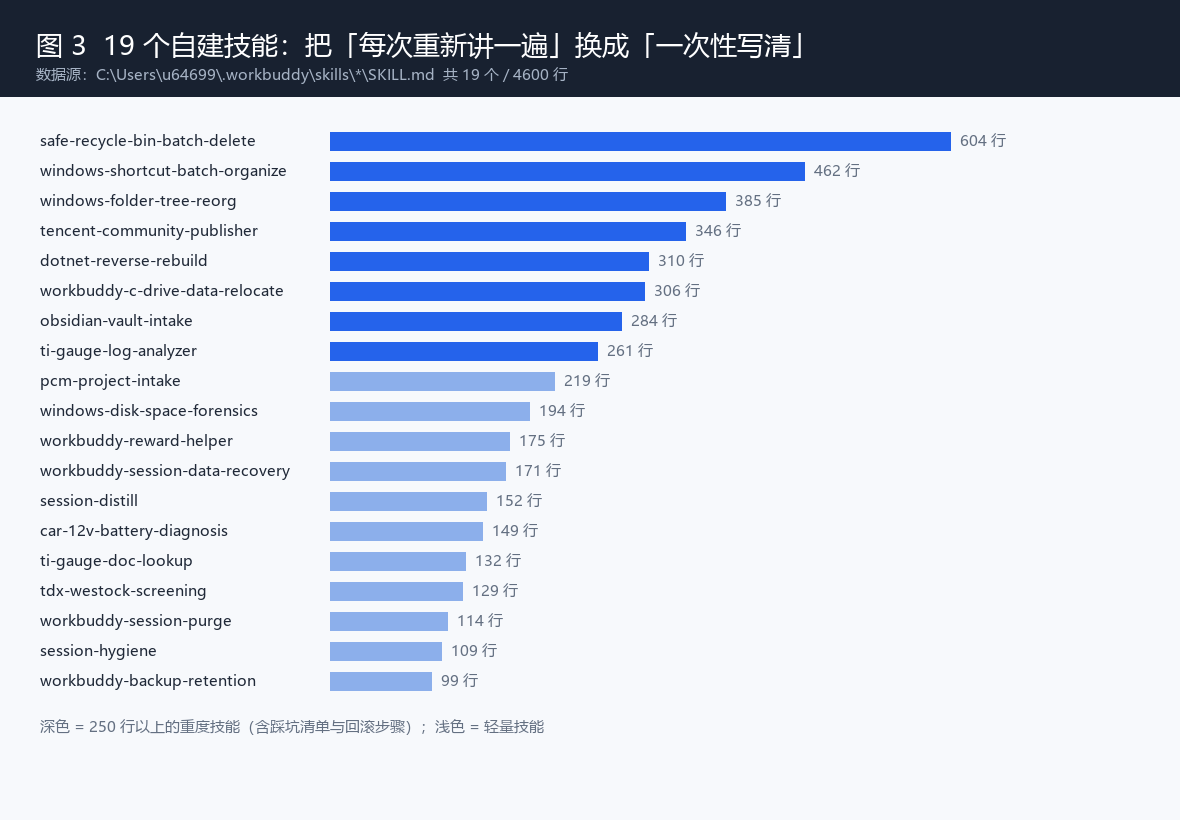
▲ 技能复用矩阵
这张矩阵是 19 个技能按 SKILL.md 行数排的。行数差别很大(99~604 行),但方向一致:凡是第二次还要解释一遍的事,第一次就写下来。
五、操作步骤:五个能改的开关,每个都对着一个数
开关①:先量化,再动手。 之前我调用量没有账,改没改对全靠感觉。现在每次大动作后都跑一遍统计脚本(Python 标准库就能写),拿真实的会话数、体积、日志条数说话。这一步的产出不是「省了多少」,而是知道钱花在哪。
开关②:流程沉淀成技能。 同一类任务我几乎不再口头解释背景——目录怎么搬、台账怎么记、浏览器怎么开,全部写在对应技能里。中途调过一次方向:最初我把技能写成了流水账,主文件越长,每次加载吃掉的上下文也越多。后来改成「主文件只写怎么干 + 硬教训清单单独成段」,按需阅读,主文件行数就压住了。技能本质上是把重复的解释从每一次对话里搬走。
开关③:定时任务用短提示。 每日签到这类固定动作交给 automation,提示词一次写清、自包含,运行 17 天攒下 121 行日志、1613 积分,中途没有人工盯点。对比以前靠人记得点签到、断签重来,这条治的正是「重复的手工操作」——写一次,跑一个月。
开关④:会话按需分家。 一个会话扛到底是我最大的历史包袱。现在按「一类问题一个会话」开新会话,过长的会话先用蒸馏把结论存进话题库、再开新的。中途踩过一个坑:拆太早会丢上下文,重讲一遍背景反而更贵。折中方案是先蒸馏再分家——结论进了知识库,新会话一行回执就能继承,不用重讲。按盘出来的曲线估算,这么拆之后,原来 16.5 MB 量级的平均上下文能降到 1~3 MB。
开关⑤:产物最小化。 我曾经一次任务被产出几十个中间文件,事后清理本身就是成本。现在的规矩是:临时脚本只进工作区、任务完成即清、每轮只留最终交付物。省的不只是磁盘,还有下一次会话为了理解这些残留文件而付出的上下文。
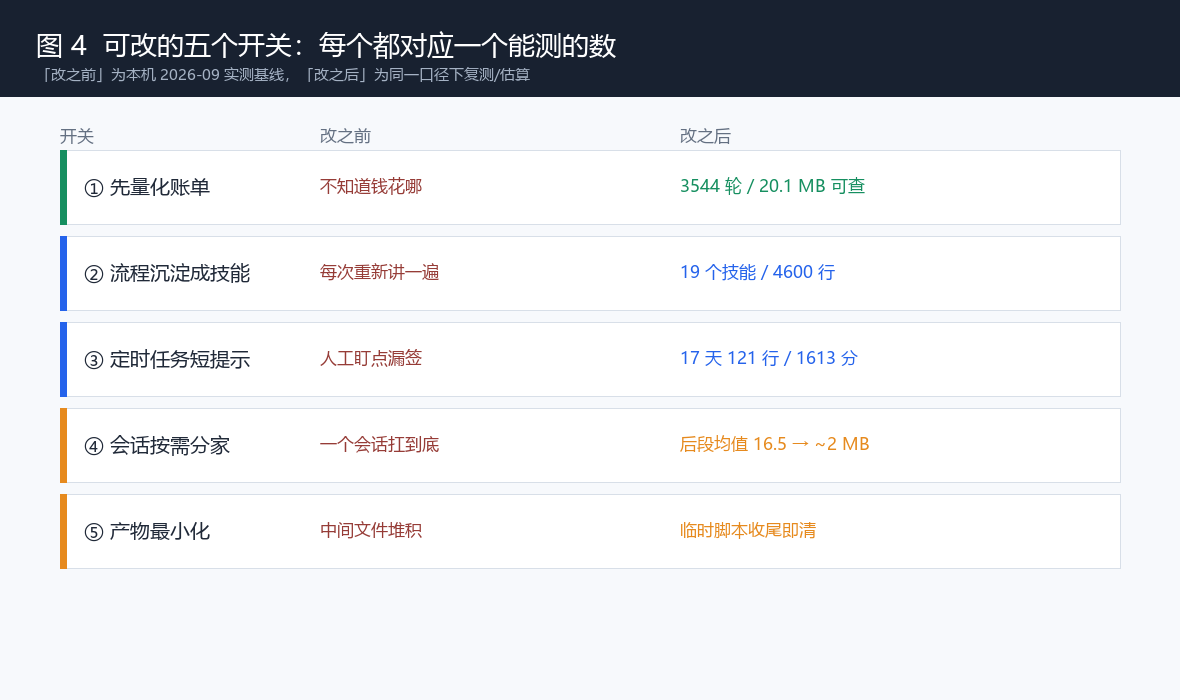
▲ 五个开关
六、产出物:一套可以复跑的账
这一轮盘账结束后,留在硬盘上的东西都能复用:
1. 盘账脚本(约 100 行 Python,纯标准库):一键输出会话体积分布、技能矩阵、审计日志统计,下次复查直接跑;
2. 19 个自建技能 / 4600 行 SKILL.md:覆盖目录治理、会话恢复、发文、选股、文档检索等日常动作;
3. 两份台账 CSV:发布台账(6 篇文章的日期、标题、链接、状态)与积分快照(剩余 343.71 / 容量 4969);
4. 6 篇已发布的完整案例:从目录治理、磁盘清理到技能搭建,每篇都对应本文明说的某个开关;
5. 一份话题知识库:长会话蒸馏后的结论按话题归档,新会话免重讲。
七、复盘:两个反直觉
第一,会话不是越长越划算。 我曾经以为同一个会话里连续追问省事,账单显示恰恰相反:每一轮都拖着全部历史走,17.6 倍的差距就是这么来的。真正省钱的做法是让上下文保持「刚够用」——靠技能和知识库外置记忆,而不是靠会话本身记住一切。
第二,省积分的最大杠杆不在「少用」,而在「不重复」。 重复的解释、重复的踩坑、重复的产物,才是账单里的大头。把重复的部分固化到文件里(技能、台账、蒸馏笔记),每一次对话就从「从头讲一遍」变成「从清单上打钩」。
这套五个开关现在还在跑。下个月再盘一次账,数字不会骗人。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号