你的 trace 止步于 span;使用 OpenTelemetry 的持续性能分析不会
原创
你的 trace 止步于 span;使用 OpenTelemetry 的持续性能分析不会
原创
点火三周
发布于 2026-10-15 11:52:48
发布于 2026-10-15 11:52:48
持续性能分析现在是 OpenTelemetry(OTel)的一种信号,而 Elastic 可以从你从未碰过的应用中收集它。OpenTelemetry Profiling 集成使用 eBPF 对 Linux 主机上的每个进程进行采样,因此无需修改代码或重启即可运行 CPU 性能分析。在我们的实验室中,一个未修改的 Spring PetClinic 在四分钟内于略多于半个 CPU 核心上处理了 30,150 个请求。火焰图将这些采样解析为 Spring Data repository 调用、Hibernate 查询,以及 H2 结果处理。该集成是一个技术预览版。我们通过 Fleet 安装它,并在 Kibana 中读取火焰图,然后使用 Elasticsearch Query Language(ES|QL)查询存储的采样数据。
先决条件:内核、Elastic Agent 版本和权限
- Kibana 和 Elastic Agent 9.4 或更高版本。这是一个 由 Fleet 管理的 OpenTelemetry 输入包:Elastic Agent 以默认模式运行,并为你管理 OTel Collector 的
profilingreceiver 和 Elasticsearch 输出。 - 运行内核 5.10 或更高版本、基于 amd64 或 arm64 架构的 Linux 主机。你可以在此找到配套的 notebook:这里。它完整重现了本文的示例,包括创建策略、查询采样数据,以及其中的步骤和最后的清理工作。
持续性能分析能展示哪些 trace 无法展示的
Trace 通过已埋点的操作追踪一个请求,而 CPU profile 则对当前活跃的调用栈进行采样:即那一刻正在执行的函数调用链。由于采集是持续进行的,因此它也涵盖后台线程以及那些从未获得 span 的代码:
证据 | 说明什么 | 还应检查什么 |
|---|---|---|
慢 span | 某操作花费了时间。 | CPU 工作与等待时间之比。 |
CPU profile | 运行时采样到了哪些函数。 | 在正常流量下相同工作是否反复出现。 |
垃圾回收中的 CPU | 运行时消耗 CPU 管理内存。 | 内存泄漏的分配或堆证据。 |
请注意,此预览版仅采集 CPU profile,不提供堆或分配 profile。
Profiles 于 2026 年 3 月进入 OpenTelemetry Alpha 阶段,截至 2026 年 9 月 15 日仍处于 Alpha 状态,因此 Elastic 的集成 0.0.1 是一个技术预览版。我们的 Profiles Alpha 文章 介绍了该里程碑背后的工作。
如何使用 OTel 设置持续性能分析
整个设置由一个 Fleet 策略和一个已注册的 agent 组成。
步骤 1:初始化 Universal Profiling 存储
该集成会写入与 Universal Profiling 读取相同的 profiling-* 索引,因此这些索引必须首先存在。如果你的部署从未使用过 Universal Profiling,请打开 Infrastructure > Universal Profiling,然后选择 Set up Universal Profiling。这需要 superuser 权限,并且每个部署只需执行一次。
步骤 2:在 Fleet 中创建 Profiling 策略
在 Integrations 中,搜索 OpenTelemetry Profiling,然后选择 Add OpenTelemetry Profiling。
注意: 如果集成未显示,请将你空间的 solution view 切换到 Observability,然后重新搜索。在经典视图中,Kibana 会从目录中隐藏技术预览版集成。
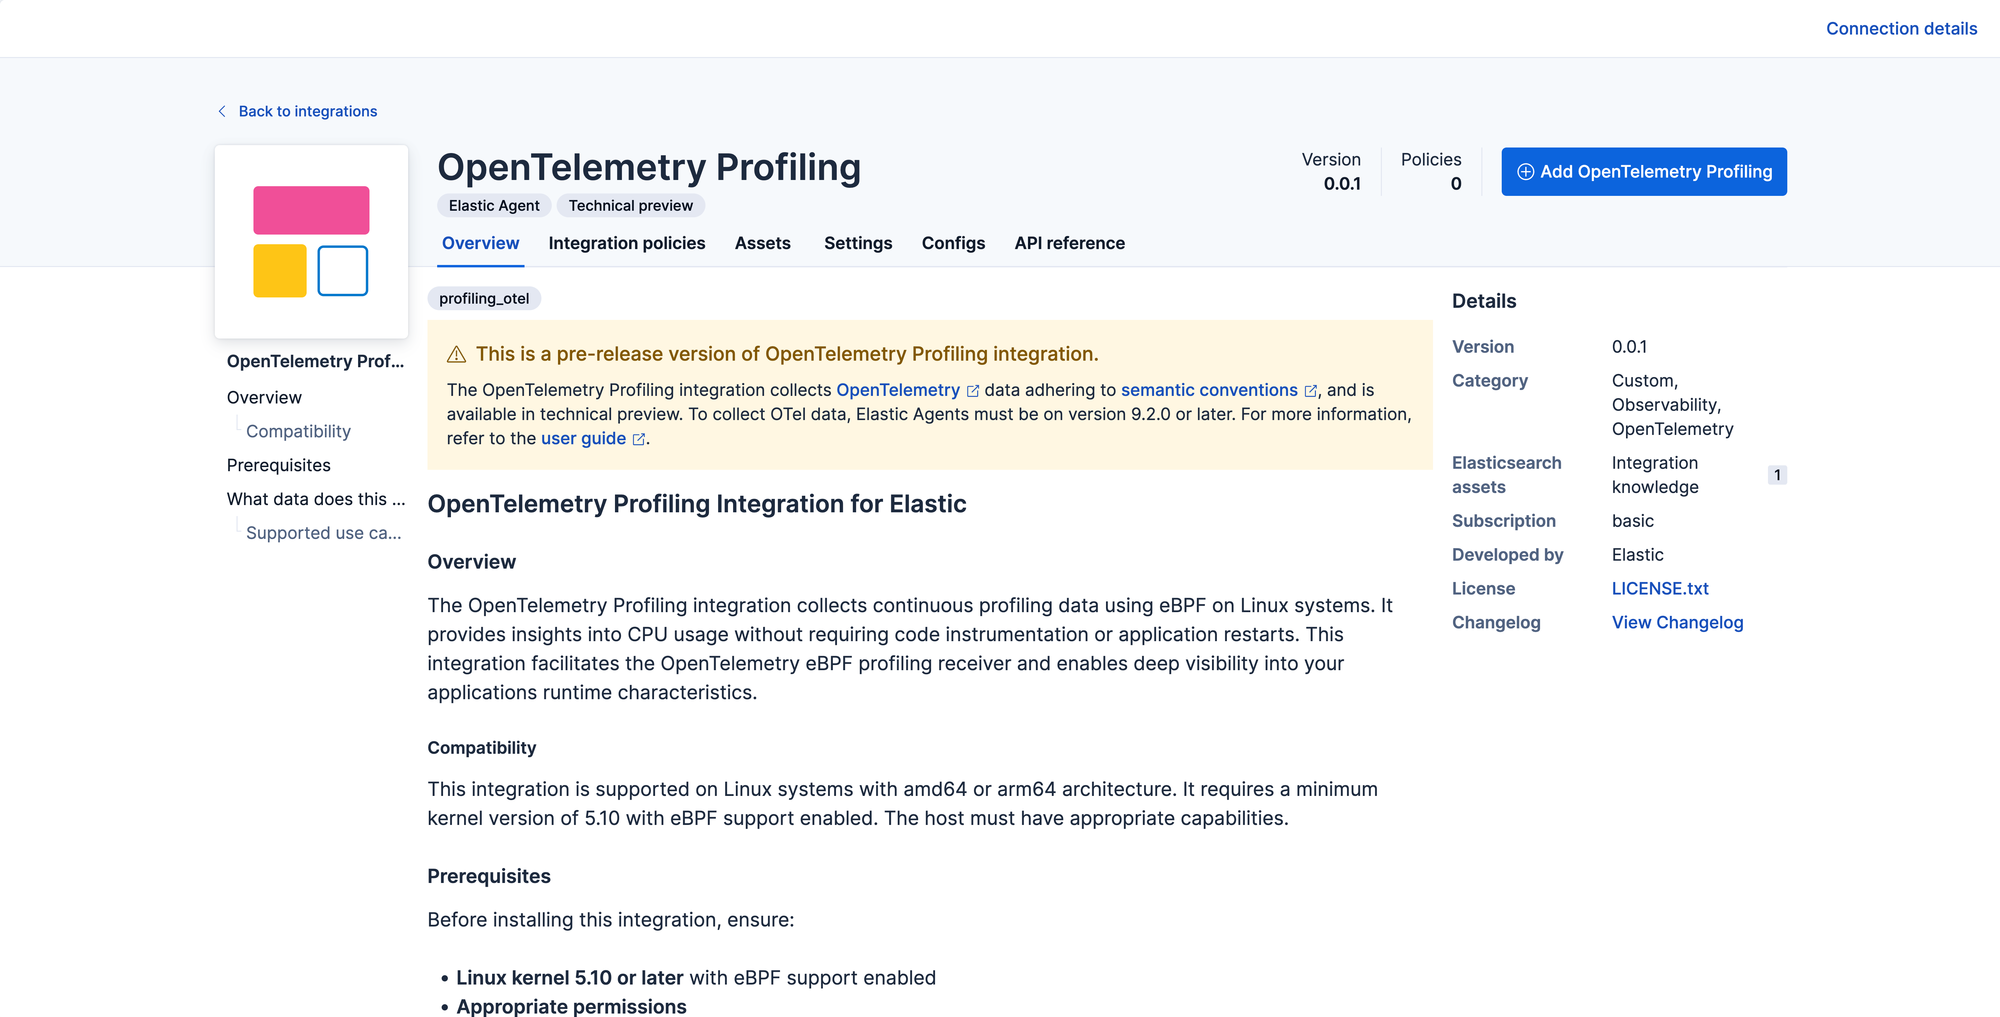
Kibana integration page for OpenTelemetry Profiling 0.0.1, the continuous profiling technical preview, with Add button
为集成命名,并保持其 receiver 启用。展开 Change defaults,然后展开 Advanced options 以设置 samples\_per\_second;我们将使用 20。选择一个新的 agent 策略,并保持 Collect system logs and metrics 不勾选,这样火焰图将只包含 profiler 的数据。然后选择 Save and continue。
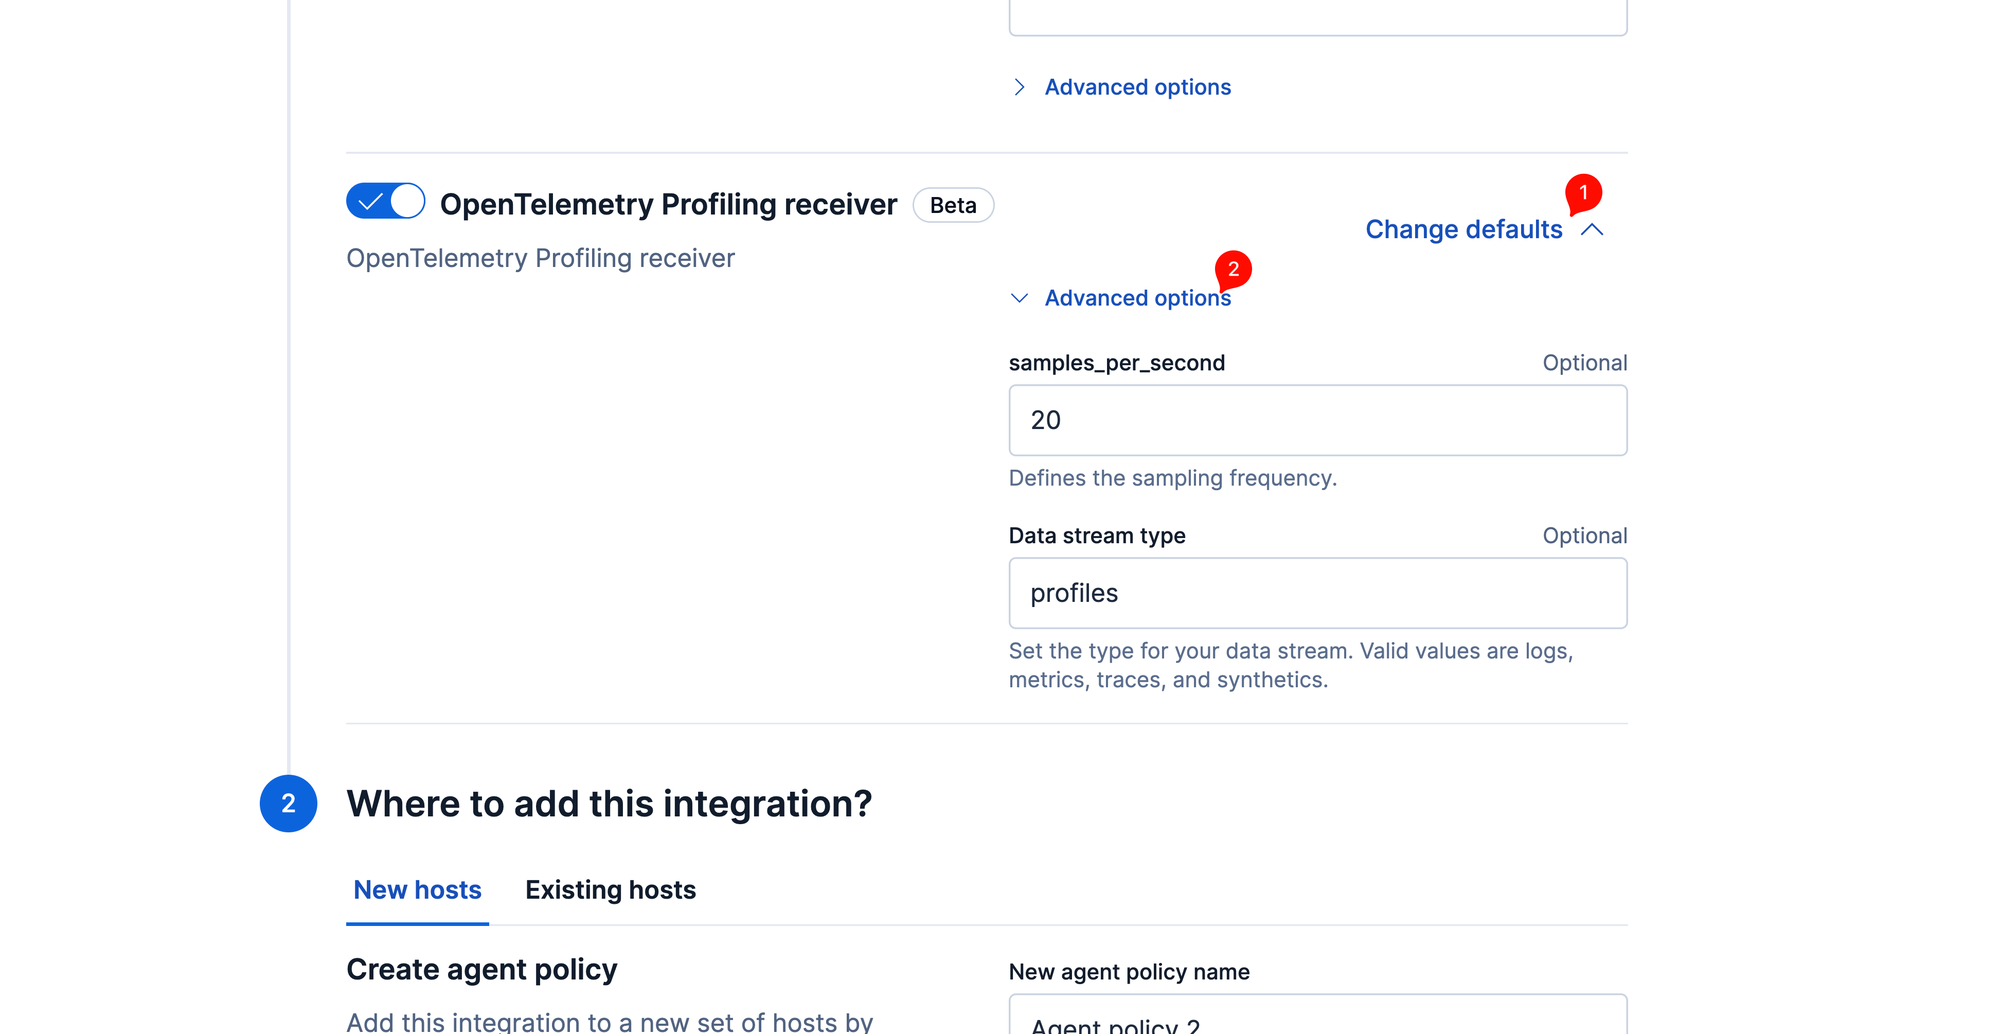
OpenTelemetry Profiling receiver in a Fleet policy with samples_per_second set to 20 for CPU profiling
步骤 3:注册你的 Linux Agent
选择 Add Elastic Agent to your hosts,然后按照适用于你平台的注册说明进行操作。对于 Docker,请使用 官方 Elastic Agent 容器流程,并具备 Linux 主机进程可见性以及 profiler 所需的 eBPF 权限。截图使用的是运行内核 6.10.14 的 Linux ARM64 虚拟机(VM)中的 Elastic Agent 9.5.3,对未修改的 Java 示例进行性能分析。
步骤 4:确认 Agent 正常且正在发送采样数据
在 Fleet > Agents 中,打开新 agent 并确认其状态为 Healthy,并且列出了 profiling 集成:
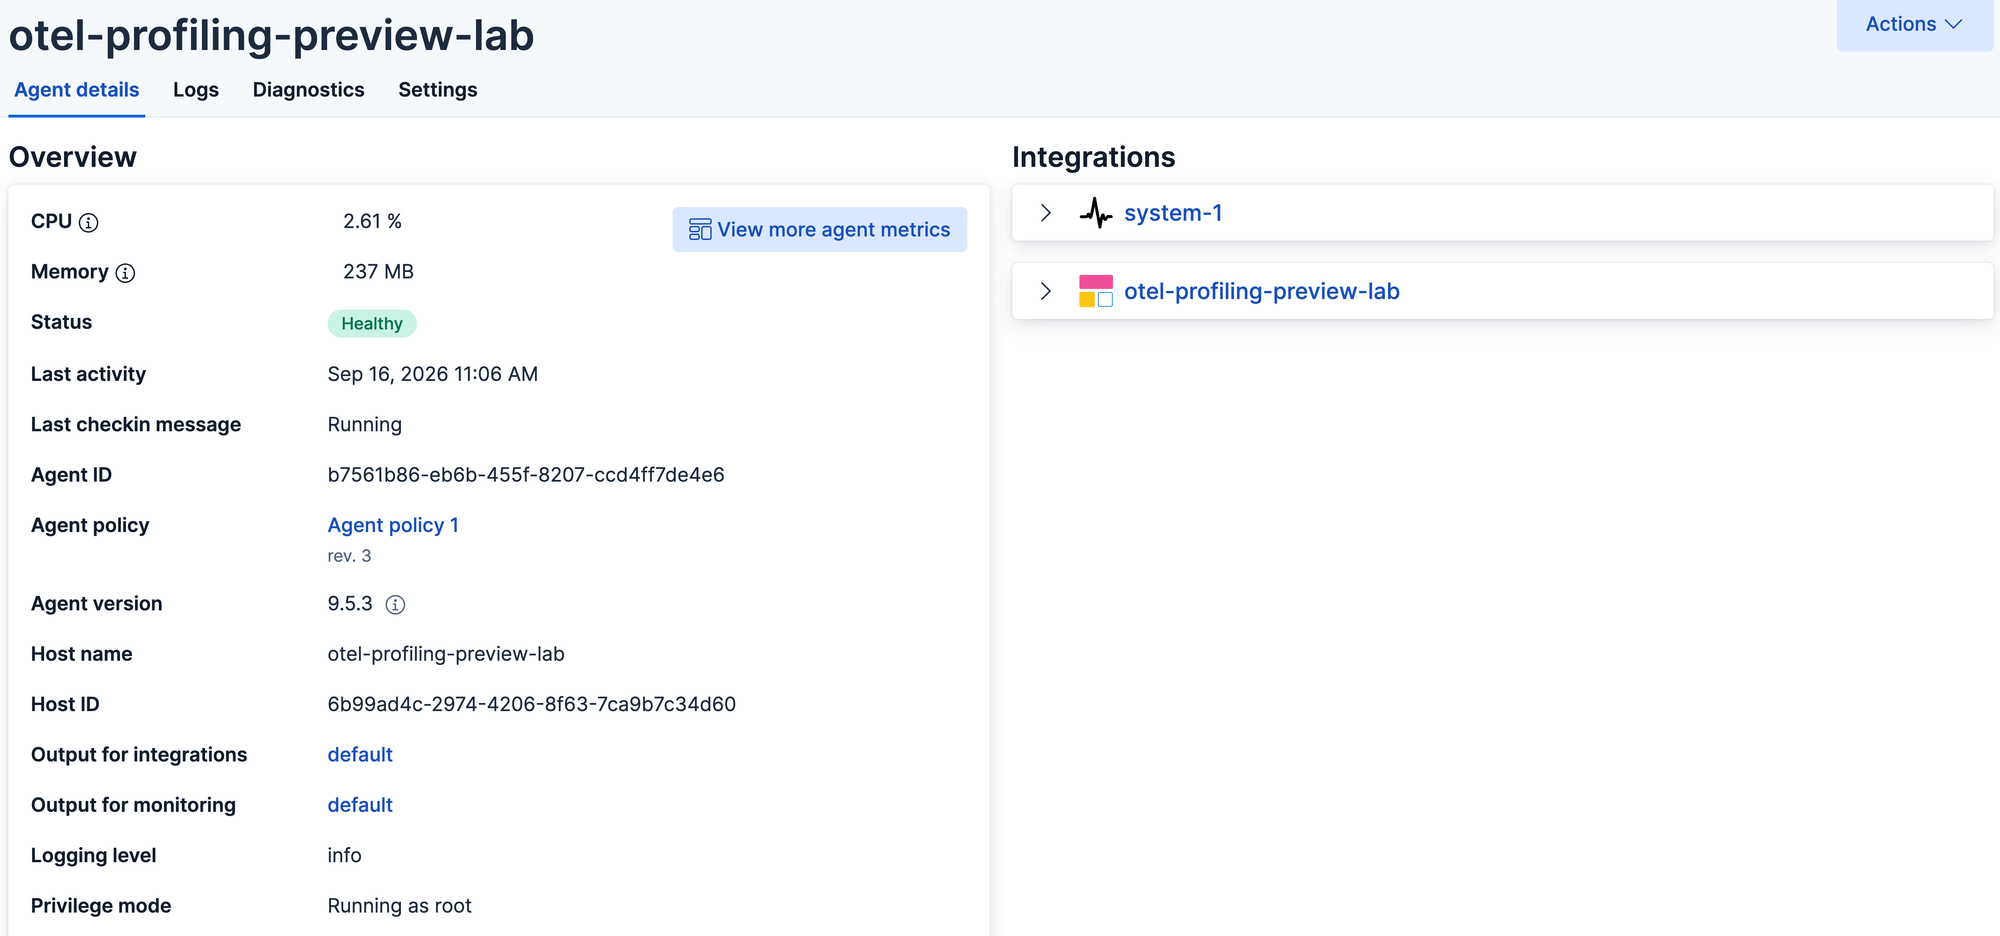
Fleet agent details showing Elastic Agent 9.5.3 Healthy with the OpenTelemetry Profiling integration attached
对 PetClinic 产生一些流量(notebook 会运行一个四分钟的循环,包括 owner 搜索、owner 页面和 vets 列表),然后检查该时间窗口的火焰图。仅凭 agent 健康状态并不能确认采样数据已经到达。
步骤 5:如何阅读火焰图并定位 CPU 工作
打开 Infrastructure > Universal Profiling > Flamegraphs,选择流量窗口,然后过滤到该应用:
process.executable.name : "java"采样数据会解析为 Java 函数,包括 Spring Data repository 调用、Hibernate 查询以及 H2 结果处理。
注意: profiler 通过读取 HotSpot Java 虚拟机(JVM)的内部结构来解析 Java 帧,因此应用必须运行在常规 JVM 上。而 GraalVM 原生镜像,例如已发布的 spring-petclinic 容器镜像,其 CPU 采样仍会计数,但每个调用栈都会止步于单个原生帧。
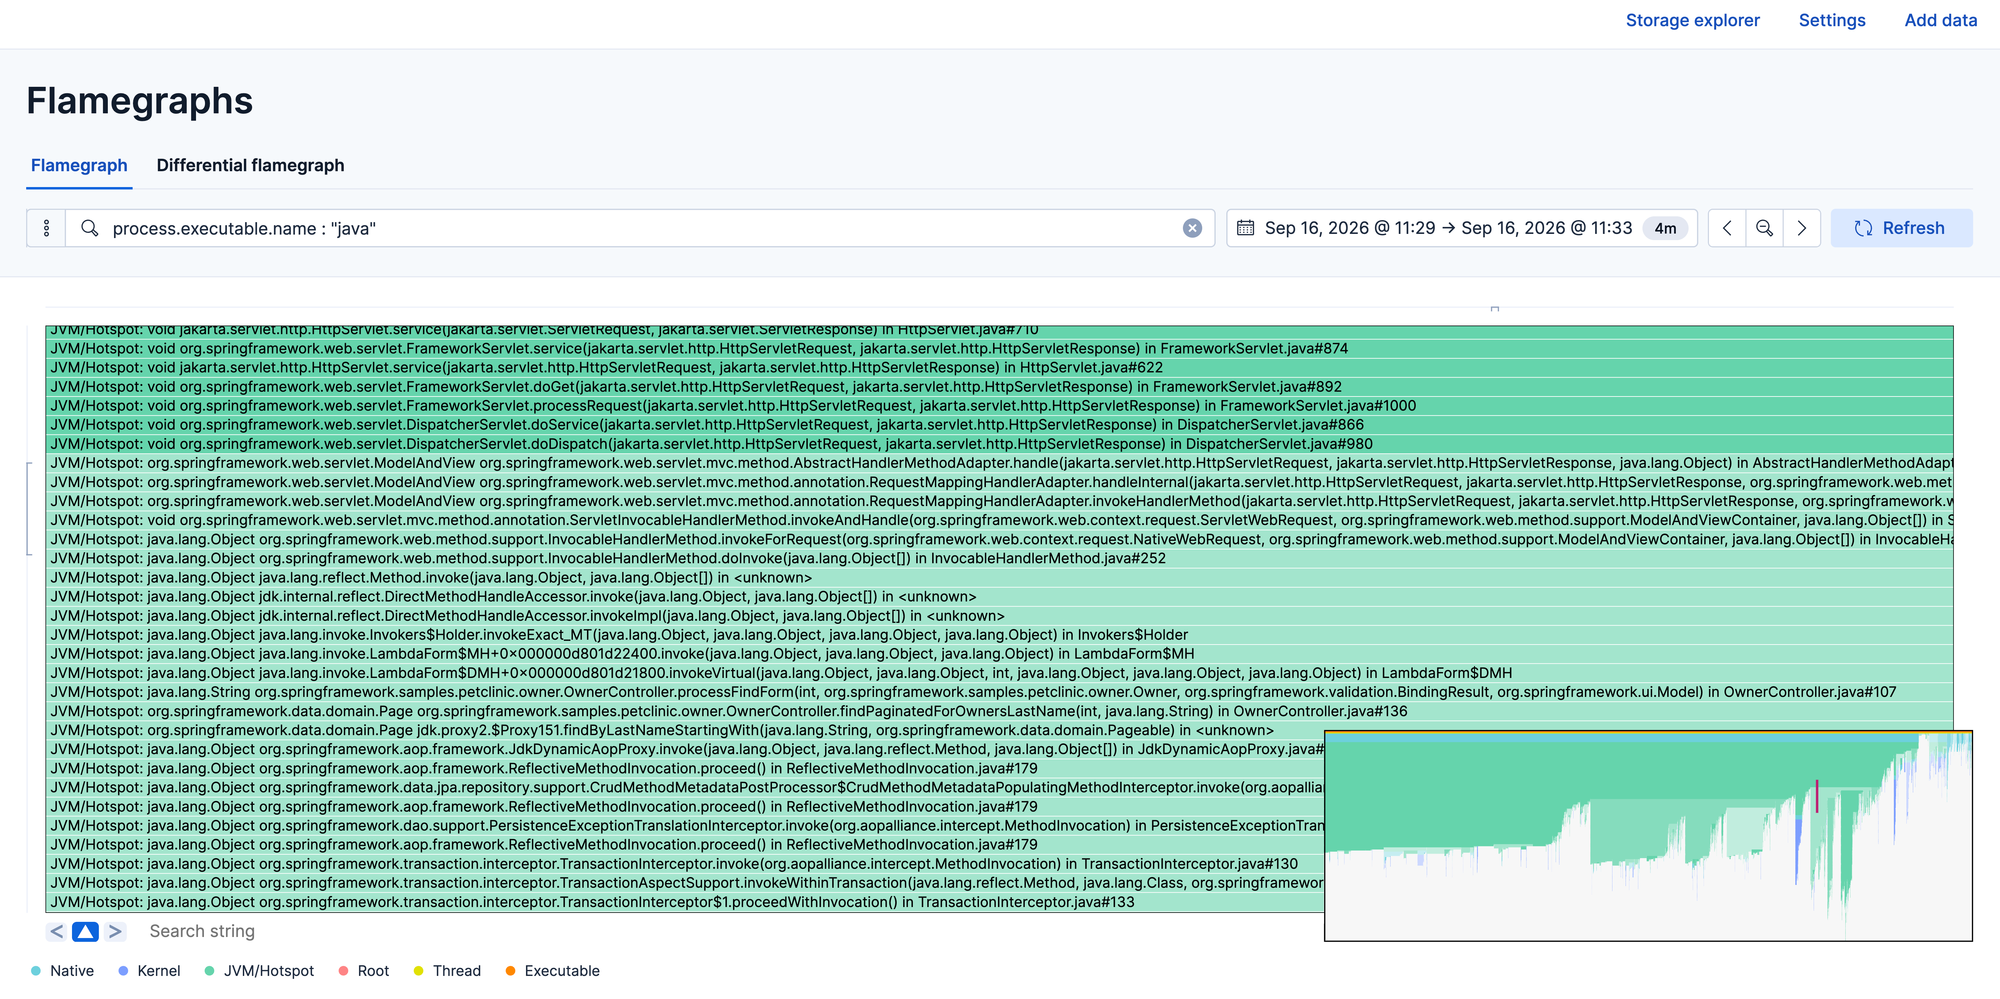
CPU profiling flamegraph in Kibana Universal Profiling showing Java Spring PetClinic frames filtered to process java
如何阅读火焰图:
- 宽度是信号。 更宽的帧代表在你所选时间窗口内占用了更多采样。
- 垂直堆叠是调用链。 调用者在下方,被调用者在上方。
- 水平位置没有意义。 这不是时间线;左侧的帧并不比右侧的帧更早。
- 先看整体,再逐步聚焦。 沿着最宽的分支向下查找,或搜索你自己的函数之一,然后放大。
本次捕获是四分钟的合成流量突发,因此在决定优化什么之前,请与稳定流量窗口进行对比。同时要记住采样的含义:一个采样到的数据库调用表示 CPU 在该调用栈中执行。它并不衡量在数据库上等待的时间。
步骤 6:使用 ES|QL 查询 CPU 性能分析采样
Profiles 是常规文档,因此我们可以对其进行查询。在 Discover 中,选择相同的时间窗口,然后运行:
FROM profiling-events-all

| WHERE process.executable.name == "java"

| STATS samples = SUM(Stacktrace.count)  BY minute = BUCKET(@timestamp, 1 minute)

| SORT minute
Stacktrace.count 是每个事件中存储的 CPU 采样数量,因此该查询会返回每分钟的采样计数。在此次运行中,它在五个桶中返回了 691、644、715、664 和 131 个采样;流量运行了四分钟,因此第一个和最后一个桶是不完整的。notebook 通过 ES|QL API 获得了相同的数字。
Profiler 每秒对每个 CPU 核心采样 20 次,因此一个完全繁忙的核心每分钟累计 1,200 个采样。在我们的六 vCPU 主机上,PetClinic 在四分钟内处理 30,150 个请求时,仅让略多于半个核心保持繁忙。请注意,这些计数不是毫秒或 CPU 百分比:
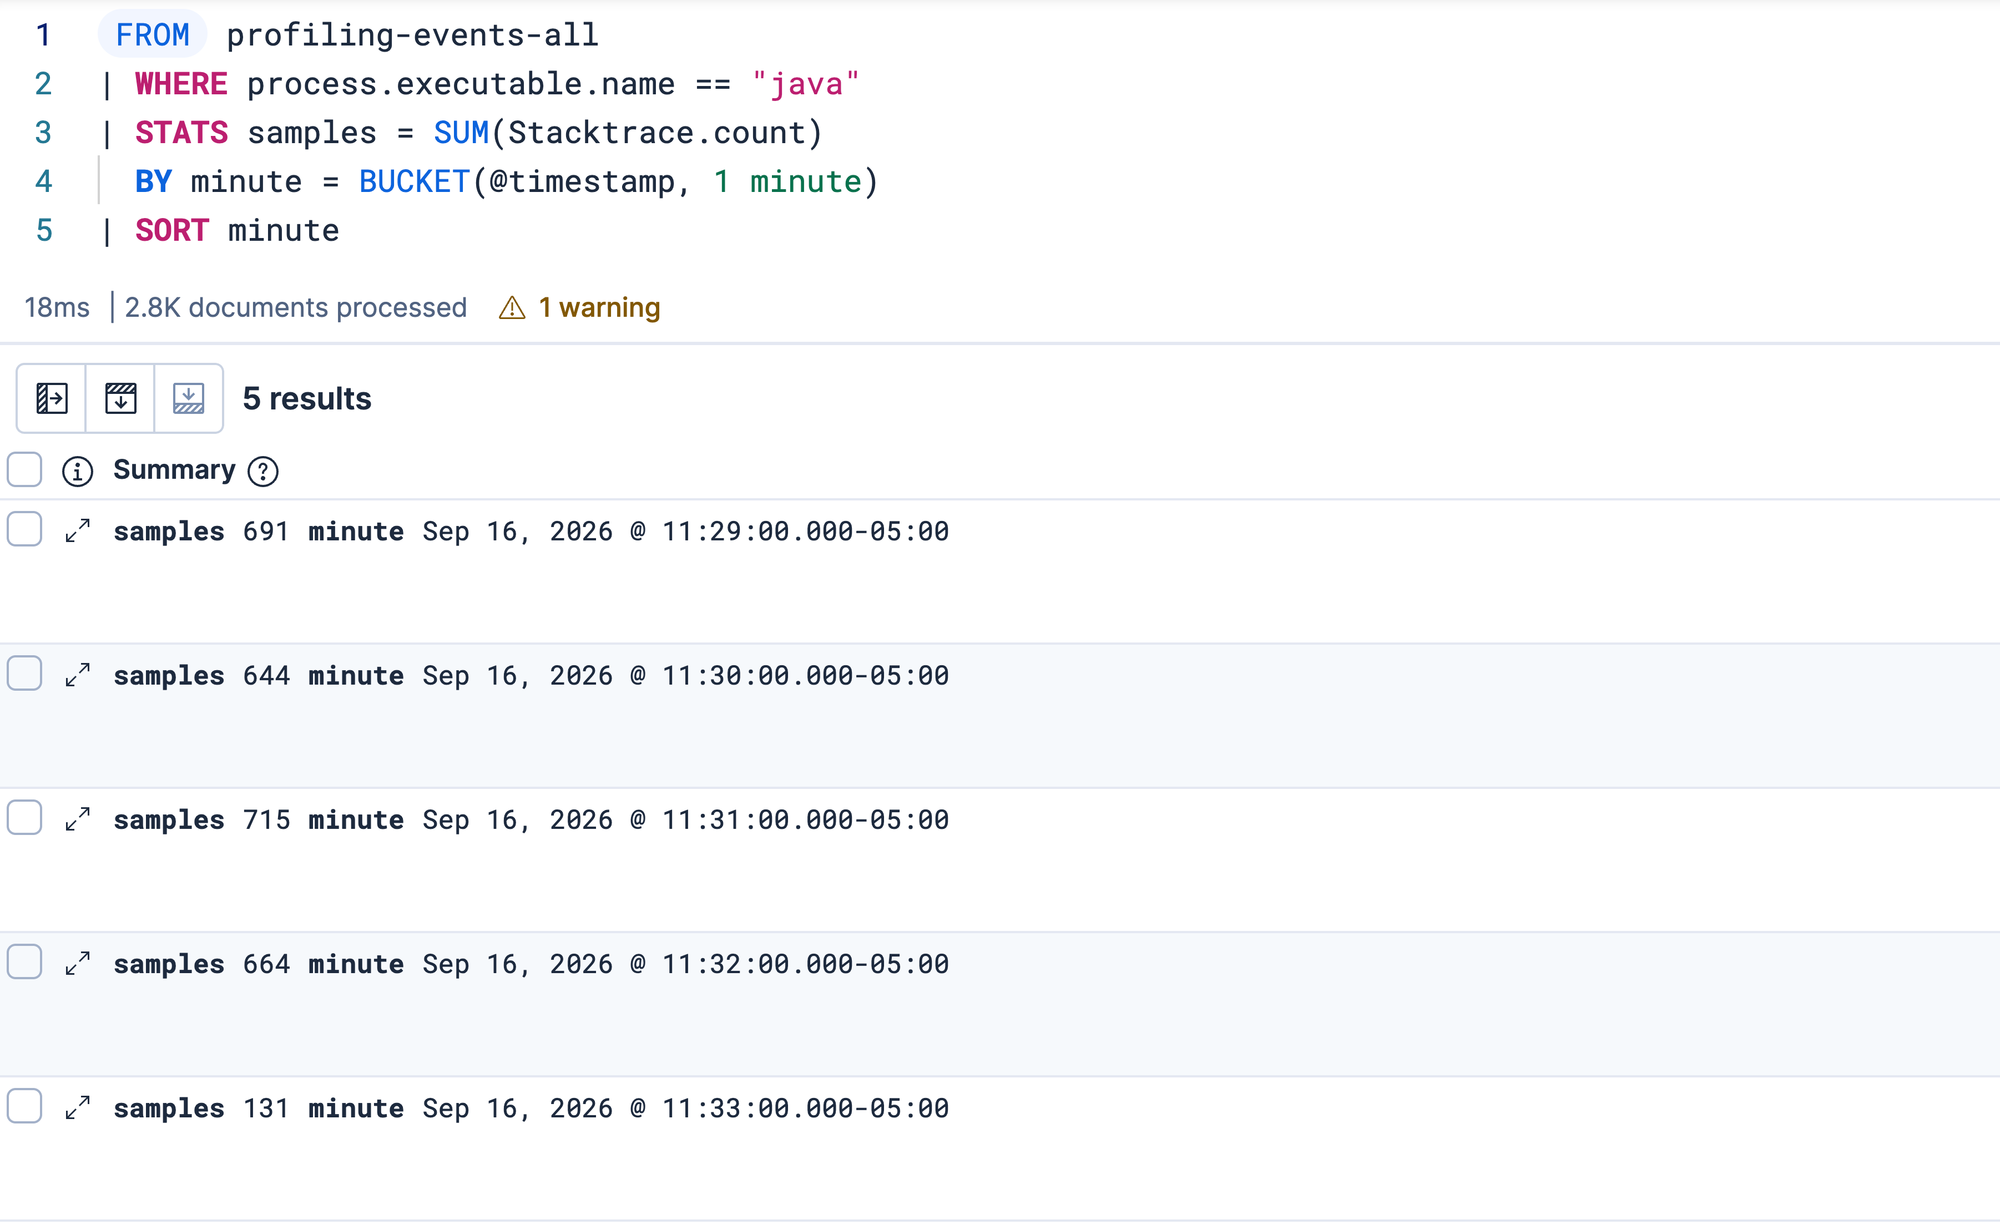
ES|QL query over profiling-events-all returning CPU profiling samples per minute: 691, 644, 715, 664 and 131
将 Profiles 与 Traces 和 CPU 指标关联起来
OpenTelemetry Profiles 数据模型支持与 trace\_id 和 span\_id 的关联。在配置了兼容的 instrumentation 和 correlation 后,一个慢 span 可以带你找到其采样到的 CPU 调用栈。单独的 profiling 包并不会对请求进行埋点,也无法完成该设置。我们的 trace-to-profile 关联演示 展示了如何在 Stack 8.13 上使用 Elastic Distribution of OpenTelemetry (EDOT) Java 实现这一功能;与这个预览版包的关联需要单独验证。
对于按运行时或内核类别的 CPU 趋势,profilingmetricsconnector 会将调用栈转换为 OTel 时间序列计数器,例如 hotspot.count 和 kernel.count。该 connector 运行在你自己的 OTel Collector 管道中;它不属于此包生成的配置的一部分,其仪表盘作为单独的 Kibana 集成提供。一旦你有了基线,这些计数器就可以用于 ES|QL、仪表盘以及机器学习(ML)异常检测。你可以通过 Observability Labs 的这篇文章了解更多关于此 connector 的内容。
如何开始使用持续性能分析
借助 OpenTelemetry Profiling 集成,添加第四个信号只需一个 Fleet 策略和具备正确权限的容器。它不需要修改代码或重启,且 profiles 会落到你当前正在使用的同一个 Universal Profiling 视图和 ES|QL 中。从一个你已经在通过日志、指标以及应用程序性能监控(APM)进行排查的服务开始,为它添加 CPU profile。找到反复出现的负载,并在变更后对比相同的工作负载。
该集成是建立在 Alpha 信号之上的技术预览版,因此预计包和数据模型会发生变化。配套的 notebook 会创建策略、运行实验,并进行清理,因此你可以在几分钟内用更新的版本重复整个练习。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号