一条 ES|QL 查询,365 天的审计日志:在热数据与可搜索快照上执行相同搜索
原创
一条 ES|QL 查询,365 天的审计日志:在热数据与可搜索快照上执行相同搜索
原创
点火三周
发布于 2026-10-15 11:54:52
发布于 2026-10-15 11:54:52
在实时数据上重建用户活动的 Elasticsearch 查询语言(ES|QL)查询,可以原封不动地针对挂载的可搜索快照运行,这正是让 365 天审计日志策略切实可行的关键。你调查一年前事件的方式,与调查昨天事件的方式完全相同。
在本文中,我们追踪六条来自公司管理控制台的审计事件,它们经由 Elastic Distribution of OpenTelemetry(EDOT)Collector 进入专用数据流。其中一条事件涉及名为 alex 的用户——他两次登录失败,第三次成功进入系统,随后尝试变更角色。我们用一条 ES|QL 查询重建该时间线,并回读保留策略以确认其已生效。然后,我们在快照支持(snapshot-backed)的索引上重新运行相同查询。最终获得的证据可直接交给审计员并加以解释。
前提条件
- Elasticsearch 和 Kibana 9.5+
- Docker,用于运行
elastic-otel-collector:9.5容器 - 由超级用户创建的 API 密钥
配套的 notebook 位于此处。它完整复现了本文的整个实验,包括 Collector 配置、可搜索快照以及中间步骤,并在最后执行清理。
审计日志能告诉你哪些应用程序日志无法告知的信息
应用程序日志通常解释软件的行为表现,例如超时、异常,甚至连接失败。而审计日志通过记录操作者(actor)、操作(action)、目标(target)、结果(outcome)和时间来建立问责机制。它们也有助于调试,但其核心价值在于重建活动轨迹并证明控制措施是如何运作的。
一次被完整捕获的 Kubernetes RoleBinding 变更
在 Kubernetes 中,Role 定义权限,RoleBinding 在命名空间内将权限授予某个身份。当审计策略包含这些资源时,两者的变更均会被审计。以下是在一个隔离的 Kubernetes 1.35.0 实验环境中捕获的真实 RoleBinding 创建事件。它通过 OpenTelemetry(OTel)收集并在 Elasticsearch 中查询。
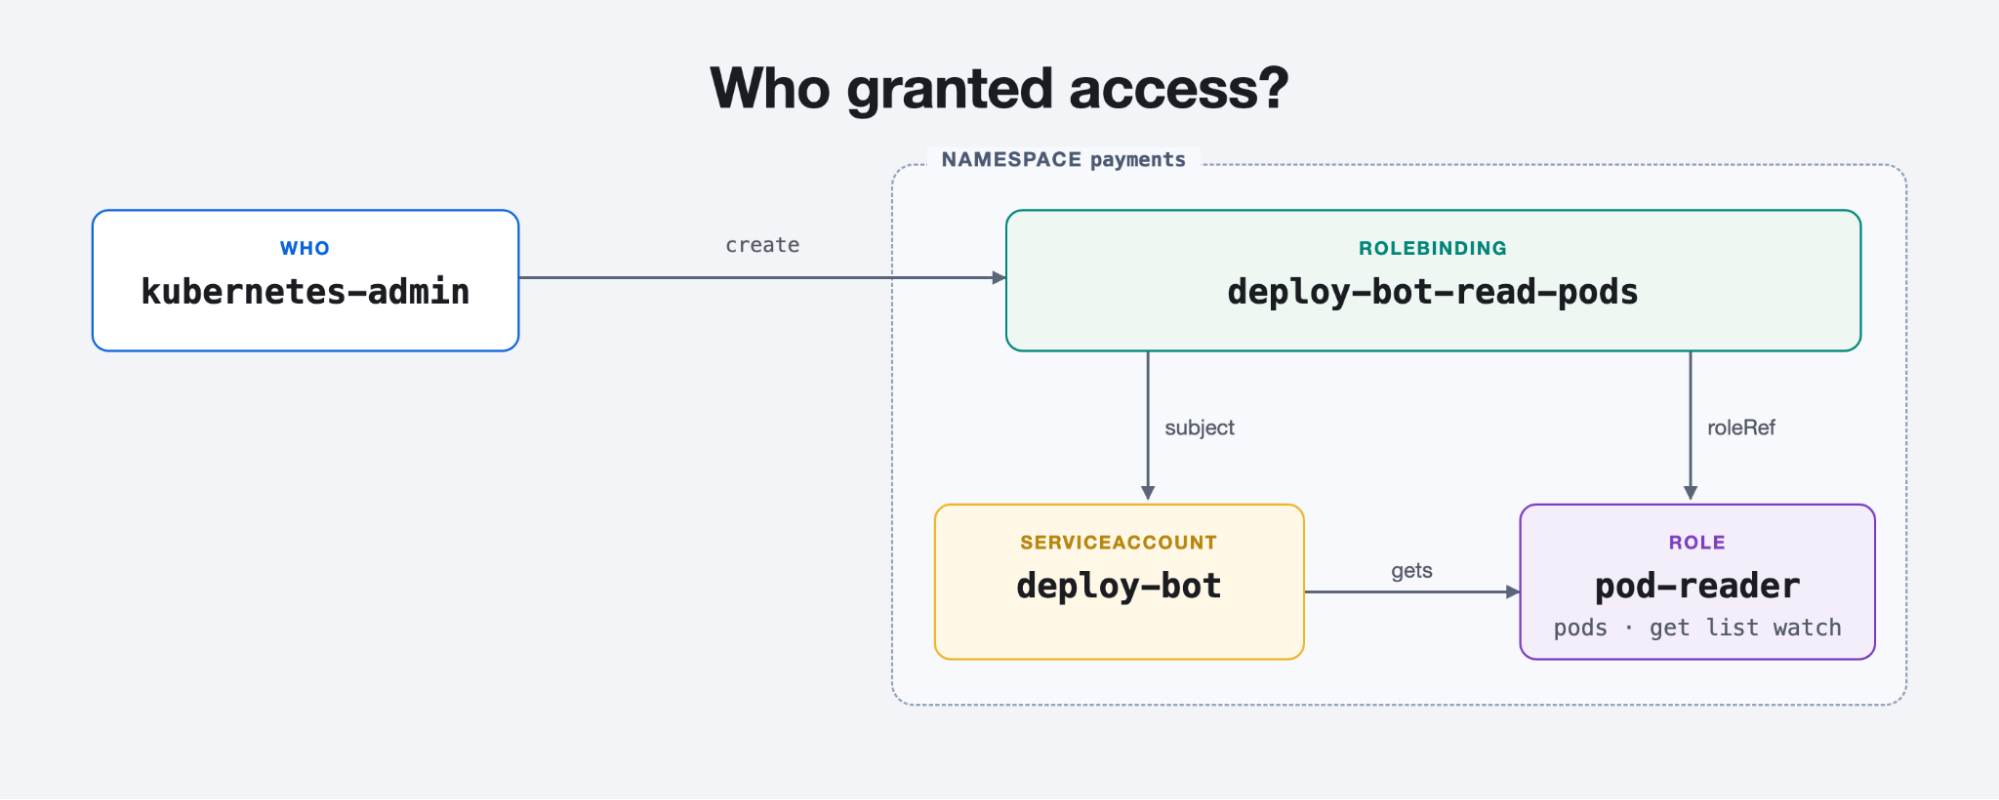
Kubernetes 审计日志示意图:kubernetes-admin 创建 RoleBinding,将 pod-reader 角色授予 deploy-bot
该成功请求将现有 pod-reader 角色授予 payments 命名空间中的 deploy-bot 服务账户。RoleBinding 的 subjects 与 role 引用来自其请求体,由本实验针对性的 Request 审计级别捕获。仅使用 Metadata 级别的日志将无法记录该请求体。
审计日志的来源
常见的审计日志来源覆盖了事件链条的不同环节:
来源 | 能回答的问题 |
|---|---|
Kubernetes API 审计日志 | 谁请求了资源变更,API 服务器如何响应? |
云服务商操作轨迹(trails) | 哪个主体对哪个资源执行了 API 操作? |
身份认证系统 | 谁登录成功或认证失败?谁变更了权限? |
数据库审计日志 | 谁访问了敏感对象或更改了数据库权限? |
收集工作始于在源头启用正确的事件。云数据访问事件可能需要额外配置;数据库慢查询日志并非完整的访问审计。对于 Kubernetes 环境,请使用现有的托管 Kubernetes 审计日志教程。
审计日志管道的四项要求
四项要求决定了审计管道的形态:
要求 | 设计决策 |
|---|---|
长期保留 | 将审计数据保存在具有明确保留策略的数据流中,与短生命周期的运维日志分离。 |
不可变性 | 明确谁不能更改或删除记录,以及持续多长时间。只读索引并不能阻止特权管理员的操作。 |
防篡改可证性 | 保留原始数据以及独立受保护的验证材料,以便检测变更或缺失的记录。 |
访问控制 | 将收集、调查和保留管理权限分离;记录对这些控制措施本身的变更。 |
对于 System and Organization Controls 2(SOC 2)或 ISO/IEC 27001 而言,日志支撑着控制措施背后的证据;但仅存储日志并不能建立合规性。你需要就记录哪些活动、每份副本保留多久、谁可以检索、以及例外情况或法律保留(legal hold)如何处理达成一致。这两个框架都没有为本实验设定统一的 365 天保留期要求。
搜索与保全需要互补的控制措施。例如,CloudTrail 完整性校验使用必须实际验证的签名摘要文件。在需要一次写入多次读取(write-once)保留的场景下,应使用适当的控制措施(如 S3 Object Lock)设计源归档。索引化的 JSON 字符串不能替代该归档或其验证材料。
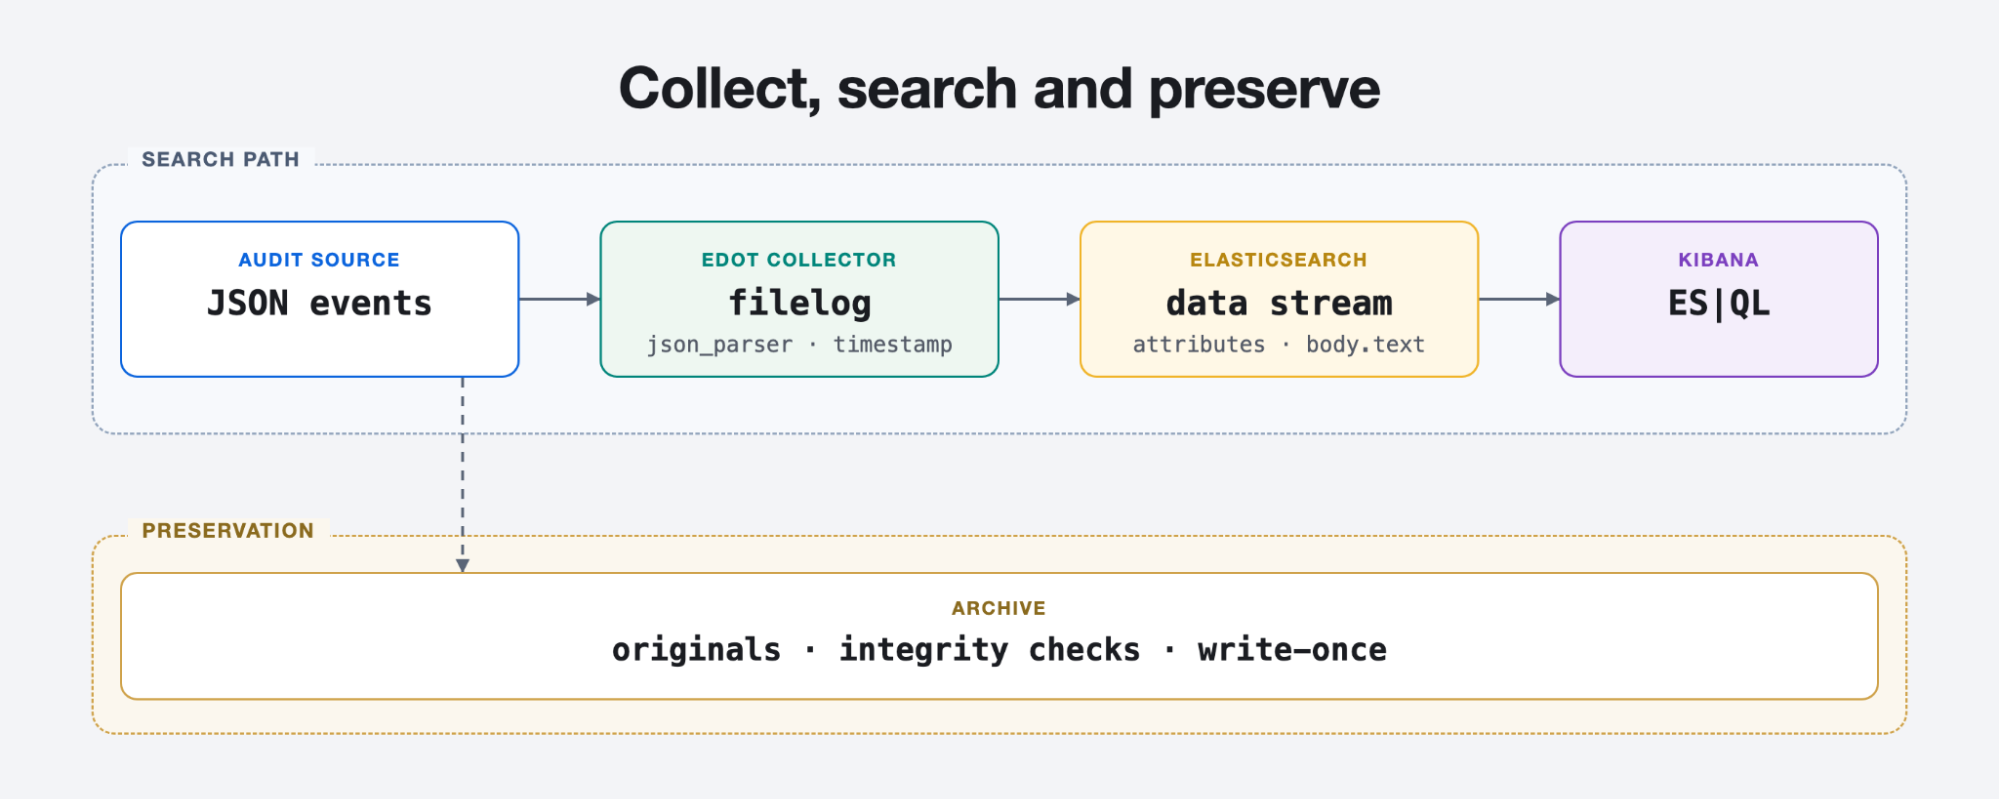
审计日志管道:JSON 事件到 EDOT Collector filelog、Elasticsearch 数据流、Kibana 中的 ES|QL
如何使用 EDOT Collector 收集审计日志
保留期的演示使用了六条虚构的应用程序审计 JSON 事件:其中四条属于用户 alex,两条属于另一用户 priya,这样操作者过滤器就有可排除的对象。EDOT Collector 以容器方式运行,并将数据发送到 Elastic Cloud Hosted(ECH)上的 Elasticsearch 和 Kibana 9.5.3。该配置基于 Elastic 官方文档中的文件日志收集与 JSON 解析流程:一个带 json_parser 运算符的 filelog receiver,以及一个设置 data_stream.dataset 和 data_stream.namespace 的资源处理器,加上以 otel 映射模式运行的 elasticsearch exporter。本文聚焦于决策与结果;完整配置和命令参见配套 notebook。
为什么 json_parser 使用 parse_to: attributes
Collector 解析来源时间戳和字段,然后将记录发送到专用的 logs-audit_demo.otel-lab 数据流。exporter 根据 dataset 和 namespace 构建该名称,并在 dataset 后附加 .otel。
与文档示例(使用 parse_to: body)不同,本实验的 json_parser 使用 parse_to: attributes,因此解析后的值会放在 attributes 下,而原始 JSON 字符串保留在 body.text 中。如果使用 parse_to: body,字段会进入 body.structured,原始字符串则会丢失。在本测试中,所有六条存储字符串均与 fixture 行精确匹配。基于 Elastic Common Schema(ECS)的集成可以使用根字段(如 user.name),因此在复用查询前请检查 schema。
用一条 ES|QL 查询重建操作者的时间线
在 Kibana Discover 中,选择 ES|QL,即 Elastic 的管道式查询语言。时间选择器使用 dateFormat:tz 高级设置指定的时区(默认为浏览器时区),因此请在Stack Management > Advanced Settings 中将其设为 UTC,然后再输入绝对时间窗口 2026-09-07T04:59:00Z 至 2026-09-07T05:06:00Z。然后运行以下查询:
FROM logs-audit_demo.otel-lab| WHERE attributes.user.name == "alex"| SORT @timestamp| KEEP @timestamp, attributes.event.action, attributes.event.outcome, attributes.audit.target, attributes.source.address| LIMIT 100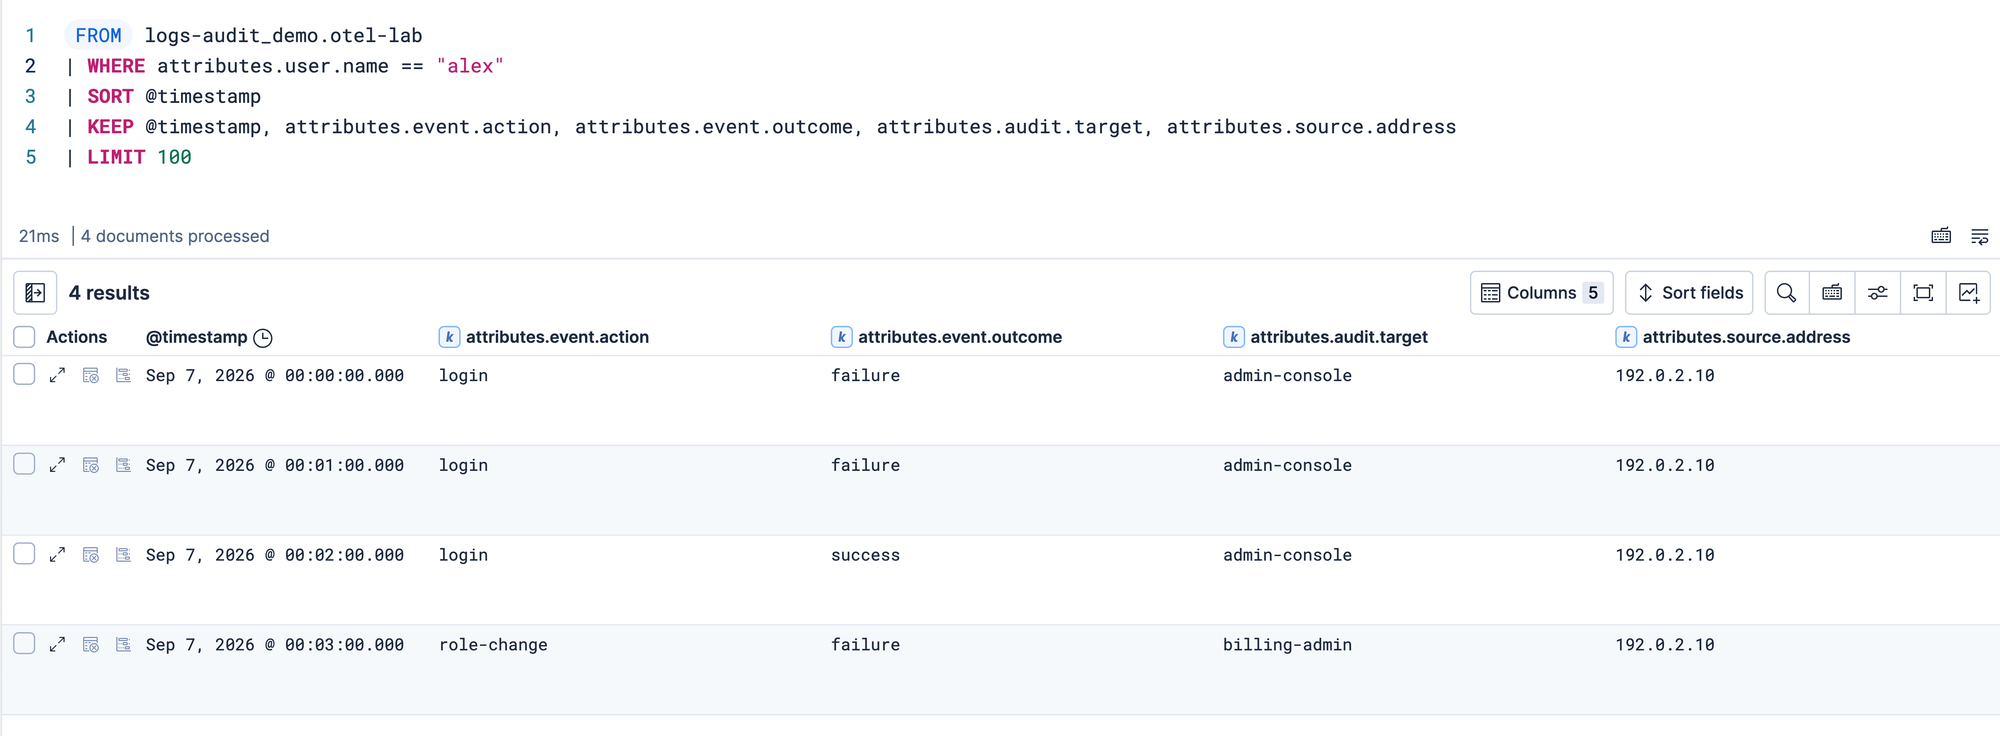
ES|QL 查询从 logs-audit_demo.otel-lab 数据流中返回用户 alex 的四条审计日志事件
请注意,最后一条事件是一次失败的角色变更。到目前为止,我们只知道 alex 尝试变更角色但被拒绝,这与权限被更改或账户被入侵并不相同。要了解实际情况,下一步是在同一租户和时间窗口内查看身份提供商和资源活动。
在对比截图与查询时,请记住 fixture 使用 UTC 时间,而 Kibana 以浏览器的时区(本例中为 UTC−05:00)显示时间戳。这就是为什么行显示为 00:00,而时间窗口设置的是 UTC。
Discover 的时间选择器会约束此查询;API 客户端需要显式的 timestamp 过滤器,notebook 中已添加。在将证据交给审查者时,请记录:
- 查询语句。
- UTC 时间窗口。
- 数据来源。
- 检索时间。
- 结果限制。
LIMIT 100 是受限的调查视图,而非穷尽式导出。
确认每条审计事件均已到达
在正常的 Collector 重启前后,数据流均持有六条记录、六个不同的事件 ID,这是因为 filelog receiver 保留了文件偏移量,而 exporter 在 file_storage 扩展中保留了发送队列。在生产规模下,还需要监控来源覆盖率、解析失败、队列饱和和投递延迟。这六条事件的检查属于功能测试,而非摄取基准测试或精确一次(exactly once)投递保证。
设置可验证的日志保留策略
保留设置应该是可以验证的。在 ECH 上,内置的 logs-*-* 模板会将新的数据流交给 logs 索引生命周期管理(ILM)策略,因此本实验为其数据流创建了专用的索引模板,配置如下:
- 优先级为 500,高于同样匹配该数据流名称的内置 logs 模板,因此 Elasticsearch 会应用此模板而非内置模板。
- 复制内置
logs-otel@template的组件列表。 - 限定为
logs-audit_demo.otel-*。 - 将
index.lifecycle.prefer_ilm设置为 false。 - 定义 365 天的数据流生命周期。
随后,数据流 API 报告后备索引(backing index)由数据流生命周期管理,生命周期回读报告了 effective_retention: 365d:
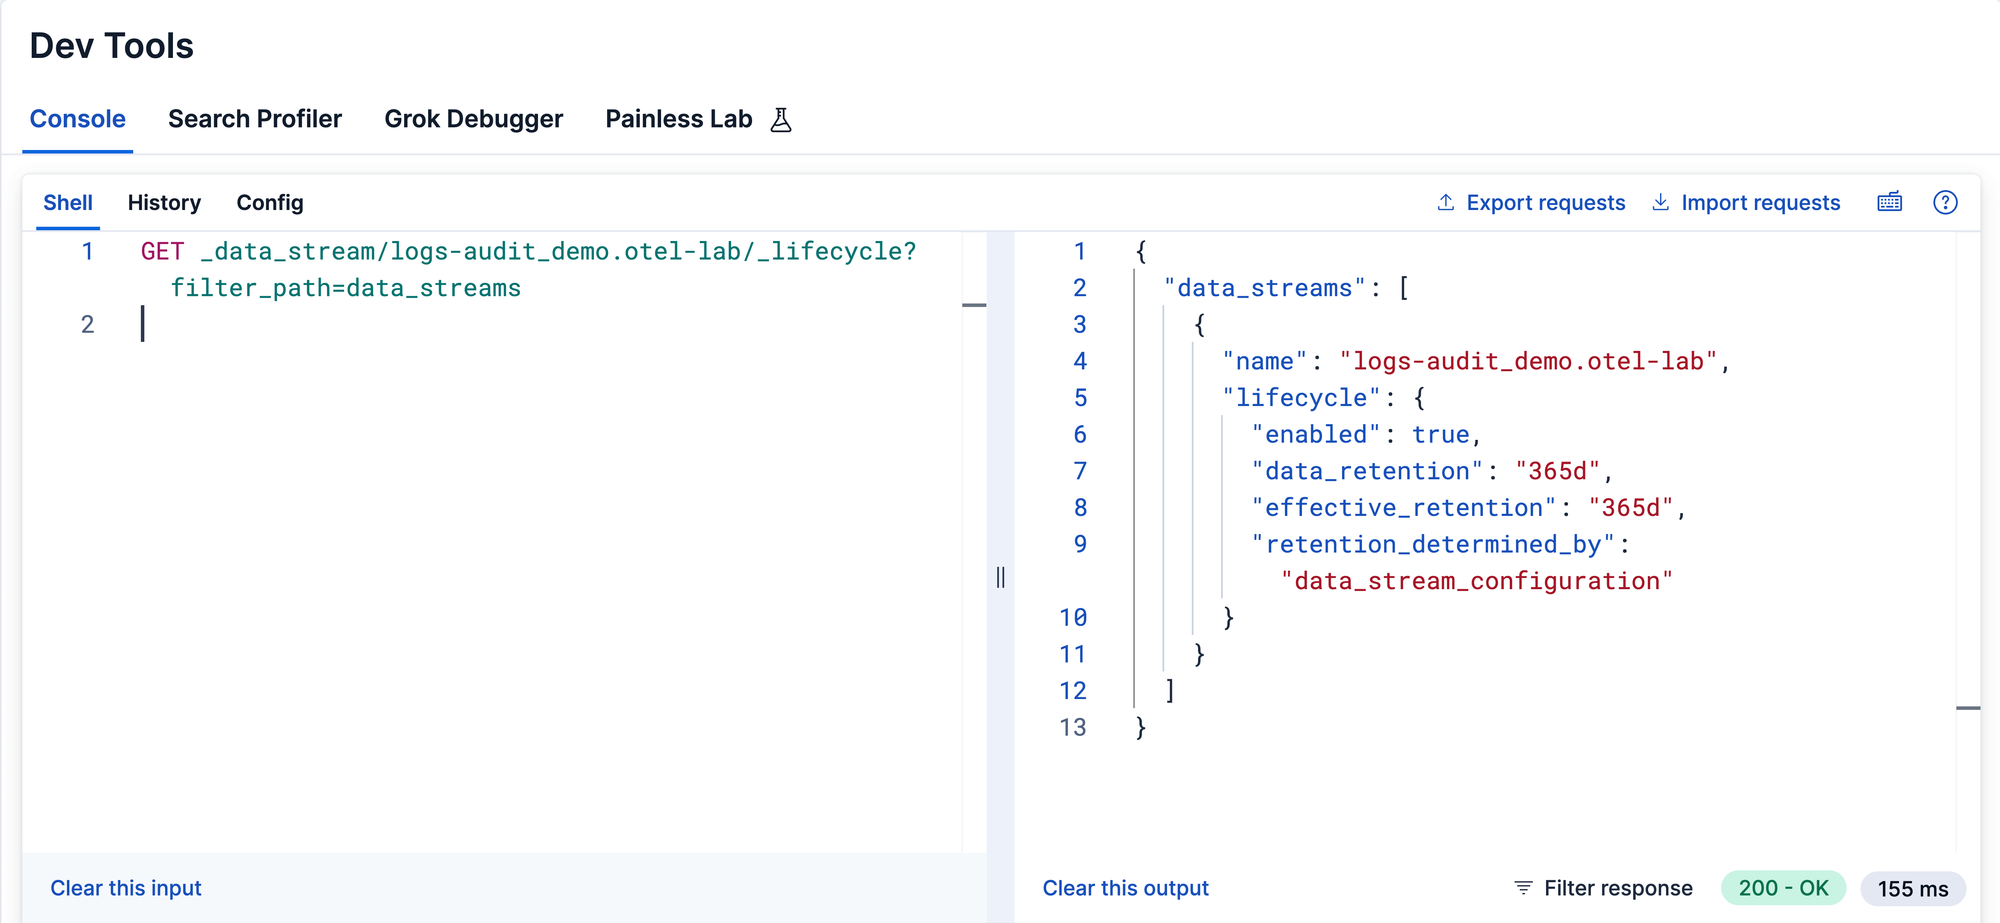
Kibana Dev Tools 生命周期 API 响应,显示审计日志数据流的 365 天数据保留
为什么你的审计数据流会忽略你设置的保留策略
数据流生命周期保留是基于后备索引生命周期时序的最小保留机制,而非精确到每条事件的删除期限。成功的回读证明的是配置正确,而非一年内的可用性。请演练检索最旧的必需记录,并定期审查来源覆盖率。关于保留接口与 ILM 的对比,请参阅使用 Streams 简化保留管理。
长期日志保留的容量规划
长期保留也会改变容量规划。每日摄取量乘以保留天数可以得到初始原始容量;映射(mappings)、压缩、副本、查询并发和层级放置都会影响实际所需资源。请基于代表性数据年龄的实际调查场景进行规模估算和测试。
使用可搜索快照查询更早的审计日志
可搜索快照使快照支持的索引保持可查询状态(经由 Elasticsearch)。完全挂载(fully mounted)的索引可以在冷层(cold tier)服务较旧数据;部分挂载(partially mounted)的索引在冻结层(frozen tier)使用共享的本地缓存。这为近期和较早的证据提供了统一的查询界面,存储与检索之间的权衡需要针对你的工作负载进行测试:
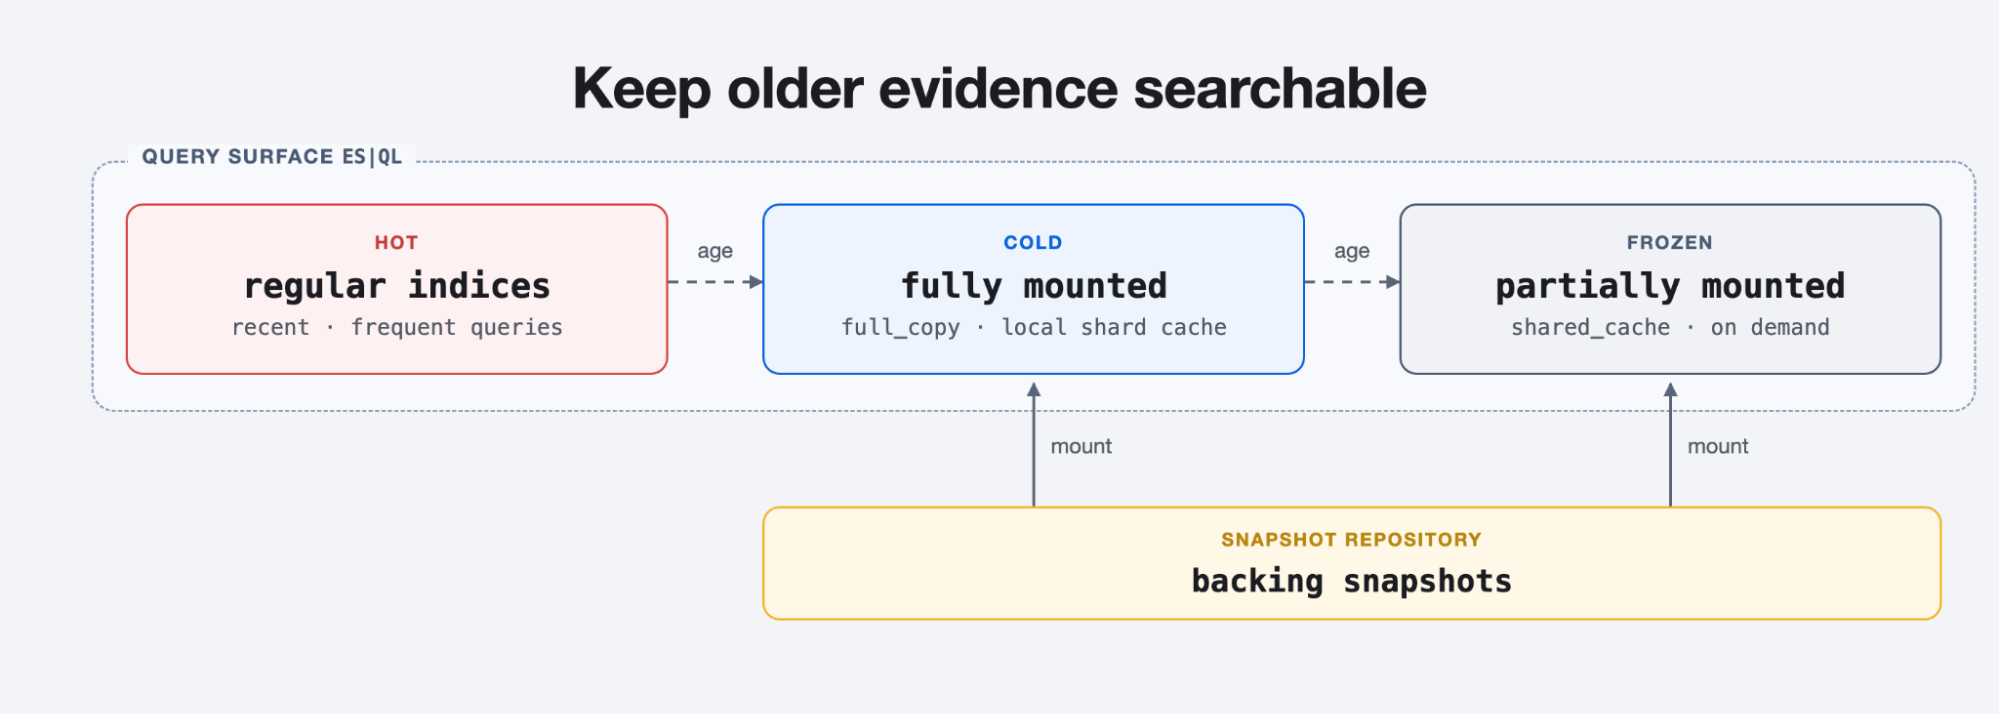
可搜索快照示意图:热、冷、冻结三层让更早的审计日志保持可通过 ES|QL 查询
该审计实验对其六条事件的后备索引拍摄了快照并进行了挂载,然后重新运行了相同的操作者查询:
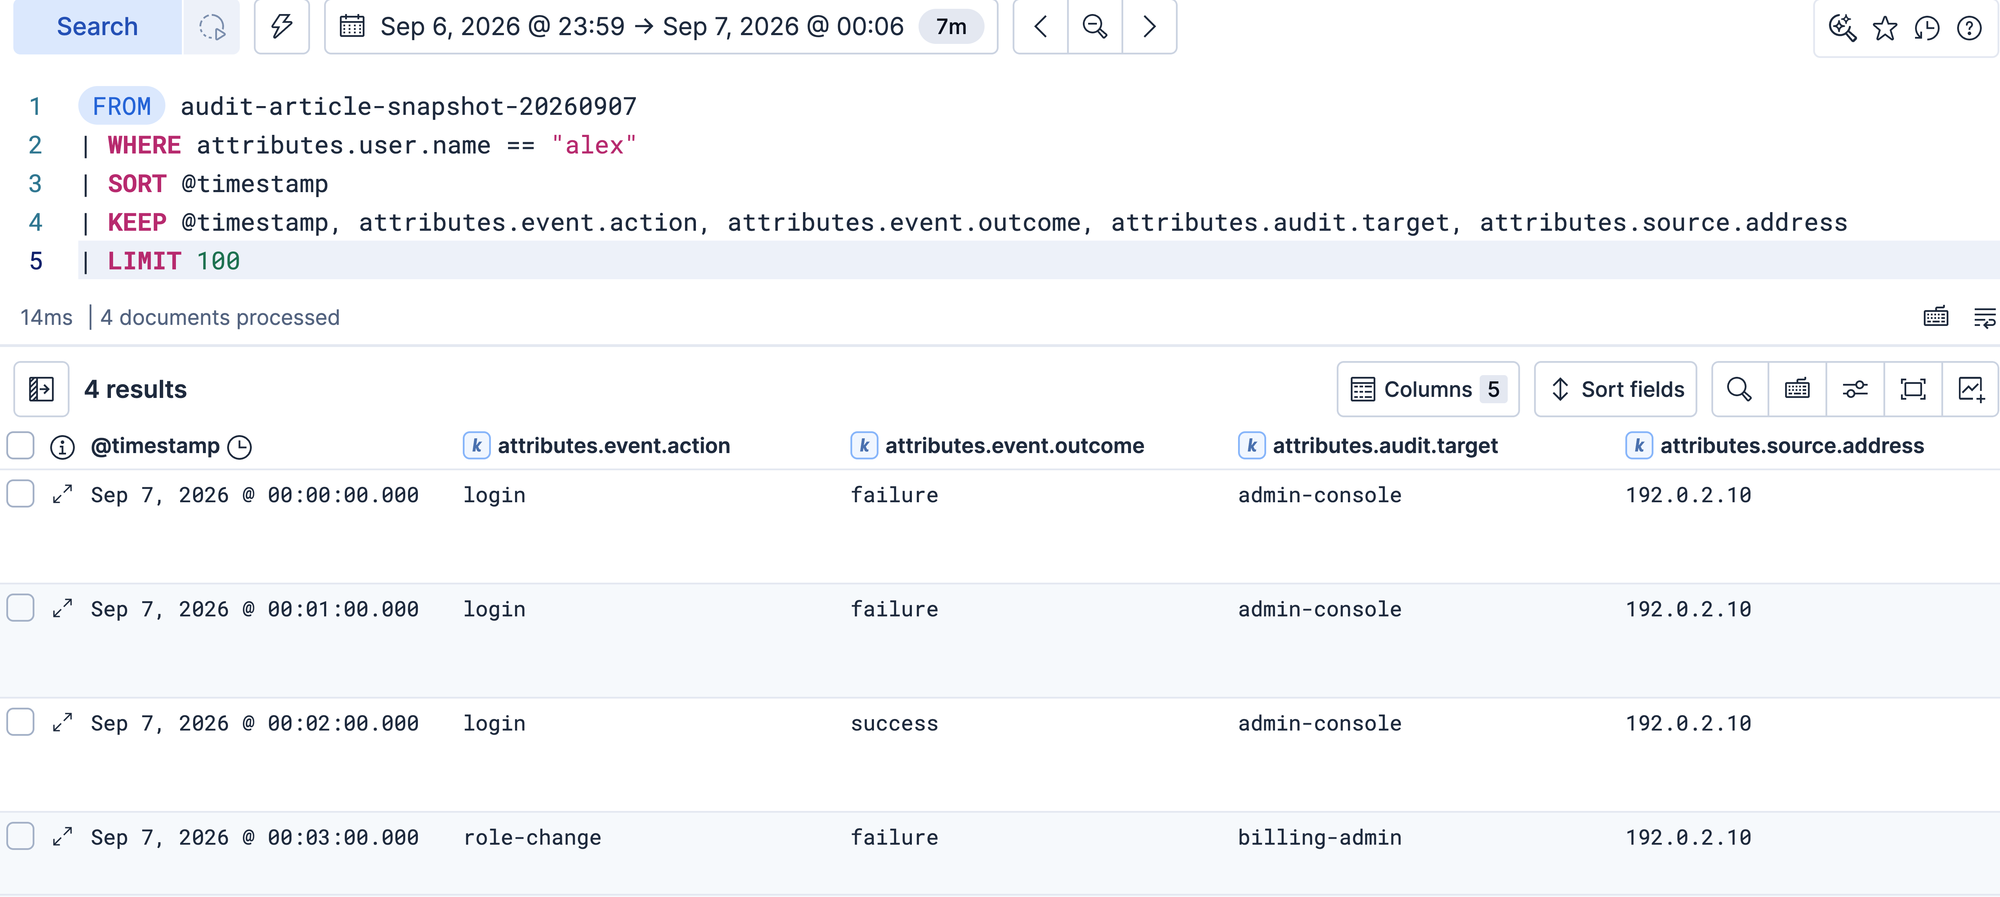
同一条 ES|QL 审计日志查询在挂载的可搜索快照上重新运行,返回相同的四条事件
返回了相同的四条事件。这使用了 Enterprise 许可证下可用热节点上的 full_copy 模式;它并未对冷/冻结层的成本或延迟进行基准测试。当挂载的索引使用后备快照时,该快照必须保持可用,而本地缓存并非备份。单独的实验挂载也需要自己的保留与清理计划。
谁能读取和更改你的审计日志
使用基于角色的访问控制为调查人员授予所需审计数据的 read 和 view_index_metadata 权限,以及预期 Kibana 空间中的 Discover 读取权限。将保留管理和快照管理职责分配到独立的角色中。角色是叠加式的,因此只读角色并不会移除其他地方授予的权限。
Collector 的 API 密钥仅在其数据流上携带 create_doc 和 auto_configure 权限,并且has privileges API确认它在那里没有 index、write、delete 或 manage 权限。这限制了 Collector 的权限范围;但并不会使记录对管理员不可变。此外,请为证据平台本身规划 Elasticsearch 和 Kibana 审计日志,具体取决于部署和订阅要求。
将 Kubernetes 审计日志与容器运行时数据关联
作为 Security Labs 的交叉内容,将 Kubernetes 审计日志与容器运行时数据关联展示了 API 活动如何与工作负载内部运行的内容建立联系。稳定的身份和资源上下文使这种关联成为可能。我们的小型应用 fixture 演示了时间线重建;它并未验证那些 Kubernetes 检测规则。
如何开始审计日志管理
从一个审计来源和一个数月后你必须回答的问题开始。验证投递,保留所需的原始数据,在近期数据和保留数据上演练搜索,并定期审查谁可以更改证据路径。Elastic 将收集、结构化调查、可搜索保留和范围化访问控制整合在一起;而你的策略则定义了这些能力必须保全的证据。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号