刚说好别动这个文件,Agent 怎么又改了?聊聊上下文压缩
原创
刚说好别动这个文件,Agent 怎么又改了?聊聊上下文压缩
原创
leikooo
发布于 2026-11-14 19:30:12
发布于 2026-11-14 19:30:12
用 Agent 跑长任务,迟早会碰到这一幕:屏幕上跳出一行 Compacting conversation…,等它转完,Agent 继续干活,但好像忘了点什么,刚才说好的「别动这个文件」,过一会它又去改了😅。
这一步叫 compaction(上下文压缩)。看起来就是「把聊天记录总结一下」,但各家 harness 在这件事上花的心思差别挺大:有的在本地让模型写一份交接文档,有的直接交给服务端返回一段加密数据,有的做了五层级联,有的把原始记录一条不删地留着让你随时回去翻。
这篇文章把最近几个比较有代表性的实现拆开看看:Codex、Claude Code、Hermes Agent、pi。不过在看它们之前,得先搞清楚一件事:为什么非压不可呢?
大模型做的事情说起来很简单:给它一串 token,它预测下一个 token,然后把预测出来的拼回去,再预测下一个……一直循环到结束。
关键在于:模型本身是无状态的。它不会「记得」上一轮聊了什么。你在聊天界面里感受到的「记忆」,其实是客户端每一轮都把完整的对话历史重新发给模型,系统提示词、你说过的每句话、它回过的每句话,全部再喂一遍。
所以对话越长,每次请求就越大。
模型无状态,每轮重发完整历史
模型一次能「看」的 token 数量有上限,这就是上下文窗口(context window),现在常见的是 200K,大一些的能到 1M。
可以把它想成一张办公桌:桌面就这么大,资料越堆越多,最后总有放不下的时候。而且就算还没堆满,资料一多也会出问题:
- 贵:Transformer 的注意力机制要让每个 token 和前面的 token 都打个照面,上下文越长,计算量和费用越高,响应也越慢。
- 容易看漏:研究和实践都发现,上下文很长时,模型对中间部分的信息不太敏感,这种现象常被叫做 context rot。桌上东西太多,真正重要的那张纸反而找不到了。
Agent 场景更费桌子。普通聊天,几十轮下来也就几万 token。Agent 就不一样了:读一个文件几千 token,跑一次测试输出几千 token,搜一次代码又是一大段。这些 tool result才是真正的大头,一个稍微复杂的任务,几十次工具调用就能把 200K 塞满。
Agent 上下文的构成示意
还有一个隐形约束:prompt cache。既然每轮都要把历史重新发一遍,那前面没变的部分能不能别重复计算?可以,只要请求的前缀和上次一模一样,服务端就能复用之前算好的结果,又快又便宜。
但缓存有个脾气:前缀里改了一个字,后面全部失效。而压缩恰恰就是在改历史——这意味着每次压缩,都要付出一次缓存重建的代价。后面你会看到,好几家的设计都在围着这个约束打转。
Prompt cache 与压缩
说穿了,压缩就是一次有损的工作交接:上一个「自己」快装不下了,得写一份交接文档给下一个「自己」,然后把桌子清空。
每家 harness 都要回答这几个问题:
- 什么时候压? 到多少比例触发,在哪个时间点检查
- 留什么、丢什么? 用户原话、最近几轮、工具输出分别怎么处理
- 交接文档谁来写、写成什么样?
- 原件放哪? 压完之后还能不能找回原始记录
带着这几个问题,我们一家一家看。
Codex
Codex CLI 是开源的,压缩逻辑主要在 codex-rs/core/src/compact.rs 和 compact_remote_v2.rs 里。
压缩分成两条路径:
- 本地压缩:在当前历史后面追加一条压缩指令,让模型生成一份摘要。
- 远程压缩:使用 OpenAI 自家模型时,交给 Responses API 在服务端完成,返回的是一个
type=compaction的条目,里面只有一段encrypted_content,加密的、客户端看不懂的数据。
本地压缩用的 prompt 写得很直白,开头就是:
You are performing a CONTEXT CHECKPOINT COMPACTION. Create a handoff summary for another LLM that will resume the task.
要求摘要包含:当前进展和关键决策、重要上下文、约束和用户偏好、下一步计划,以及继续工作需要的关键数据。生成的摘要放回历史时,前面还会加一段「前情提要」:
Another language model started to solve this problem and produced a summary of its thinking process. You also have access to the state of the tools that were used by that language model. Use this to build on the work that has already been done and avoid duplicating work.
注意它的措辞:不是「你之前做了什么」,而是「另一个模型做到了这里,你接着干」。Codex 把压缩明确定义成了一次交接。
Codex 压缩前后的历史
压缩之后的历史大致由三部分组成:
- 用户的原话:从新到旧逐条保留,直到用完预算。本地路径的预算是
COMPACT_USER_MESSAGE_MAX_TOKENS = 20_000,远程 v2 是RETAINED_MESSAGE_TOKEN_BUDGET = 64_000。超出预算的消息会被截断,图片之类的媒体直接丢掉。 - 重新注入的初始上下文:AGENTS.md、环境信息等不是从旧历史里继承,而是重新生成一份插回去。
- 摘要:放在最后。
助手的回复、工具调用和工具结果,统统折叠进摘要里,不单独保留。
这个设计背后的判断很清楚:用户说过的话是需求本身,不能让模型转述;而模型自己干活的过程,总结一下就够了。
自动压缩的阈值由 model_auto_compact_token_limit 控制,社区反馈从 v0.100.0 开始,这个值不能超过上下文窗口的 90%。源码里还区分了几个阶段:一轮开始前压(PreTurn)、一轮结束后压(PostTurn),以及用户手动执行 /compact。
远程压缩返回的是加密数据,那里面到底装了什么?社区有两个挺有意思的研究:
- Kangwook Lee 用 prompt injection 的方式「骗」出了加密内容,发现服务端压缩内部用的仍然是一份 LLM 写的 handoff 摘要,prompt 和开源版本几乎一致。
- 有人分析了 1087 次真实压缩记录,发现 blob 每次是重写而不是追加——上一次的 blob 作为输入,输出一份新的,大小基本稳定在一个范围内,并不会随着压缩次数越来越大。
至于为什么要加密,官方没有详细解释,社区推测包括防篡改、方便服务端随时调整压缩算法等。这部分属于第三方实测和推断,看个思路就好。
Claude Code
Claude Code 的压缩,官方文档讲得比较克制,能确认的有这些:
- 快到上限时自动压缩,先清理旧的工具输出,空间还不够再对对话做摘要。
- 摘要会保留你的请求和关键代码片段,但对话早期的细节指令可能丢失,所以官方建议把长期规则写进 CLAUDE.md,而不是指望对话历史。
- 可以手动
/compact focus on the API changes指定摘要重点,也可以在 CLAUDE.md 里加一个 "Compact Instructions" 小节。 - 如果某个巨大的文件或工具输出让上下文压完马上又满,Claude Code 会在几次尝试后停止自动压缩并报错,而不是无限循环。
- 子 agent 有独立的上下文窗口,它们的工具调用不会进入主对话,只有最终结果返回。
更细的实现,官方没有展开。下面这部分来自社区对 Claude Code 实现的拆解分析,并非官方文档,具体数值可能随版本变化。
按社区的分析,Claude Code 的压缩不是一次性的,而是从便宜到昂贵逐层尝试:
Claude Code 的分层压缩
第一个是 cached microcompact。前面说了,改历史会打断 prompt cache,那清理工具结果岂不是很亏?Claude Code 的做法是让服务端在缓存里把旧结果「抠掉」,本地消息不变,缓存前缀也还在。而时间触发的那一层更直接:一个小时没动静,缓存本来就过期了,这时候改历史不用心疼。
第二个是 session memory。与其等到快满了再让模型一口气总结几十万 token,不如在平时就有个后台 agent 持续记笔记,包括当前状态、任务说明、涉及的文件、踩过的坑、关键结果等等。真到要压缩的时候,笔记已经现成了。
走到最后一层 full compact 时,Claude Code 会 fork 一个 agent,继承原来的系统提示词和完整历史(这样大部分输入还能命中缓存),再追加一条压缩指令。模型先在 <analysis> 里打草稿,再输出 <summary>,包含 9 个部分:
1. Primary Request and Intent 2. Key Technical Concepts 3. Files and Code Sections 4. Errors and Fixes 5. Problem Solving 6. All User Messages 7. Pending Tasks 8. Current Work 9. Optional Next Step
其中第 6 项是「所有用户消息」,和 Codex 保留用户原话的思路一致,只是这里是让模型在摘要里列出来。草稿部分会在提取后被丢掉,只留下 summary。
摘要写完还没结束,Claude Code 还会做一轮「恢复」:
- 重新读入最近访问的最多 5 个文件,每个最多 5K token,总共不超过 50K
- 重新注入正在使用的 skills、plan 文件
- 摘要里附上完整对话记录的文件路径,需要时可以回去查原文
另外还有一个熔断:连续失败 3 次就停止自动压缩。据分析,这个机制是因为之前出现过大量会话反复压缩失败、白白浪费 API 调用的情况。
Hermes Agent
Hermes Agent 是 Nous Research 做的开源 Agent,它的开发者文档里专门有一篇讲压缩和缓存,写得非常细。
触发上,Hermes 有两道防线:
- Agent 内部的压缩器:默认在 prompt 达到上下文窗口的 50% 时触发;窗口小于 512K 的模型,比例会被抬到至少 75%。
- 网关层的兜底:每条消息进来之前检查,达到 85% 就压。
还可以用 threshold_tokens 设置绝对值,或者用 model_thresholds 给不同模型单独配置。
压缩结构很直观:掐头、留尾、压中间。
Hermes 的头尾保护与中间摘要
- 头部固定保留前 3 条,也就是系统提示词和第一轮对话。
- 尾部从后往前按 token 预算保留。默认的
lean模式下,预算是窗口的 2.5%,夹在 10K 到 25K 之间,并且至少保留一条真实的用户消息。 - 切割点会自动调整,保证 tool_call 和对应的 tool_result 不会被拆开。
中间这段的处理分两个阶段,先免费清理,再花钱总结。
第一阶段不调用 LLM:尾部以外、超过 200 字符的工具结果,直接替换成 [Old tool output cleared to save context space]。如果被清掉的是 skill 内容,还会留下标记,提醒模型需要时重新加载。
第二阶段才把中间部分交给一个辅助模型做摘要,模板是结构化的:
Goal / Constraints & Preferences / Progress (Done, In Progress, Blocked) Key Decisions / Relevant Files / Next Steps / Critical Context
lean 模式下还会额外做几件事:逐字引用每条真实的用户消息;用正则从原文抽取 PR 编号、commit SHA、文件路径、错误信息这类「锚点」,不经过模型转述,避免模型把 a3f9c2e 记成 a3f9c2f。
被压掉的原件不会删除。默认的 in-place 模式下,压缩后会话 ID 不变,被压掉的消息标记为已归档,但仍然可以通过 session_search 搜出来。
后续再压缩时,Hermes 会把上一次的摘要传给模型,要求更新而不是重写:已完成的从 In Progress 挪到 Done,新进展补上,过时的信息删掉。
另外,压缩器本身是一个可替换的 ContextEngine 接口,比如社区插件 hermes-vcc 就完全不调用 LLM,用正则提取的方式生成摘要。
Hermes 在稳定性上下了不少功夫,从它的安全机制能看出踩过哪些坑:
- 摘要失败后进入冷却,时间逐级递增:60 秒 → 300 秒 → 900 秒
- 多次卡住后跳过 LLM,直接生成一份确定性的兜底摘要
- 文档特别强调:辅助模型的上下文窗口必须不小于主模型,否则摘要请求会失败,中间那段对话就直接丢了。GitHub 上还有一个相关 issue:辅助模型窗口太小,导致每一轮都在触发压缩,陷入死循环。
pi
pi 是 Mario Zechner 做的开源 coding agent,以简洁著称。它的压缩文档开头就写得很坦白:压缩是有损的,但完整历史一直保存在 JSONL 文件里。
触发条件就一行公式:
contextTokens > contextWindow - reserveTokens
reserveTokens 默认 16384。检查时机也很讲究:在工具结果写回历史之后、模型开始下一次回答之前。如果模型提供方报了上下文溢出,pi 会压缩一次再重试。
切点的选法是从最新的消息往前数,累计到 keepRecentTokens(默认 20K)为止,这之后的消息原样保留,之前的交给模型摘要。
切点只能落在用户消息、助手消息等位置,不能落在 tool result 上,因为它必须和对应的工具调用待在一起。
还有一种边界情况:如果某一轮用户请求下,Agent 连续干了很久,单这一轮就超过了预算,那只能从这一轮的中间切开。pi 会分别生成两份摘要(之前完整轮次的历史摘要 + 这一轮前半段的摘要)再合并。
另一个小细节:pi 不会把原始的消息数组直接丢给模型总结,而是先序列化成纯文本:
[User]: 帮我把登录接口改成 JWT [Assistant]: 好的,我先看一下现有实现 [Assistant tool calls]: read src/auth/login.ts [Tool result]: ...
为什么这么做?因为如果直接把对话历史给模型,它很容易把这当成一段要「接着聊」的对话,而不是一份要总结的材料。另外工具结果超过 2000 字符会被截断,thinking 内容会被省略。
摘要格式也是结构化的:Goal、Constraints & Preferences、Progress、Key Decisions、Next Steps、Critical Context。此外 pi 会从工具调用中提取读过哪些文件、改过哪些文件,以 <read-files>、<modified-files> 的形式附在摘要后面,而且会跨多次压缩累积。
pi 的 CompactionEntry 与模型实际看到的上下文
这是 pi 最有特点的地方:压缩不会改写历史,只是往会话的 JSONL 里追加一条 `CompactionEntry`,记录摘要内容和「从哪条消息开始保留」。原始消息全部还在。
再加上 pi 的会话本身是树状结构,用 /tree 可以回到任意一个历史节点开新分支。切换分支时,pi 还会提议把你离开的那条分支总结一下,带到新分支里。
扩展性方面,session_before_compact 钩子可以拿到准备好的所有数据,然后取消压缩、或者直接返回一份你自己生成的摘要——整个压缩逻辑都可以替换掉。
放在一起看
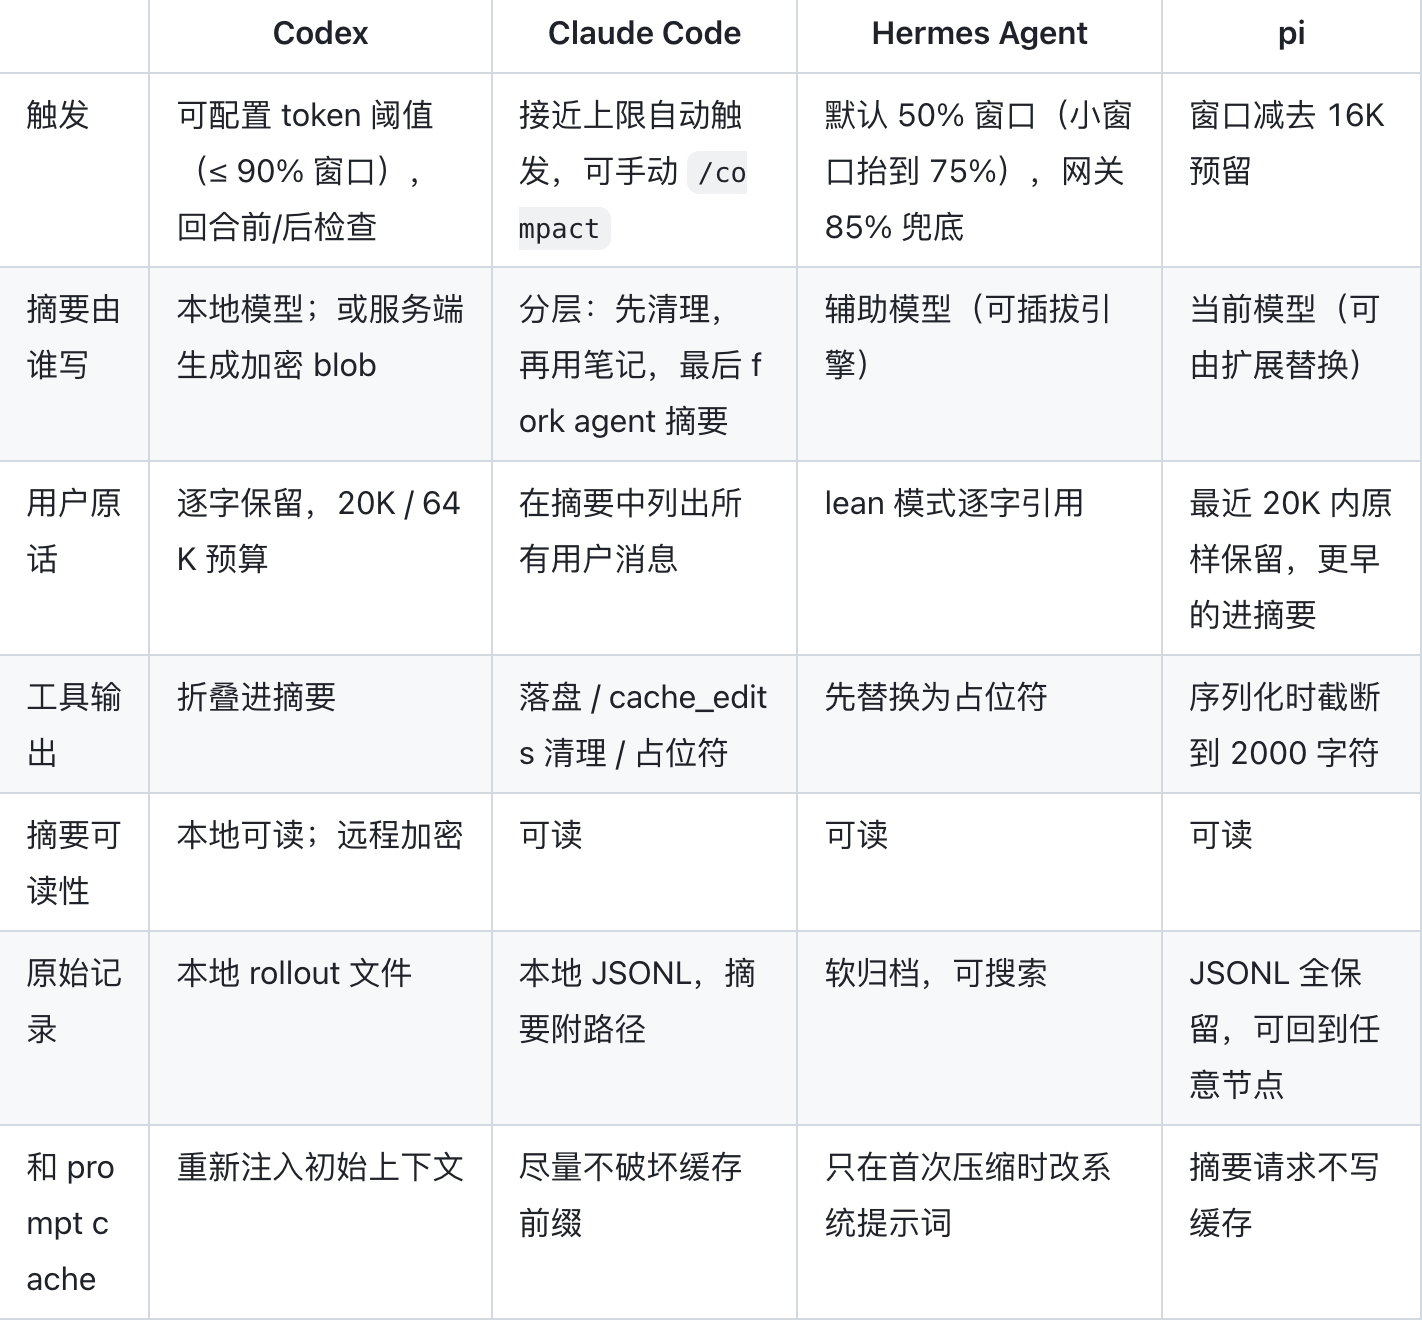
我自己是怎么做的
最近用 Claude Code 比较多,我是直接在 /config 里把 auto-compact 关掉了
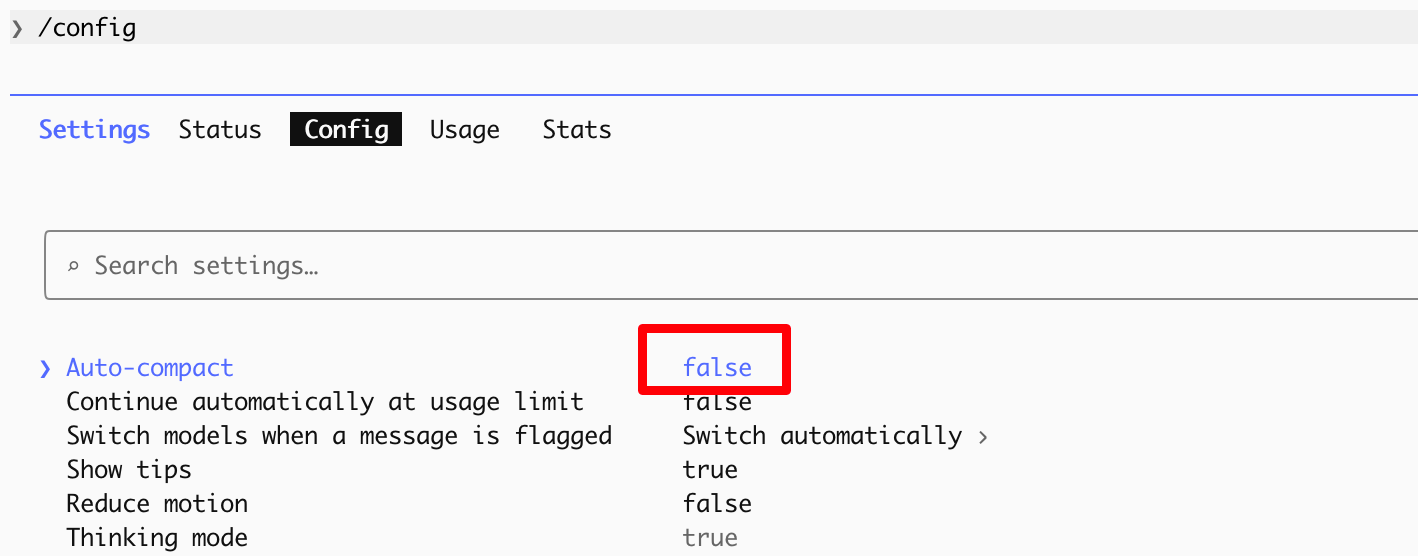
image-20261114185444770
压缩全部手动来。主要有两种做法:
- 用 [handoff skill](https://github.com/mattpocock/skills/blob/main/skills/productivity/handoff/SKILL.md) 写交接文档:让模型把当前进展总结成一个文件,然后开一个新会话,把文件交给它接着干。
- 手动 `/compact` 并指定重点:比如
/compact 重点保留接口改动和还没跑通的测试,告诉它这次什么最不能丢,一般上下文到极限了就只能有这种方式了,不能用 handoff 这个 skills 进行压缩。
这样做最大的好处是压缩是我主动的行为,我可以感知到。自动压缩往往在任务做到一半时触发,开头那种「刚说好别动的文件又被改了」的情况,很多就发生在这里。手动压缩可以挑一个子任务刚完成的时候,这时候需要交接的东西最少,也最清楚。
而且 handoff 是模型在还能看到完整上下文时写的,质量不会比自动压缩差。它最后是一个文件,我可以看到内容。
最后总结
四家放在一起看,其实都在回答开头那几个问题,只是给出了不同的答案。
相同的部分很明显:
- 都认为用户说过的话比模型自己干活的过程更重要,要么原样保留,要么要求在摘要里完整列出。
- 都在对付工具输出这个大头,而且大多选择在调用 LLM 摘要之前,先用不花钱的方式清掉一批。
- 摘要格式都趋向结构化:目标、约束、进展、决策、下一步。
- 都绕不开 prompt cache,压缩时机和方式或多或少都在考虑缓存的代价。
不同的部分,更多是取舍:
- 摘要放在哪里:Codex 的远程压缩把摘要交给服务端,客户端拿到的是不可读的加密数据;其他几家的摘要都是明文,用户可以看、可以改。
- 一步到位还是分层:Claude Code 和 Hermes 都是先便宜后昂贵地逐级尝试;Codex 和 pi 的主流程更直接。
- 原始记录怎么处理:pi 只追加不改写,Hermes 软归档可检索,Claude Code 在摘要里留下原文路径。
- 能不能换掉:Hermes 和 pi 把压缩逻辑做成了可替换的接口,用户可以接入自己的实现。
不管哪种方案,压缩终究是有损的。已经有研究专门在测压缩过程中「约束条件」的丢失率。所以各家文档几乎都在暗示同一件事:真正需要一直生效的规则,别放在对话里,放进 AGENTS.md、CLAUDE.md 这类每次都会重新加载的地方。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号