把大模型搬回工位:本地推理这笔账,到底怎么算
原创
把大模型搬回工位:本地推理这笔账,到底怎么算
原创
用户8690294
发布于 2026-11-14 23:15:11
发布于 2026-11-14 23:15:11
过去两年,企业用大模型的方式很统一:调 API。按 token 付费,用完即走,不用买卡、不用运维。这套模式在探索期几乎无懈可击。但当一个功能从“试一试”变成“每天都有人用”,账单和约束就会一起浮出水面。
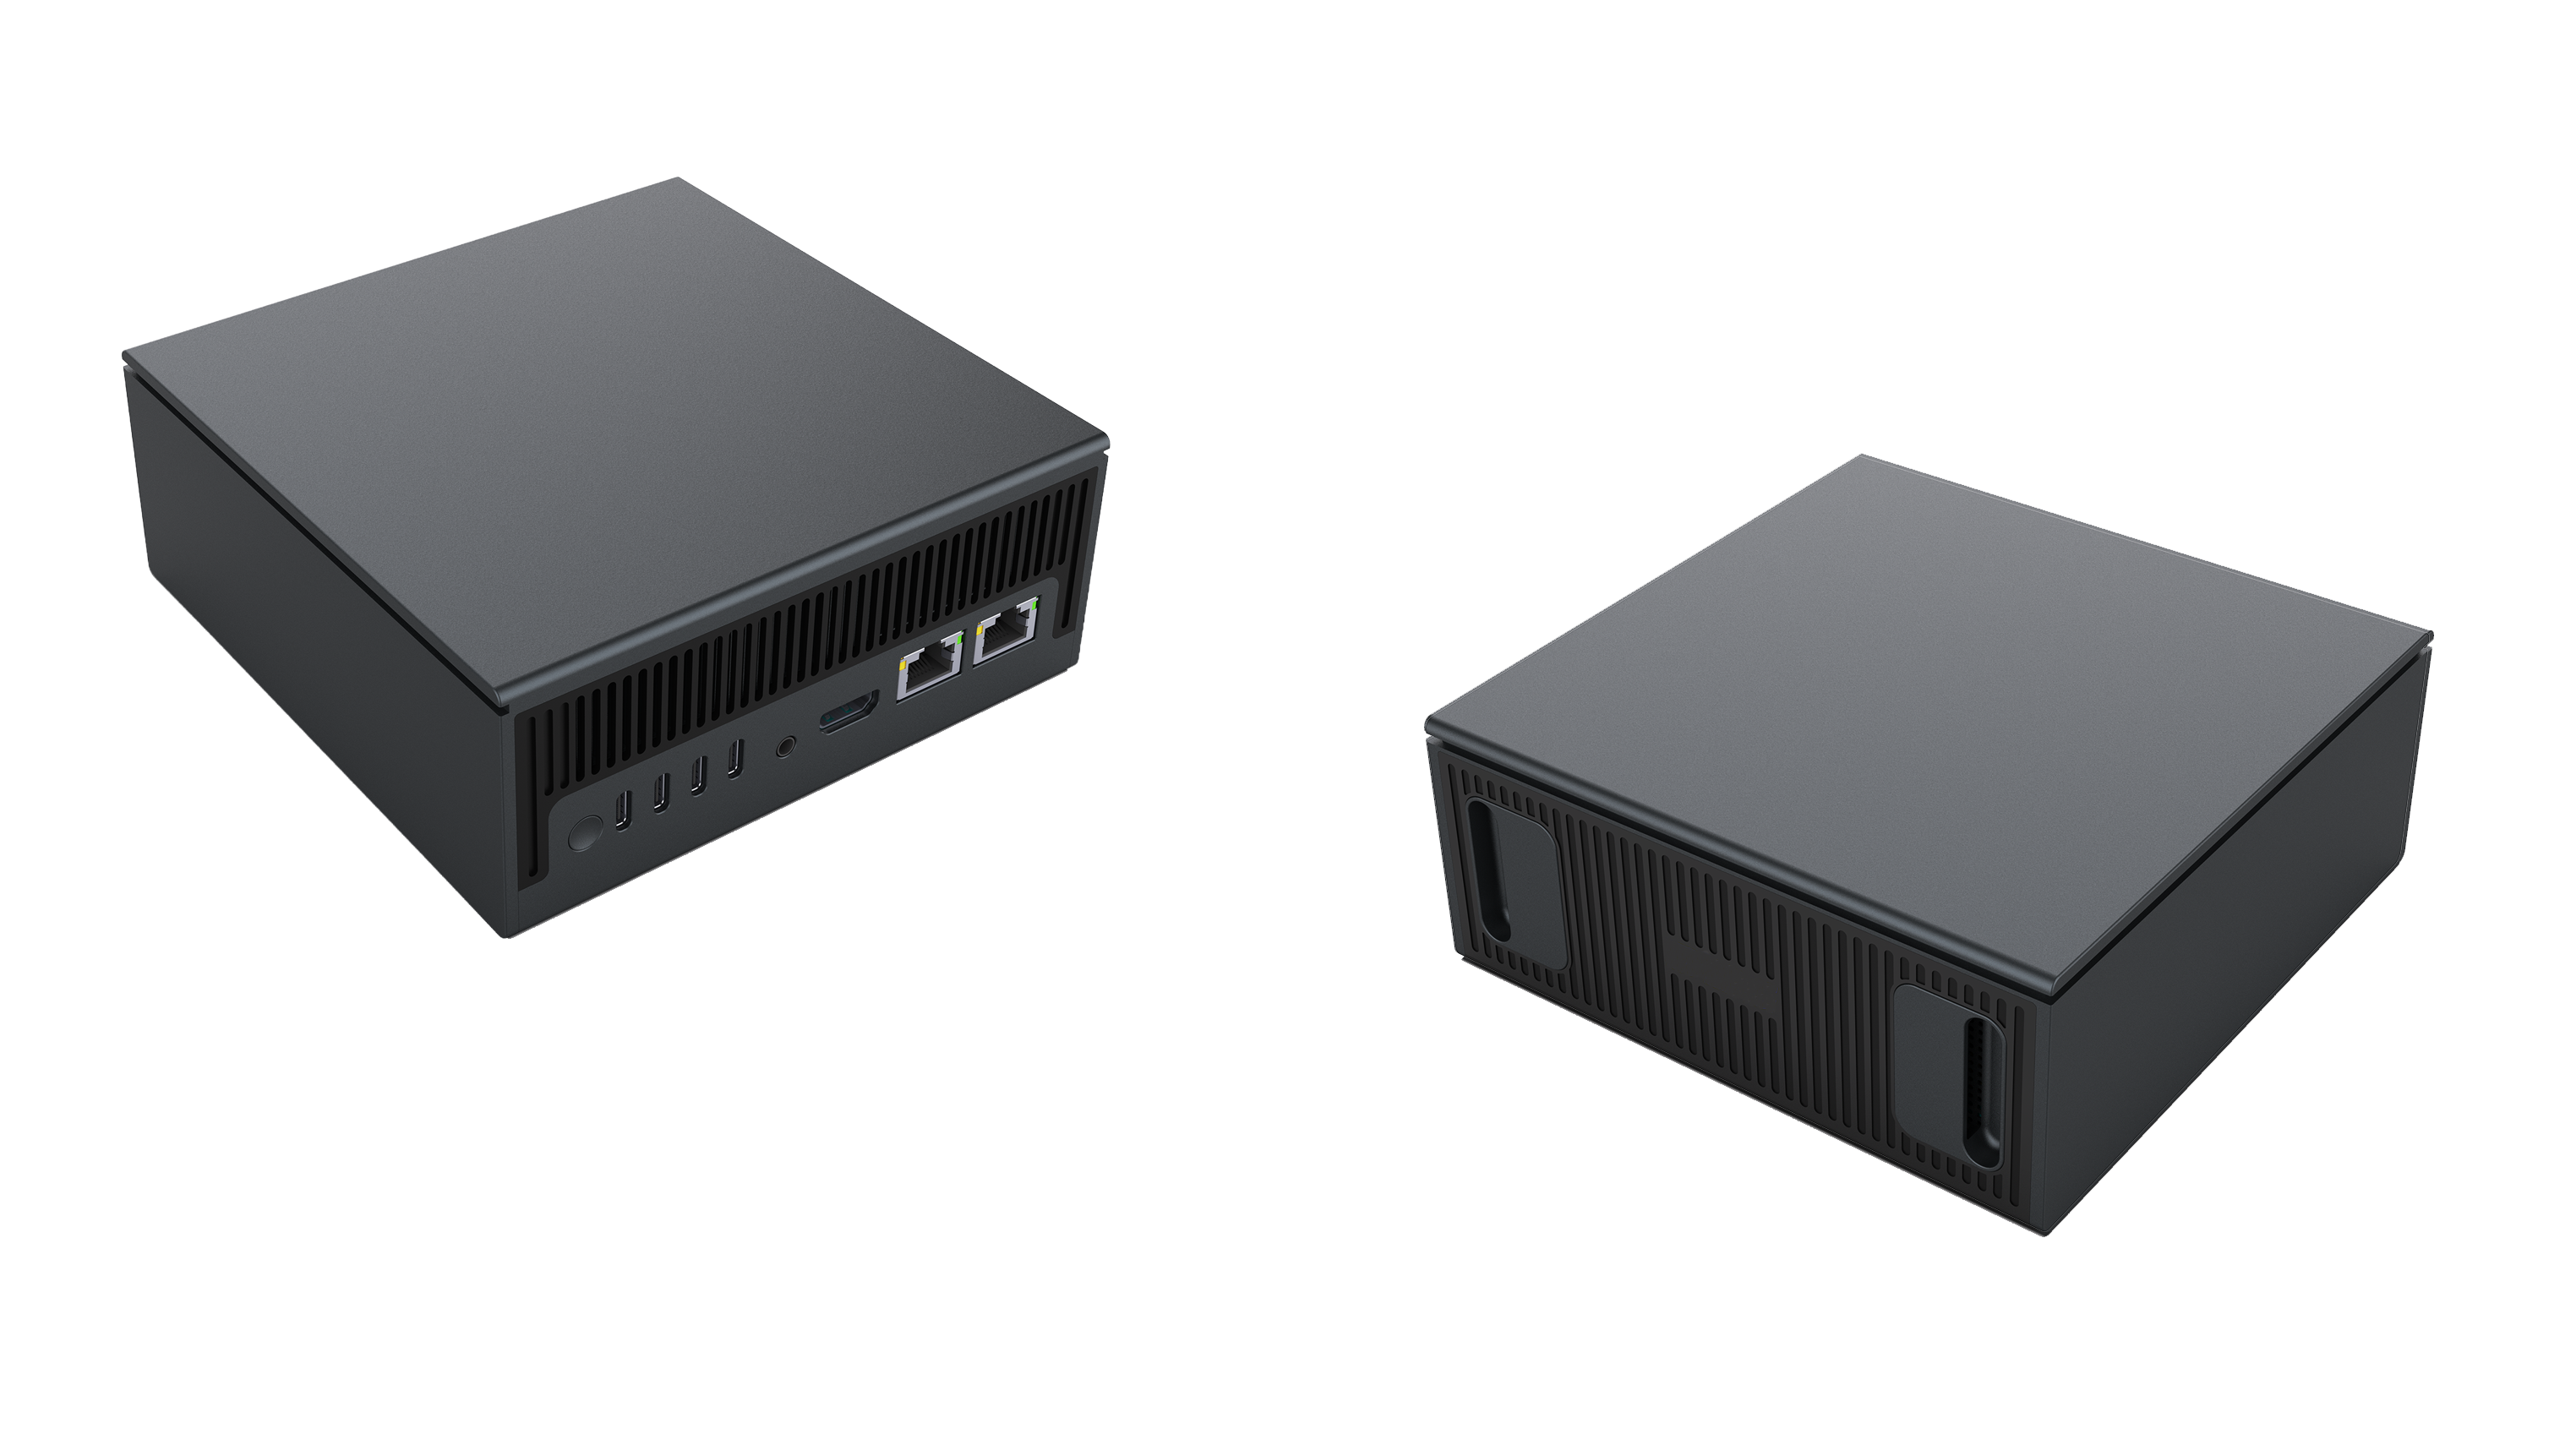
高频、敏感、离线的负载,正在从云上被摘下来
01 云端的三笔隐性成本
第一笔是钱,但往往不是最贵的。高频、短上下文的调用,单价看着低,乘以调用量之后并不便宜;真正让成本失控的,常常是“为了效果好多轮重试”带来的重复计费。
第二笔是数据出域。合同、病历、工艺图纸、客户名单——这些内容一旦离开内网,法务和合规就要介入。很多项目不是败在技术上,而是卡在“数据能不能出去”这一步。
第三笔是时延抖动。公网调用 P50 也许只有几百毫秒,但 P99 的长尾会直接体现在产品体验上:语音助手突然卡两秒,质检流水线的节拍就被打乱。
02 哪些任务适合搬回本地
不是所有推理都值得本地化。判断标准可以简化成四问:
· 调用频次高不高?一天几十次,云端更划算;一分钟几十次,本地开始有优势。
· 上下文长不长?长文档摘要、代码库级理解,本地显存吃不消,仍应上云。
· 数据敏不敏感?涉及个人隐私、商业机密的,本地是默认选项。
· 断网能不能用?产线、机房、野外设备,网络本身就是不确定项。
四个问题里如果有两个以上回答“是”,就值得算一算本地的账。
03 本地跑模型的三道门槛
很多人以为门槛是算力,其实是显存。参数量决定下限:一个 7B 模型做 INT4 量化,权重约占 4GB,加上 KV Cache 和框架开销,8GB 显存只是起步;13B 需要 16GB 左右;30B 级别则要 24GB 以上才谈得上顺畅。算力决定的是速度,显存决定的是“能不能跑”。
第二道门槛是内存带宽。大模型解码阶段是访存密集型,权重每一层都要从显存搬进计算单元,带宽不够,算力再高也喂不饱。这也是为什么同样标称“几百 TOPS”,不同架构跑同一个模型,token/s 能差出好几倍。
第三道门槛是量化与精度损失。INT8 基本无损,INT4 在多数对话任务上可用,再往下压,长上下文和数学推理会先崩。工程上通常分级处理:敏感任务走 FP16/INT8,日常问答走 INT4。
04 硬件形态在变:从机架到桌面
过去做本地推理意味着买一台带 GPU 的服务器:几千瓦功耗、机架空间、专用机房、空调。这对只有几十人的团队来说太重了。
这两年开始出现另一条路线:把推理能力做成桌面大小的设备,功耗控制在百瓦级,直接放在工位旁边,接普通市电,不用改造机房。为了实现这个形态,厂商通常要做三件事——用低功耗的 ARM 或嵌入式平台做系统调度,把算力做成可更换的模块以覆盖不同模型规模,重新设计散热(铝鳍片加涡轮风扇基本是标配)。
这类设备的定位不是替代数据中心,而是把“高频、敏感、离线”那部分负载从云上摘下来。它的价值不在峰值算力,而在部署位置。
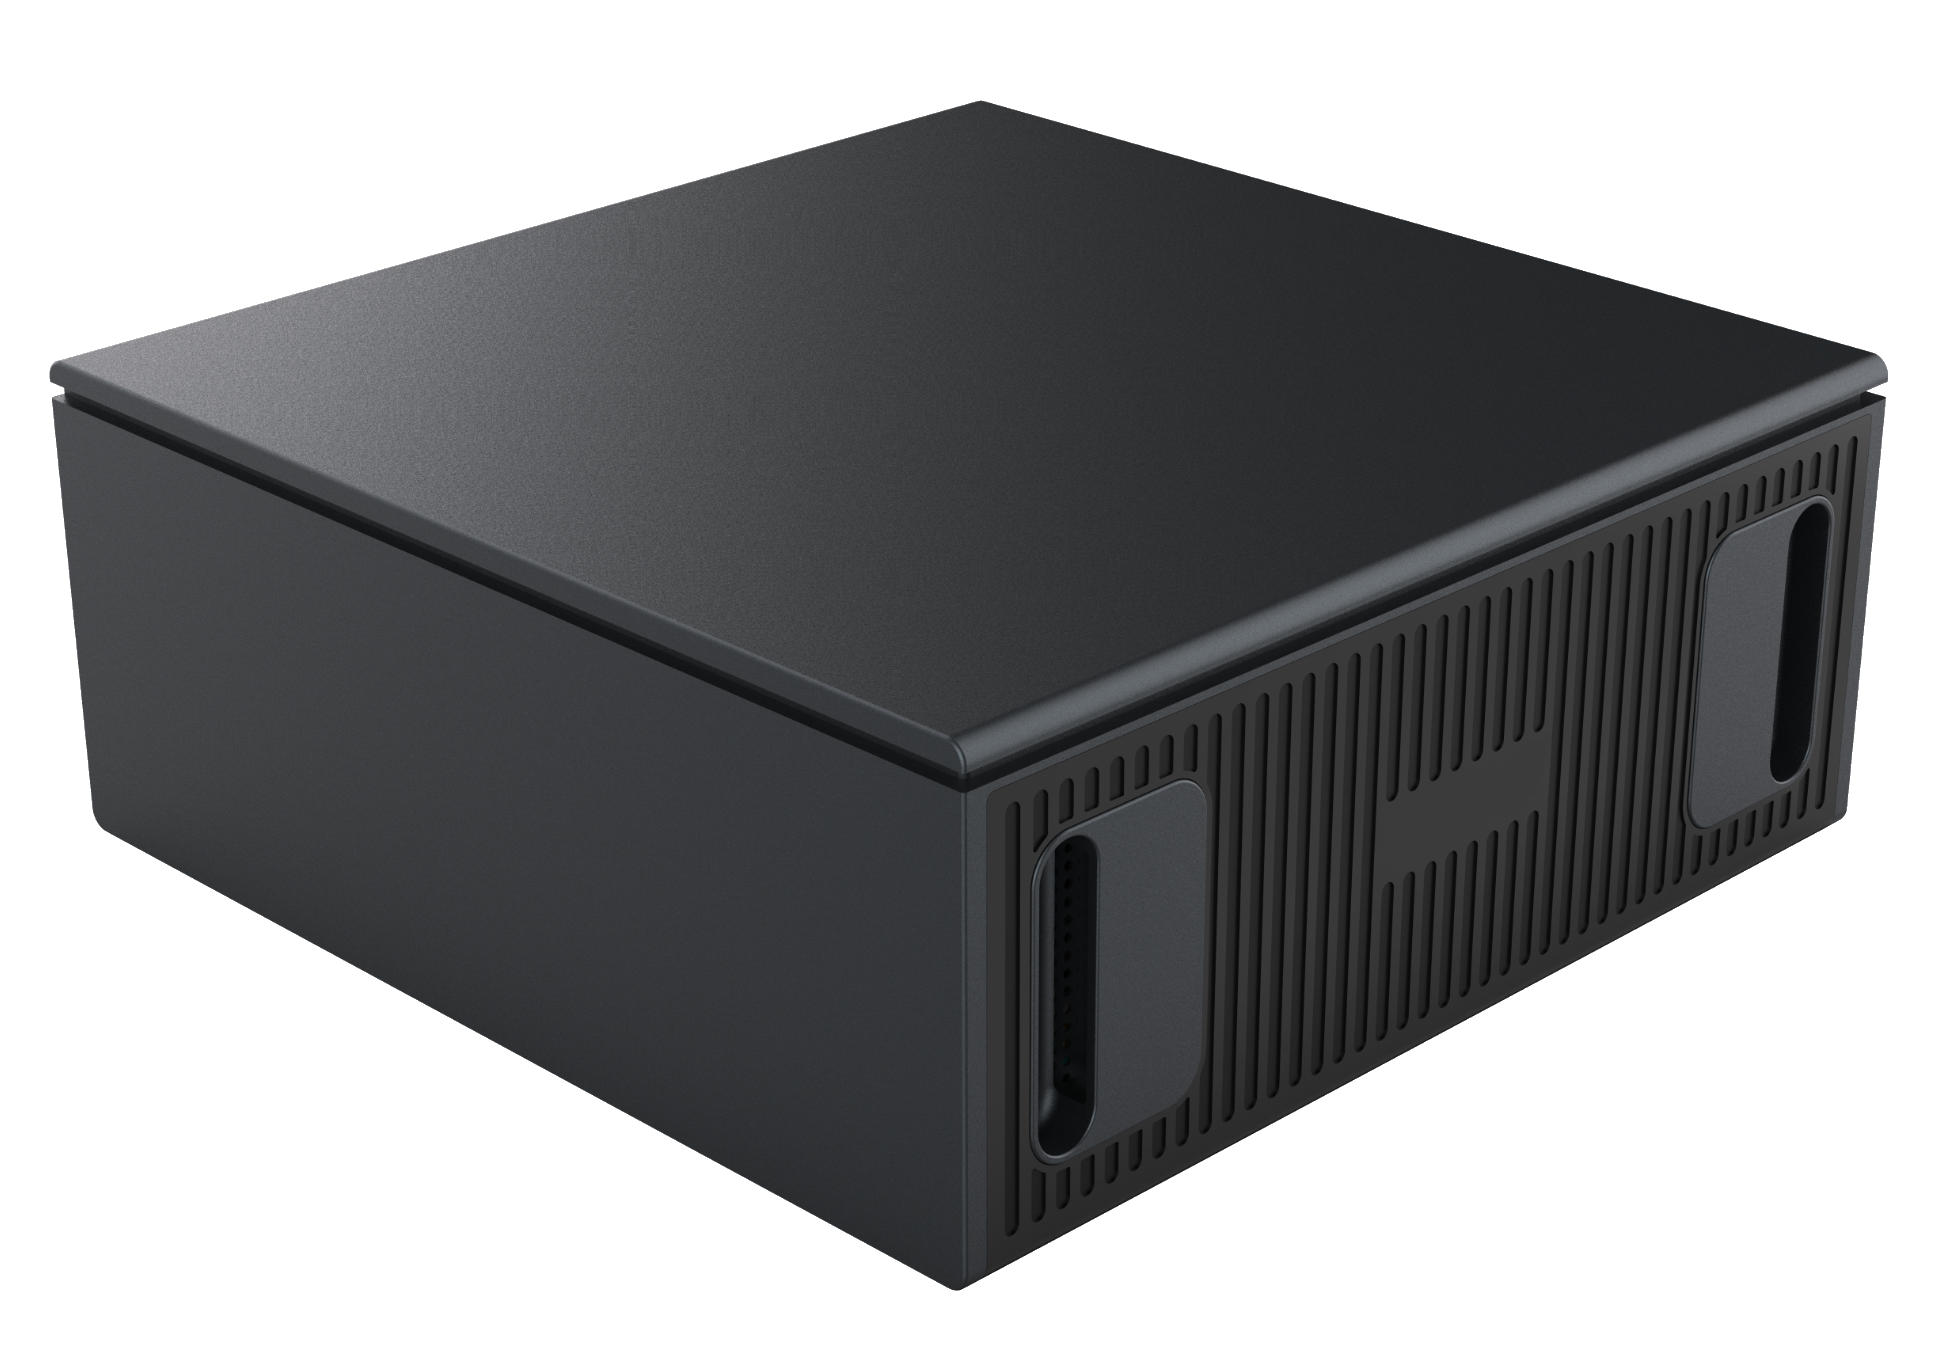
▲ 桌面级推理设备的典型形态:接近一本词典的体积,正面开口散热
05 怎么评估一台本地推理设备
厂商标称的 TOPS 参考价值有限,因为它衡量的是理想条件下的峰值。真正该看的是四个指标:
· 单位功耗吞吐:同样跑一个 7B 模型,谁的 token/s 除以瓦数更高
· 首 token 延迟:交互型应用最敏感的不是总吞吐,而是“多久开始出字”
· 并发衰减:1 路和 8 路同时请求,吞吐掉多少
· 可维护性:模型怎么更新、故障怎么定位、坏了多久能换
前三个要实测,第四个要看文档和备件。四项都过关,才谈得上“能上生产”。
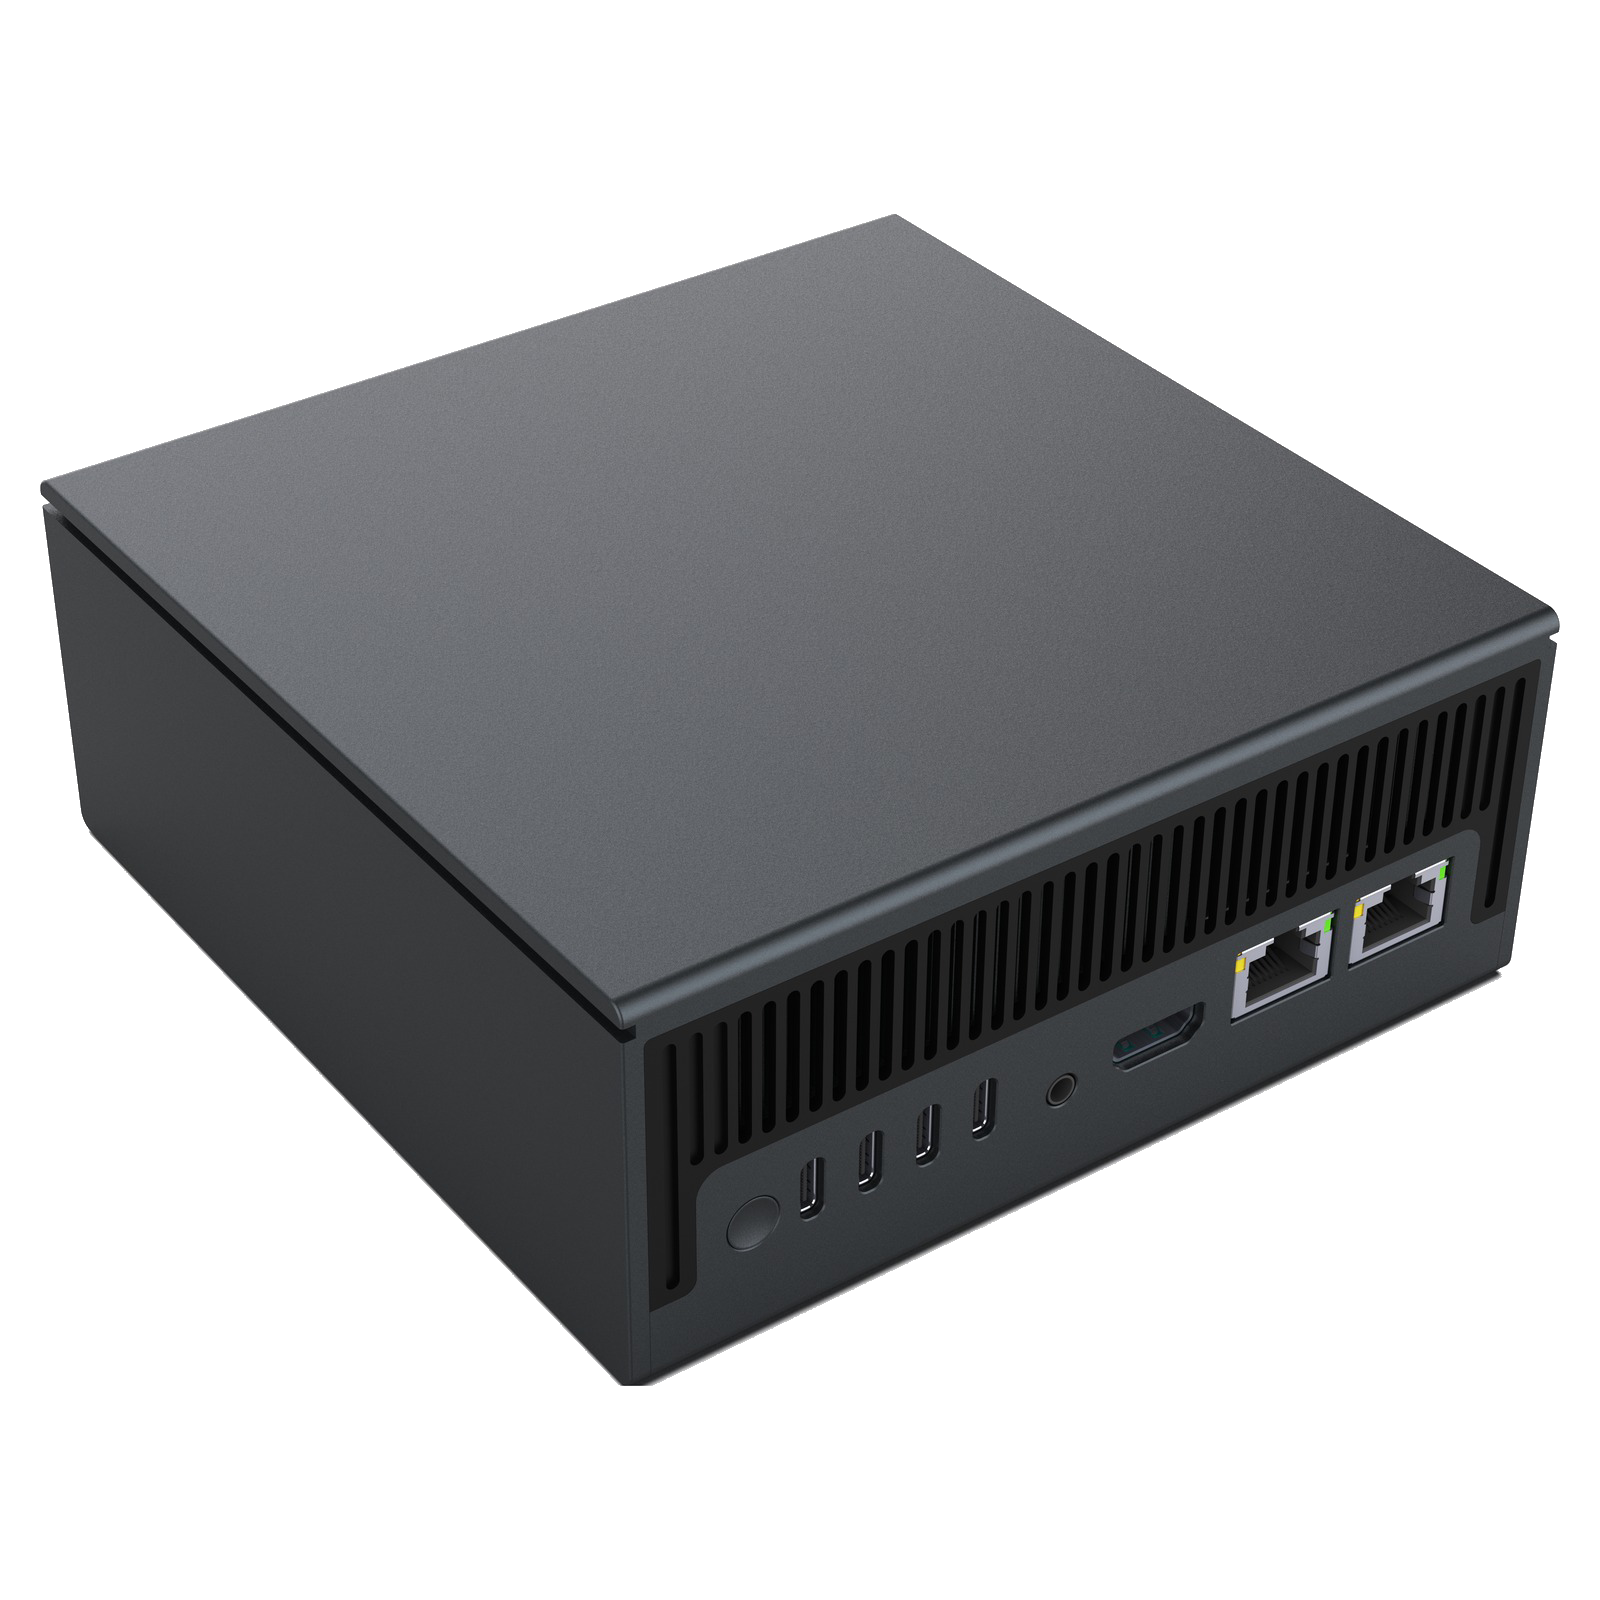
▲ 前面板:网口、HDMI、Type-C 与散热栅集中布置,可平放于工位
06 结构设计里的取舍
桌面形态最大的工程难题是散热与噪音。百瓦级功耗靠纯被动散热,机箱体积会大到失去意义;加风扇就会有噪音,放在工位旁边就成了体验问题。
常见的解法是把风道做直、把风扇藏进鳍片内部、用调速策略让风扇在低负载时停转。代价是满载时仍有可闻噪音,所以这类设备更适合放在设备间或开放办公区的角落。
另一个取舍是可维护性。模块化设计让算力可以升级,但也意味着结构件更多、装配公差更紧、成本更高。是否值得,取决于产品生命周期内模型规模会不会变——在模型一年一迭代的当下,答案通常是“值”。
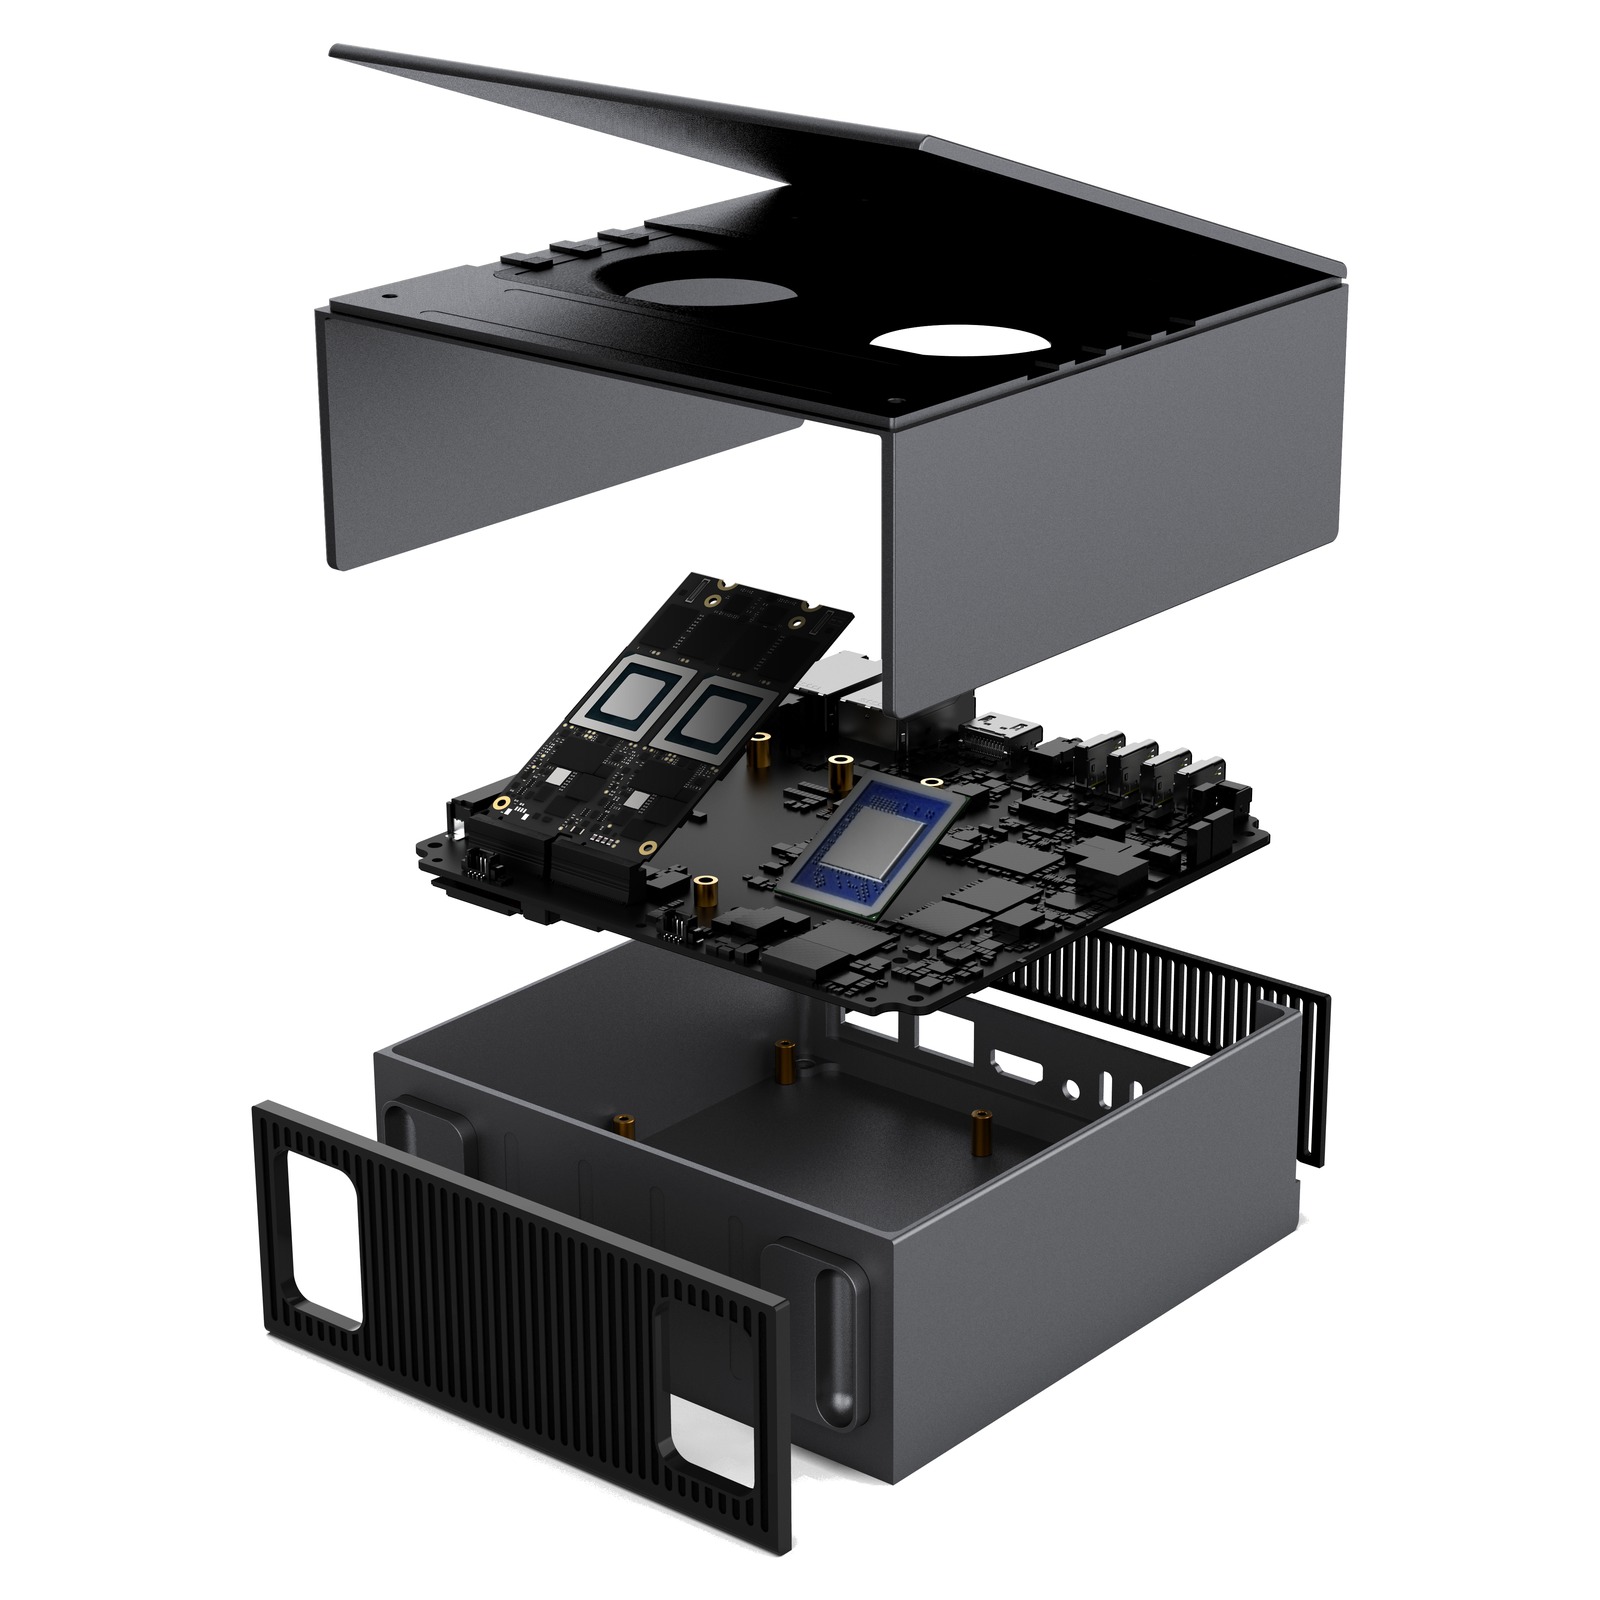
▲ 爆炸结构:上盖、主板与算力模块、机箱散热件,模块化便于按需升级
07 混合架构才是常态
把话说回来,本地推理不是要取代云。训练仍然在云上,长上下文、复杂推理、长尾请求也仍然交给云。合理的架构是分层:
· 高频、短上下文、数据敏感 → 本地
· 低频、长上下文、需要最强模型 → 云端
· 断网场景 → 本地兜底,恢复后同步
这套分层不新鲜,和十几年前“缓存放本地、数据库放机房”是同一个思路。变的只是被分层的对象,从数据变成了推理。
08 别神化本地
最后泼点冷水。单机算力有上限,多用户并发一上来就会排队;模型迭代速度快,今天够用的配置明年可能就不够;国产算力平台的软件栈仍在快速演进,算子覆盖和框架适配都需要预留时间。
本地推理是一门工程生意,不是一次硬件采购。算清楚调用量、数据边界和时延要求,再决定放哪儿,比追参数实在得多。
你所在的团队,现在哪些 AI 功能还在纯云端跑?如果搬到本地,最先卡住你的会是显存、成本,还是运维?评论区聊聊。
(本文为技术观察,不构成采购建议;文中数据来自公开资料与通用工程经验,具体性能以实测为准。)
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号