我拆了 Yelp 的 AI 助手,UI 这层才是最难搬的
原创
我拆了 Yelp 的 AI 助手,UI 这层才是最难搬的
原创
Lethehong
发布于 2026-11-15 16:14:37
发布于 2026-11-15 16:14:37
图 1 本文配图:围绕本文主题的氛围配图
先别急着把它当成前端重构
Yelp 在 11 月 15 日公开了 AI 助手的新 UI 方案,关键词是「原生 UI 与服务端驱动 UI 融合」。我第一眼看到这个说法,反应是,这不就是把组件树从服务端推下来吗,前端还剩下什么。
但往下想一层,事情没这么简单。Yelp 的 AI 助手不是聊天框里吐文字,它要回答「附近哪家拉面今晚还开着」「这家店适不适合带小孩」这类问题,答案里天然带结构化卡片、营业状态、评分、地图入口。这些组件的状态到底归谁管,才是这次改动的核心。
如果只是把卡片模板搬到服务端,那叫模板下发,不叫融合。它敢用「融合」这个词,说明原生 UI 没有退场,服务端下发的是一棵带占位节点的组件树,原生组件按类型接管渲染。
这个判断是我从「融合」两个字推出来的,公开信息没有给出组件协议的具体字段。所以下面所有关于字段级的描述,都是我按同类服务端驱动 UI 实现的通用规律做的推断,标清楚,不冒充事实。
服务端下发的不是数据,是组件树
服务端驱动 UI 这套东西不新鲜,Android 的 RemoteViews、Server-Driven UI 在电商 App 里用了好几年。它的基本形态是,服务端返回一个 JSON,里面每个节点有 type、props、children,客户端有一个注册表,按 type 找到对应的原生渲染器。
Yelp 这个场景的特殊之处在于,AI 助手的输出是动态生成的。模型这一轮决定给你一张餐厅卡片,下一轮可能给你一个对比列表,再下一轮可能是一张地图加三个标记点。这些结构没法在客户端编译期写死。
所以它必须走服务端下发组件树这条路。但组件树里每个叶子节点,最终还是要落到原生控件上,否则滚动性能、手势、无障碍全部崩掉。这就是「融合」两个字的实际含义。
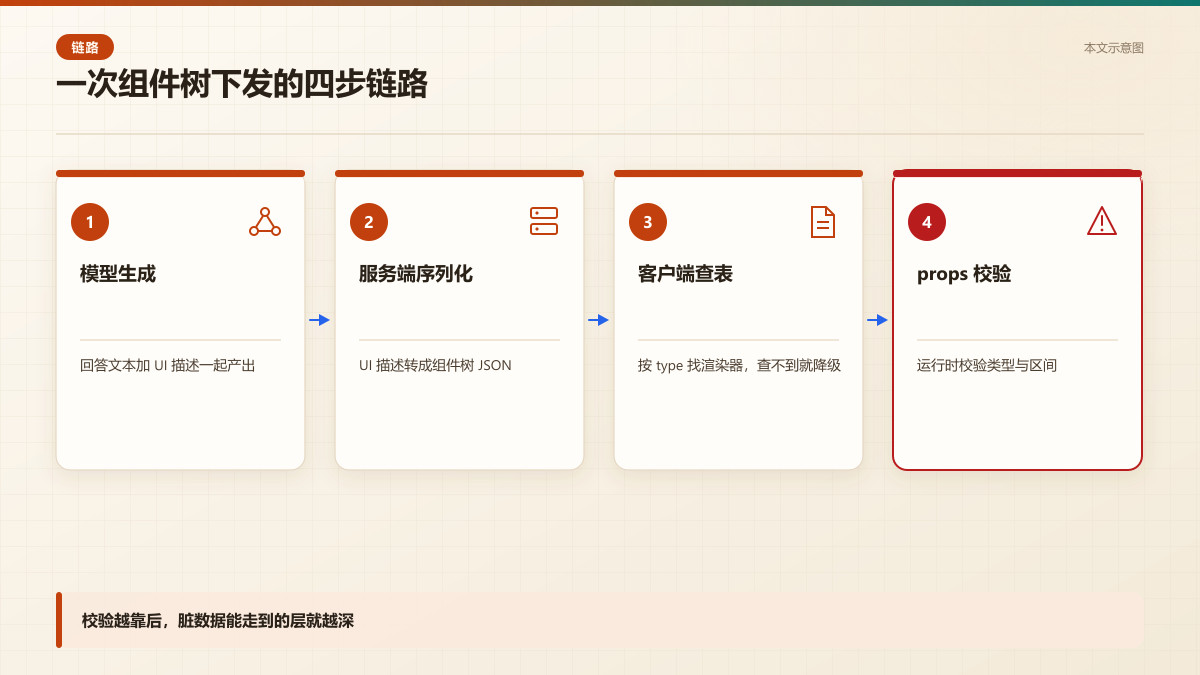
图 2 本文示意图:从用户提问到原生控件挂载,校验责任落在第三步和第四步之间
关键问题来了。一棵组件树从服务端到客户端,中间要过模型生成、序列化、传输、反序列化、类型匹配、props 校验六道关。任何一道关的校验逻辑写松了,客户端就会拿到一个它不认识的 type,或者一个类型对但 props 越界的节点。
缺陷最容易长在类型注册表这一层
我见过的服务端驱动 UI 实现,出问题最多的地方不是网络层,也不是渲染层,是类型注册表的查找逻辑。
客户端启动时注册一批渲染器,key 是字符串 type。服务端下发节点,客户端拿 type 去查表。查不到怎么办,大部分实现的选择是静默降级,渲染一个空白占位或者直接跳过。
这个选择在正常业务里没问题,但在 AI 生成内容的场景里就危险了。模型可能生成一个拼写错误的 type,或者生成一个旧版本客户端不认识的 type,静默降级意味着用户看到一块空白,而且没有任何日志能定位。
更麻烦的是 props 校验。原生 UI 时代,props 是编译期类型检查的,传错了编译不过。服务端驱动之后,props 是运行时从 JSON 来的,类型全靠运行时校验。一个本该是数字的字段传了字符串,一个本该在 0 到 5 之间的评分传了 99,这些都要在渲染前拦住。
公开信息没有披露 Yelp 的注册表实现细节,我不知道它用的是白名单加 schema 校验,还是简单的 switch case。但同类系统的通用规律是,校验越靠后,出问题的面越大。
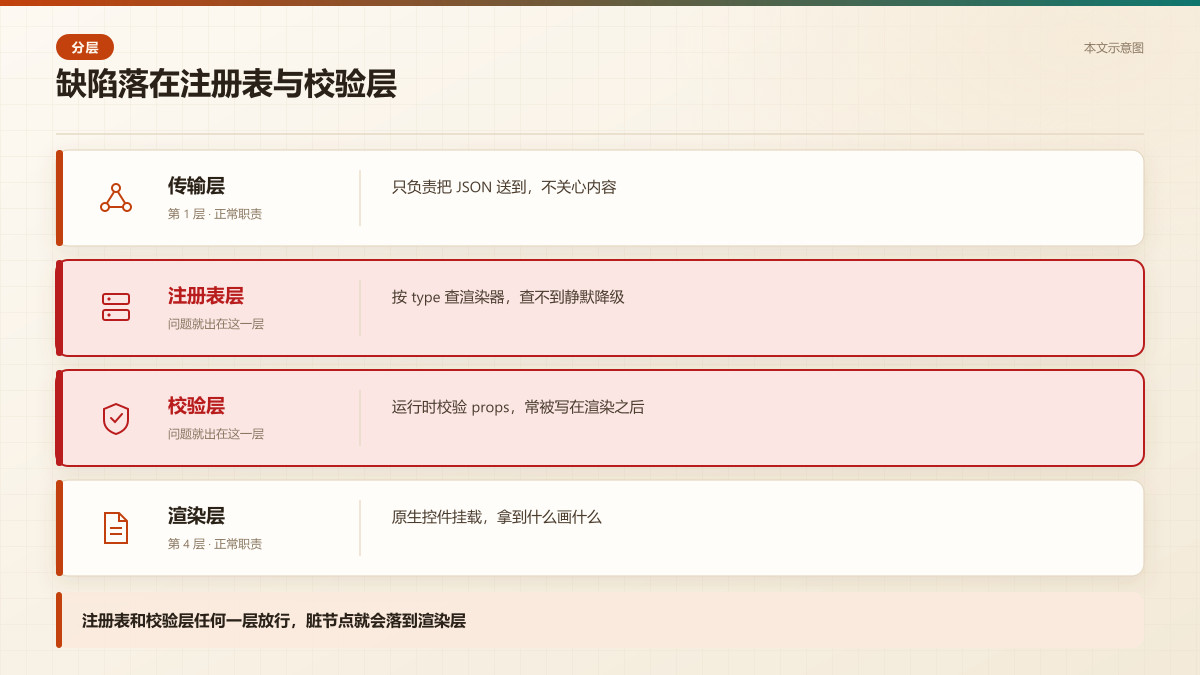
图 3 本文示意图:四层结构里,最该拦住未知类型的是注册表层,最容易被跳过的是 props 校验层
一次调用的完整顺序,我推了一遍
假设用户问「今晚还开着的拉面店」,一次完整调用大概是这个顺序。
第一步,客户端把 query 和当前上下文(位置、时间、用户偏好)发给 AI 服务。第二步,模型生成回答,同时生成一个 UI 描述,描述里包含组件类型和绑定数据。第三步,服务端把 UI 描述序列化成组件树,下发给客户端。
第四步,客户端反序列化,拿根节点的 type 查注册表。第五步,递归渲染子树,每个节点渲染前做 props 校验。第六步,原生组件挂载,绑定手势和埋点。
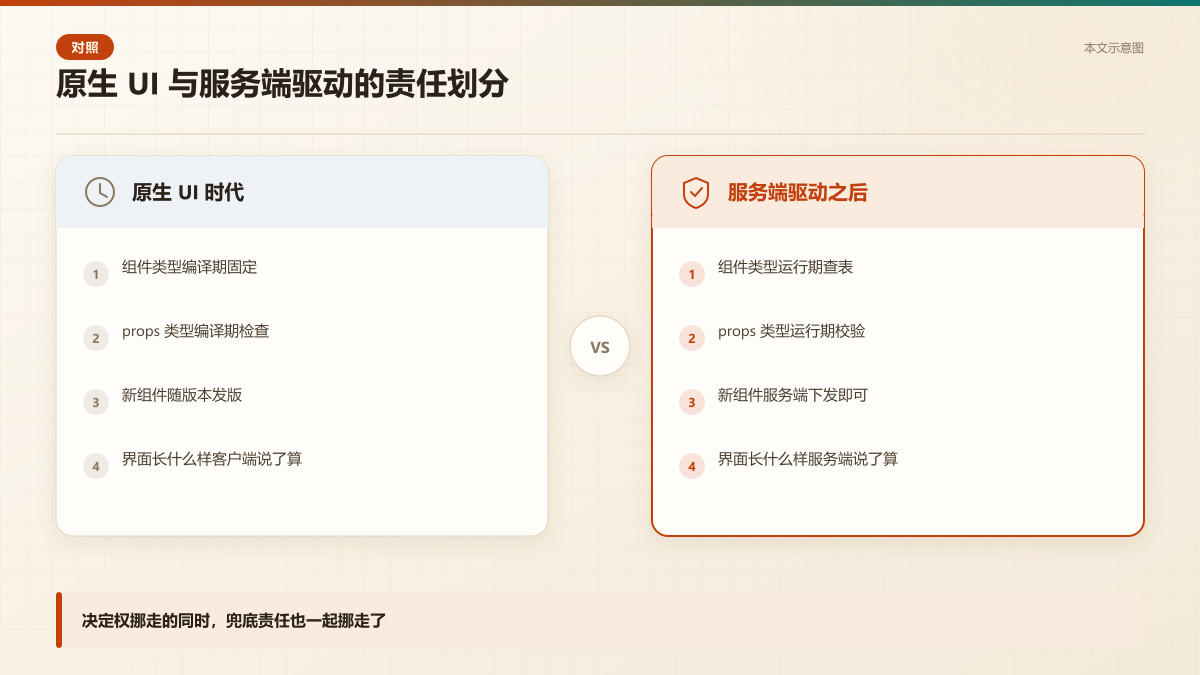
图 4 本文示意图:左边是编译期兜底的老做法,右边是运行期兜底的新做法,责任重心整体后移
问题出在第三步和第四步之间。服务端序列化的时候,它怎么知道客户端支持哪些 type。如果服务端不感知客户端版本,它可能下发一个新 type,老客户端不认识。如果服务端感知版本,那版本协商的逻辑本身就是一个新的失败点。
我倾向于认为 Yelp 走的是能力协商路线,客户端上报自己支持的组件类型列表,服务端在生成 UI 描述时把不支持的节点替换成降级形态。但这只是推断,公开信息没给。
这条链路我能验到哪一步
我没有 Yelp 的客户端包,也没有它的服务端接口权限,所以没法真的抓一次组件树下发。我能做的,是在本地搭一个最小复现,验证类型注册表和 props 校验这两个环节的失效模式。
模拟注册表与 props 校验(示意代码,验证未知 type 和越界 props 能不能在校验层被拦住)
下面这段 Python 脚本模拟的是客户端注册表查找和 props 校验的逻辑。它不连 Yelp,只是把「服务端下发未知 type」和「props 越界」两种输入喂进去,看校验层能不能拦住。
期望输出是,未知 type 被拒绝并记录,越界 props 被裁剪到合法区间。如果输出是静默通过,说明校验逻辑写在了渲染之后,而不是之前。
结果不对时,先怀疑注册表的 key 匹配是不是做了大小写归一化,再怀疑 props schema 是不是只校验了存在性没校验类型。这两处是同类实现最常见的漏点。
今天能做的事,分三档
如果你在做类似的服务端驱动 UI 系统,今天就能做的第一件事,是把类型注册表的查找逻辑改成失败即拒绝,不要静默降级。降级可以保留,但必须打日志、上报指标,让未知 type 可见。
这周能做的第二件事,是给每个组件类型补一份 props schema,在渲染前做运行时校验。数字字段校验区间,字符串字段校验长度和字符集,枚举字段校验白名单。校验失败走降级渲染,不要抛异常白屏。
做不到 schema 校验的过渡办法,是在服务端序列化时做一次类型收敛,把所有 props 强制转成目标类型,转不了的替换成默认值。这个办法治标不治本,但能挡住大部分脏数据。
第三件事是版本协商。客户端上报支持的组件类型集合,服务端在生成 UI 描述时做交集,交集之外的节点替换成通用降级组件。这一步不做,每次发新组件都是一次全量客户端的兼容性赌博。
这次没查到什么,我也得说清楚
公开信息没有披露 Yelp 的组件协议字段名,没有披露它的注册表是白名单还是 switch,没有披露它做不做客户端能力上报。这三个缺口决定了这次改动的真实风险面,我只能按通用规律推。
还有一个我没法验证的点,是 AI 生成 UI 描述这一环的约束强度。模型输出是自由文本,它生成的组件类型和 props 是不是经过了一层结构化约束(比如 JSON schema 强制解码),公开信息里看不到。如果没有这层约束,那服务端拿到的 UI 描述本身就是不可信的。
我也没拿到 Yelp 客户端在弱网、旧版本、组件类型不匹配时的实际表现,所以关于降级路径的描述都是推断。如果你手上有包,抓一次组件树下发就能验证我上面说的注册表行为,这个验证成本很低,值得做。
我的分析够不到的地方,也得摆出来
上面推了一整条链路,但有几处我确实够不到,得单独说清楚,不然就成了拿推断当事实。
第一,我没有 Yelp 的客户端包,也没有服务端接口权限,所以组件树下发的真实格式、字段名、嵌套深度,我全都没见过。s2 和 s4 里那些 type、props、children 的描述,是按同类服务端驱动 UI 的通用结构写的,不是 Yelp 的实际协议。
第二,模型生成 UI 描述这一环的约束强度,公开信息完全没提。它到底是自由文本生成后靠后处理解析,还是用 JSON schema 强制解码,这两种做法的风险差一个数量级。前者意味着服务端拿到的描述本身就不可信,后者至少保证结构合法。我没法判断 Yelp 属于哪一种。
第三,关于降级路径,我只在本地模拟了未知 type 和越界 props 两种输入,没有测弱网、旧版本客户端、组件树深度超限这些情况。真实环境里的失败模式比我模拟的多,这部分我只能标成未验证。
第四,也是最大的一个缺口,我没有 Yelp 这次改动前后的性能数据。服务端驱动 UI 的渲染开销、首屏时间、内存占用,这些指标决定了融合方案到底能不能在生产环境站住。公开信息里没有给出任何对比数字,我也没法在本地复现一个等价的 App 来测。所以这篇东西不涉及性能判断,只谈校验责任。
所以这篇东西的定位是,用通用规律推一个可能的风险面,再给一套能落地的防御动作。它不是 Yelp 的漏洞报告,我也没打算把它写成漏洞报告。真要坐实,得有人拿到包抓一次下发,那个成本很低,但不是我现在的条件能做到的。
写在最后
所以我的结论只到这一层,融合方案的方向是对的,原生 UI 的性能和服务端驱动的灵活性确实需要兼得。但兼得的代价是校验责任从编译期挪到了运行期,这一层的工程投入如果不够,后面会以白屏和空白卡片的形式还回来。
这件事真正值得看的,不是 Yelp 用了什么技术,是它把「界面长什么样」这个决定权从客户端挪到了服务端之后,怎么保证服务端下发的每一棵树,客户端都能安全地渲染出来。这个问题的答案,比任何架构图都重要。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章,我们,下次再见。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号