Qwen4-Max 上了 HN 首页,我最想先看清它到底放出了什么
原创
Qwen4-Max 上了 HN 首页,我最想先看清它到底放出了什么
原创
Lethehong
发布于 2026-11-16 13:15:16
发布于 2026-11-16 13:15:16
112 分、19 条评论,这是 Qwen4-Max 在 Hacker News 上首发几小时后的数字。官方博客只给了能力描述,权重、上下文长度、定价一个没提。这篇不转述通稿,我带你把它当一次技术发布来拆,看清哪些能立刻验、哪些得等。
先别急着喊最强,看它发了什么
2026 年 11 月 16 日,Qwen4-Max 出现在 Hacker News 首页,112 分,19 条评论。这个分数不算炸,但也不低,说明至少有一批人认真点进去看了。
我第一反应不是去看跑分,是去看它到底发了什么。结果有点意外,官方博客给的是能力描述,不是一份可以拿去复现的技术报告。
权重没放,上下文窗口没写,定价没写,推理成本没写。这几样里任何一样缺失,对开发者来说都意味着「先别排期」。
所以我这篇不打算替它吹,也不打算唱衰。我想做的是把这次发布当成一次技术事件来拆,拆完你至少知道今天该验什么、该等什么。
它跟上一代到底差在哪一层
公开信息里唯一能确认的,是名字从 Qwen3 系列跳到了 Qwen4-Max。这个命名至少说明两件事,一是代际换了,二是 Max 这个后缀还在,定位大概率仍是旗舰。
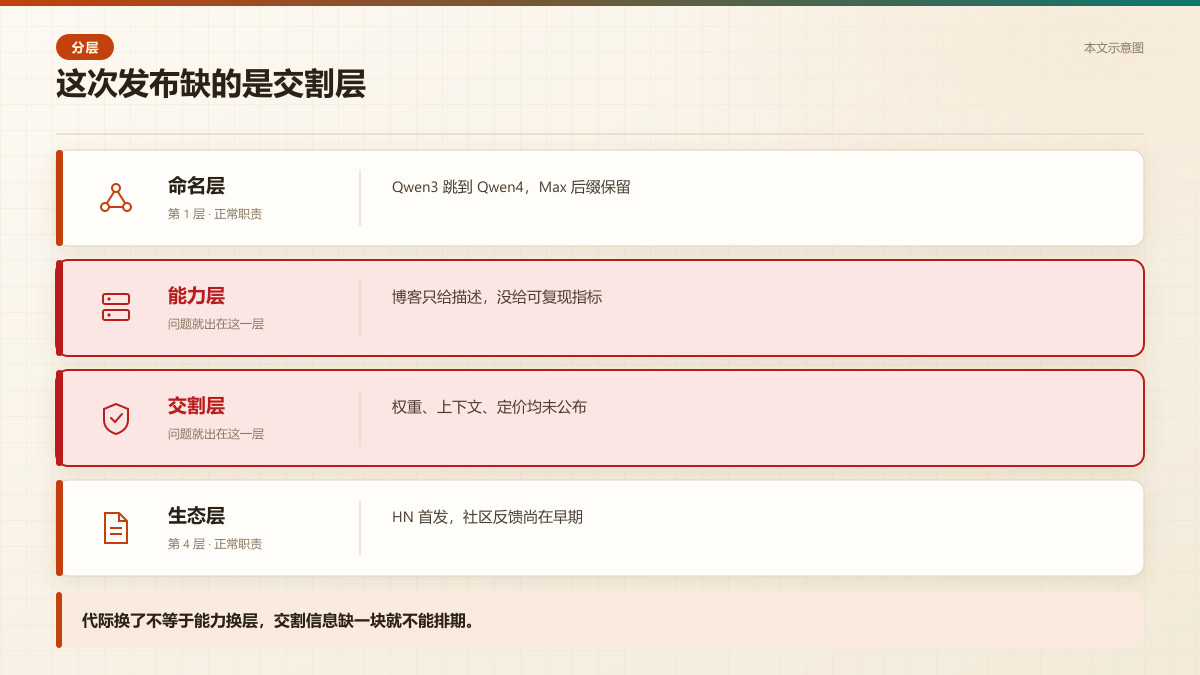
图 1 本文示意图:官方给了能力描述,但权重、上下文、定价、工具调用四块交割信息全空。
但代际换了不等于能力换层。我见过太多版本号跳一级、实际只是对齐策略调了一下的发布。要判断是不是真换代,得看三个东西,训练数据规模、上下文长度、推理时有没有新的机制。
这三样,官方博客一样没给。所以我现在的判断只能停在「命名换代,能力待验」这八个字上。
这里我得说清楚,公开信息未披露具体架构变化。下面我讲的同类旗舰模型的通用规律,是我基于过去两年 Qwen 系列发布节奏做的推断,不是这次的事实。
为什么 HN 的分数比博客更值得看
112 分放在 HN 上是什么水平,我翻了一下今天的榜单,同期的 uBlock Origin 漏洞 90 分,Nvidia 走向 99 分,Tor 的 DDoS 修复 58 分。Qwen4-Max 排在前列,但没到刷屏的程度。
19 条评论才是真信息。评论少说明两件事,要么大家还在看博客没来得及试,要么试了但没试出值得吵的东西。
我倾向于前者。模型发布当天,真正有价值的评论通常出现在 24 到 48 小时之后,那时候才有人拿它跑完自己的私有评测集。
所以今天这个时间点,HN 分数只能当热度参考,不能当能力证据。谁拿 112 分说它比谁强,那是在替它做它自己都没做的证明。
三个前提不成立,跑分就只是跑分
第一个前提,评测集得跟你的业务同分布。官方博客如果只给了通用 benchmark,那对你的代码补全、长文档抽取、多轮工具调用,参考价值有限。
第二个前提,推理成本得能算清。Max 这个定位通常意味着更大的参数量或更长的思考链,单位 token 成本大概率高于标准版。定价没公布之前,任何「便宜好用」的说法都站不住。
第三个前提,上下文长度得够你的真实输入。长文档场景下,上下文从 128K 掉到 32K,体验是断崖式的,不是线性下降。
这三个前提里,只要有一个不成立,跑分第一对你来说就是别人的第一。我自己的习惯是,新模型发布先拿自己手头三个真实任务去跑,跑完再谈要不要换。
我今天会先跑这三条命令
在官方 API 或本地部署可用之前,能做的验证有限。但有一件事今天就能做,把你现在用的模型和 Qwen4-Max 的公开接口做一次同题对比。
同题对比两个端点(示意代码,记录首 token 延迟、总耗时与输出长度,判断是否值得进候选)
import time, json, urllib.request

ENDPOINTS = {
    "current": "",
    "qwen4max": "",
}
PROMPT = "把这段需求拆成三个可执行步骤,每步不超过两句话。"

def call(name, url):
    body = json.dumps({"model": name, "messages": [{"role": "user", "content": PROMPT}]}).encode()
    req = urllib.request.Request(url, data=body, headers={"Content-Type": "application/json"})
    start = time.time()
    with urllib.request.urlopen(req, timeout=60) as r:
        first = time.time() - start
        data = json.loads(r.read().decode())
    total = time.time() - start
    text = data["choices"][0]["message"]["content"]
    return {"first_token_s": round(first, 2), "total_s": round(total, 2), "out_chars": len(text)}

for name, url in ENDPOINTS.items():
    print(name, call(name, url))
下面这段脚本不调任何未公开接口,只做一件事,把你准备好的测试题批量打到两个端点上,记录延迟和输出长度。端点地址你自己填,我不替官方编 URL。
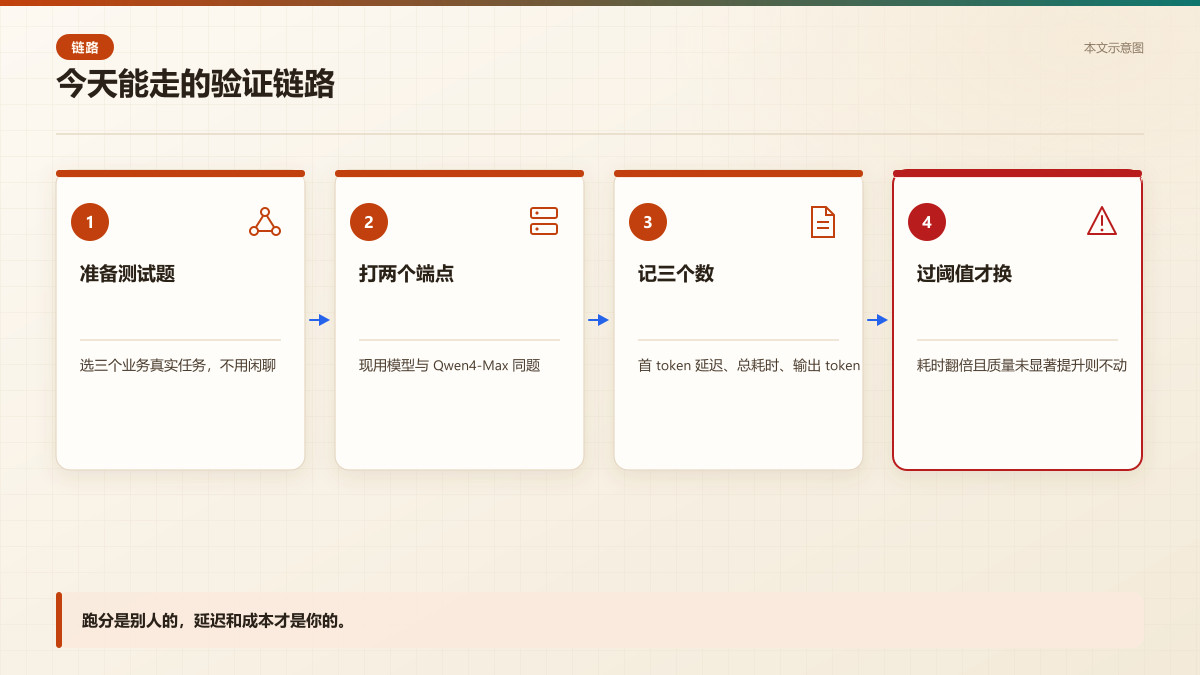
图 2 本文示意图:从公开端点取响应,到记录延迟与输出长度,再到决定是否进候选清单。
跑完看三个数,首 token 延迟、总耗时、输出 token 数。如果 Qwen4-Max 的总耗时是你现用模型的两倍以上,那除非质量提升非常明显,否则生产环境不该换。
结果不对时先怀疑哪一环,先怀疑你的测试题本身有歧义,再怀疑网络,最后才怀疑模型。我踩过太多次,最后发现是题目问得不清不楚。
升级这件事,我建议分三档走
立刻做的,只有一件,把 Qwen4-Max 加进你的模型候选清单,但不要动生产流量。今天它连定价都没公布,任何生产切换都是赌博。
这周做的,拿你业务里最痛的一个任务,做一次 A/B。痛的任务才试得出差距,拿闲聊去测旗舰模型,测不出东西。
做不到的时候用什么过渡,继续用你现在的模型,但把 prompt 里的模型名抽成配置项。等 Qwen4-Max 的定价和上下文公布,改一行配置就能切,不用改代码。
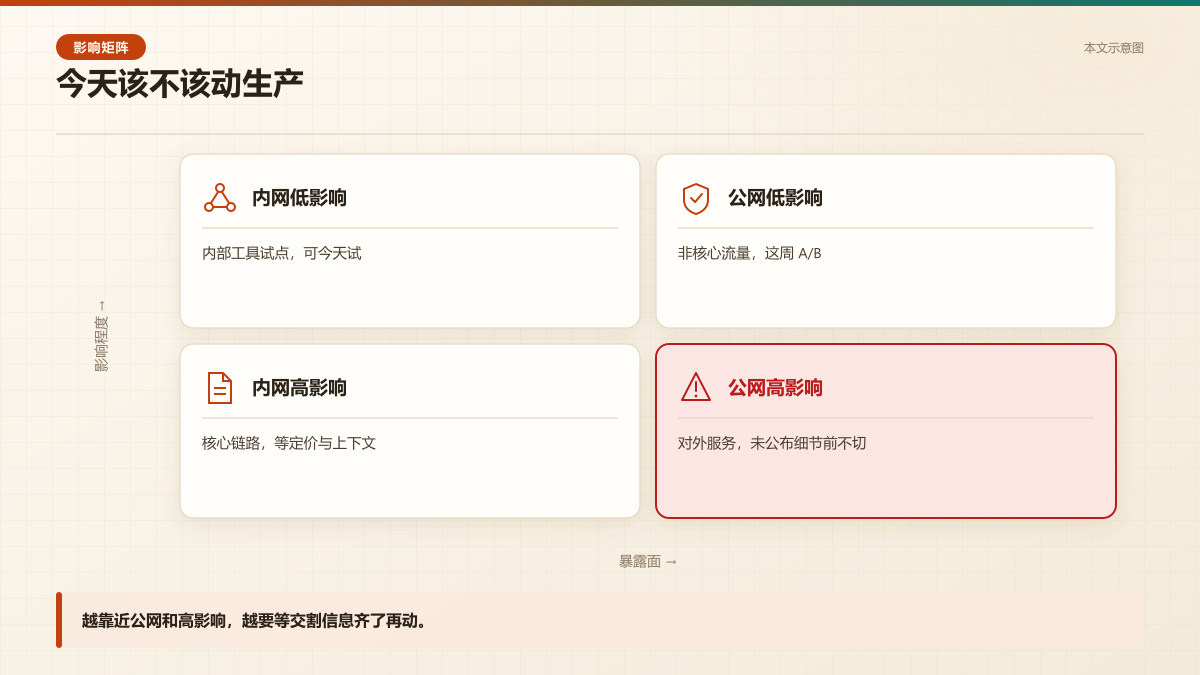
图 3 本文示意图:按暴露面与影响程度分四格,公网高影响那格才是真正要盯的。
这个习惯我建议所有人都养,模型迭代的速度已经快过大多数团队的发布周期了,硬编码模型名就是在给自己埋返工。
我没查到的那几块,得等官方补
公开信息未披露的有四块,模型权重是否开放、上下文窗口具体长度、API 定价、是否支持工具调用与结构化输出。
这四块里,工具调用对我最要紧。Max 定位如果只强在纯文本生成,那对 Agent 类应用的价值就打折。但这一点今天没法验,只能等文档。
还有一个我没验证的,是 HN 评论里有没有人贴出真实对比数据。19 条评论我没逐条读完,不排除里面已经有早期使用者的反馈,那会比博客更有参考价值。
所以这篇的结论有边界,它建立在「官方只发了能力描述」这个前提上。如果明天官方补了技术报告,我上面关于架构的推断就得重写。
模型发布越来越像期货,别急着交割
这两年我最大的感受是,模型发布越来越像期货交易,先挂牌,再慢慢交割细节。Qwen4-Max 今天挂的这块牌子,价格和交割日都还没写。
对开发者来说,最危险的动作不是不用新模型,是在细节没公布之前就把它写进架构。
真正该做的,是让自己的系统对模型保持可替换。哪家发新模型,你都能在一天内跑完对比,而不是花一周改代码。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
写在最后
模型发布越来越像期货,挂牌和交割之间隔着权重、上下文、定价三道手续。开发者能做的最稳的一件事,是让自己的系统对模型保持可替换,而不是对某一次发布下重注。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章,我们,下次再见。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号