GPT-6 Astra 帮物理学家写证明,这事跟你的代码库有什么关系
原创
GPT-6 Astra 帮物理学家写证明,这事跟你的代码库有什么关系
原创
Lethehong
发布于 2026-11-16 15:15:48
发布于 2026-11-16 15:15:48
先别急着看物理,看它被怎么用
OpenAI 今天在官方新闻里放出一条消息,标题是 A step toward defining the Standard Model on a lattice。副标题说得很克制,探索一个候选的非微扰格点标准模型定义,以及 GPT-6 Astra 如何帮助把这个想法变成一份详细的证明。
我第一反应不是「AI 又攻克物理了」,是「这份证明谁在审」。因为格点场论这个方向,构造性证明的门槛不在写,在每一步能不能被独立复算。
公开信息只给了这一层,模型在里面具体做了哪些步骤,是推导、是文献检索、还是把已有的碎片拼成连贯论证,官方描述没有拆开。这一点我得先说清楚,后面凡是涉及内部流程的,都是我的推断。
但这条新闻值得写,因为它把一个老问题摆到了台面上。当 AI 的输出从「一段能跑的代码」变成「一份声称成立的证明」,验证的成本由谁承担,验证的粒度细到什么程度。
格点标准模型难在哪,难在它不是拟合
标准模型本身是一套量子场论,用微扰论算出来的结果和实验对得极好。问题出在低能区,耦合常数变大,微扰展开不收敛,你没法靠逐阶展开去算强相互作用在那里的行为。
格点方法换了一条路。把连续时空离散成格子,路径积分变成有限维积分,然后用蒙特卡洛数值算。这条路在 QCD 上跑了几十年,成绩是实打实的。
但把整个标准模型,包括手征费米子和规范场,一次性放到格点上并且保持手征对称性,一直是个硬骨头。Nielsen-Ninomiya 定理摆在那里,你不能随便把费米子放上去还指望手征对称性自动保住。
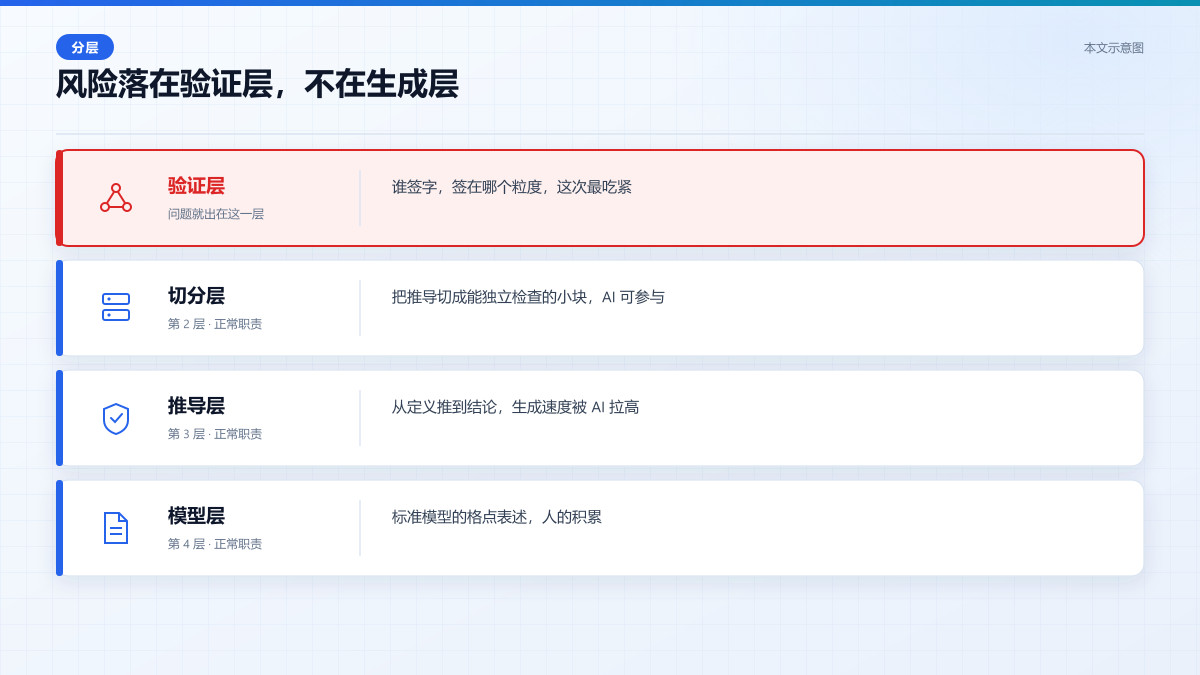
图 1 本文示意图:AI 参与推导之后,中间两层产出变快,最上面的验证层负担反而变重
所以「定义一个格点上的标准模型」这句话,分量在「定义」两个字上。它不是算一个数,是先把这套理论在离散情况下怎么写清楚,写到一个能被检验的程度。
这就是为什么标题用的是 a step toward,不是 we defined。一步,不是终点。
AI 在这类工作里的位置,跟写代码不一样
写代码的时候,AI 的输出有一个天然的裁判,跑一下,过不过。单元测试、类型检查、运行时错误,都是低成本的否定信号。
数学物理论证的裁判不是这样。一份证明对不对,没有编译器能告诉你。它要靠同行逐步读,靠每一步的前提是否成立、每个不等式是否真的成立、每个极限是否存在。
所以 GPT-6 Astra 在这里如果只是生成文本,那价值有限。它真正可能有价值的地方,是把论证拆成足够小的步骤,让每一步都小到可以被单独检查。
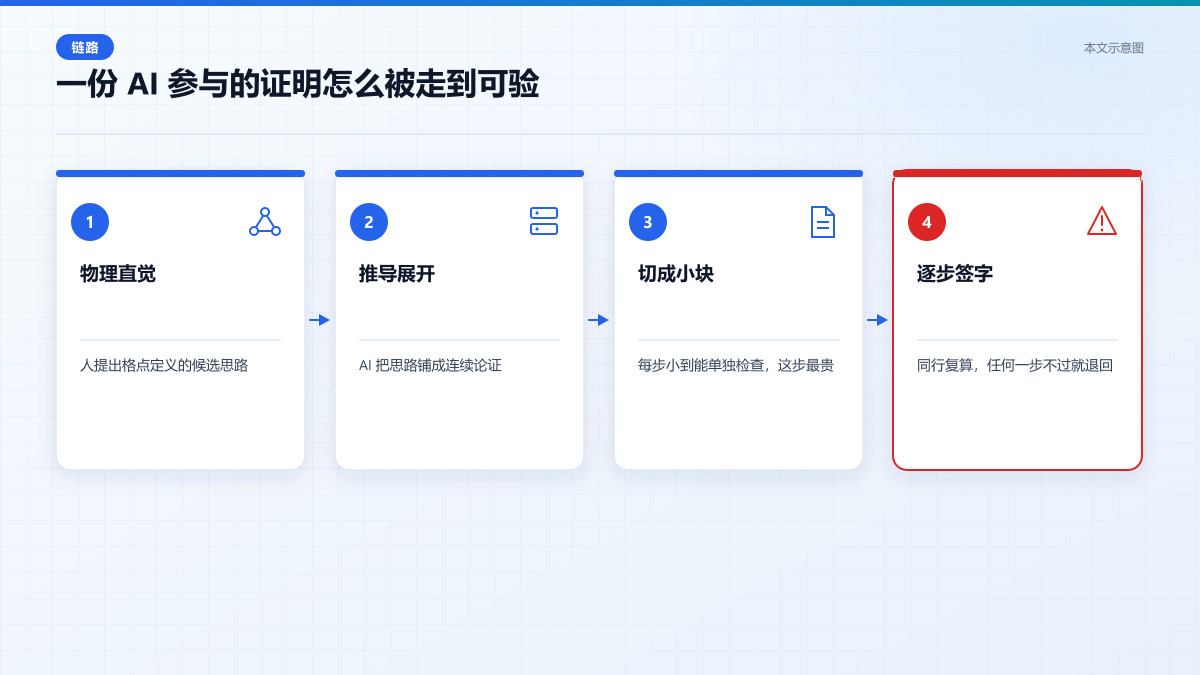
图 2 本文示意图:从物理直觉到可签字结论,中间卡住的不是生成,是切分和复算
这是我自己的推断,官方描述里没有写到这个粒度。但如果它做的不是这个,那「帮助把想法变成详细证明」这句话就站不住,因为详细证明的价值全在可检查性上。
反过来讲,如果它真的把证明拆到了可检查的粒度,那这件事的意义就超出了物理。它给出的是一个模板,AI 产出的长链条推理,怎么切成人类能逐段签字的形式。
问题不在生成,在每一步能不能被复算
我把这件事拆成四层来看,缺陷或者说风险,落在最上面那层。
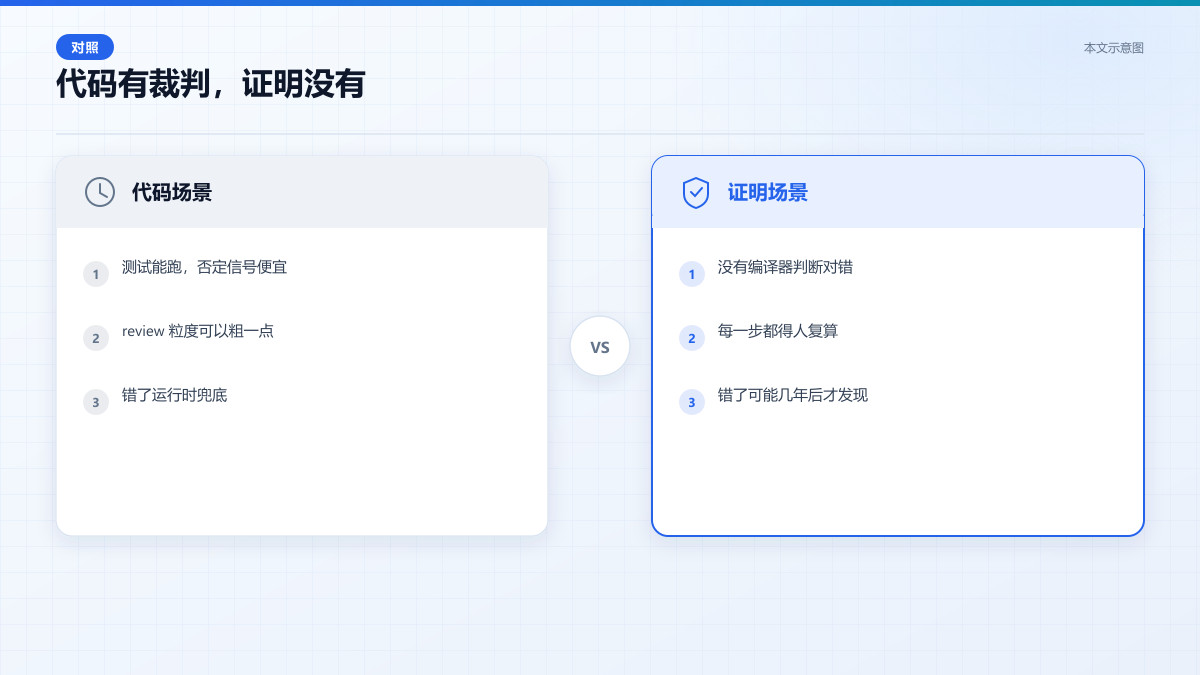
图 3 本文示意图:同样是 AI 产出,代码能靠测试低成本否定,证明只能靠人逐步读
最底下是物理模型层,标准模型的格点表述,这一层是人的工作,几十年积累下来的。往上是推导层,从定义出发一步步推到结论,这一层现在 AI 可以参与。再往上是步骤切分层,把推导切成可独立检查的小块。最上面是验证层,谁签字,签在哪个粒度上。
AI 进来之后,中间两层产出变快了,最上面那层的负担反而变重了。因为你要检查的东西变多了,而且写的人不是你,你对它的直觉信任是零。
这跟代码 review 是一个道理。一个你不熟的同事一口气提了八百行改动,你 review 的成本比他慢慢写还高。区别在于代码有测试兜底,证明没有。
所以这条新闻如果只读成「AI 会做物理了」,就读偏了。它真正暴露的是验证环节的瓶颈,而这个瓶颈在软件工程里已经存在很多年了。
换成代码场景,这个瓶颈你天天在撞
我不做格点场论,我做工程。但上面那套分层,换成代码是一一对应的。
模型层是业务约束,推导层是 AI 生成的实现,步骤切分层是 commit 的粒度,验证层是测试和 review。
你现在用 coding agent 的时候,最容易出问题的是哪一层,是步骤切分层。AI 一次给你两百行,你看不完,于是你选择相信,相信的代价在后面某天爆出来。
这份物理证明给我的启发是,把粒度压小这件事本身要当成产出的一部分。不是「AI 写完了,我来验」,是「AI 写的时候就得按我能验的粒度写」。
具体到操作上,就是要求它一次只改一个函数、一次只动一个分支、每步给出它认为的验证方式。这些要求写进提示词里,成本很低,收益是把 review 从「通读」变成「核对」。
一段能跑的代码,把粒度检查变成习惯
下面这段不是复现物理证明,我没那个能力。它是把「一次改动是否落在可检查的粒度内」这件事变成一个能跑的检查。
思路很简单,拿 git diff 的行数、涉及文件数、涉及函数数当代理指标,超过阈值就提醒你这次改动大到 review 会失真。
改动粒度自检(示意代码,筛出单次改动过大、review 会失真的提交)
阈值要按你自己的项目调,我这里给的是经验值,不是标准。
读者今天该做什么,分三档
立刻做的,是回头看你最近一周让 AI 生成的那些改动,挑出其中单次超过两百行的,重新过一遍。不是为了找 bug,是为了确认你当时到底看没看懂。
这周做的,是把粒度要求写进你的提示词模板。一次一个函数,一次一个分支,改动前先说清打算动哪几个文件。这三句话加进去,成本几乎为零。
做不到的时候,过渡办法是强制自己只看 diff 不看生成过程。生成过程会给你一种「我全程盯着」的错觉,diff 才是最终事实。
如果你在团队里带人,还有一件更值得做的,把 review 的粒度写进流程。不是规定行数上限,是规定「超过某个规模的改动必须拆」。这条规则对人和对 AI 一视同仁。
我怎么验的,以及这次没查到什么
我得先把验证这块说清楚。我做的不是复现那份证明,我没有格点场论的背景,也没有拿到它的推导文本。我能验的只有公开信息这一层,官方新闻的标题、副标题、措辞,以及它选择用 a step toward 而不是 we defined 这个事实。
基于这些,我做了两件事。一是把新闻里的措辞逐个对照,看哪些是已完成的陈述,哪些是探索性的表述,结论是后者占主导。二是把「AI 产出怎么被验证」这条线拉到我熟悉的代码场景,看它能不能推出可执行的结论,也就是上面那套分层和那段脚本。
下面是我这次够不到的地方,列清楚比含糊过去强。
第一,GPT-6 Astra 在这份证明里具体做了什么,公开描述只有一句话。是生成了完整推导,还是只做了局部补全,还是做了文献层面的串联,公开信息未披露,我不知道。
第二,这份证明目前有没有经过同行评议,官方新闻没有说。a step toward 这个措辞本身就在回避「已成立」这个判断。
第三,格点标准模型的构造在这个领域里已有的进展到了哪一步,我没有能力判断这次的工作相对前人推进了多少。这是领域知识缺口,不是信息缺口。
第四,我连这份证明的篇幅、结构、引用了多少篇前人工作都没看到。公开信息里只有一句概括,没有正文,没有附录,没有引用列表。这意味着我连「它把推导切到了多细」这个最关键的判断都没法做,只能从措辞上反推。
第五,那段脚本我只在自己的仓库里跑过,样本是我最近两周的提交记录,样本量小,阈值是拍脑袋定的。它能不能在别人的项目里用,我没有验证过,也不打算说它通用。
所以上面关于「步骤切分是价值所在」的那套推理,建立在「AI 参与的是推导链条」这个假设上。如果它实际参与的是别的环节,那套推理要改。
我把这个假设标出来,是因为这类新闻最容易犯的错,是把一句克制的官方描述读成一个已经完成的结论。
这次的分析够不到哪里,我得说清楚
上面八节里,凡是我讲到 GPT-6 Astra 内部怎么工作的地方,都是从公开措辞反推的,不是我看到的东西。这条边界我想单独拎出来说,因为它决定了这篇稿子里哪些结论能拿去用,哪些只能当猜。
能拿去用的部分,是验证层这个框架,以及从它推出来的那几条操作。这部分不依赖那份证明本身成不成立,换成任何一次 AI 产出长链条推理的场景,逻辑都成立。
够不到的部分有三块。第一块是那份证明的正文,我没看到,所以它到底把推导切到了什么粒度,我只能靠 a step toward 这个措辞去猜,猜错了整篇的立论就要挪位置。
第二块是格点场论这个领域的进展坐标。我不知道这次的工作相对前人推进了多少,也不知道「定义」这个词在这个圈子里具体指到哪一步。这是领域知识缺口,不是信息缺口,补不上就是补不上。
第三块是那段脚本的普适性。样本只有我自己两周的提交记录,阈值是经验值,换个仓库、换个团队规模,它可能完全不准。我没有任何数据能说明它在别人那里也能用。
还有一块是我压根没碰的,就是这件事对物理学本身的意义。我没有能力评价一份格点标准模型的构造性证明在学术上值多少,这篇稿子从头到尾也没打算评这个。
所以这篇的分析半径,到「AI 产出变长之后验证怎么跟上」为止。再往外,比如这份证明会不会改变格点场论的研究路径,公开信息不够,我的知识也不够,我不下结论。
所以今天到底动不动手,怎么动
回到最实际的问题。这条新闻不会让你的线上服务挂掉,没有 CVE,没有需要打补丁的版本区间。所以「今天就动手」这句话,不是让你去升级什么,是让你改一个习惯。
我给的判断是,今天值得花二十分钟做一件事,翻出你最近一周 AI 生成的最大一次改动,逐行读一遍,边读边问自己这一步我能不能独立复算。读不完的那部分,就是你验证层的缺口。
这周内做第二件,把「一次一个函数、一次一个分支、改动前列出要动的文件」写进你的提示词模板。这不是玄学,是把切分粒度前置到生成阶段,省掉后面 review 的返工。
如果团队有 review 流程,第三件是把规模上限写进去。超过两百行或者超过五个文件的改动必须拆,这条对人和对 AI 一样。写不进去的团队,过渡办法是 review 时只看 diff 不看生成过程,别被「我全程盯着」的错觉骗了。
这三件事都不依赖那份物理证明最后成不成立。它成立,说明这条路走得通,你的粒度习惯值钱。它不成立,说明验证层比想象中更吃紧,你的粒度习惯更值钱。
真正的信号在验证侧,不在生成侧
这两年每次有模型发布,讨论的焦点都在它能生成什么。能写代码、能写文章、能推公式。生成能力确实在涨,但涨到某个点之后,瓶颈就换位置了。
换到验证侧。你能不能快速判断一个产出对不对,这个能力没有跟着一起涨。物理证明是这样,代码 review 是这样,你每天看的那些 AI 生成的分析报告也是这样。
所以这份格点标准模型的证明,我关心的不是它推进了物理学多少,是它有没有给出一种可复用的验证结构。如果给了,那它对写代码的人的意义,比对物理学家还大。
毕竟物理学家只有那么多,而每天被 AI 产出淹没的工程师,到处都是。
写在最后
AI 能写出的东西越来越长,这件事本身不新鲜。新鲜的是,愿意为其中哪几步负责的人,有没有跟着变多。格点标准模型那份证明最后成不成立,要等同行去复算,但「怎么让每一步都能被复算」这个问题,今天就可以开始在你的代码库里练。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章,我们,下次再见。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号