Kibana 中的 AI 连接器:你的 Agent 可调用的 90+ 数据源
原创
Kibana 中的 AI 连接器:你的 Agent 可调用的 90+ 数据源
原创
点火三周
发布于 2026-11-17 15:24:37
发布于 2026-11-17 15:24:37
Kibana 自带 90 多个 AI 连接器。其中包括 Slack、GitHub、Confluence 和 PagerDuty,以及 Gmail、Drive、Jira、Salesforce 和 Snowflake。将其中一个添加到 Agent,它就能在推理时把该服务当作工具来调用。无需编写集成代码,数据也保留在原本所在的位置。你的 Elasticsearch 索引告诉 Agent 发生了什么;连接器则告诉它原因——无论原因是更改了权限范围的拉取请求、关于已知回归问题的 Confluence 页面,还是有人首次提出该问题的 Slack 线程。在事件处理过程中,这可以节省通常用于寻找上下文的前 30 分钟。
90+ AI 连接器库
Kibana 自带 90 多个连接器规范,包括 Gmail、Google Drive、Google Calendar、Slack、GitHub、Confluence、PagerDuty、Jira、Salesforce、Datadog 和 Snowflake:
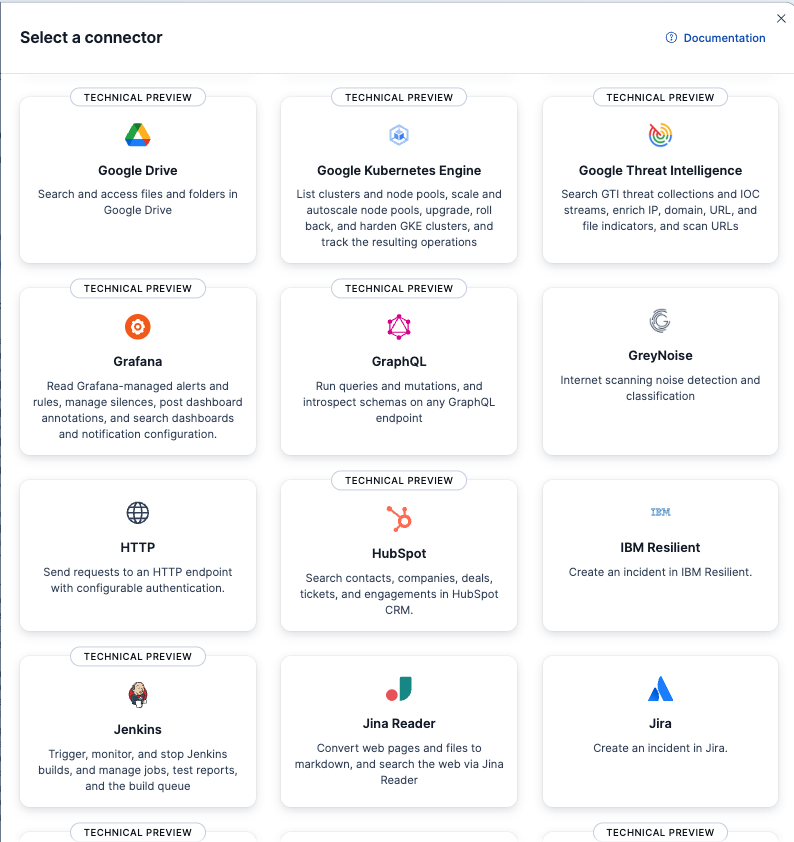
The Kibana AI connectors library showing Google Drive, Jira, Grafana and other available connector specs
每个规范都会声明该连接器可以访问哪些数据、如何进行身份验证、支持哪些操作,以及其中哪些操作可供 Agent 作为工具调用:
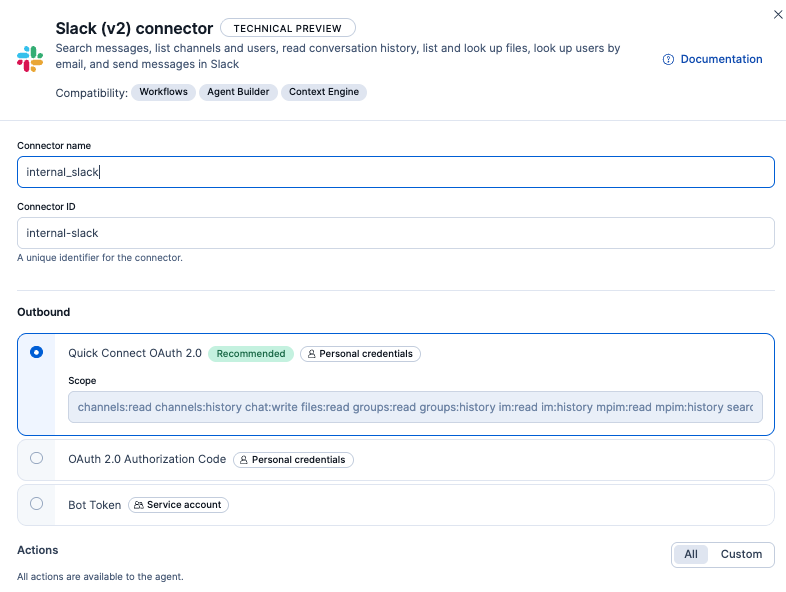
Slack AI connector setup in Kibana showing OAuth and bot token options and the actions open to the agent
最后一点让这套机制真正实用。Agent 在推理时会调用连接器操作,就像调用任何其他工具一样。无需编写集成代码,也无需维护单独的流水线。
AI 连接器如何进行身份验证
Kibana Connectors 可处理 OAuth、API key 以及 bearer token。借助 Elastic 的 Auth Relay Service,用户可以向 Google 或 Slack 授权,而无需将自己的凭据交给 Kibana。Agent 看到的是有类型的操作,底层的一切由规范处理。
AI Agent 如何从索引之外获取上下文
例如,假设一位产品分析师向 Agent 询问客户互动情况。Elasticsearch 索引中包含事件、会话、客群和转化指标,而 Agent 擅长查询这些数据并编写 Elasticsearch Query Language(ES|QL)。
问题在于发生了什么,而不是数字显示了什么。分析师想知道,为什么第二季度企业客群的互动下降,以及应该如何处理。索引数据无法回答这一点。答案分散在四个地方:
- 一封邮件线程,其中某个大客户指出了客户入驻引导问题
- 一份 Google 文档,描述了第二季度初上线的功能变更
- 一场 Slack 讨论,增长团队在其中讨论了一个假设,但始终没有定论
- 一份产品评审会的日历邀请,会上有人决定推迟修复
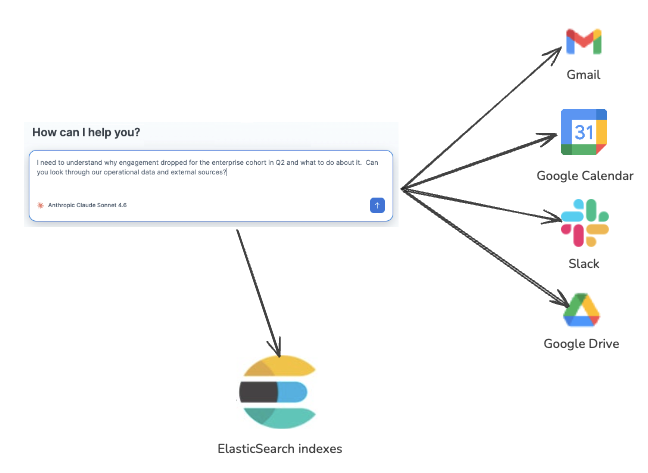
AI agent querying Elasticsearch indexes plus Gmail, Calendar, Slack and Drive to explain a Q2 engagement drop
借助 Kibana Connectors,Agent 可以触达所有这些信息。它会搜索邮件、从 Drive 中提取规范、读取 Slack 线程,并查看会议记录以确认决定了什么以及何时决定。分析师只需问一次,其余交给 Agent。
AI 事件响应:更快定位根因
现在考虑一个安全告警。安全信息和事件管理(SIEM)系统标记出异常的凭据使用和横向移动,以及某个内部服务账号认证失败次数激增。原始遥测数据位于 Elasticsearch 中,因此 Agent 可以查询这些数据并关联事件。它还可以找到受影响的主机。
找到数据只是简单的一步,难的是弄清发生了什么。是哪次代码变更导致了这个问题?异常发生前是否刚刚进行过部署?原始设计对身份验证流程的意图是什么?值班工程师何时介入,他们已经排除了哪些可能?
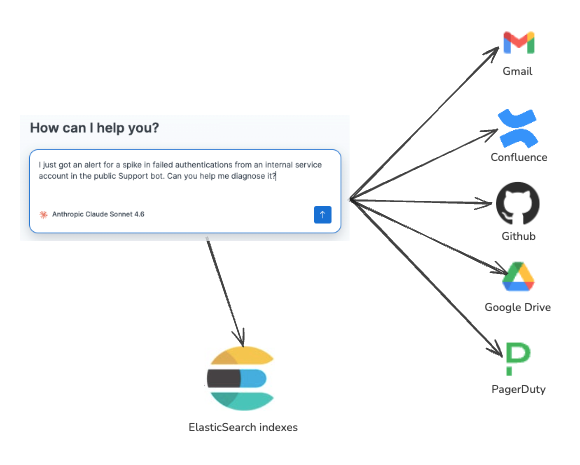
AI incident response: agent querying Elasticsearch, Gmail, Confluence, GitHub, Drive and PagerDuty after an alert
Elasticsearch 保存遥测数据。其余记录分布在另外四个地方:
- 添加权限范围的 PR 在 GitHub 中
- 说明这是缺陷还是预期行为的设计文档在 Confluence 中
- 事件时间线在 PagerDuty 中
- 团队当前的推测在某个 Slack 线程中
借助 Kibana Connectors,Agent 可以在工程师仍在阅读告警时收集这些材料。这能节省事件处理的前 30 分钟——这段时间通常用于寻找上下文。
AI 连接器应使用哪种身份?
一旦离开 Elastic,身份问题就会变得复杂。Kibana 用户和 Google Drive 登录账号是两种不同的身份,即使它们共用同一个电子邮件地址。当连接器调用外部服务时,它必须确定自己以谁的身份行事。正确的答案取决于 Agent 正在访问谁的数据。
个人数据:以用户身份连接
个人数据(例如 Gmail 收件箱、Slack 私信或 Drive 文件夹)需要以个人自己的身份进行连接。这正是 Agent 有用的原因:它能看到该用户的私人对话,而看不到其他人的。支持个人 OAuth 的连接器允许每位用户分别授权,因此 Agent 会以他们的权限行事。
组织数据:以系统账号连接
组织数据(例如 PagerDuty 时间线、Confluence 设计文档或共享 GitHub 仓库)通常更适合使用系统账号或 API key。管理员只需配置一次身份验证,之后无需每个人单独进行身份验证。
个人数据 | 组织数据 | |
|---|---|---|
示例 | Gmail 收件箱、Slack 私信、Drive 文件夹 | PagerDuty 时间线、Confluence 设计文档、共享 GitHub 仓库 |
身份验证 | 个人 OAuth | 系统账号或 API key |
配置者 | 每位用户分别配置 | 管理员一次性配置 |
Agent 可见范围 | 仅该用户可见的内容 | 服务账号可见的所有内容 |
大多数 Agent 最终会混合使用两种方式。
在 Kibana 中设置 AI 连接器
你添加的每个 AI 连接器都会成为 Agent 可调用的对象,因此设置是一次性配置,而不是一个集成项目。
在 Kibana 中打开你的 Agent,进入工具配置。浏览连接器库,并设置你需要的数据源。你添加的任何连接器都可供该 Agent 在推理时使用。
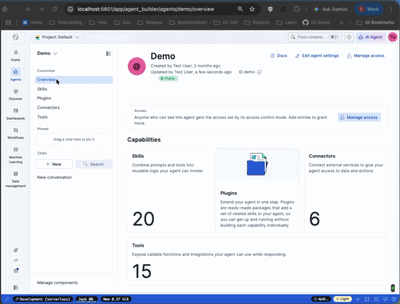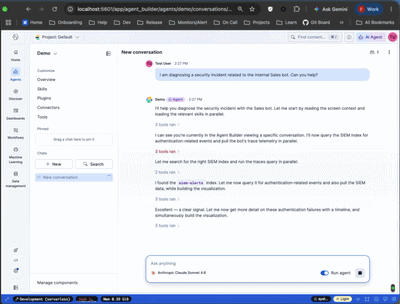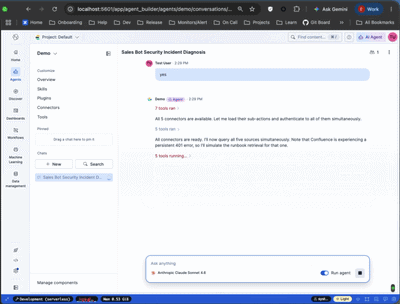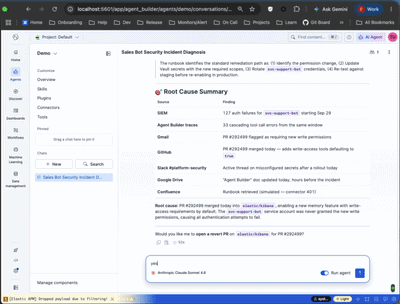
Kibana agent overview showing 6 AI connectors alongside 20 skills and 15 tools available to the agent
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号