过犹不及:重排搜索结果时,为何 20 个候选优于 200 个
原创
过犹不及:重排搜索结果时,为何 20 个候选优于 200 个
原创
点火三周
发布于 2026-11-17 15:26:14
发布于 2026-11-17 15:26:14
动手体验 Elasticsearch:进入 Elasticsearch Labs 仓库 中的示例 notebook,开始免费云试用,或立即在本地机器上试用 Elastic。
我们最近在 25 个检索基准测试中测试了 jina-reranker-v3.5,以找出什么样的候选池大小能在准确率与 Token 成本之间取得最佳平衡。对来自 Elasticsearch BM25 的前 100 个候选进行重排,平均可将错误率降低约 21%;而将候选池减半到 50 个,只损失约 2% 的准确率,却能把 Token 数量减半。使用 jina-embeddings-v5-text-small 的语义搜索则更早达到峰值:20 个候选,错误率降低 8.5%。而给它 200 个候选时,平均表现甚至比完全不使用重排器还差。候选越多并不一定越好。初始检索越差,重排器需要的候选就越多,需要修正的内容也越多。
什么是重排器?
重排器 AI 模型以查询和候选匹配项为输入,独立生成新的排序,将候选从最匹配到最不匹配进行排序。
理论上,你可以让重排器独自完成检索:把整个数据库交给它排序。但这样使用重排器的成本高得不可接受,无论是计算资源还是通过 API 产生的 Token 成本都是如此。这相当于每次查询时都让 AI 模型通读你的数据库。在实践中,重排器几乎总是与某种更高效的检索过程配合使用,例如嵌入,由后者选出候选匹配项,再交给重排器重新评估。
重排器大致分为三种类型:逐点式、逐对式和列表式。区别在于一次可以输入多少候选、模型需要运行多少次,以及能否获得可靠的排序。
类型 | 输入 | N 个候选的模型运行次数 | 排序是否一致? | 候选数量限制 | 示例 |
|---|---|---|---|---|---|
逐点式 | 查询和一个候选 | N,每个候选一次 | 是,候选按分数排序 | 任意数量 | jina-colbert-v2 |
逐对式 | 查询和两个候选 | N-1,每次比较两个 | 否,A 可胜 B,B 可胜 C,而 C 又胜 A | 任意数量 | PairReranker |
列表式 | 查询和完整候选池 | 1 | 是,模型返回排序 | 只要适配模型输入即可 | jina-reranker-v3.5 |
表 1:重排器类型比较。
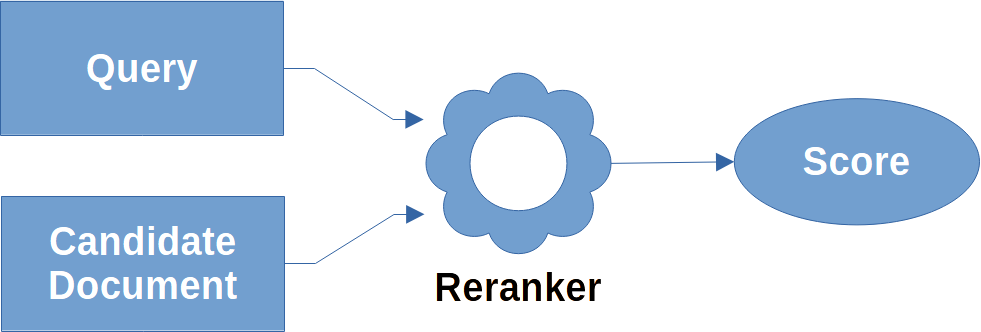
Pointwise reranker diagram: a query and one candidate document go in, a relevance score comes out
图 1:逐点式重排器。
逐点式重排器以查询和单个候选匹配项为输入,输出一个分数。多个检索候选随后按分数排序。它们允许你评估任意数量的候选,但每个候选都需要完整运行一次模型。当需要评估大量候选时,这种重排器最合适,例如没有高质量第一阶段检索时,或联邦搜索这类候选来自多个来源、而这些来源不会向你透露分数或排名的场景。当你能够把候选池有效限制在少量高概率最佳候选时,与替代方案相比,逐点式重排器相对昂贵。
jina-colbert-v2 是逐点式重排器的一个例子。它接收一个查询和一个文档对并返回分数;不过,最高效的用法是批量处理文档并返回每个文档的分数,这样查询就不必为每个文档单独重新编码。
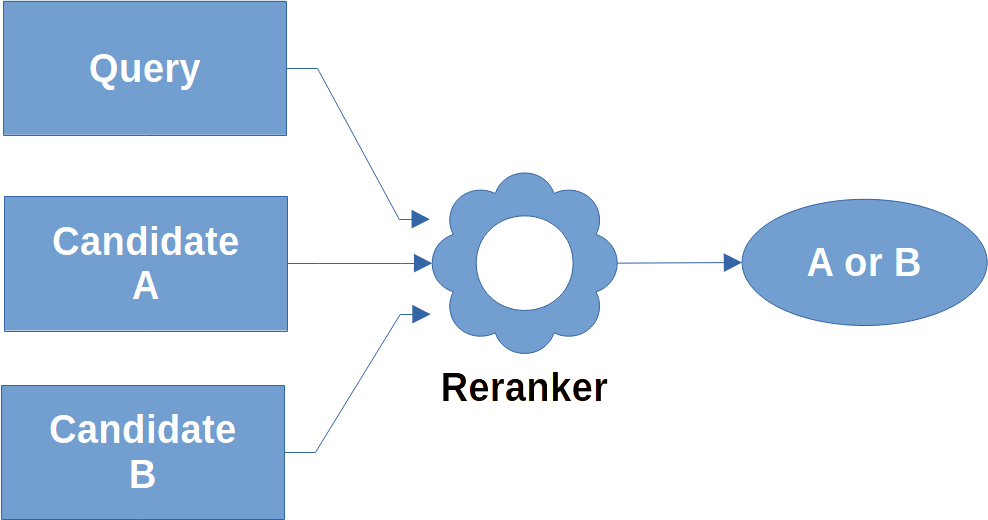
Pairwise reranker diagram: a query plus candidates A and B go in, the reranker returns the better match
图 2:逐对式重排器。
逐对式重排器接收一个查询和两个候选,并告诉你两者中哪个更匹配。你可以像淘汰赛一样两两比较,从而重排任意数量的候选。但这意味着,如果你有 N 个候选匹配项,就需要运行模型 N-1 次,几乎和逐点式重排器一样多。此外,它们不保证排序一致。如果根据重排器,候选 A 优于候选 B,候选 B 优于候选 C,那么候选 C 仍有可能被排在候选 A 之前。
PairReranker 是逐对式重排器的一个例子,设计用于对文本生成模型的候选输出进行排序。
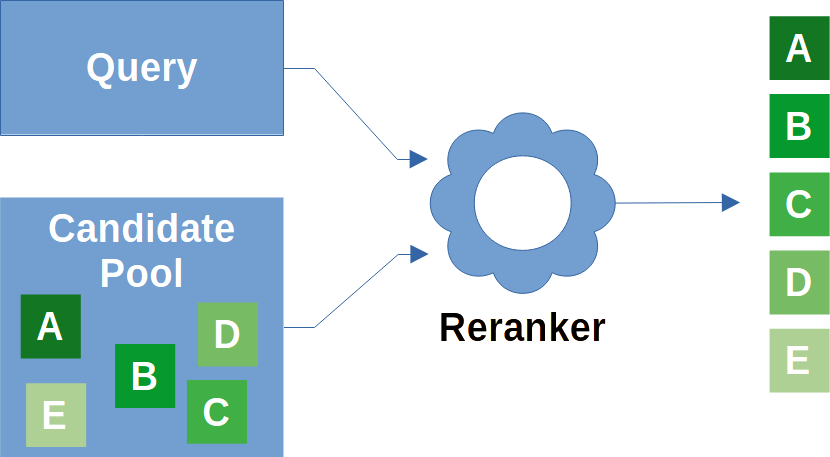
Listwise reranker diagram: a query and full candidate pool go in, ranked results A to E come out
图 3:列表式重排器。
列表式重排器接收一个查询和一组候选,并输出从最佳匹配到最差匹配的排序。它们只允许处理能放入模型输入长度的候选,而且通常比逐点式模型更大。不过,评估整个候选池只需要调用一次模型。
在正面比较中,列表式重排通常优于逐点式和逐对式重排,但它只能处理少量候选匹配项。在候选数量很大,或列表式重排器相对较大的资源需求成为问题时,逐点式和逐对式重排器可能是更好的方案。
本文中,我们使用 Elastic | Jina AI 最新的列表式重排器 jina-reranker-v3.5,考察两个变量:
- 列表式重排器的输出如何受初始检索步骤质量和候选池质量影响?
jina-reranker-v3.5需要多少个候选匹配项才能返回最优匹配?
事实证明,这两个变量并非完全独立。
重排如何改进 Elasticsearch BM25 搜索
BM25 是经典的文本信息检索算法。它不使用 AI 模型,但速度非常快、计算需求低,并且内置于 Elasticsearch。尽管近期 AI 驱动的搜索通常性能更优,BM25 仍被广泛使用,部分原因是它非常廉价且快速,部分原因是这个已有 30 多年历史的算法让许多用户习惯了搜索系统以 BM25 的方式运行。
我们使用来自四个广泛使用的基准套件的标准文本检索基准集合,评估 jina-reranker-v3.5 与使用 BM25 找到的检索候选结合时的表现:
- Benchmarking-IR(BEIR) 是经典的英文文本信息检索基准,使用广泛,包含来自不同领域的不同材料。我们使用了一个子集;需要承认,我们排除了最大的数据集,因为在其上运行测试会花费更多时间。
- CQADupStack 是一组问答数据集,主要与信息技术相关,来自 Stack Exchange 网站上的论坛。
- 代码信息检索基准(CoIR) 是一组代码检索数据集。我们只使用了该集合中的三个数据集,它们都相对较小,并且涉及自然语言查询或文档。
- BRIGHT 是一个被设计为对传统检索算法非常困难的数据集。其作者创建它是为了测试文本检索系统的推理能力,确保像 BM25 这样的词法检索方案和基于嵌入的语义检索难以找到匹配。大多数传统检索系统,包括语义搜索,在 BRIGHT 上得分都很差。我们特意选择这些数据集,是为了观察
jina-reranker-v3.5在极其困难的条件下是否能增加价值。
下表显示了每个数据集的检索分数,以 nDCG@10 衡量,分别使用 Elasticsearch 的 BM25 实现本身(Elastic Cloud 上的 Elasticsearch Serverless,英文分析器,默认 BM25 设置),以及在不同候选数量下使用重排器:10、20、50、100 和 200。我们的 BM25 基线配置为只检索 200 个候选,因此没有测试更大的候选列表。
数据集 | 仅 BM25 | RR @10 | RR @20 | RR @50 | RR @100 | RR @200 |
|---|---|---|---|---|---|---|
BEIR | ||||||
SciFact | 0.6836 | 0.7389 | 0.7583 | 0.7647 | 0.7607 | 0.7392 |
TREC-COVID | 0.6191 | 0.6533 | 0.7320 | 0.7994 | 0.8280 | 0.8191 |
Quora | 0.8066 | 0.8667 | 0.8857 | 0.8971 | 0.9007 | 0.8838 |
ArguAna | 0.4782 | 0.6645 | 0.7477 | 0.7889 | 0.8028 | 0.7786 |
Webis-Touche2020 | 0.3381 | 0.3394 | 0.3821 | 0.3407 | 0.3155 | 0.2534 |
NFCorpus | 0.3232 | 0.3397 | 0.3504 | 0.3535 | 0.3521 | 0.3375 |
FiQA | 0.2506 | 0.3240 | 0.3704 | 0.4208 | 0.4500 | 0.4313 |
SCIDOCS | 0.1547 | 0.1776 | 0.2024 | 0.2081 | 0.2150 | 0.1951 |
CQADupStack | ||||||
Gaming | 0.4876 | 0.5446 | 0.5767 | 0.6070 | 0.6274 | 0.6105 |
Android | 0.3932 | 0.4435 | 0.4724 | 0.5140 | 0.5279 | 0.4986 |
English | 0.3488 | 0.4021 | 0.4357 | 0.4683 | 0.4841 | 0.4697 |
Physics | 0.3488 | 0.4053 | 0.4357 | 0.4641 | 0.4873 | 0.4748 |
Webmasters | 0.3145 | 0.3546 | 0.3837 | 0.4103 | 0.4195 | 0.4049 |
Programmers | 0.2997 | 0.3488 | 0.3744 | 0.4169 | 0.4300 | 0.4139 |
GIS | 0.3055 | 0.3555 | 0.3923 | 0.4235 | 0.4412 | 0.4301 |
Unix | 0.2965 | 0.3428 | 0.3715 | 0.4085 | 0.4310 | 0.4152 |
Stats | 0.2926 | 0.3311 | 0.3541 | 0.3915 | 0.4016 | 0.3862 |
WordPress | 0.2728 | 0.3230 | 0.3490 | 0.3729 | 0.3864 | 0.3543 |
TeX | 0.2441 | 0.2715 | 0.2948 | 0.3205 | 0.3313 | 0.3112 |
Mathematica | 0.2140 | 0.2576 | 0.2923 | 0.3176 | 0.3367 | 0.3266 |
CoIR | ||||||
StackOverflow-QA | 0.6724 | 0.7431 | 0.7697 | 0.8100 | 0.8351 | 0.8560 |
CoSQA | 0.1714 | 0.1937 | 0.2283 | 0.2609 | 0.2828 | 0.2935 |
Apps | 0.0485 | 0.0701 | 0.0969 | 0.1354 | 0.1779 | 0.2399 |
BRIGHT | ||||||
LeetCode | 0.1439 | 0.1439 | 0.1498 | 0.1268 | 0.1226 | 0.1341 |
StackOverflow | 0.1405 | 0.1417 | 0.1492 | 0.1551 | 0.1674 | 0.1543 |
表 2:使用 _jina-reranker-v3.5_ 和不同候选池大小的 BM25 搜索。
使用 jina-reranker-v3.5 重排可以在每个基准上改进基础 BM25 分数,但对于列表式重排器,这取决于候选池大小。如果候选池太大,加入重排器有时反而会比完全不使用重排器更差。在表 2 中,可以看到 LeetCode 和 Webis-Touche2020 基准出现了这种情况。
如果我们使用逐点式或逐对式重排,这种情况就不会发生。无论给定多少候选,它们都会产生相同的排序。如果候选 A 优于候选 B,加入候选 C 永远不会改变这一点。但列表式重排器会一次性查看整个候选列表,当输入信息过多时,它们会受到注意力稀释和噪声累积的影响。AI 并非魔法。基于注意力的模型资源有限,当这些资源被摊薄时,表现就会变差。
从这里可以看到,给 jina-reranker-v3.5 200 个候选,结果比只给它前 100 个更差。只有三个 CoIR 基准在 200 个候选时得分高于更小的候选池。在某些情况下,只使用 50 个候选比 100 个得分更高。有两个基准在 20 个候选时达到峰值。
最优规模的差异凸显了部署 AI 时的一个重要考虑:无论在什么场景下,基准测试都只能非常间接地反映模型在你的数据、你的管道中的表现;因此,跟踪你为自身用例和数据所选择的 AI 模型的表现非常重要。
不过,如果我们观察 jina-reranker-v3.5 在不同基准上降低了多少错误,确实可以大致了解可以预期什么样的结果:
重排候选数量 | 10 | 20 | 50 | 100 | 200 |
|---|---|---|---|---|---|
所有数据集上的平均误差降低 | 0.0878 | 0.1433 | 0.1875 | 0.2097 | 0.1873 |
表 3:BM25 在不同候选池大小下的误差降低。
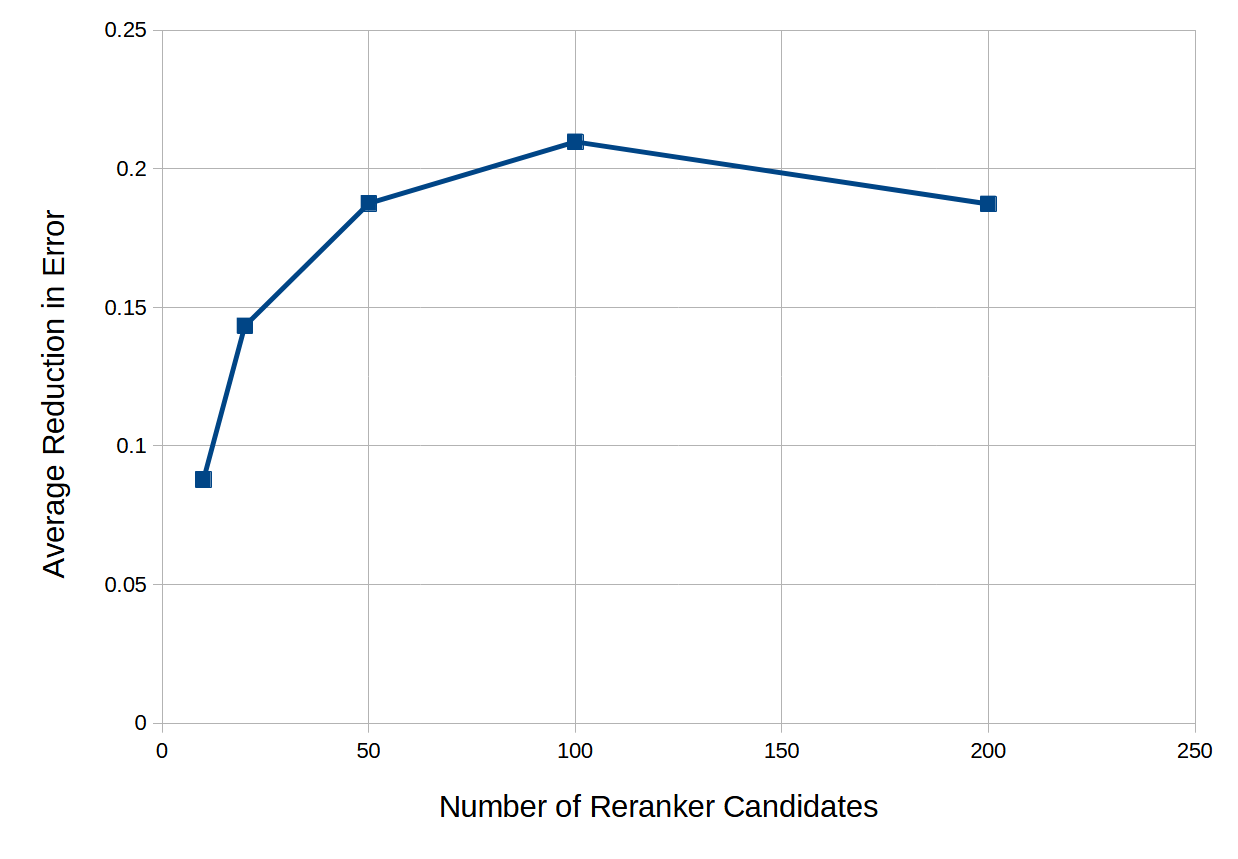
Line chart of jina-reranker-v3.5 with BM25: error reduction peaks at 100 candidates and drops at 200
图 4:BM25 配合重排时,各基准上的平均误差降低与候选池大小的关系。
可以看到,在这个场景中,使用 Elasticsearch BM25 时,性能在 100 个候选左右达到峰值;但使用 50 个候选只会略微增加误差(按 nDCG@10 约为 2%)。将发送给重排器的候选数量减半,可以把 Token 数量减半,从而将成本降低 50% 并减少延迟。在 25 个基准中,只有两个基准在候选池从 100 缩小到 50 时误差增加超过 10%:BEIR TREC-COVID 和 CoIR StackOverflow-QA。在这两个案例中,原因都是 50 个候选时的错误率已经非常低。
这些测试表明,使用 jina-reranker-v3.5 配合 Elasticsearch 的 BM25 实现时,最划算的选择是只使用 50 个候选。
重排与语义向量搜索结合时表现如何
但如果我们有更好的初始搜索方案呢?这些发现是否适用于使用 AI 生成嵌入的语义搜索?
TL;DR:不适用。
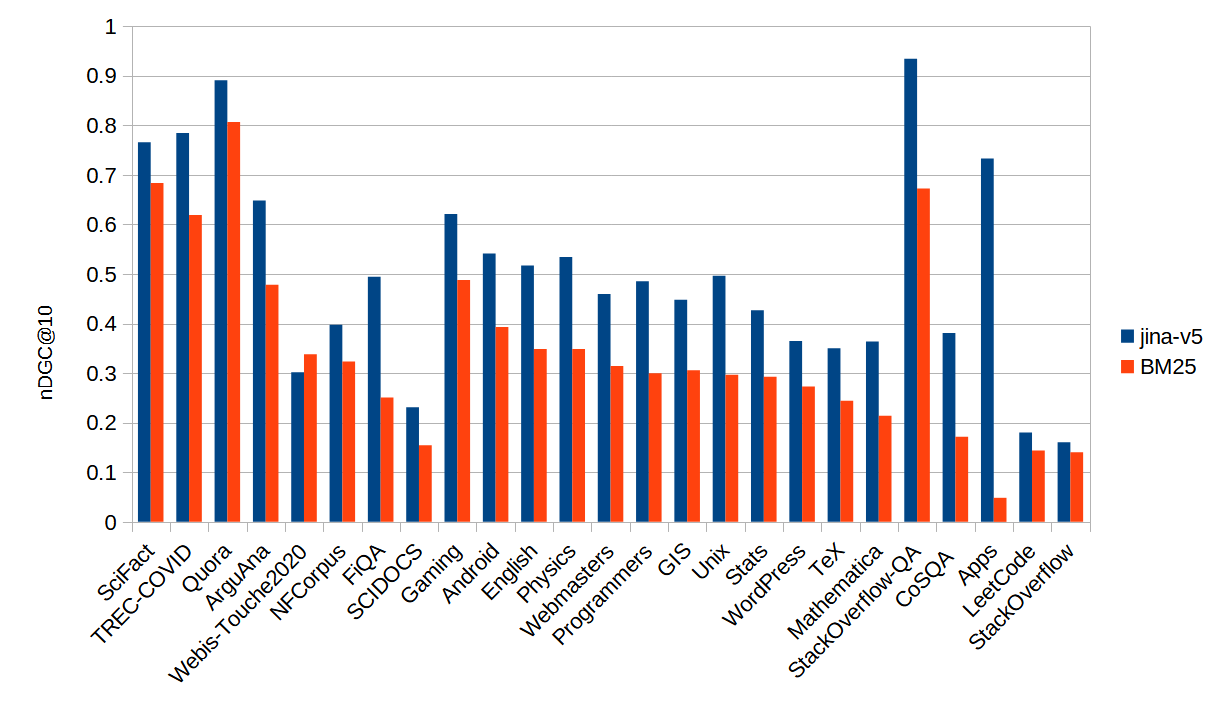
我们使用 jina-embeddings-v5-text-small 嵌入和向量搜索代替 BM25,而不是 BM25。首先,使用该模型的语义搜索产生的结果明显优于 BM25,在所选基准上平均将错误率降低了 25.7%。在一个基准上,Jina 的语义搜索异常地表现更差,但差距并不大:
Bar chart comparing nDCG@10 for jina-embeddings-v5-text-small and Elasticsearch BM25 on 25 benchmarks
图 5:BM25 与 jina-embeddings-v5-text-small 在各基准上的比较。
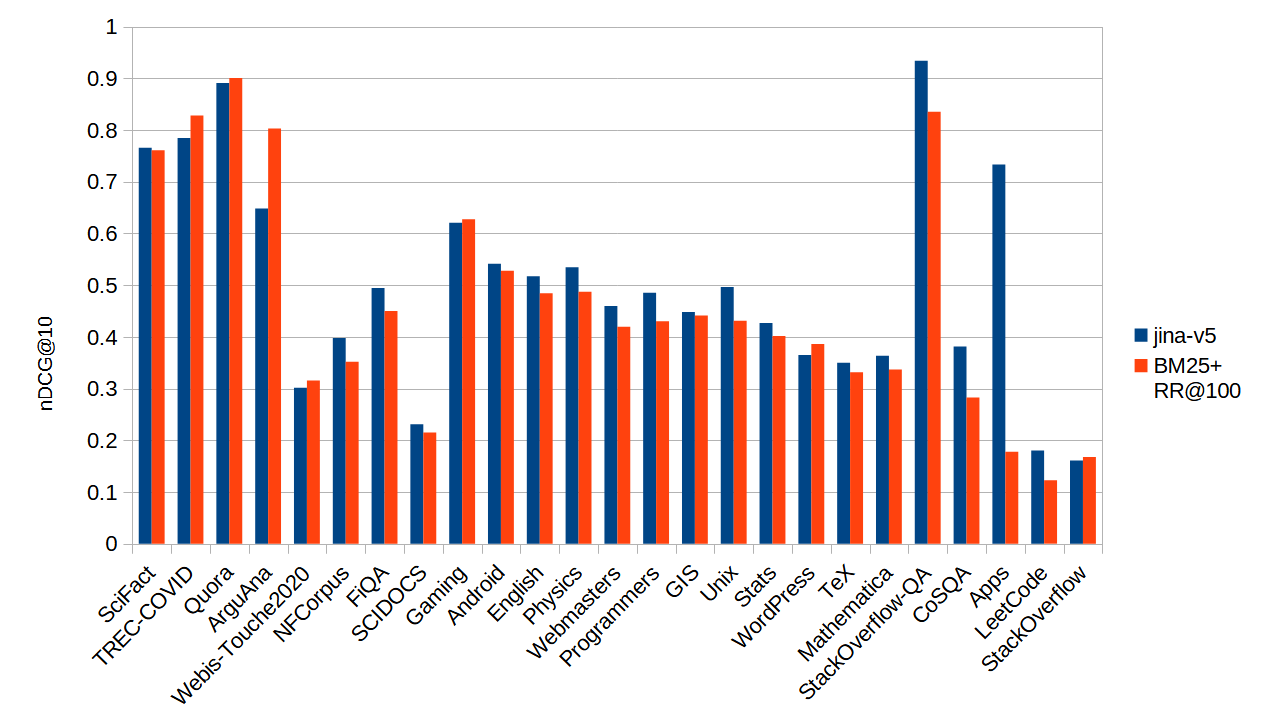
然而,在 100 个候选下使用 jina-reranker-v3.5,可以将 BM25 的分数提升到与 Jina 最佳语义检索相当的水平:
Bar chart: BM25 with jina-reranker-v3.5 at 100 candidates vs jina-embeddings-v5-text-small nDCG@10
图 6:BM25 配合 jina-reranker-v3.5 (100 个候选),与 jina-embeddings-v5-text-small 单独使用在各基准上的比较。
总体而言,jina-embeddings-v5-text-small 在这些检索基准上表现更好,但差距要小得多。在这些基准上,与 BM25 配合 jina-reranker-v3.5 相比,jina-embeddings-v5-text-small 平均将错误率降低了 4.2%。在一半的 BEIR 基准上,配合重排的 BM25 实际上击败了语义搜索。
但是,如果一个优秀的列表式重排器能让质量较低的检索接近前沿的基于嵌入的语义检索,那么当我们一开始就使用最佳检索时,它还能增加多少价值?
我们使用 jina-embeddings-v5-text-small 的语义搜索重复了测试,候选池大小相同:10、20、50、100 和 200。结果如下:
数据集 | 仅 v5-text | RR @10 | RR @20 | RR @50 | RR @100 | RR @200 |
|---|---|---|---|---|---|---|
BEIR | ||||||
SciFact | 0.7655 | 0.7935 | 0.7895 | 0.7795 | 0.7768 | 0.7541 |
TREC-COVID | 0.7846 | 0.8223 | 0.8355 | 0.8583 | 0.8642 | 0.8053 |
Quora | 0.8909 | 0.9024 | 0.9067 | 0.9068 | 0.9063 | 0.9013 |
ArguAna | 0.6485 | 0.7819 | 0.8111 | 0.8173 | 0.8183 | 0.8007 |
Webis-Touche2020 | 0.3015 | 0.3151 | 0.3293 | 0.3234 | 0.3247 | 0.2903 |
NFCorpus | 0.3978 | 0.4033 | 0.4001 | 0.3976 | 0.3841 | 0.3364 |
FiQA | 0.4946 | 0.5145 | 0.5205 | 0.5182 | 0.5103 | 0.4496 |
SCIDOCS | 0.2310 | 0.2415 | 0.2517 | 0.2393 | 0.2267 | 0.1826 |
CQADupStack | ||||||
Gaming | 0.6209 | 0.6536 | 0.6676 | 0.6604 | 0.6536 | 0.6048 |
Android | 0.5412 | 0.5627 | 0.5782 | 0.5713 | 0.5596 | 0.5157 |
English | 0.5171 | 0.5418 | 0.5533 | 0.5534 | 0.5490 | 0.5072 |
Physics | 0.5344 | 0.5407 | 0.5404 | 0.5395 | 0.5293 | 0.4923 |
Webmasters | 0.4595 | 0.4660 | 0.4763 | 0.4675 | 0.4621 | 0.4124 |
Programmers | 0.4851 | 0.5017 | 0.5005 | 0.4911 | 0.4795 | 0.4260 |
GIS | 0.4480 | 0.4745 | 0.4846 | 0.4873 | 0.4850 | 0.4325 |
Unix | 0.4964 | 0.5055 | 0.5200 | 0.5052 | 0.4923 | 0.4455 |
Stats | 0.4266 | 0.4377 | 0.4492 | 0.4514 | 0.4432 | 0.4046 |
WordPress | 0.3647 | 0.3890 | 0.4112 | 0.4147 | 0.4169 | 0.3695 |
TeX | 0.3500 | 0.3707 | 0.3786 | 0.3767 | 0.3687 | 0.3242 |
Mathematica | 0.3636 | 0.3770 | 0.3891 | 0.3732 | 0.3659 | 0.3244 |
CoIR | ||||||
StackOverflow-QA | 0.9341 | 0.9486 | 0.9470 | 0.9437 | 0.9414 | 0.9322 |
CoSQA* | 0.3812 | 0.3687 | 0.3782 | 0.3725 | 0.3628 | 0.3403 |
Apps | 0.7332 | 0.7823 | 0.7897 | 0.7823 | 0.7695 | 0.7355 |
BRIGHT | ||||||
LeetCode | 0.1803 | 0.1689 | 0.1546 | 0.1232 | 0.1141 | 0.0878 |
StackOverflow | 0.1606 | 0.1631 | 0.1754 | 0.1665 | 0.1432 | 0.1327 |
* CoSQA 分数在不同运行之间约有 0.01 的波动。表 4:使用 _jina-embeddings-v5-text-small_ 的语义向量搜索,结合 _jina-reranker-v3.5_ 和不同候选池大小。
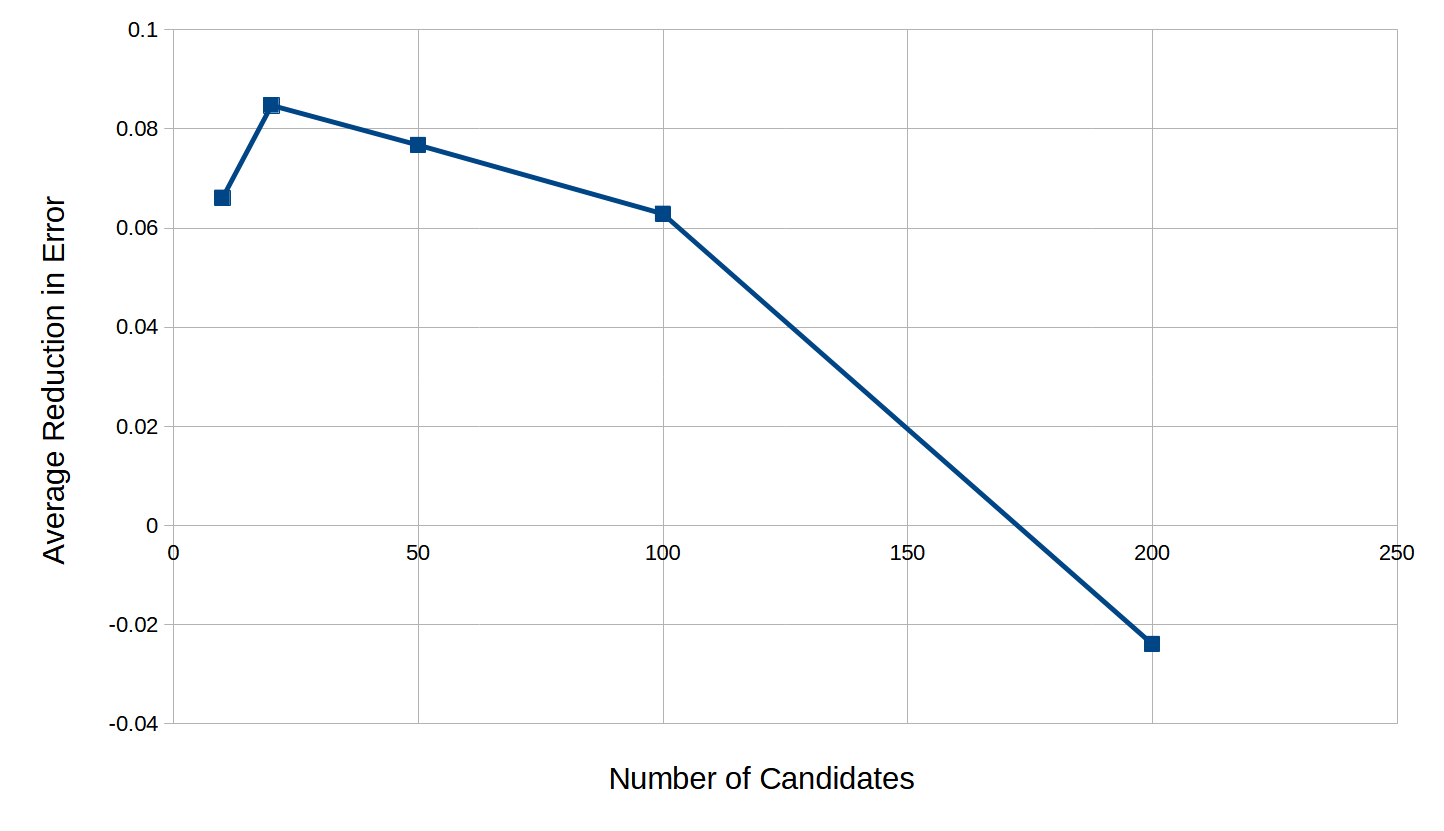
更好的第一阶段检索会改变最优候选池大小。平均而言,它明显更小,而且最优候选池大小在不同基准之间的分布要分散得多。使用 200 个候选时,平均结果实际上比完全不使用重排器还差。对于两个基准,BRIGHT LeetCode 和 CoIR CoSQA,重排在所有候选池大小下的得分都低于单独使用检索器。
重排候选数量 | 10 | 20 | 50 | 100 | 200 |
|---|---|---|---|---|---|
所有数据集上的平均误差降低 | 0.0661 | 0.0848 | 0.0767 | 0.0629 | -0.0239 |
表 5:语义向量搜索在不同候选池大小下的误差降低。
Line chart: semantic search reranking peaks at 20 candidates and turns negative at 200 candidates
图 7:语义向量搜索配合重排时,各基准上的平均误差降低与候选池大小的关系。
与 jina-embeddings-v5-text-small 配合使用时,20 个候选的重排使性能最大化,而 BM25 则是 100 个。这表明,使用更好的策略来获得初始候选池,可以降低之后使用重排器的成本。然而,使用更好的初始搜索系统也会降低重排器的附加价值。对 BM25 找到的最佳 100 个候选进行重排,平均将错误率降低了 20% 以上。对 jina-embeddings-v5-text-small 的最佳 20 个候选(表现最好的候选池大小)进行重排,平均仅将错误率降低了约 8.5%。
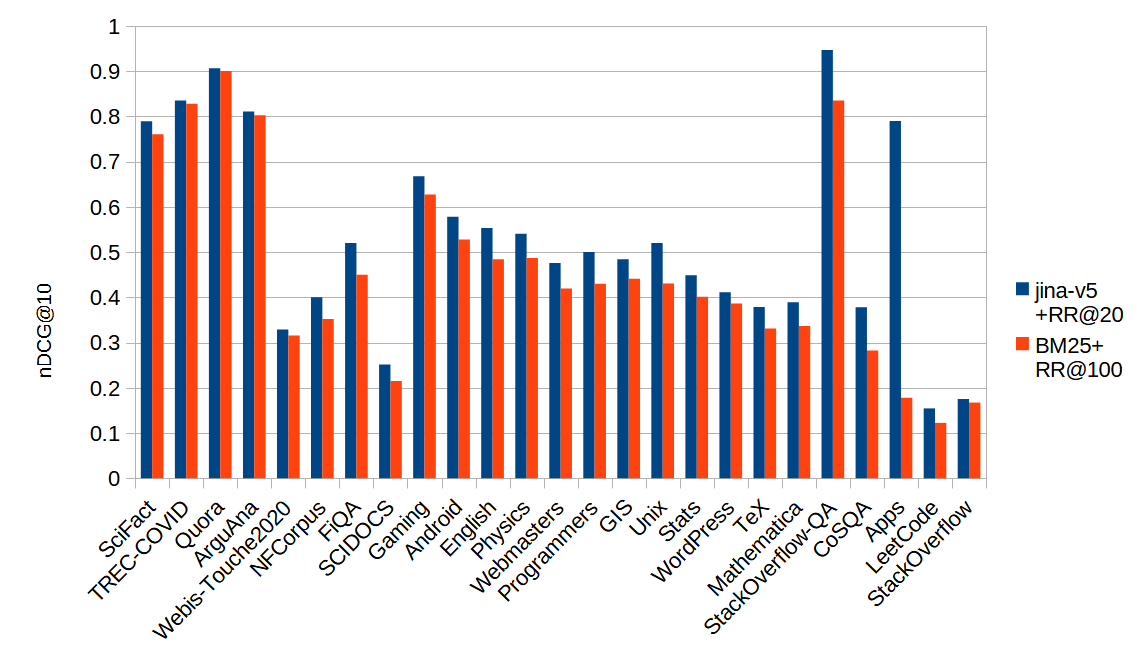
如果我们比较 BM25 配合 jina-reranker-v3.5 与 jina-embeddings-v5-text-small 配合 jina-reranker-v3.5,语义搜索与智能重排器的组合在每个基准上都得分更高。
Bar chart: semantic search reranked at 20 candidates vs BM25 reranked at 100 candidates, nDCG@10
图 8:使用 jina-embeddings-v5-text-small 和 jina-reranker-v3.5 (20 个候选)的语义向量搜索,与 Elasticsearch BM25 配合重排(100 个候选)在各基准上的比较。
然而,差距比你想象的要小。与 BM25 配合 jina-reranker-v3.5 相比,使用 jina-embeddings-v5-text-small 配合 jina-reranker-v3.5 平均将错误率降低了 13.26%。这大约是不使用重排器时比较 jina-embeddings-v5-text-small 与 BM25 所获得误差降低的一半。
调整列表式重排器时哪些因素重要
本文中,我们使用了一个高性能的列表式重排器。这里的部分计算可能并不完全适用于其他重排器。然而,列表式重排器总体上会遇到与本文所述类似的问题。我们在这里并没有做到科学上的严谨,但可以从这些结果中提炼出一些部署列表式重排器的通用原则:
应该向重排器发送多少个候选?
结果会因发送给重排器的候选数量不同而存在显著差异。我们只测试了固定数量的策略。根据你从初始搜索中检索到的信息,也许能够判断有多少候选值得发送给重排器。BM25 和基于语义嵌入的搜索都会在返回结果时附带分数。可能存在某种策略,例如分数阈值,能够改进重排器性能。我们没有测试这种可能性。
但我们确实明确发现,你可以给重排器过多的候选。更多并不总是更好,往往更糟。
初始搜索越好,重排器增加的价值越少
这个结果在我们的预期之内。当检索系统犯的错误更少时,重排能够改进的空间就更小。但现在我们有一些实证证据来支持这一点。我们还表明,一个好的重排器可以在相对较差的初始搜索基础上改进到足以与高性能语义搜索竞争。在许多实际用例中,这是一个重要的结果。特别是 BM25,它非常廉价、高效、快速,并且深深植根于信息检索领域,而 Elasticsearch 包含一个增强的 BM25 实现,本身已经是一个非常强大的检索系统。将 jina-reranker-v3.5 添加到 BM25 管道,可能比围绕语义搜索重新设计整个检索过程更容易。
初始搜索越差,候选池需要越大
两个数据点并不足以得出定论,但我们测试中最优候选池大小之间的差距(BM25 为 100,jina-embeddings-v5-text-small 为 20)具有提示意义。这意味着,使用 BM25 配合重排器相比使用语义搜索在计算、延迟或成本上可能节省的部分,会被必须向重排器传递大得多的候选池所带来的成本增加所部分抵消。
重排结果在不同数据集之间的差异有多大?
重排的影响和最优候选池大小在不同基准之间可能差异很大,这意味着它们在不同实际用例之间的差异至少同样大。我们鼓励你用自己的数据进行测试,并尝试自行优化管道,因为没有任何一组基准与你的管道完全相同。jina-reranker-v3.5 和 jina-embeddings-v5-text-small 均可通过 Elastic Inference Service(EIS)在 Elasticsearch 中使用。你可以注册一个免费 Elastic Cloud 实例,试用 14 天,亲自体验。
如何将 jina-reranker-v3.5 添加到你的 Elasticsearch 管道
你无需自行托管任何模型,就可以在自己的数据上验证所有这些发现。使用 Elastic Cloud 意味着 Elastic 托管一切,并管理整个搜索管道和 AI 技术栈。
如果你已经在 Elasticsearch 中使用 BM25 搜索,无需重新索引任何内容即可添加 jina-reranker-v3.5:
- 为重排器创建一个 Elastic Inference API 端点。
- 在现有查询中添加一个
text_similarity_reranker检索器。 - 将
rank_window_size设置为 100。该参数控制有多少候选进入重排器,这正是我们在此测试的变量。 - 将
rank_window_size设置为 50 重新运行,并比较结果。在我们的测试中,更小的候选池只损失很少的准确率,却能将 Token 数量减半。
如果你使用语义向量搜索,设置方式会改变,起点也会改变:
- 使用
semantic_text字段,通过jina-embeddings-v5-text-small为数据建立索引。 - 添加一个使用
jina-reranker-v3.5的text_similarity_reranker检索器。 - 将
rank_window_size设置为 20,而不是 100。更好的初始检索需要小得多的候选池,对于某些数据,最佳大小还会更小。 - 不要假设更多候选会有帮助。我们发现,对 200 个语义搜索候选进行重排,平均结果比完全不重排还差。
有关将 jina-reranker-v3.5 与现有 Elastic 搜索管道配合使用的更多信息,请参阅 Elasticsearch 文本重排文档。
jina-embeddings-v5-text-small 和 jina-reranker-v3.5 也可通过 Jina API 获取,并提供免费 Token 供试用;同时还提供 Jina 本地部署容器,可在你自己的硬件上运行。两者的权重均发布在 Hugging Face 上,可在非商业许可下用于测试和研究。如需商业使用,请联系 Elastic 销售团队。
你的管道的最佳候选池大小取决于你的数据,因此请实际测量,而不是相信任何默认值,包括我们给出的默认值。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号