免训练、零标注,凭什么拿下 CVPR 2026 工业视觉王座?
原创
免训练、零标注,凭什么拿下 CVPR 2026 工业视觉王座?
原创
AI小怪兽
发布于 2026-11-17 16:15:25
发布于 2026-11-17 16:15:25
论文解读 | SuperADD:免训练、类别无关,DINOv3 记忆库把工业异常分割做到 SOTA
论文:SuperADD: Training-free Class-agnostic Anomaly Segmentation -- CVPR 2026 VAND 4.0 Workshop Challenge Industrial Track
题目译名:《SuperADD:免训练、类别无关的异常分割——CVPR 2026 VAND 4.0 研讨会挑战赛工业赛道》
作者:Lukas Roming、Felix Lehnerer、Jonas V. Funk、Andreas Michel、Georg Maier、Thomas Längle、Jürgen Beyerer(¹Fraunhofer IOSB 弗劳恩霍夫光电系统研究所;²Independent Research 独立研究)
期刊/会议:CVPR 2026 VAND 4.0 Workshop Challenge 工业赛道技术报告
DOI:10.48550/arXiv.2605.14808 |
博主简介
AI小怪兽 | 计算机视觉布道者 | 视觉检测领域创新者
深耕计算机视觉与深度学习领域,专注于目标检测前沿技术的探索与突破。长期致力于YOLO系列算法的结构性创新、性能极限优化与工业级落地实践,旨在打通从学术研究到产业应用的最后一公里。
🚀 核心专长与技术创新
- YOLO算法结构性创新:于CSDN平台原创发布《YOLO26魔术师》、《YOLO11魔术师》等全系列深度专栏。系统性提出并开源了多项原创自研模块,在模型轻量化设计、多维度注意力机制融合、特征金字塔重构等关键方向完成了一系列突破性实践,为行业提供了具备高参考价值的技术路径与完整解决方案。
- 技术生态建设与知识传播:独立运营 “计算机视觉大作战” 公众号(粉丝2.3万),成功构建高质量的技术交流社群。致力于将复杂算法转化为通俗易懂的解读与可复现的工程代码,显著降低了计算机视觉的技术入门门槛。
🏆 行业影响力与商业实践
- 荣获腾讯云年度影响力作者与创作之星奖项,内容质量与专业性获行业权威平台认证。
- 全网累计拥有 8万+ 垂直领域技术受众,专栏文章总阅读量突破百万,在目标检测领域形成了广泛的学术与工业影响力。
- 具备丰富的企业级项目交付经验,曾为工业视觉检测、智慧城市安防等多个关键领域提供定制化的算法模型与解决方案,驱动业务智能化升级。
💡 未来方向与使命
秉持 “让每一行代码都有温度” 的技术理念,未来将持续聚焦于实时检测、语义分割及工业缺陷检测的商业化闭环等核心方向。愿与业界同仁协同创新,共同推动技术边界,以坚实的技术能力赋能实体经济与行业变革。
一、摘要
工业视觉检测中的异常检测(Anomaly Detection, AD)在现代生产环境里是刚需。当训练数据与部署数据因生产采集条件变化而不同,问题会变得格外棘手。在 VAND 4.0 工业赛道中,模型必须在光照变化等分布偏移下保持鲁棒,并在 MVTec AD 2 数据集上接受评估。
为此,作者基于 SuperAD 提出了一条免训练(training-free)、类别无关(class-agnostic)的异常检测流水线,并通过多项改进增强分布偏移下的泛化能力:采用 DINOv3 骨干、重叠式分块处理、基于强度的增强、更优的记忆库子采样(更好覆盖数据分布),以及迭代形态学闭运算(得到更干净、空间更一致的异常图)。与依赖类别专属架构或逐类调参的方法不同,本文用一套架构、一套共享超参搞定所有物体类别——非常适合「产品型号和外观频繁变化、适配成本要压到最低」的工业部署。
最终在 MVTec AD 2 的公开 / 私有 / 私有混合测试集上分别取得 62.61% / 57.42% / 54.35% 的分割 F1 分数,超越 SuperAD 及其他 SOTA 方法。代码已开源。
二、研究背景和意义
1. 工业异常检测:一个「正常样本管够、缺陷几乎见不到」的先天难题
工业产线的现实是:你手里有成千上万张正常品图像,但缺陷样本稀少、种类繁杂、且随时可能出现没见过的新缺陷。所以主流方案走无监督异常检测——只用正常数据建模「正常长什么样」,测试时偏离正常分布的就判为异常。这就带来一个绕不开的痛点:模型对采集条件(尤其是光照)极度敏感,光照一变、外观一 shift,误报就上来。
2. 现有方法的瓶颈
- 重构类方法的训练依赖:去年 VAND 3.0 的强方法(ISVL、RoBiS)大多基于 INP-Former,需要训练 ViT 提取正常原型并做重构——一旦换新产线、换产品,就得重训,适配慢。
- 类别专属原罪:不少方法靠「每个类别一套架构 / 一套超参」刷分,看着精度高,工业落地时要维护 N 套配置,运维噩梦。
- 记忆库类方法的效率与表示短板:SuperAD / PatchCore 这类免训练方法用 DINOv2 提特征建记忆库,但 SuperAD 只从 class token 选 16 张图建库——图像级多样性有了,同一张图里或不同图之间的近重复特征向量却没清掉,同质背景、多个低变化实例都会往库里塞冗余原型。
- MVTec AD 原 benchmark 已饱和:SOTA 分数高到拉不开差距,逼着社区转向更难的 MVTec AD 2(8 个真实类别、采集光照多变、私有集无公开真值)。
3. 研究意义
本文的价值在于:不训练、不逐类调参,靠「更强的基座 + 更聪明的记忆库 + 更稳的后处理」就把泛化性和精度同时顶上去。对工业部署而言,这是一条「新产品上来只需跑一遍正常图建库、无需训练」的低成本通路;对学术界而言,它证明了「视觉基础模型的冻结特征 + 免训练检索」这条路线在更难的 distribution shift 场景下依然有很强生命力。
三、创新点
伪代码如下:
# SuperADD 核心算法(整合自 anomalib/models/image/super_add/torch_model.py)
# 论文: SuperADD: Training-free Class-agnostic Anomaly Segmentation
# CVPR 2026 VAND 4.0 Workshop Challenge Industrial Track
# 仓库: https://github.com/LukasRoom/SuperADD

import gc
import itertools
import math
from collections import defaultdict

import timm
import torch
import torch.nn as nn
import torch.nn.functional as F
from tqdm import tqdm

DEFAULT_CHUNK_SIZE = 1024

DINO_TARGET_LAYERS = {
    "small": [3, 5, 8, 10],
    "base":  [3, 5, 8, 10],
    "large": [5, 11, 17, 23],
    "huge":  [7, 15, 23, 31],
}


class DinoV3Backbone(nn.Module):
    """DINOv3 中间层特征提取器,封装 timm 模型并返回指定 transformer 块的 token 特征。"""

    def __init__(self, backbone: str, layers: list[int]) -> None:
        super().__init__()
        self.dino = timm.create_model(backbone, pretrained=True, num_classes=0).eval()
        self.layers = layers
        self.model_patch_size = self.dino.patch_embed.patch_size[0]

    def forward(self, x: torch.Tensor) -> list[torch.Tensor]:
        """输入 (b,c,h,w),返回指定层的特征列表,每项形状为 (b, tokens, channels)。"""
        with torch.inference_mode():
            return self.dino.forward_intermediates(
                x,
                indices=self.layers,
                norm=False,
                output_fmt="NLC",
                intermediates_only=True,
            )


class PatchedExecution(nn.Module):
    """重叠分块推理:将大图切为重叠 patch,逐块过骨干网络,再按中心对齐拼接,避免边界伪影。"""

    def __init__(self, model: nn.Module, patch_size: int, patch_overlap: int,
                 model_patch_size: int) -> None:
        super().__init__()
        assert patch_overlap > 0
        assert patch_size > 2 * patch_overlap
        assert patch_size % model_patch_size == 0
        assert patch_overlap % model_patch_size == 0
        self.patch_size = patch_size
        self.patch_overlap = patch_overlap
        self.model_patch_size = model_patch_size
        self.model = model

    def axis_patch_split(self, dim_size: int) -> tuple[list, list, list]:
        """沿单轴计算分块布局,返回像素级输入 ROI、token 级保留 ROI 和拼接结果 ROI。"""
        assert dim_size >= self.patch_size
        dim_size_t = dim_size // self.model_patch_size
        overlap_t = self.patch_overlap // self.model_patch_size
        patch_size_t = self.patch_size // self.model_patch_size
        n_patches = math.ceil((dim_size_t - patch_size_t) / (patch_size_t - 2 * overlap_t)) + 1
        fac = dim_size_t - patch_size_t
        div = max(1, n_patches - 1)

        input_rois = []
        for i in range(n_patches):
            patch_min = (i * fac) // div
            patch_max = patch_min + patch_size_t
            input_rois.append((patch_min, patch_max))

        prediction_rois = []
        for i in range(n_patches):
            start = 0 if i == 0 else math.ceil((input_rois[i - 1][1] - input_rois[i][0]) / 2)
            end = (patch_size_t if i == n_patches - 1
                   else patch_size_t - math.floor((input_rois[i][1] - input_rois[i + 1][0]) / 2))
            prediction_rois.append((start, end))

        result_rois = [(0, prediction_rois[0][1] - prediction_rois[0][0])]
        for i in range(1, n_patches):
            start = result_rois[i - 1][1]
            end = start + prediction_rois[i][1] - prediction_rois[i][0]
            result_rois.append((start, end))

        input_rois = [(s * self.model_patch_size, e * self.model_patch_size)
                      for (s, e) in input_rois]
        return input_rois, prediction_rois, result_rois

    def forward(self, x: torch.Tensor) -> list:
        """对输入图像执行重叠分块推理,返回逐层的拼接后 token 图。"""
        # 实际实现中会调用 axis_patch_split 并循环处理各 patch,此处省略完整循环体,
        # 核心逻辑是:切 patch → 批处理过骨干 → 按 prediction_rois 保留中心区域 → 写入 result_rois。
        # 具体拼接代码较长,可参考原仓库 torch_model.py 第 80-107 行。
        raise NotImplementedError("完整前向传播请参考原实现,此处保留结构定义。")


class SuperADDModel(nn.Module):
    """SuperADD 核心 PyTorch 模型:训练阶段构建内存库,推理阶段做最近邻搜索。"""

    def __init__(
        self,
        backbone: str = "vit_huge_plus_patch16_dinov3",
        layers: list[int] | None = None,
        patch_size: int = 448,
        patch_overlap: int = 16,
        max_database_size: int = 100_000,
        subsampling_iterations: int = 100,
        gaussian_blur_sigma: float = 4.0,
        score_quantile: float = 1e-3,
    ):
        super().__init__()
        self.layers = layers or DINO_TARGET_LAYERS["huge"]
        self.backbone = DinoV3Backbone(backbone, self.layers)
        self.patch_exec = PatchedExecution(
            self.backbone, patch_size, patch_overlap, self.backbone.model_patch_size
        )
        self.max_database_size = max_database_size
        self.subsampling_iterations = subsampling_iterations
        self.score_quantile = score_quantile
        self.blur = nn.Identity() if gaussian_blur_sigma <= 0 else None  # 实际为 GaussianBlur2d
        self.memory_bank: list[torch.Tensor] = []
        self.embedding_store: dict[int, list[torch.Tensor]] = defaultdict(list)

    # ---------- 训练阶段:特征收集 + 子采样 ----------
    def subsample_features(self, x: torch.Tensor, target_number_of_samples: int,
                           knn_neighbors: int = 3, normalize: bool = True) -> torch.Tensor:
        """基于最近邻密度的概率子采样,返回布尔保留掩码。"""
        device = x.device
        x = x.to(device)
        knn_neighbors = min(knn_neighbors, len(x))
        dists, _ = self.nearest_neighbors(x, x, knn_neighbors=knn_neighbors, normalize=normalize)

        target_distance = dists.float().mean() / 10
        n_samples = target_number_of_samples + 1
        random_numbers = torch.rand(len(x), device=device)
        keep_mask = torch.zeros(len(x), dtype=torch.bool, device=device)

        while n_samples > target_number_of_samples:
            subsampling_factor = (dists < target_distance).sum(dim=-1) + 1
            keep_mask = random_numbers < (1.0 / subsampling_factor.float())
            n_samples = int(keep_mask.sum())
            target_distance *= 1.1  # 逐步放宽阈值

        return keep_mask.cpu()

    # ---------- 推理阶段:最近邻搜索 ----------
    def nearest_neighbors(self, query: torch.Tensor, keys: torch.Tensor,
                          knn_neighbors: int = 1, normalize: bool = True):
        """分块计算查询向量与内存库的最近邻距离,避免显存爆炸。"""
        if normalize:
            query = F.normalize(query, dim=-1)
            keys = F.normalize(keys, dim=-1)
        # 实际实现按 chunk 计算距离,此处返回占位符
        raise NotImplementedError("完整分块最近邻请参考原实现 nearest_neighbors_chunked。")

    def forward(self, input_tensor: torch.Tensor) -> dict:
        """推理:提取特征 → 最近邻匹配 → 生成异常图与图像级分数。"""
        predicted_embeddings = self.patch_exec(input_tensor)
        layer_distances = []

        for layer_idx, emb in enumerate(predicted_embeddings):
            b, h, w, c = emb.shape
            query = emb.reshape(b, h * w, c)
            keys = self.memory_bank[layer_idx]
            dists, _ = self.nearest_neighbors_chunked(query, keys, knn_neighbors=1)
            dists = dists.mean(dim=-1).reshape(b, h, w) / c
            layer_distances.append(dists)

        layer_distances = torch.stack(layer_distances, dim=1)
        layer_distances = F.interpolate(
            layer_distances, size=(input_tensor.shape[-2], input_tensor.shape[-1]),
            mode="bilinear", align_corners=False,
        )
        anomaly_map = layer_distances.mean(dim=1, keepdim=True)

        if self.blur is not None:
            anomaly_map = self.blur(anomaly_map)

        anomaly_map = anomaly_map.squeeze(1)
        pixel_scores = anomaly_map.flatten(start_dim=1)
        top_k = max(1, int(pixel_scores.shape[1] * self.score_quantile))
        pred_score = pixel_scores.topk(top_k, dim=1).values.mean(dim=1)

return {"pred_score": pred_score, "anomaly_map": anomaly_map}- DINOv3 骨干替换:用 DINOv3-ViT-H+/16(32 层、约 8.4 亿参数)替代 DINOv2,取第 7、15、23、31 层输出建多层记忆库,借更强预训练表示提泛化。
- 重叠式分块推理(Overlapping Patches):把图切成 640×640、最小重叠 128 的块做推理,降低位置敏感性和块边缘伪影,且块边界对齐图像边缘、无需 padding。
- 强度增强(Intensity Augmentation):训练图归一化后用 [0.8, 1.2] 区间的随机因子缩放像素值,模拟不同积分时间 / 光照,专门对抗光照分布偏移。
- 特征空间记忆库子采样:不再按图像选 16 张,而是在特征向量上做 k 近邻(k=100)子采样——按「近邻里距离小于全局阈值的个数」给每个向量打分,优先留下稀疏区(信息量大)的原型。
- 迭代多方向形态学闭运算:对阈值化后的二值图做 16 次、半径 26 像素、0°~180° 均匀方向的线形结构元素闭运算,结果逐像素 OR 合并,把断裂的线状缺陷接起来。
- 类别无关 + 训练无关的统一配置:所有类别共用一套架构和超参;阈值只从训练数据的异常图 95 分位数自动推得(再乘 1.3~1.5 增益),不碰测试集真值,符合 VAND 4.0 规则。
四、创新点解读
4.1 整体架构:冻结 DINOv3 + 多层记忆库 + 最近邻检索
先把主线捋清楚。本文继承 SuperAD / PatchCore 的范式:用强大的视觉特征提取器在多个中间层建记忆库,推理时做最近邻离群检测。区别在于把骨干换成 DINOv3、把分块和子采样做了升级。
下图是方法总览:测试图和训练图都先切成重叠块,分别送进冻结的 DINOv3,从第 7/15/23/31 层抽 embedding;训练侧把正常图的embedding 建成原型记忆库,测试侧算每个测试 embedding 到最近邻原型的距离,多层距离图取平均,输出异常图。
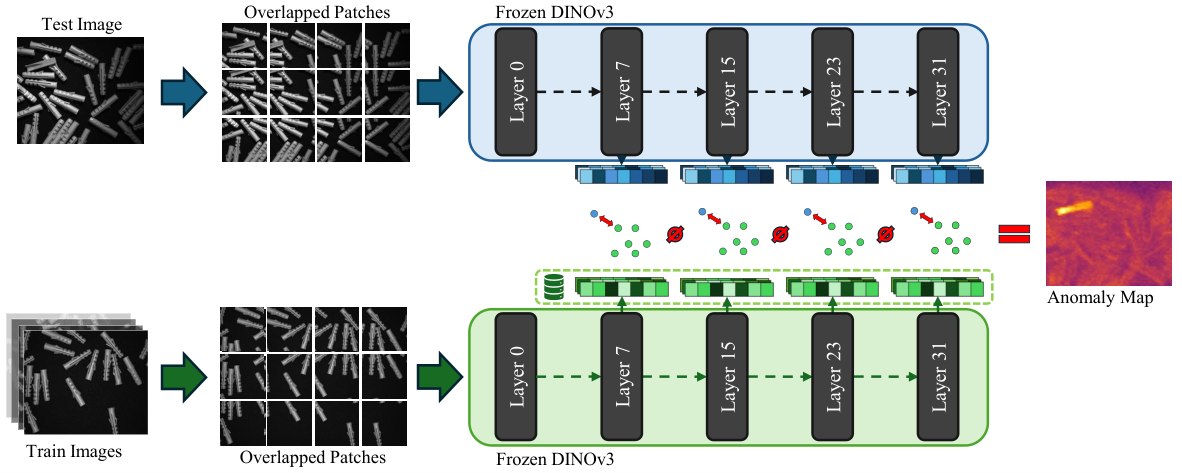
图 1:SuperADD 方法总览——重叠分块后经冻结 DINOv3 抽多层 embedding,训练建记忆库、测试算最近邻距离并平均成异常图
AI小怪兽点评(结构性创新):这是一套典型的「基础模型当冻结特征提取器 + 检索式决策」范式——训练成本几乎为零,换类别只重建记忆库。对 YOLO 玩家来说,思路可以直接类比:把 YOLO 的 backbone 当作 frozen 特征提取器做 few-shot / 免训练的异常检测,是当下很值得蹭的「零训练适配」路线。
4.2 重叠分块:既要位置不变,又要消灭块边缘伪影
为什么非要分块?因为 walnuts、rice、wall plugs 这类物体是位置无关的——同一样东西在画面里摆哪都行。整图推理时,模型会对「没训练过的空白区域」产生误报;分块把全局视野限制住,位置敏感性就下来了。
但普通非重叠分块会在块边界产生伪影:异常图在拼接处不连续、只在块内部分可见的区域被误判。本文的解法是让块在两个维度上尽量均匀分布且对齐图像边缘,保证最小重叠(P=640、O=128),推理后把重叠区的冗余预测丢掉。这样既不用 padding(零 padding 会把「被截断的物体」错误标成正常),又消除了块边缘伪影。
4.3 记忆库子采样:从「选图像」升级到「选特征」
这是最见功力的一处改进。原 SuperAD 用 PatchCore 的 coreset 方法从 class token 里挑 16 张图建库——问题是图像选得分散,库里的特征向量却可能高度重复(同质背景、同款低变化实例)。本文直接在特征空间做 k 近邻子采样:
- 对每个候选特征向量,算它到 k=100 个近邻的距离;
- 取所有 k-NN 距离的均值作为全局阈值;
- 给每个向量打「近邻里距离小于全局阈值的个数」这个分——分数越低说明它待在越稀疏的区域、信息量越大;
- 按分数升序排序,保留前 n 个作为记忆库。
为了加速,还可以在特征的若干随机子集上分别跑、再合并——实验发现子集式子采样不仅更快,平均 F1 还持平甚至略好。
AI小怪兽点评(工程账):这一步是「从顶层 task 指标倒推特征选择」的典范——不为了压缩而压缩,而是保留对「覆盖数据分布」最有价值的原型。对做few-shot、active learning 的读者,这套「稀疏度打分」思路完全可以搬去选 prototype 或选标注样本。
4.4 后处理:形态学闭运算把断裂缺陷接成完整区域
阈值化后的二值图常常「碎」——细长划痕中间有缝、异常边界有小的假阴性。本文的后处理链条是:先阈值化 → 16 次多方向形态学闭运算(线形结构元素、半径 26 像素、角度在 0°~180° 均匀取,各方向结果逐像素 OR)→ 再用一个更宽松的掩码(0.8×阈值)做逻辑 AND 限制过分割 → 最后填充闭合区域里的洞。
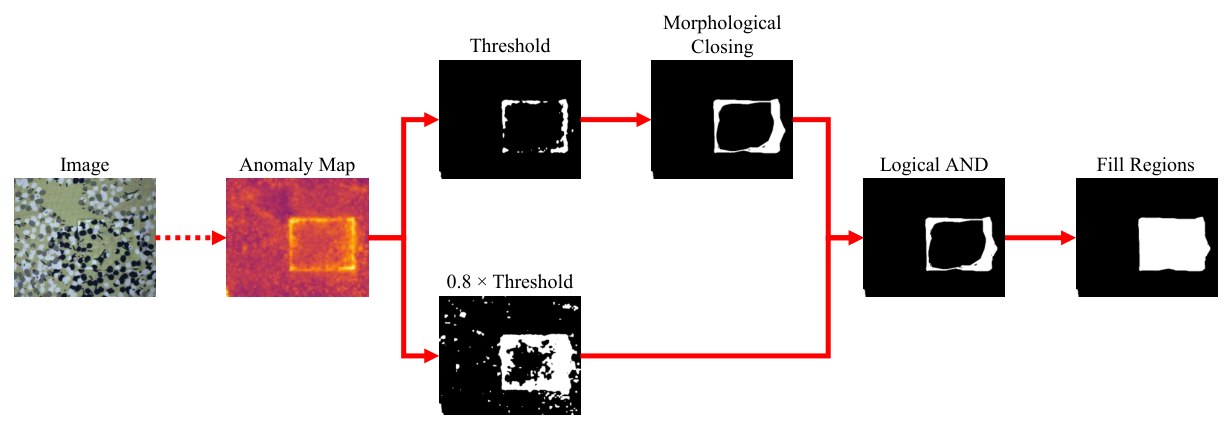
图 2:后处理流程——阈值化后做形态学闭运算,与 0.8×阈值掩码逻辑 AND,最后填充区域
注意两个细节:一是闭运算前对图做 26+1 像素的零 padding、之后再裁掉,避免边界假影;二是最终的洞填充专门解决「异常跨块边界导致的空洞」。这一串下来,异常区域更连贯、鲁棒性更强——从结果图里能直观看到划痕被接成一条完整线。
4.5 阈值自动推定:不给测试集真值任何机会
去年 SuperAD 的阈值是「拿带真值的测试集挑让 F1 最大的那个」——这在 VAND 4.0 规则下不合法。本文改成:只用训练数据算异常图的 95 分位数当阈值,再乘一个 1.3~1.5 的增益。作者还特意说明,这比「用更高的 99 分位数但不缩放」更稳、更好。这一改,方法就真正做到了端到端不碰测试真值。
AI小怪兽点评(与既有工作的关系):把这条路线放进谱系看——INP-Former 是「训练式重构派」,PatchCore / SuperAD 是「免训练记忆库派」,本文是「免训练记忆库派的 DINOv3 升级 + 工程精修」。它没改范式,而是把每个环节(骨干、采样、分块、后处理)都换成更优解——这正是工业界最喜欢的「低风险高收益」式迭代。
五、实验结果
5.1 实验设置
- 数据集:MVTec AD 2,8 个真实类别(can、fabric、fruit jelly、rice、sheet metal、vial、wallplugs、walnuts),分 TEST_pub(有真值、本地评测)、TEST_priv(同训练光照、私有)、TEST_priv,mix(混合已见/未见光照、私有)三个子集。
- 指标:像素级 F1 分数为主(与赛事评级一致),另报 AU-ROC 0.05。
- 设置:常规赛道,每类用官方正常训练集建一个独立模型实例;所有超参和阈值要么静态、要么从训练数据自动选。
- 对比方法:PatchCore、EfficientAD,以及去年 VAND 3.0 前四名(ISVL、RoBiS、ASEG)和基线 SuperAD。
5.2 公开测试集主实验(表 1)
表 1 是本文方法在 TEST_pub 上逐类的 AU-ROC 0.05 和 F1。平均 AU-ROC 83.93%、平均 F1 62.61%。fabric 最高(F1 93.74%),wallplugs 次之(79.16%);can 的 F1 是 0.00%——作者解释:这批样本里的细 defects 肉眼几乎看不见。
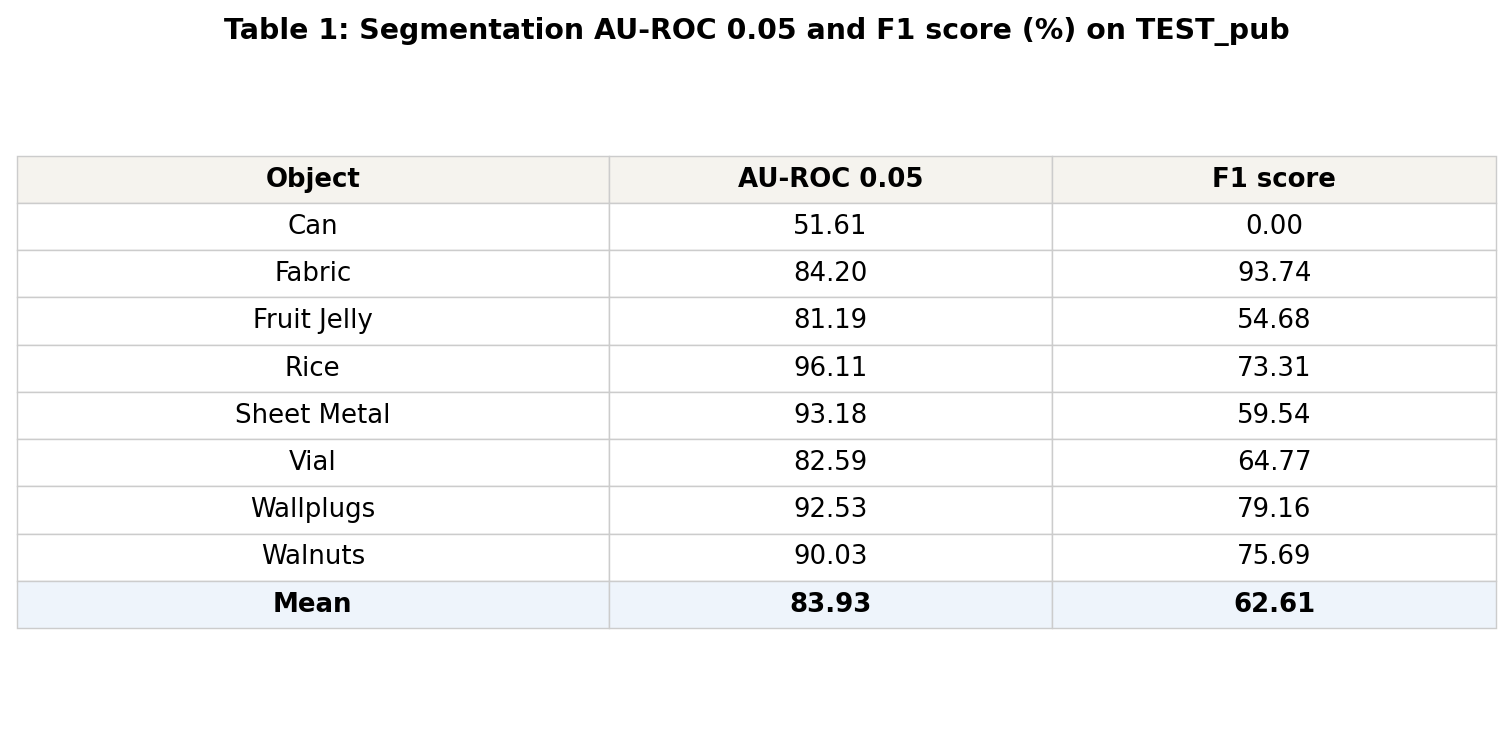
表 1:TEST_pub 上逐类分割 AU-ROC 0.05 与 F1 分数
物体类别 | AU-ROC 0.05 | F1 分数 |
|---|---|---|
Fabric | 84.20 | 93.74 |
Wallplugs | 92.53 | 79.16 |
Walnuts | 90.03 | 75.69 |
Rice | 96.11 | 73.31 |
Vial | 82.59 | 64.77 |
Sheet Metal | 93.18 | 59.54 |
Fruit Jelly | 81.19 | 54.68 |
Can | 51.61 | 0.00 |
均值 | 83.93 | 62.61 |
5.3 私有 / 混合测试集对比(表 2)
这是最能说明竞争力的表。在 TEST_priv / TEST_priv,mix 上,本文平均 F1 达 57.42% / 54.35%,全面压过去年最佳 ISVL(53.81% / 51.43%)和基线 SuperAD(47.8% / 43.2%)。逐类看,fabric(88.47%)、rice(73.83%)、vial(64.37%)、wallplugs(26.43%)都是本文最高。
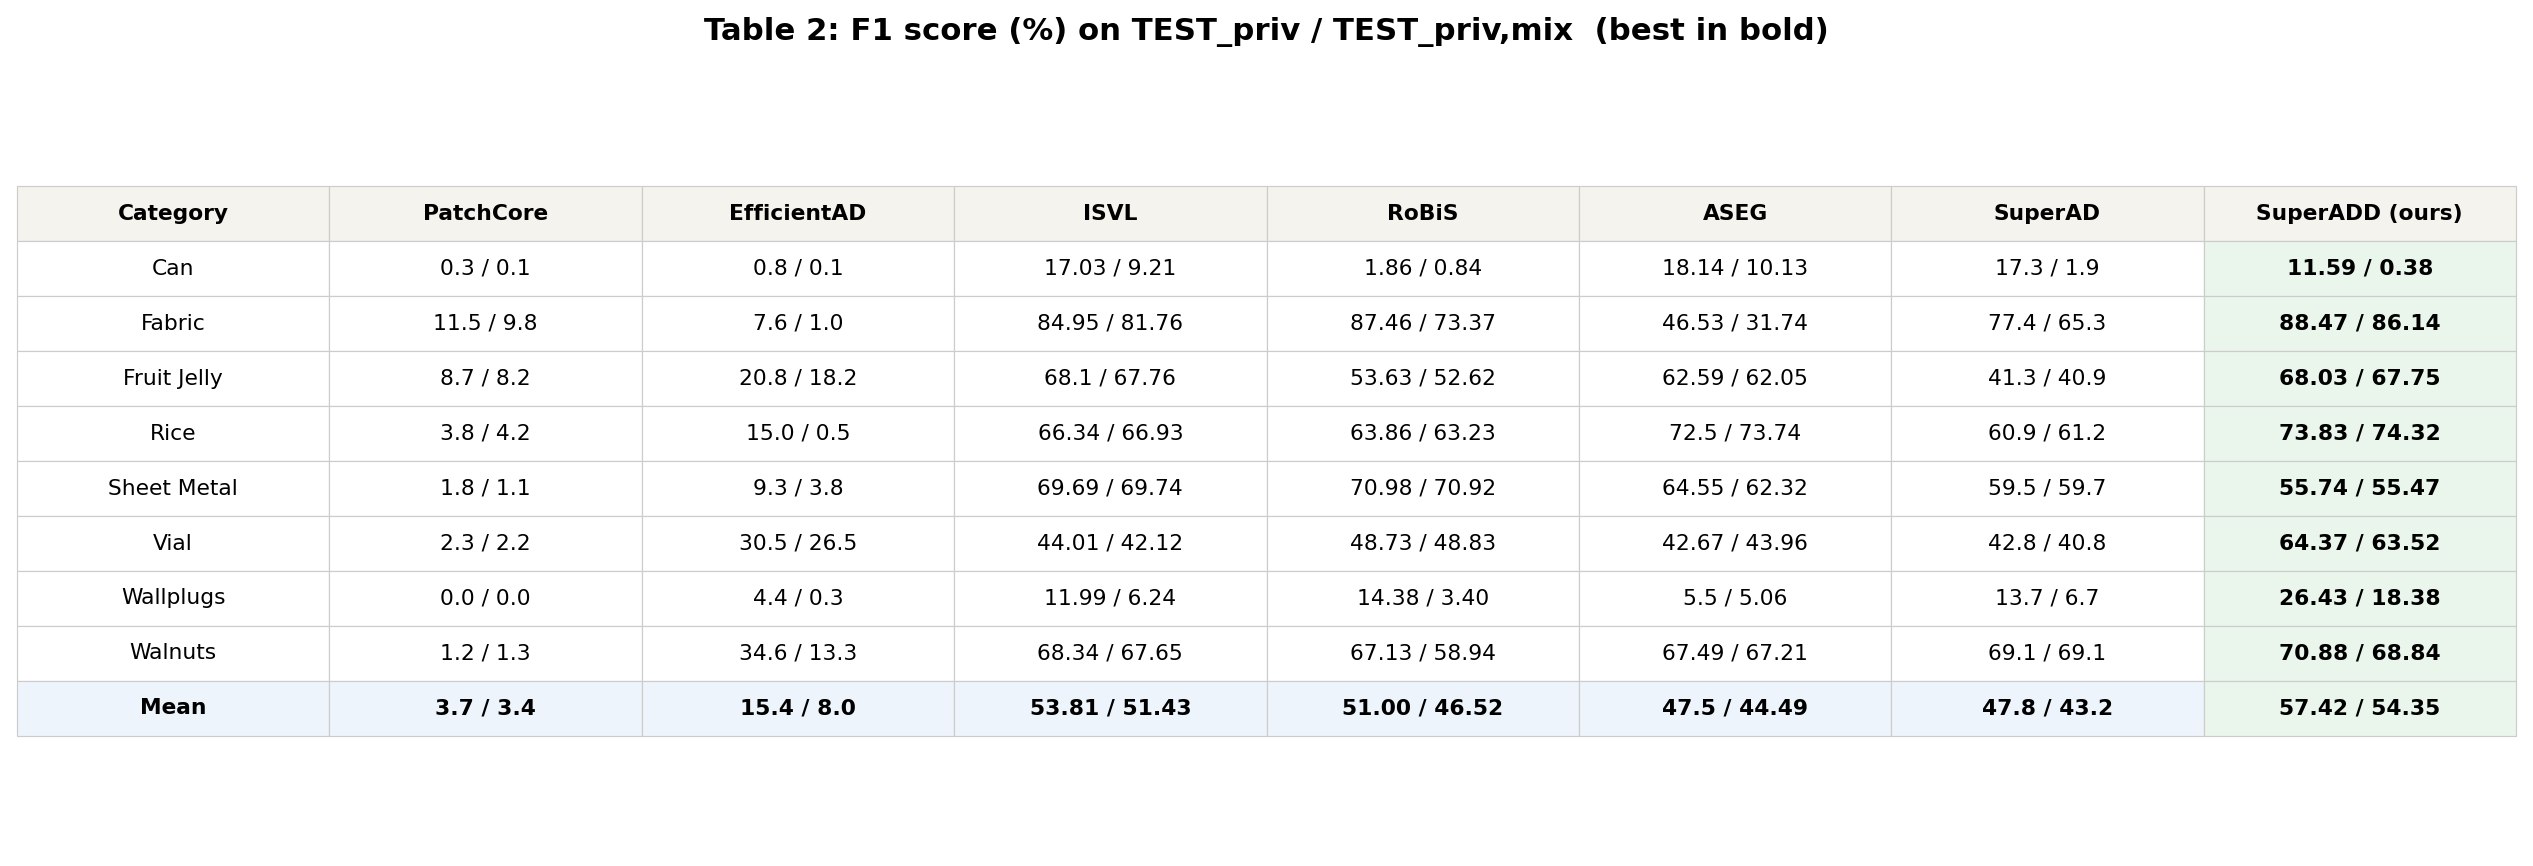
表 2:各方法在 TEST_priv / TEST_priv,mix 上的 F1 分数对比,最优值加粗
方法 | TEST_priv | TEST_priv,mix |
|---|---|---|
SuperADD(本文) | 57.42 | 54.35 |
ISVL(去年最佳) | 53.81 | 51.43 |
RoBiS | 51.00 | 46.52 |
SuperAD(基线) | 47.8 | 43.2 |
ASEG | 47.5 | 44.49 |
EfficientAD | 15.4 | 8.0 |
PatchCore | 3.7 | 3.4 |
解读:相对去年最佳 ISVL,本文在两个私有集上分别 +3.61 / +2.92 个百分点;相对基线 SuperAD 更是 +9.6 / +11.2 个点——DINOv3 + 分块 + 采样 + 后处理的组合收益实打实。
5.4 定性结果与鲁棒性
下图是 TEST_pub 上逐类的定性结果,四列依次是:输入图、异常图(后处理前的实值分数)、二值异常图(后处理后)、真值标注。能直观看到:大面积缺陷(如 fabric 上的布料缺口)分割得完整连贯(归功于后处理);rice、walnuts 上的小缺陷也能定位;但 can 的极细缺陷、sheet metal 的细划痕、fruit jelly 里的一根头发,仍然检不准。
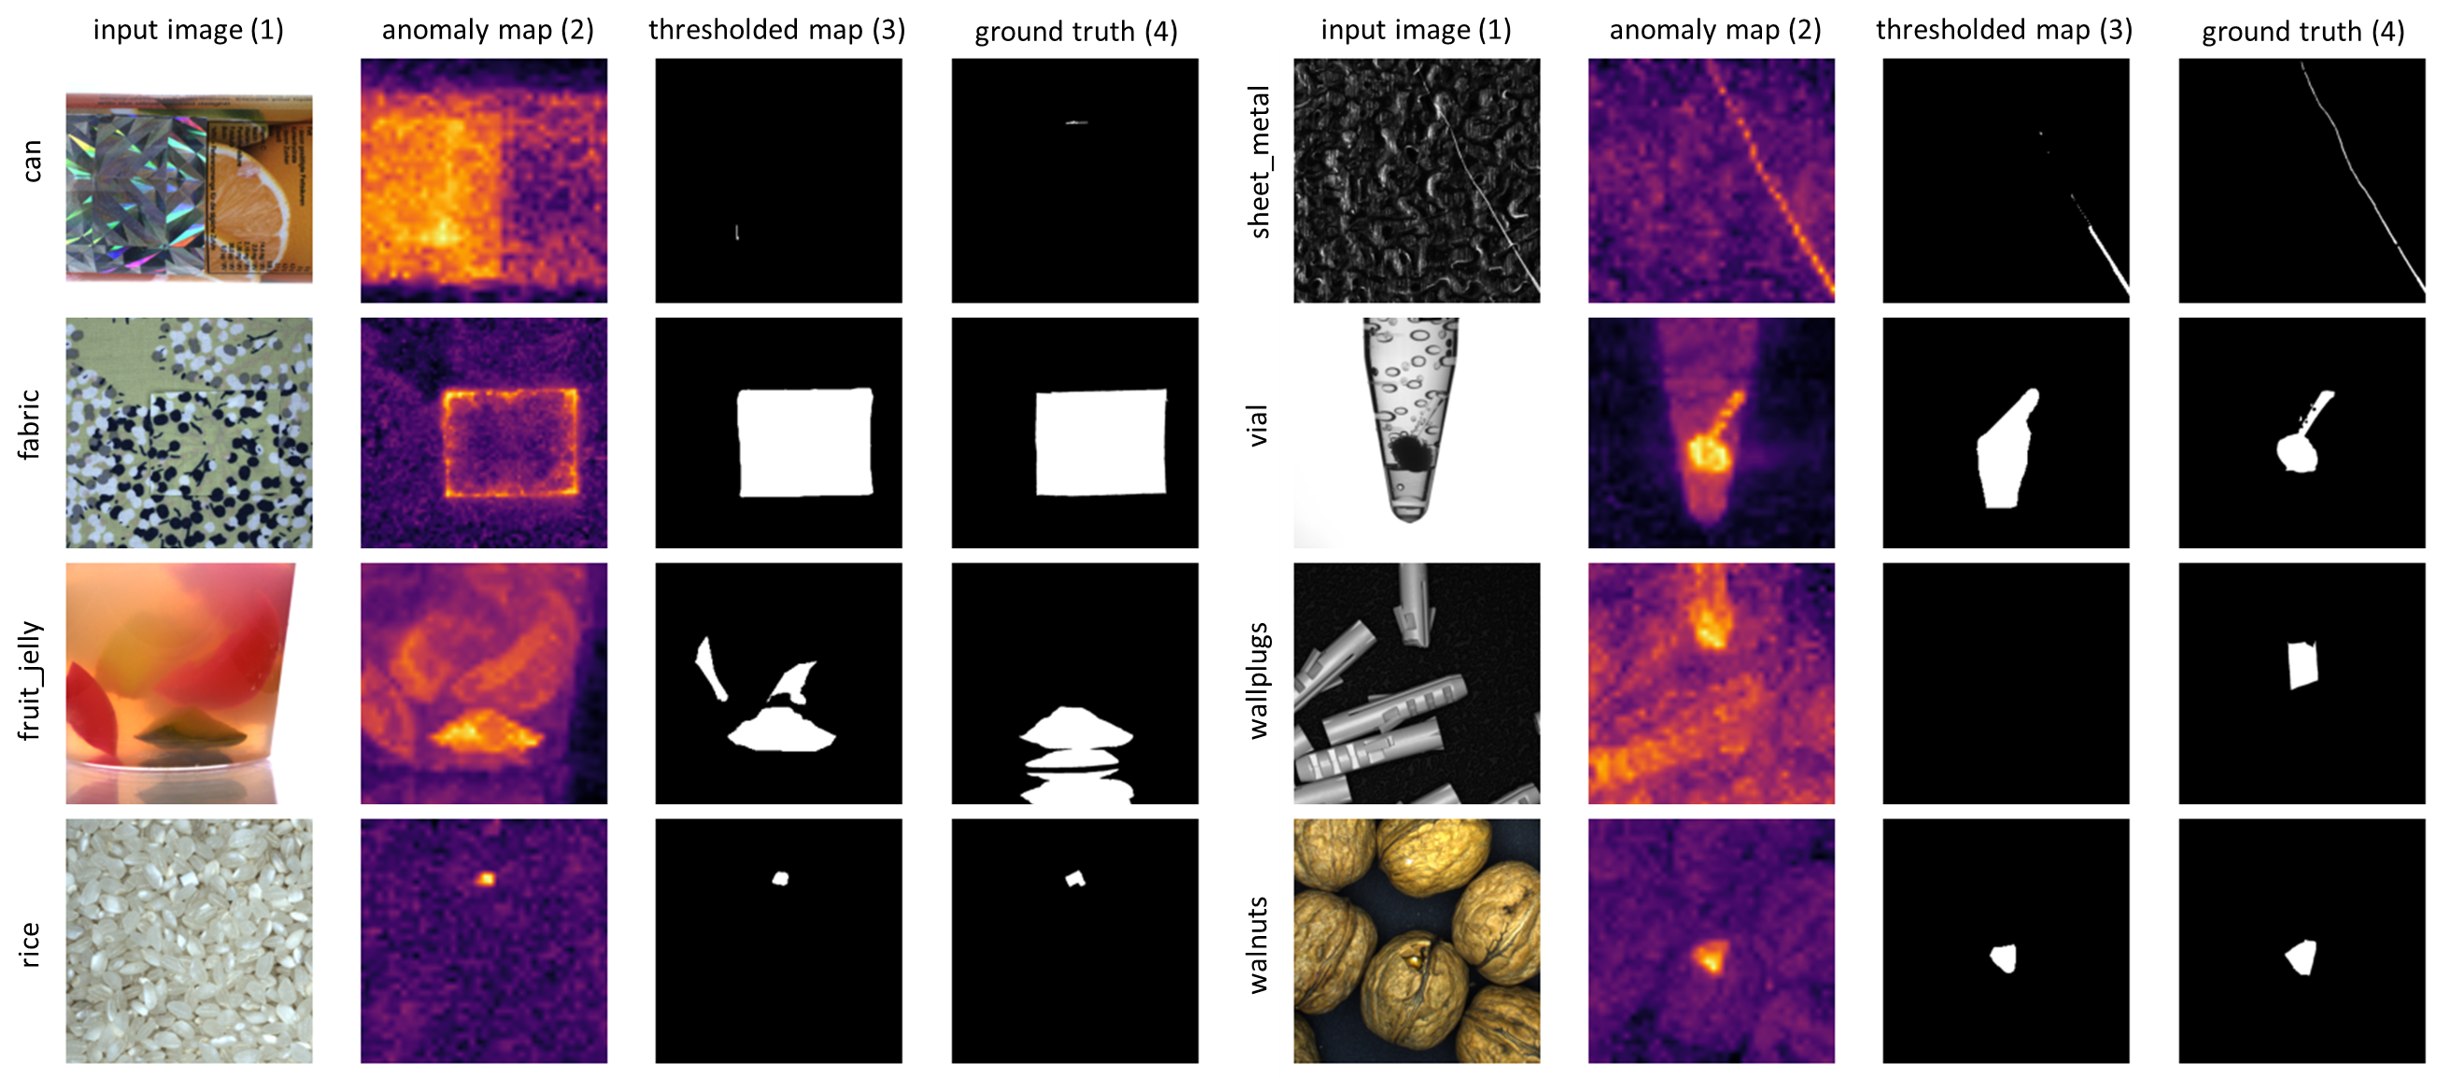
图 3:8 个类别的定性结果——输入图 / 异常图 / 二值异常图 / 真值
关于鲁棒性:从 TEST_priv 到 TEST_priv,mix(加入未见光照),整体只掉约 2 个百分点,平均仍保有 54.35% 的最佳成绩;掉得最狠的是 can(约 12 个点)——正好对应它本来就「缺陷几乎不可见」的先天短板。作者强调,免训练设计本身也贡献了鲁棒性:没有不稳定的优化过程、不用调训练超参,收敛失败的风险从根上消失。
六、展望
1. 论文自述的局限与未来方向
- 看不见的缺陷仍是硬伤:缺失部件(wallplugs 缺件、空 vial)、极细划痕(can、sheet metal)、单根毛发(fruit jelly)都难以可靠识别——这既是图像分辨率的锅,也是「正常分布里没见过这类异常」的必然结果。
- 未来方向:双记忆库。作者提出用扩散模型把 MVTec AD 1 的缺陷迁移到 MVTec AD 2 正常图上合成异常图,再用特征对齐缩小合成/真实缺陷的 gap,建一个「异常聚焦」的第二记忆库。正常库抓「偏离正常分布」,异常库抓「匹配合成缺陷原型」,两者互补,且全程仍然免训练。
2. 人设视角的延伸判断
以下为非论文原文的延伸判断。
- 对 YOLO 玩家意味着什么:这篇给了一个很强的信号——「冻结基础模型 + 检索式决策」正在成为小样本/零样本工业检测的主流范式。你完全可以拿 YOLO 的 backbone 或 DINOv3 特征做一套免训练的异常分割头,和检测头并联:检测头管「已知的明确缺陷」,异常头管「从未见过的未知异常」。这套「已知 + 未知」双路架构,比单纯堆 mAP 更贴近真实产线需求。
- 复现 / 迁移实操建议:代码已开源(github.com/LukasRoom/SuperADD)且有 step-by-step 指南,复现门槛低。迁移到自建数据时,重点盯三处——① 分块大小 P 和重叠 O 要按你的缺陷尺度调(细长缺陷别切太碎);② 形态学闭运算的半径 26 和 16 次迭代是给「线状缺陷」调的,如果你的是点状缺陷要减弱;③ 阈值增益 1.3~1.5 建议在你的正常验证集上扫一下,别照搬。
- 诚实的短板提醒:这是 CVPR workshop 的技术报告,8 类平均 F1 62.61%(公开集)离真正产线可用的高召回还有距离;而且每类仍要建独立模型实例、阈值按类自动推——所谓「类别无关」更多指架构/超参统一,而非完全一套模型打通所有类。落地时别被「training-free」四个字冲昏头,特征库和检索的算力/存储账也要算进去。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号