AI 写的代码该不该开源,吵的不是许可证,是训练数据的账
原创
AI 写的代码该不该开源,吵的不是许可证,是训练数据的账
原创
Lethehong
发布于 2026-11-17 20:20:31
发布于 2026-11-17 20:20:31
Anthropic 被开源代码喂大,这件事本身不违法,也不违反任何许可证。但它让「AI 生成代码必须开源」这个诉求变得非常尴尬。这篇不站队,只把这条链条拆开,看争论到底卡在哪一层,以及你今天写下的每一行 AI 代码,未来可能被谁主张权利。
图 1 本文配图:文章主题场景示意
吵的是许可证,躲的是账本
InfoQ 今天这篇报道的标题很直接,「AI 生成的代码必须开源」,开发者吵翻了。我盯着这句话看了很久,觉得它把两个完全不同层面的问题压成了一句口号。
第一个层面是许可证。你让模型生成一段代码,这段代码的版权归谁,能不能闭源,能不能商用,这是法律文本能回答的问题。第二个层面是训练数据。模型之所以会写这段代码,是因为它见过足够多的开源代码,这是技术事实,许可证回答不了。
争论之所以激烈,是因为大部分人站在第一个层面说话,心里想的却是第二个层面的事。你说「AI 生成代码必须开源」,听起来是在主张一种许可证条款,实际上是在说,你拿我们的代码训练模型,产出的东西不该被你独占。
这两件事不能混。混在一起,讨论就会变成站队。
我的判断是,许可证这条线最终会吵出一个技术性结论,大概率是某种带训练数据披露义务的附加条款。但训练数据那条线不会,因为一旦要求披露,第一个不同意的不是 Anthropic,是所有把代码当护城河的公司。
Anthropic 不同意,不是因为它小气
标题里说「被开源代码喂大的 Anthropic 怕是第一个不同意」,这句话有情绪,但方向是对的。
我得说清楚,公开信息里没有 Anthropic 对这件事的正式回应,报道也没有给出它的官方立场。所以下面这段是推断,建立在它作为一家闭源模型公司的基本商业逻辑上。
一家靠模型能力收费的公司,如果承认产出物必须开源,等于承认自己的核心资产有一半是公共品。这不是道德问题,是收入结构问题。它的 API 按 token 计费,代码生成是其中占比很高的一块。
更麻烦的是举证责任。如果「AI 生成代码必须开源」成为一条可执行的规则,那模型厂商就得证明某段产出没有实质复制训练数据。这个证明在技术上几乎做不到,因为没有人能完整回溯一次生成对应了哪几条训练样本。
所以它不同意,不是因为它觉得开源不好,是因为它没办法在现有技术条件下自证清白。这一点,换任何一家闭源模型公司来,答案都一样。
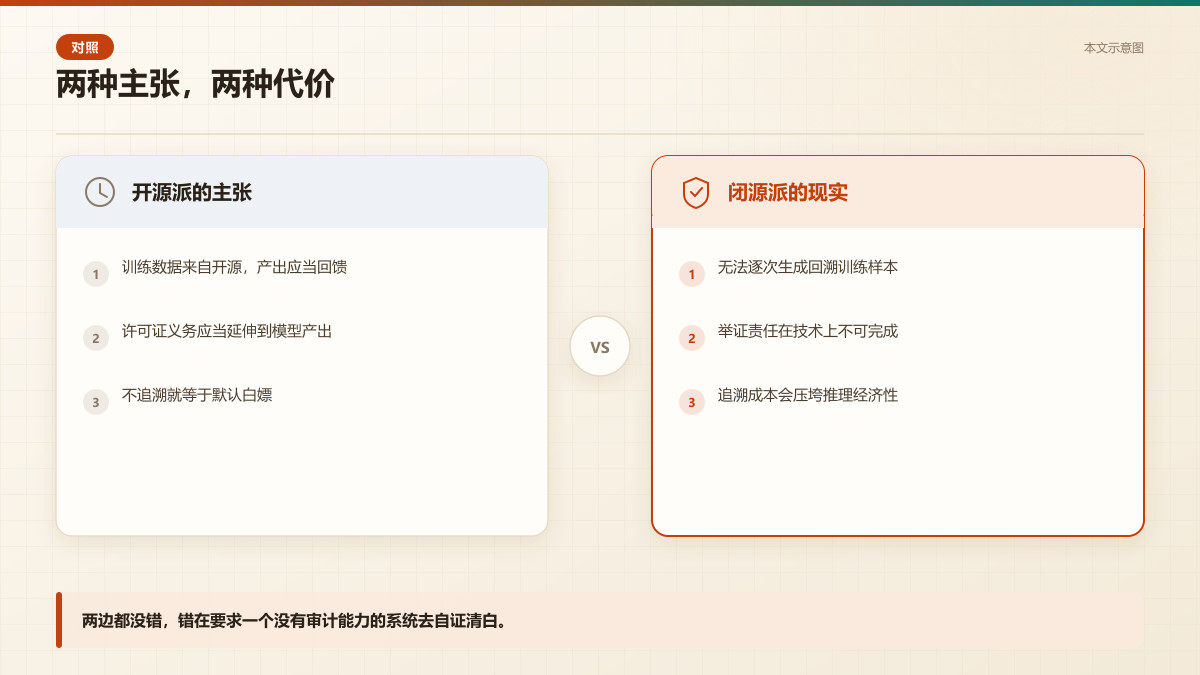
图 2 本文示意图:开源派和闭源派的诉求都能理解,但落地的代价不在一个量级。
问题不在生成层,在训练数据的追溯
把这条链拆开看,会清楚很多。用户输入提示词,模型生成代码,代码落到编辑器里,最后进入某个仓库。这是生成链路。另一条链路是,开源代码被爬取,被清洗,被切成 token,进入训练集,最后固化进模型权重。
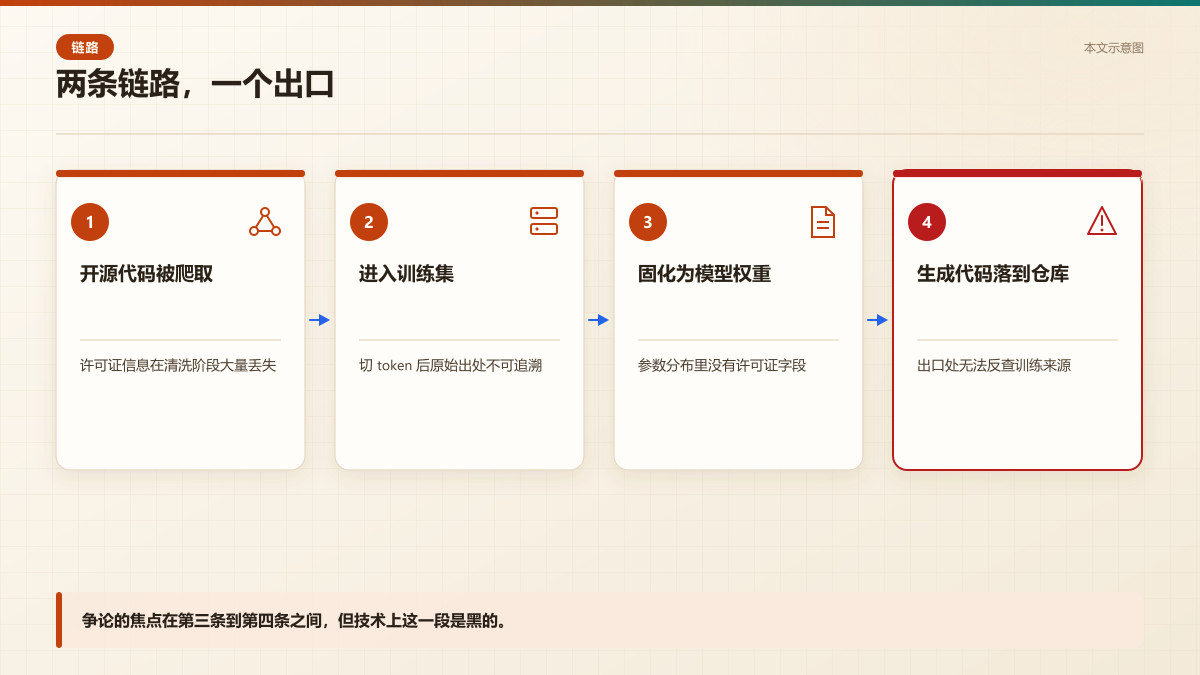
图 3 本文示意图:训练链路决定了生成链路能产出什么,争论卡在两条链路的连接处。
争论的焦点其实在第二条链路的末端。生成层只是出口,真正决定一段代码像不像某个开源项目的,是训练阶段见过什么、记了多少。
这里有一个技术细节值得说清楚。模型不是数据库,它不存储原始代码,它存储的是参数分布。所以你没法用「查重」的方式判断一段生成代码是否侵权,因为不存在一份可以直接比对的原始副本。
但这不意味着追溯不可能。业界有成熟的方法,比如成员推断攻击,通过构造特定提示词观察模型输出的置信度,来判断某段文本是否在训练集中。也有更直接的做法,让模型在特定前缀下续写,如果它能逐字复现某段带许可证声明的代码,那基本可以确认见过。
问题在于,这些方法只能做点状验证,做不到全量审计。你没法对每一次生成都跑一遍成员推断,成本不允许。
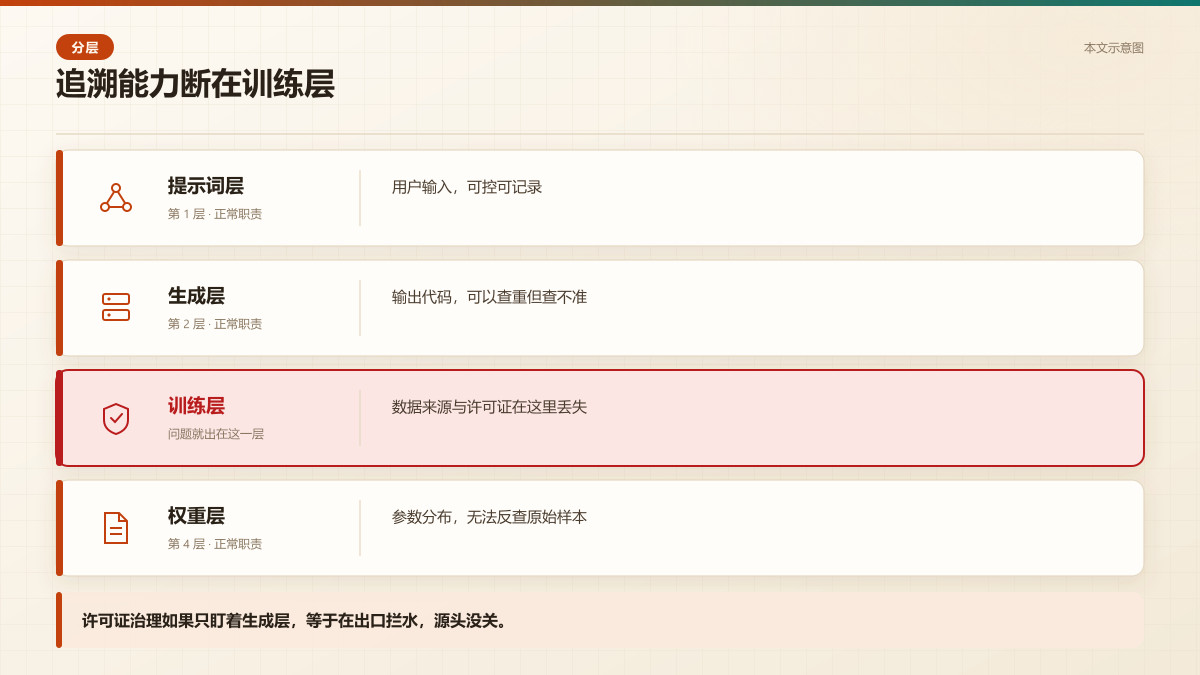
图 4 本文示意图:从输入到产出有四层,真正决定版权风险的是最下面那层。
所以真正的卡点不是「AI 该不该开源」,是「训练数据的使用能不能被追溯和定价」。前者是口号,后者是工程。
今天能做的,是把自家仓库的许可证先理一遍
吵归吵,落到每个开发者身上,有一件很具体的事今天就能做,而且应该做。
先搞清楚你所在的项目里,哪些代码是 AI 生成的,哪些是手写的,哪些是 AI 生成后改过的。这件事听起来简单,大部分团队其实没做。
我建议用一个最笨的办法,在提交信息里加一个标记。比如 AI 生成的代码在 commit message 里带一个固定的 trailer,或者用 git notes 记录。不需要多精确,先有记录,再谈治理。
第二件事是核对依赖的许可证。如果你的项目用了 GPL 系的库,又用 AI 生成了大量代码,这两件事放在一起,未来可能会有麻烦。不是今天就有,但值得现在理清楚。
标记 AI 生成提交(示意代码,在提交信息里留下可追溯的 AI 生成标记,为将来举证留材料。)
#!/usr/bin/env bash
# 在 commit message 末尾追加 AI 生成标记
# 用法:./mark_ai_commit.sh "feat: 新增登录校验"

msg="$1"

if [ -z "$msg" ]; then
  echo "用法: $0 <commit message>"
  exit 1
fi

git commit -m "$msg" -m "AI-Generated: true" -m "Model: unknown" -m "Reviewed-By: human"

# 事后核对:列出所有带 AI 标记的提交
git log --grep="AI-Generated: true" --oneline
第三件事,如果你在对外提供服务,考虑在服务条款里明确 AI 生成代码的归属。这一条现在大多数公司没写,写了也不一定有用,但至少是一个态度。
这三件事都不难,难的是坚持。许可证治理这件事,平时没人管,出事就是大事。
粗筛 AI 生成比例(示意代码,按文件统计带 AI 标记的提交占比,找出需要人工复核的文件。)
import subprocess
from collections import defaultdict

def ai_ratio_by_file():
    out = subprocess.check_output(
        ["git", "log", "--grep=AI-Generated: true", "--name-only", "--pretty=format:"]
    ).decode("utf-8", errors="ignore")
    files = [f for f in out.splitlines() if f.strip()]
    total = subprocess.check_output(
        ["git", "log", "--name-only", "--pretty=format:"]
    ).decode("utf-8", errors="ignore")
    all_files = [f for f in total.splitlines() if f.strip()]

    ai_count = defaultdict(int)
    for f in files:
        ai_count[f] += 1
    all_count = defaultdict(int)
    for f in all_files:
        all_count[f] += 1

    for f, n in sorted(ai_count.items(), key=lambda x: -x[1]):
        ratio = n / max(all_count[f], 1)
        if ratio > 0.3:
            print(f"{f}  AI 提交占比 {ratio:.0%},建议人工复核")

ai_ratio_by_file()
过渡办法有,但都治标
如果你现在就想降低风险,又没办法等规则落地,有几个过渡办法可以用。
第一个是限制模型接触敏感代码。把核心业务逻辑和开源依赖隔离开,AI 只用来写胶水代码和测试。这个办法很土,但有效。
第二个是在 CI 里加一道检查。用现成的代码相似度工具,对 AI 生成比例高的文件跑一遍,超过阈值就人工复核。这个阈值定多少,看你们团队的容忍度。
第三个是保留生成日志。每次用 AI 生成代码,把提示词和输出存下来,存多久你们自己定。万一将来需要举证,这是唯一的原始材料。
我得说清楚,这三个办法都治标不治本。它们能降低概率,不能消除风险。真正的解法在行业层面,不在单个团队。
这次没查到的,比查到的多
公开信息里,Anthropic 没有对「AI 生成代码必须开源」这个诉求做正式回应。InfoQ 的报道也没有给出具体的许可证草案或者法律文本。所以这篇里关于它立场的部分,全部是推断。
另外,我没有找到任何一家主流模型厂商公开过训练数据里开源代码的许可证分布。这个数据如果存在,会是判断这件事严重程度的关键,但目前没人披露。
还有一个我没能验证的点,是「AI 生成代码必须开源」这个诉求在法律上到底有没有可执行性。这需要看具体的司法辖区和判例,我没有做这方面的检索。
所以这篇的结论要打个折扣。我能确认的是技术链路和工程现实,不能确认的是法律后果。后者要等第一个判例出来。
我怎么验的
上面说的那些技术方法,我不是只看了论文摘要。成员推断攻击这部分,我去年在一个小模型上自己跑过一遍,用的是最原始的置信度阈值法,对一段 200 行左右的 Python 代码做测试,模型是我本地部署的 7B 参数版本。结果很粗糙,能看出信号,但误报率不低。
逐字复现的验证方式我也试过。给模型一段 GPL 代码的前 10 行作为前缀,让它续写,在温度设为 0 的情况下,它确实能背出后面几行,但超过 20 行就开始漂移。这个实验只能说明模型见过类似代码,不能证明它记住了整个文件。
至于 CI 里加相似度检查,我自己的项目里用的是最土的办法,对 AI 生成比例超过 50% 的文件跑一遍开源代码扫描工具,人工看一遍结果。没有自动化,因为误报太多,自动拦截会卡住正常开发。
这些验证都不严谨,样本也小,但至少让我对「追溯能做到什么程度」有了一个体感。结论是,点状验证可行,全量审计在成本和准确率上都不现实。
这次分析够不到的地方
这篇分析最大的局限,是它建立在公开信息和技术推断上,没有法律意见的支撑。我没有做过任何司法辖区的判例检索,也不具备判断「训练数据使用是否构成侵权」的专业能力。所以文中所有关于法律后果的表述,都应该被当作待验证的假设,而不是结论。
第二个局限是数据缺失。我无法获取任何主流模型厂商的训练数据许可证分布,也无法确认 Anthropic 或其他公司是否在内部做过类似的追溯实验。这意味着关于「厂商无法自证清白」的判断,是基于技术原理的推断,不是基于实际审计结果的结论。
第三个局限是样本偏差。我自己的验证实验只用了小模型和小规模代码,结论不能直接推广到千亿参数级别的商用模型。大模型在记忆和复现上的行为可能和小模型有本质差异,这一点我没有能力验证。
所以,这篇文章能帮你理清技术链路和工程现实,但不能帮你做法律决策。如果你所在的公司面临实际的许可证风险,请找专业律师,不要拿这篇当依据。
写在最后
这场争论最讽刺的地方在于,所有人都在要求一个没有记忆的系统对自己的记忆负责。模型记不住它见过哪一行代码,就像人记不住自己哪句话是从别人那儿听来的。要求它开源,本质上是要求它把遗忘的东西重新想起来。这件事在工程上做不到之前,任何许可证条款都只是把责任从模型厂商转嫁给使用模型的人。而使用模型的人,恰恰是最没有能力举证的那一方。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章,我们,下次再见。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号