# 9条ES|QL查询看穿Foundry Agent账单:一个工具p95拖到10秒,79个span失败,Token尖峰全是死循环
原创
# 9条ES|QL查询看穿Foundry Agent账单:一个工具p95拖到10秒,79个span失败,Token尖峰全是死循环
原创
点火三周
发布于 2026-11-18 19:47:22
发布于 2026-11-18 19:47:22
Foundry 托管 Agent 的 OpenTelemetry span 本身就已经说明了它的成本。九个 ES|QL 查询加上一个可导入的 Kibana 仪表盘,把各模型 Token 成本、工具延迟、失败 span 和每位调用方的花费集中到同一块屏幕上。同一批 span 也会喂给 Agent 365,但 Agent 365 用它们做另一件事:确认这个 Agent 是谁,以及它被允许做什么。
在示例数据中,有一个工具的 p95 高达 10 秒,把 Agent 自身的 p95 拖到了 13.1 秒;另有 79 个 span 在五类错误下失败。配套内容包括一个示例 Agent 容器、一个可生成 605 次运行和约 3,000 个 span 的生成器,以及一条在 Agent 调用从未调用过的工具时触发的 ES|QL 规则。
本文接续《Microsoft Foundry 的 AI Agent 可观测性:两个环境变量,无需 Collector》,该文讲的是如何把 Foundry span 首次接入 Elastic。
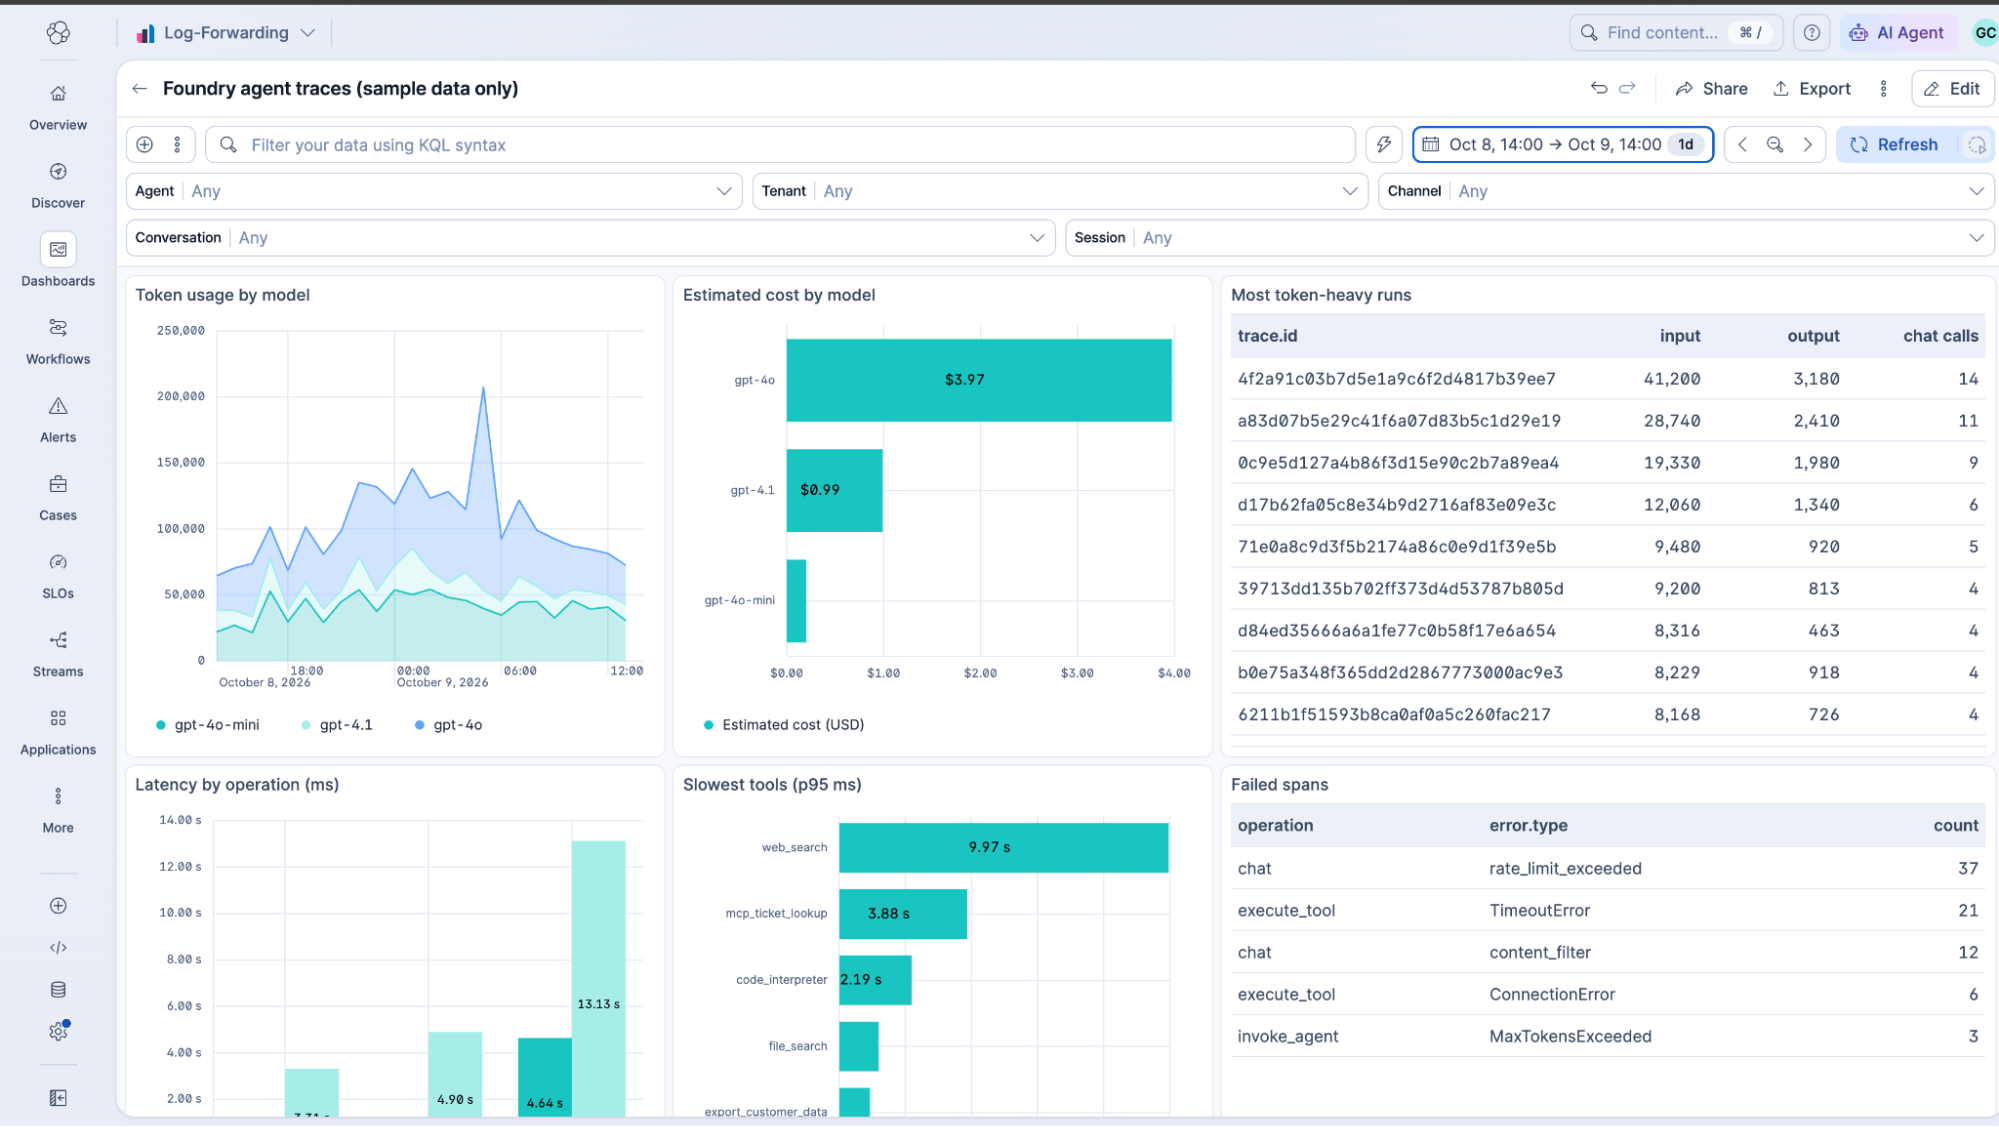
Microsoft Foundry Agent trace 的 Kibana 仪表盘:Token 用量、预估成本、延迟、最慢工具与失败 span
前置条件:将 Foundry Agent 的 span 接入 Elastic
本文接续《Microsoft Foundry 的 AI Agent 可观测性:两个环境变量,无需 Collector》继续展开。在那篇文章中,我们介绍了如何把 Foundry Agent 的 span 送入 Elastic 托管 OTLP 端点,并以应用性能监控(APM)瀑布图的形式查看单次运行。你需要先从那篇文章拿到端点 URL 和 API key,否则后文所有内容都无法工作。span 会落入 traces-generic.otel-default 数据流。
瀑布图适合查看单次运行。但像这周哪个模型最贵?、哪个调用方在推高花费?,或者某个工具是否正在变慢这类问题,需要跨所有运行做聚合——这正是仪表盘要做的事。本文就来构建这个仪表盘,并补上前一篇文章没有涉及的 Agent 365 上下文。
Microsoft Foundry Agent 的 trace 都去了哪里?
Foundry Agent 产生的 trace 有三个来源,也可以发往多个目的地(包括 Agent 365),其中只有部分能到达 Elastic:
- Foundry 生成服务端 trace,覆盖 prompt agent、托管 Agent 以及工作流。Foundry 将它们存储在项目关联的 Application Insights 资源中,默认情况下不会有任何内容发往 Elastic。
- 客户端 trace 来自调用 Agent 的应用程序。它们记录你的调用代码及其对 Foundry 的请求,但止步于 Agent 的边界。
- 容器内 trace 来自托管 Agent——容器中运行的是你自己的编排代码。对这段代码做埋点,就能记录 Agent 发起的每一次模型调用和工具调用。容器的遥测管道可以通过 OTLP 把这些 span 发往 Elastic;当 Agent 365 导出开启时,也可以同时发往 Agent 365。这是两个独立 exporter 共享同一条管道,而不是一个通用的 OTLP exporter。本文后续内容都使用这条路径。
Agent 365 是目的地而非来源。它是微软用于 Agent 身份、治理与安全的控制平面。它会摄取 span,供 Microsoft 365 管理中心中的 Agent 清单、Microsoft Purview 以及 Microsoft Defender 使用。Agent 365 并不是一个存放完整原始 span 的通用存储,它通过 Microsoft Defender 高级搜寻等界面,支持对处理后的 Agent 活动记录进行查询。
Agent 365 保留什么,Elastic 保留什么
这两个目的地做的是不同的事,而同一个 span 会同时喂给二者:
Agent 365 | Elastic | |
|---|---|---|
它回答的问题 | 有哪些 Agent?谁负责它们?它们被允许做什么? | Agent 在成本、延迟、失败和用量方面表现如何? |
优势 | 在 Microsoft 365、Purview 和 Defender 中提供身份、治理、合规与安全视图。 | 对 Agent 发出的每个 span 执行即席 ES|QL 查询,不限制 span 类型。你可以控制 span 的保留时长以及谁可以读取,细到针对 prompt 内容的字段级安全。仪表盘、告警规则和检测(如下文的新工具查询)都跑在同一份数据上。你还可以把 Agent trace 与技术栈其余部分的日志、指标和 APM 数据关联起来。 |
保留的 span | 仅保留 | Agent 发出的一切,包括 Agent 365 忽略的 span 类型,例如 |
两个目的地保留的 span 不同,但它们共享的身份字段让你可以把两边对齐。在 Elastic 中按 gen_ai.agent.id 和 microsoft.tenant.id 过滤,就能隔离出某个租户下的某个 Agent 实例;随后用 gen_ai.conversation.id 和 trace ID,就能把一次运行从管理中心一路追踪进 Elastic。
将 Foundry 托管 Agent 的 trace 同时发送到 Elastic 和 Agent 365
Foundry 托管 Agent 运行在 Foundry Agent Server Host 之内,而这个 host 已经替你做了大部分工作。在我测试过的版本中(azure-ai-agentserver-core 2.2.0 与 microsoft-opentelemetry 1.3.9),它会自动配置 Microsoft OTel distro。它会向 OTEL_EXPORTER_OTLP_ENDPOINT 指定的任意 OTLP 端点导出,默认使用 HTTP/protobuf。它会依据 FOUNDRY_AGENT_* 环境变量,为每个 span 打上 agent ID、blueprint ID、tenant ID 和 session ID。当 Foundry 为该 Agent 启用 Agent 365 导出时,它也会一并打开。Foundry 通过账户级的 a365LoggingEnabled 设置控制 Agent 365 导出;当该值为 true 时,受支持的托管库会自动开启导出,因此容器本身不需要调用 use_microsoft_opentelemetry()。
容器确实会用 distro 的 scope 来描述运行的每一步。InvokeAgentScope、InferenceScope 和 ExecuteToolScope 会以 Agent 365 可接受的形态、以及仪表盘查询可读取的形态,发出 invoke_agent、chat 和 execute_tool 这三类 span。这个 Agent 处理一个调用端点。每个请求都在一个根 invoke_agent span 内运行,并调用一个工具;同时通过 Foundry 客户端发起一次模型调用。下面的代码先在 AgentDetails 中描述一次 Agent 身份,然后把工具调用和模型调用分别包进会发出 execute_tool 和 chat span 的 scope 中。除非你设置 CAPTURE_MESSAGE_CONTENT,否则内容采集保持关闭。
import asyncio
import os
import uuid
from urllib.parse import urlparse

# The scopes below do nothing unless observability is switched on. The agent server host
# only does that itself when Foundry enables Agent 365 export, so opt in here to get spans
# in Elastic either way.
os.environ.setdefault("ENABLE_OBSERVABILITY", "true")

from azure.ai.agentserver.invocations import InvocationAgentServerHost
from azure.ai.projects import AIProjectClient
from azure.identity import DefaultAzureCredential
from microsoft.opentelemetry.a365.core import (
    AgentDetails,
    CallerDetails,
    Channel,
    ExecuteToolScope,
    InferenceCallDetails,
    InferenceOperationType,
    InferenceScope,
    InvokeAgentScope,
    InvokeAgentScopeDetails,
    Request,
    ServiceEndpoint,
    ToolCallDetails,
    ToolType,
    UserDetails,
)
from starlette.responses import JSONResponse

# The agent server host turns on OTLP export when OTEL_EXPORTER_OTLP_ENDPOINT is set.
app = InvocationAgentServerHost()

CAPTURE_CONTENT = os.environ.get("CAPTURE_MESSAGE_CONTENT", "false").lower() == "true"
MODEL = os.environ["FOUNDRY_MODEL_NAME"]
PROJECT_HOST = ServiceEndpoint(hostname=urlparse(os.environ["FOUNDRY_PROJECT_ENDPOINT"]).hostname)

# The instance ID goes in agent_id. Using the blueprint ID there makes Agent 365 reject
# the export with a 403 agent ID mismatch.
AGENT = AgentDetails(
    agent_id=os.environ["FOUNDRY_AGENT_INSTANCE_CLIENT_ID"],
    agent_name=os.environ.get("FOUNDRY_AGENT_NAME", "support-agent"),
    agent_blueprint_id=os.environ["FOUNDRY_AGENT_BLUEPRINT_CLIENT_ID"],
    tenant_id=os.environ["FOUNDRY_AGENT_TENANT_ID"],
)

project = AIProjectClient(
    endpoint=os.environ["FOUNDRY_PROJECT_ENDPOINT"],
    credential=DefaultAzureCredential(),
)
openai = project.get_openai_client()

def lookup_order(request: Request, order_id: str) -> str:
    """Stand-in for a real tool call, such as a database or MCP lookup."""
    arguments = {"order_id": order_id}
    details = ToolCallDetails(
        tool_name="lookup_order",
        arguments=arguments if CAPTURE_CONTENT else None,
        tool_call_id=str(uuid.uuid4()),
        tool_type=ToolType.FUNCTION.value,
        # Replace with the host your real tool calls.
        endpoint=ServiceEndpoint(hostname="orders.example.com"),
    )
    with ExecuteToolScope.start(request=request, details=details, agent_details=AGENT) as scope:
        result = f"Order {order_id} shipped and arrives Thursday."
        if CAPTURE_CONTENT:
            scope.record_response(result)
        return result

def ask_model(request: Request, prompt: str) -> str:
    """One model call, recorded as a chat span with token counts."""
    details = InferenceCallDetails(
        operationName=InferenceOperationType.CHAT,
        model=MODEL,
        providerName="microsoft.foundry",
        endpoint=PROJECT_HOST,
    )
    with InferenceScope.start(request=request, details=details, agent_details=AGENT) as scope:
        response = openai.responses.create(model=MODEL, input=prompt)
        if CAPTURE_CONTENT:
            scope.record_input_messages([prompt])
            scope.record_output_messages([response.output_text])
       ```python
        scope.record_input_tokens(response.usage.input_tokens)
        scope.record_output_tokens(response.usage.output_tokens)
        return response.output_text

@app.invoke_handler
async def handle(request):
    body = await request.json()
    question = body.get("question", "")

    # Content=None keeps the question out of the span. The conversation ID groups the runs
    # in one thread. The host adds Foundry's session ID to every span for you.
    agent_request = Request(
        content=question if CAPTURE_CONTENT else None,
        conversation_id=body.get("conversation_id"),
        channel=Channel(name=body.get("channel", "web")),
    )
    caller = CallerDetails(
        user_details=UserDetails(user_id=body.get("user_id"), user_client_ip=request.client.host)
    )

    # One root span per request keeps the model and tool calls in a single trace.
    with InvokeAgentScope.start(
        request=agent_request,
        scope_details=InvokeAgentScopeDetails(endpoint=PROJECT_HOST),
        agent_details=AGENT,
        caller_details=caller,
    ) as scope:
        order_status = lookup_order(agent_request, body.get("order_id", "unknown"))

        # The OpenAI client is synchronous, so run it off the event loop.
        answer = await asyncio.to_thread(
            ask_model,
            agent_request,
            "You are a support agent. Answer in two sentences.\n"
            f"Order status: {order_status}\n"
            f"Customer question: {question}",
        )
        if CAPTURE_CONTENT:
            scope.record_output_messages([answer])
        return JSONResponse({"answer": answer})

if __name__ == "__main__":
    app.run()
```json
在容器镜像中安装这些包,并在托管 Agent 上设置 OTLP 环境变量。Foundry 会在启动时把 FOUNDRY_* 变量注入每个托管 Agent 容器。它们是保留的只读变量,因此你的代码应当读取它们,但绝不应设置或覆盖它们:
pip install azure-ai-agentserver-invocations azure-ai-projects azure-identity \
    microsoft-opentelemetry

export OTEL_EXPORTER_OTLP_ENDPOINT="https://<your-motlp-endpoint>"
export OTEL_EXPORTER_OTLP_HEADERS="Authorization=ApiKey <your-api-key>"
```json
按照 Foundry 托管 Agent 文档把容器部署为托管 Agent,然后向它发送几个请求,JSON body 中包含 order_id、question、user_id 和 conversation_id。
那些会让 Foundry Agent span 悄悄丢失的细节
上面那个文件里有几个细节,比它们看起来更重要:
- 开启可观测性。 除非
ENABLE_OBSERVABILITY为true,否则这些 scope 什么都不做。只有当 Foundry 启用 Agent 365 导出时,host 才会自行开启它,因此示例文件主动设置该变量,以便无论哪种情况都能拿到进入 Elastic 的 span。没有它,Agent 会正常运行,但不会发出任何invoke_agent、chat或execute_toolspan。 - 用实例 ID,而不是 blueprint ID。
gen_ai.agent.id是 Agent 实例的 app ID。把 blueprint ID 放在那里会让 Agent 365 以 403 agent ID mismatch 拒绝导出。像示例那样两者都保留:实例 ID 放在AgentDetails.agent_id,blueprint ID 放在agent_blueprint_id,这样 Elastic 就能按 blueprint 汇总实例。 - 不要动
**gen_ai.agent.type**。微软将Foundry之类的值保留自用,而 Agent 365 会自行对注册在 Microsoft Entra 中的 Agent 分类。 - service name 由 host 设置。
service.name来自FOUNDRY_AGENT_NAME(由 Foundry 注入),而不是OTEL_SERVICE_NAME。缺少它时,span 会以azure.ai.agentserver的身份到达。 - operation name 是
**Chat**。该 distro 会把模型调用的gen_ai.operation.name写成Chat,首字母大写 C,而 Elastic 对 keyword 值的比较是区分大小写的。下文每个查询都用TO_LOWER()包裹该字段,以便同时匹配两种写法。 - Token 计数是数字。
gen_ai.usage.input_tokens和gen_ai.usage.output_tokens经 OTLP 以整数形式到达,因此查询可以直接相加,无需类型转换。Agent 365 自己的线路格式把所有内容都作为字符串发送,但 distro 会在它那一侧处理。
如果你基于 Microsoft Agent Framework、Semantic Kernel、LangChain、LangGraph 或 OpenAI Agents SDK 构建,该 distro 可以通过 instrumentation_options 参数替你完成埋点,这样你就可以去掉手写的 scope。自动埋点只记录标准 OTel 属性,因此 Agent 365 仍然需要来自 BaggageBuilder 的微软身份属性,或来自 host 读取的 FOUNDRY_AGENT_* 变量。
host 也会通过相同的 OTLP 设置发送指标。本文的面板只基于 trace 构建。在你基于指标构建面板之前,请先核对自己数据中的指标名称。
要确认数据已经到达,打开 Discover 的 ES|QL 模式并运行:
FROM traces-generic.otel-*
| WHERE attributes.gen_ai.operation.name IS NOT NULL
| STATS spans = COUNT(*) BY operation = attributes.gen_ai.operation.name
```json
你应该会看到 invoke_agent 和 Chat 的行,以及 execute_tool。如果缺少某一行,请检查 ENABLE_OBSERVABILITY。如果全都没有,请检查 API key 是否在 OTLP 端点上具备写权限。
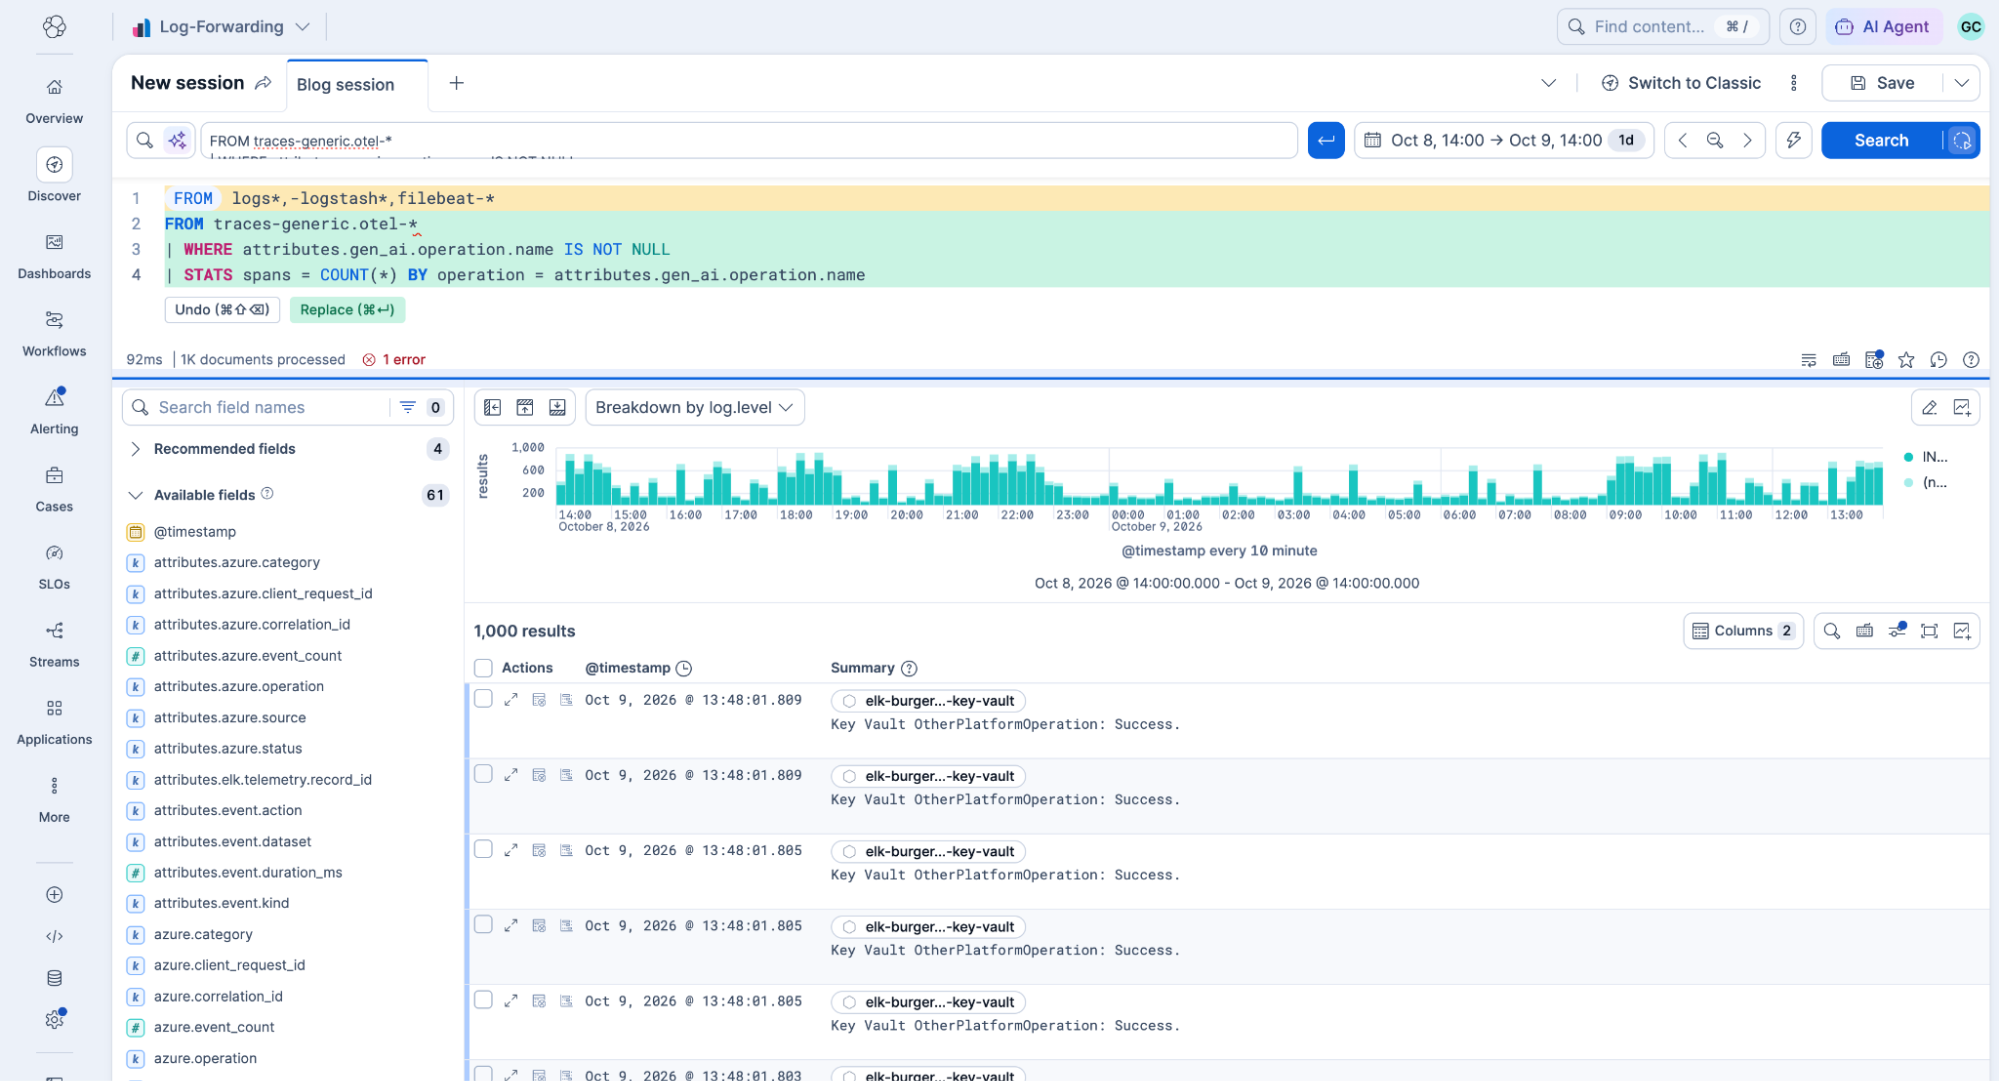
Kibana Discover 中用 ES|QL 查询按 gen_ai.operation.name 统计 Foundry Agent span:invoke_agent、Chat 与 execute_tool
决定 Elastic 接收哪些 prompt 与响应内容
除了每次工具调用的参数和结果之外,这些 scope 还能记录 prompt 和响应。示例中内容采集是关闭的,仪表盘的所有查询也都不需要它。但 Agent 365 只消费携带消息内容、工具参数和工具结果的 span,并会过滤掉缺少这些内容的不合格 span。你可以在关闭内容的情况下保持 Agent 365 导出开启,但 Agent 365 不会使用这些 span。如果你为了让它能用而打开内容采集,同一批 span 就会把这些内容一并带到 Elastic。
有三种处理方式:
方案 | Agent 365 | Elastic | 需要做什么 |
|---|---|---|---|
保持内容关闭 | 不会消费这些 span | 拿到仪表盘所需的全部数据 | 无需任何操作 |
内容开启,在 Elastic 中限制访问 | 消费这些 span |
| 字段级安全 |
内容开启,在进入 Elastic 前剥离 | 消费这些 span | 不存储任何内容 | 在 Agent 与 Elastic 之间部署一个带 attributes processor 的 OpenTelemetry Collector |
示例读取 CAPTURE_MESSAGE_CONTENT 环境变量,默认关闭。请在首次生产部署之前与隐私负责人一起做出这个选择,而不是之后。
Agent 365 导出的身份认证与许可
Elastic 侧只需要一样东西:一个对托管 OTLP(mOTLP)端点具备写权限的 API key。不要把它放进容器镜像。请存放在 Azure Key Vault 中,并作为 secret 提供给托管 Agent。
Agent 365 侧涉及的组件更多,全部记录在 Microsoft Learn 上:
- 租户中至少需要一个用户被分配 Microsoft 365 E7 或 Microsoft Agent 365 许可证。没有许可证时,HTTP 导出会返回 200 OK,但响应会把 span 报告为被拒绝,原因是
tenant_not_licensed。403 Forbidden 则意味着别的问题,即缺少必需的应用角色或委派作用域,或者 URL 中的 agent ID 与已认证身份不匹配。 - 已注册的 Agent 365 Agent 实例在服务到服务(service-to-service)路由上导出,无需额外权限或管理员同意。委派路由和未注册身份(例如标准的 app registration)需要
Agent365.Observability.OtelWrite权限并获得管理员同意。 - 对于服务到服务导出,任何未注册为 Agent 365 Agent 实例的身份——无论是 app registration 还是托管标识,甚至只是一个 agent ID——都需要
Agent365.Observability.OtelWrite应用角色和管理员同意。
Agent 365 可观测性属性都有什么用?
Agent 365 要求的必填属性比普通生成式 AI(GenAI)trace 更多。它们同时也是很有用的仪表盘维度,因为它们说明了是谁、在哪里、在哪个会话中:
属性 | 在 Elastic 中的用途 |
|---|---|
| 按租户过滤或拆分仪表盘。 |
| Agent 实例的 app ID。与 Agent 365 管理记录关联的键,也是下文新工具检测的分组键。 |
| 按 Agent 过滤仪表盘。 |
| 按 blueprint 汇总实例。 |
| 把运行归组为会话。 |
| 用于 session 和 channel 面板。channel 值是短小写 token,例如 |
| 调用方的 Entra 对象 ID。用于统计每位调用方的 Token 消耗与活动。 |
| 对比 function 工具与 Model Context Protocol(MCP)服务器。把 |
消息、工具参数、工具结果 | 内容。(见上文的决策。) |
微软的属性参考列出了全部属性,并注明每种 span 类型下哪些是必填的。示例设置了身份、会话、channel、调用方、工具类型、工具调用 ID、模型和 provider 属性。除了消息内容,Agent 365 还要求服务器地址和客户端地址,在依赖 Agent 365 侧之前,你应当对照自己的 Agent 实际发出的内容检查完整清单。
九个 ES|QL 查询:Foundry Agent 的成本、延迟与失败
下文每个查询对应一个仪表盘面板。字段名来自 OTel GenAI 语义约定以及 Agent 365 属性。微软与 Cisco 的 Outshift 合作,为多 Agent 系统扩展了这些约定,引入了 invoke_agent、plan、invoke_workflow、execute_tool 和内存操作等 span 类型。微软的 Agent trace 概览描述了它们,并指出 OTel GenAI 约定在上游仍处于 Development 状态,可能会发生变化。请固定你的 SDK 版本;如果某个查询返回为空,请对照一条实时 trace 检查字段名。
按模型统计的 Token 用量随时间变化
使用堆叠面积图。下面的查询按小时汇总输入与输出 Token,并按模型拆分总量,生成紧随其后的图表。这个面板能让失控的 Agent 一目了然。反复重试同一工具调用的循环,会表现为某个模型色带中的尖峰。
FROM traces-generic.otel-*
| WHERE TO_LOWER(attributes.gen_ai.operation.name) == "chat"
| STATS tokens = SUM(attributes.gen_ai.usage.input_tokens + attributes.gen_ai.usage.output_tokens)
    BY hour = BUCKET(@timestamp, 1 hour), model = attributes.gen_ai.request.model
| SORT hour
```json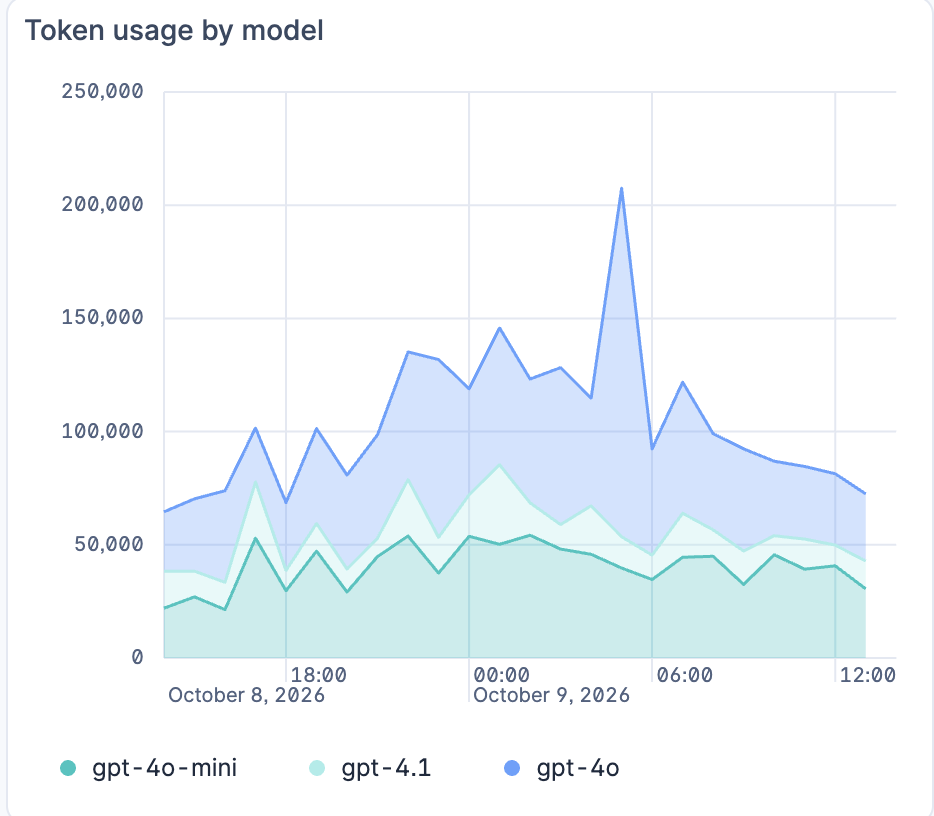
Foundry Agent 按模型统计的 Token 用量,其中 gpt-4o 在一小时内出现 207,000 Token 的尖峰
按模型估算的 Token 成本
使用水平条形图。查询把 Token 数量乘以每百万 Token 的费率。下面的费率是占位值,请替换为你自己 Azure 协议中的价格。任何没有匹配 CASE 行的模型都会返回 null 成本,因此请为你运行的每个部署添加一行。如果你的 Foundry 部署名称与底层模型名称不同,请改为按 attributes.gen_ai.response.model 分组,它携带的是实际作答的模型。
FROM traces-generic.otel-*
| WHERE TO_LOWER(attributes.gen_ai.operation.name) == "chat"
| STATS input_tokens = SUM(attributes.gen_ai.usage.input_tokens),
        output_tokens = SUM(attributes.gen_ai.usage.output_tokens)
    BY model = attributes.gen_ai.request.model
| EVAL cost_usd = CASE(
    model == "gpt-4o",      input_tokens / 1000000.0 * 2.50 + output_tokens / 1000000.0 * 10.00,
    model == "gpt-4o-mini", input_tokens / 1000000.0 * 0.15 + output_tokens / 1000000.0 * 0.60,
    model == "gpt-4.1",     input_tokens / 1000000.0 * 2.00 + output_tokens / 1000000.0 * 8.00,
    NULL)
| KEEP model, cost_usd
| SORT cost_usd DESC NULLS LAST
```json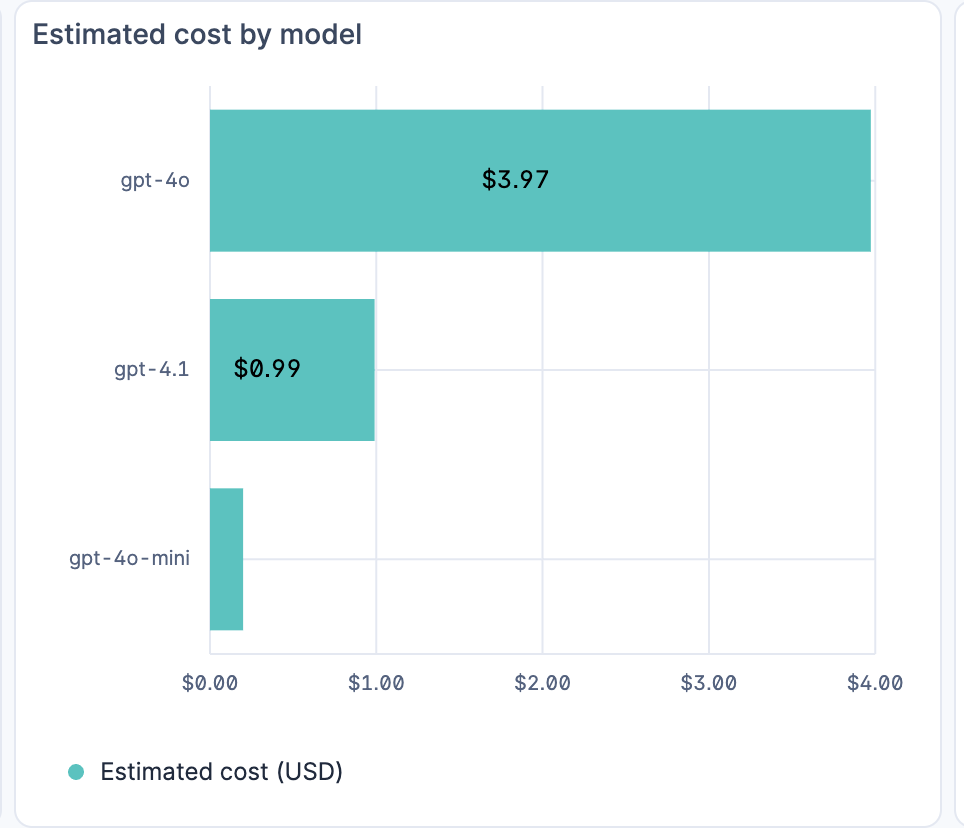
Foundry Agent 按模型估算的 Token 成本:gpt-4o $3.97,gpt-4.1 $0.99,gpt-4o-mini 低于 $0.10
Token 消耗最大的 Agent 运行
使用数据表。按 trace ID 汇总 chat span,得到的是整次 Agent 运行的成本,而不是单次模型调用,而排在最上面的一行通常就是第一个值得打开的。失败的模型调用不携带 Token 计数,因此 NULLS LAST 可以避免只由失败构成的运行挤占表格顶部。
FROM traces-generic.otel-*
| WHERE TO_LOWER(attributes.gen_ai.operation.name) == "chat"
| STATS input_tokens = SUM(attributes.gen_ai.usage.input_tokens),
        output_tokens = SUM(attributes.gen_ai.usage.output_tokens),
        chat_calls = COUNT(*)
    BY trace.id
| SORT input_tokens DESC NULLS LAST
| LIMIT 10
```json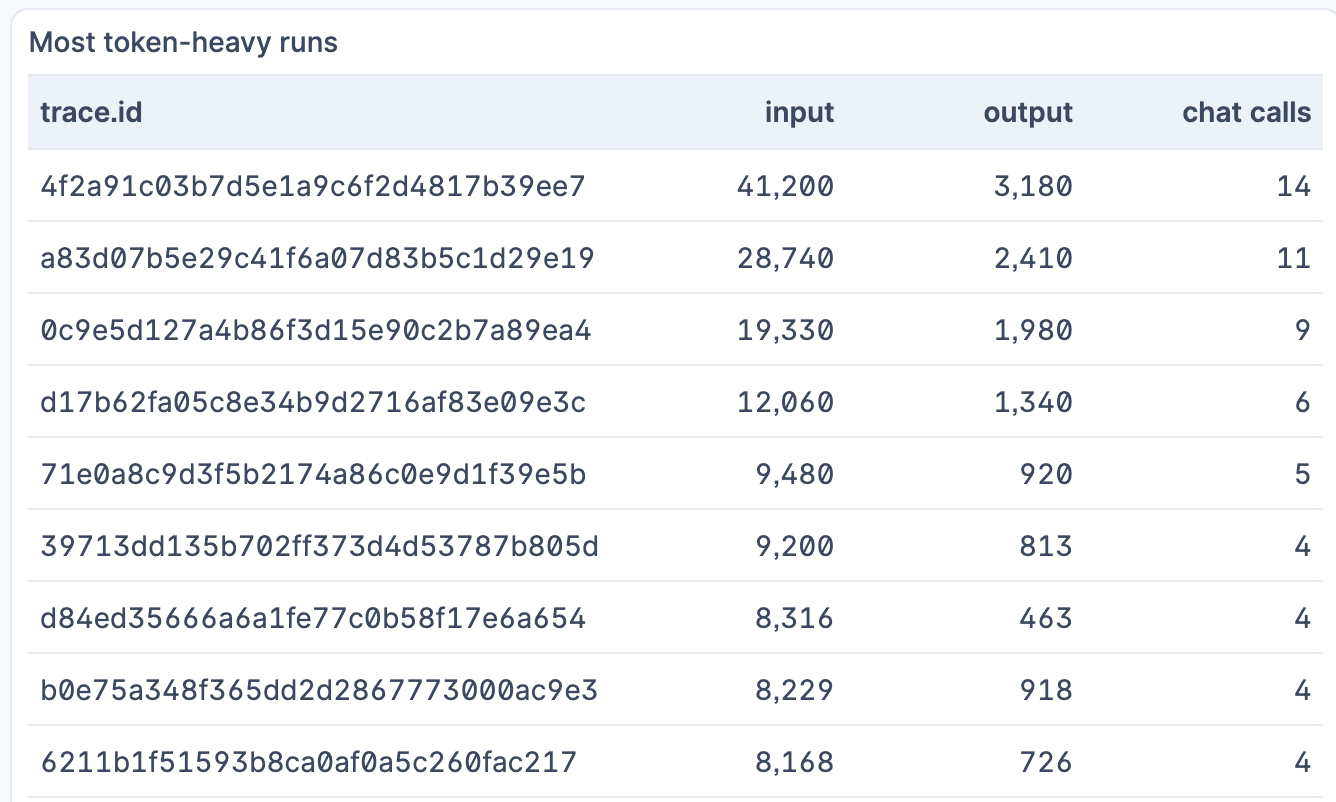
按 trace.id 统计的 Token 消耗最大的 Foundry Agent 运行,最高一条为 14 次 chat 调用共 41,200 输入 Token
按操作类型统计的延迟
使用分组条形图。对比每种操作类型的 p50 与 p95,可以看出慢是出在模型调用还是工具调用上,或者出在它们周围的编排上。OTel 以纳秒存储 span 的 duration,因此查询会转换为毫秒。
FROM traces-generic.otel-*
| WHERE TO_LOWER(attributes.gen_ai.operation.name) IN ("invoke_agent", "chat", "execute_tool")
| EVAL duration_ms = duration / 1000000.0
| STATS p50 = PERCENTILE(duration_ms, 50),
        p95 = PERCENTILE(duration_ms, 95)
    BY operation = TO_LOWER(attributes.gen_ai.operation.name)
```json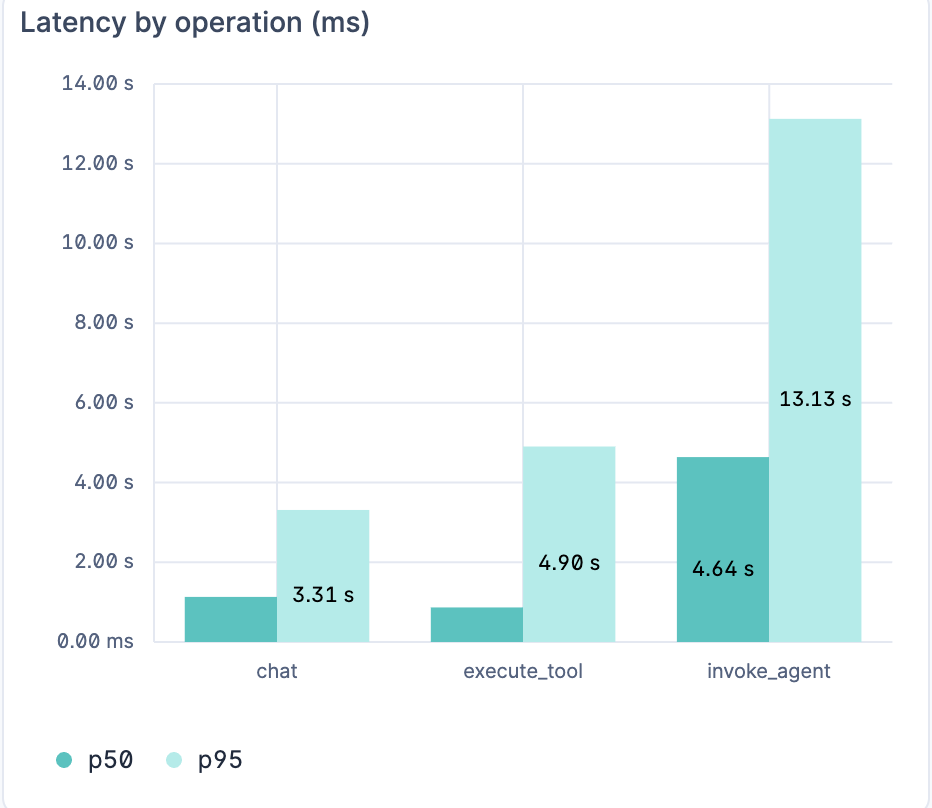
Foundry Agent 按操作统计的延迟:invoke_agent p95 13.13s,execute_tool 4.90s,chat 3.31s
按 p95 统计的最慢工具调用
使用水平条形图。按 p95 而不是平均值排序,可以避免一个平时很快、偶尔要花 10 秒的工具被健康的均值掩盖。
FROM traces-generic.otel-*
| WHERE TO_LOWER(attributes.gen_ai.operation.name) == "execute_tool"
| EVAL duration_ms = duration / 1000000.0
| STATS p95_ms = PERCENTILE(duration_ms, 95), calls = COUNT(*)
    BY tool = attributes.gen_ai.tool.name
| SORT p95_ms DESC
| LIMIT 10
```json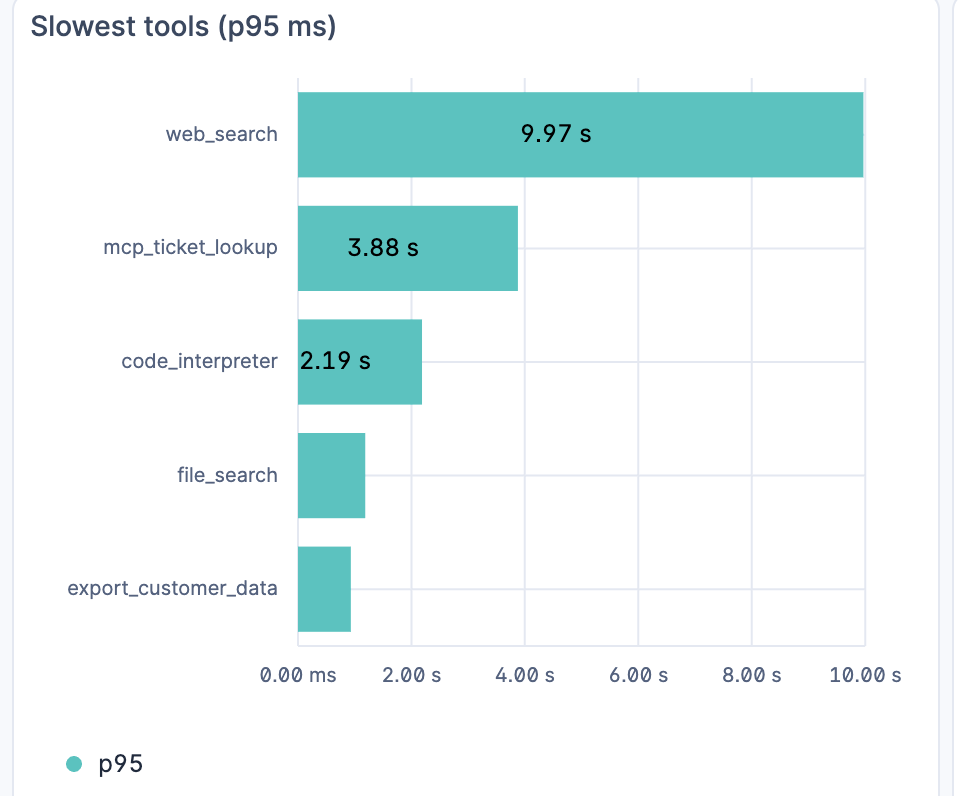
按 p95 统计的最慢 Foundry Agent 工具调用:web_search 9.97s,mcp_ticket_lookup 3.88s,code_interpreter 2.19s
按操作与错误类型统计的失败 span
使用数据表。按操作和错误类型分组,可以把 provider 限流和内容过滤器拦截与工具超时区分开,它们有不同的负责人和不同的修复方式。
FROM traces-generic.otel-*
| WHERE attributes.gen_ai.operation.name IS NOT NULL
    AND status.code == "Error"
| STATS failures = COUNT(*)
    BY operation = TO_LOWER(attributes.gen_ai.operation.name), error_type = attributes.error.type
| SORT failures DESC
```json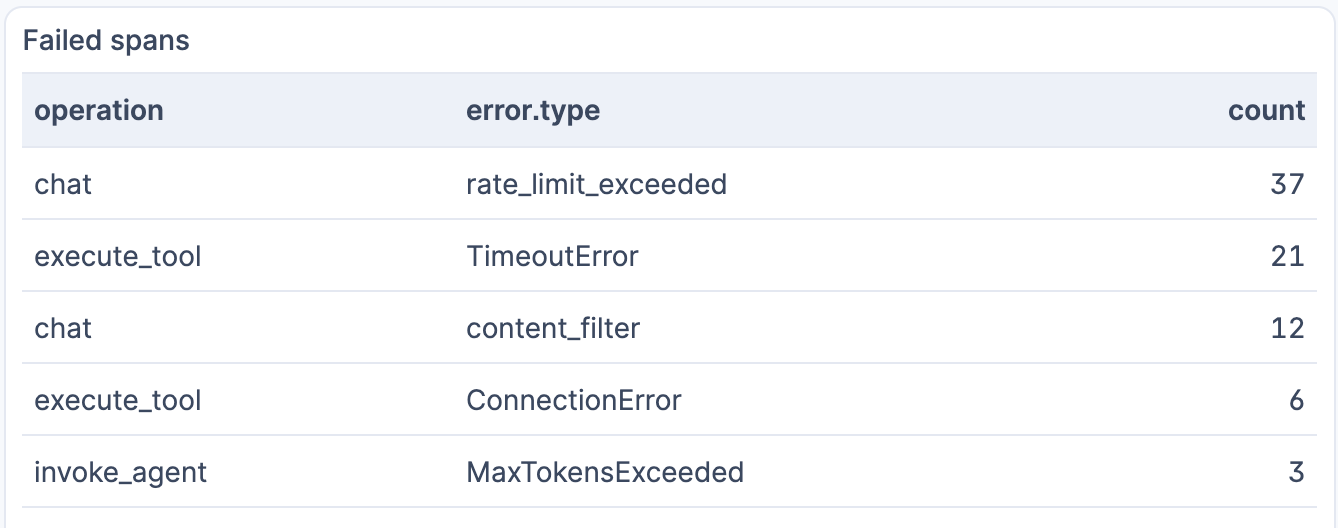
按 channel 统计的 Agent 运行:Teams、Outlook 与 Web
使用水平条形图。Agent 365 记录每次运行来自哪个界面,例如 Teams、Outlook 或 Web。对比各 channel 可以看出 Agent 实际在哪里被使用,以及在出问题时应该先看哪个 channel。
FROM traces-generic.otel-*
| WHERE TO_LOWER(attributes.gen_ai.operation.name) == "invoke_agent"
| STATS runs = COUNT(*) BY channel = attributes.microsoft.channel.name
| SORT runs DESC
```json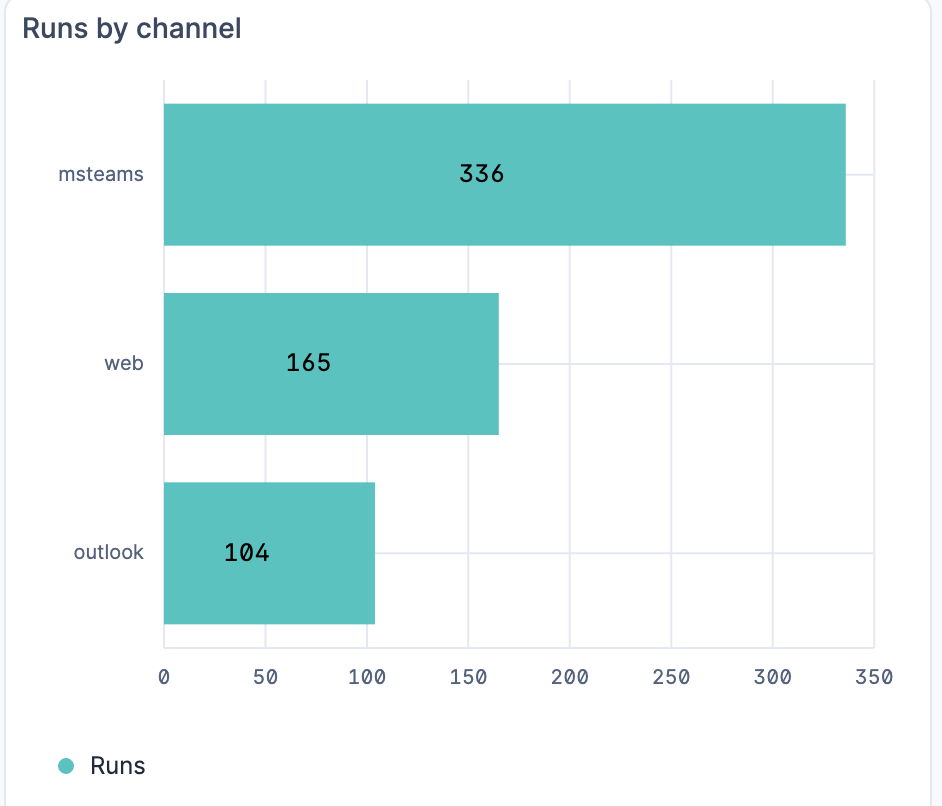
按 Agent 365 channel 统计的 Foundry Agent 运行:Microsoft Teams 336 次,Web 165 次,Outlook 104 次
按调用方统计的 Token 消耗
使用数据表。Token 记录在 chat span 上,而调用方记录在根 invoke_agent span 上,因此查询先按 trace 汇总 Token,并从同一条 trace 中取出调用方,然后再按调用方汇总一次。调用方是 user.id 中的 Entra 对象 ID。可以在 Entra 中把它解析为姓名,或在 Elastic 中做富化。
FROM traces-generic.otel-*
| WHERE TO_LOWER(attributes.gen_ai.operation.name) IN ("invoke_agent", "chat")
| STATS run_tokens = SUM(attributes.gen_ai.usage.input_tokens + attributes.gen_ai.usage.output_tokens),
        caller = MAX(attributes.user.id)
    BY trace.id
| WHERE caller IS NOT NULL
| STATS runs = COUNT(*), tokens = SUM(run_tokens) BY caller
| SORT tokens DESC NULLS LAST
| LIMIT 10
```json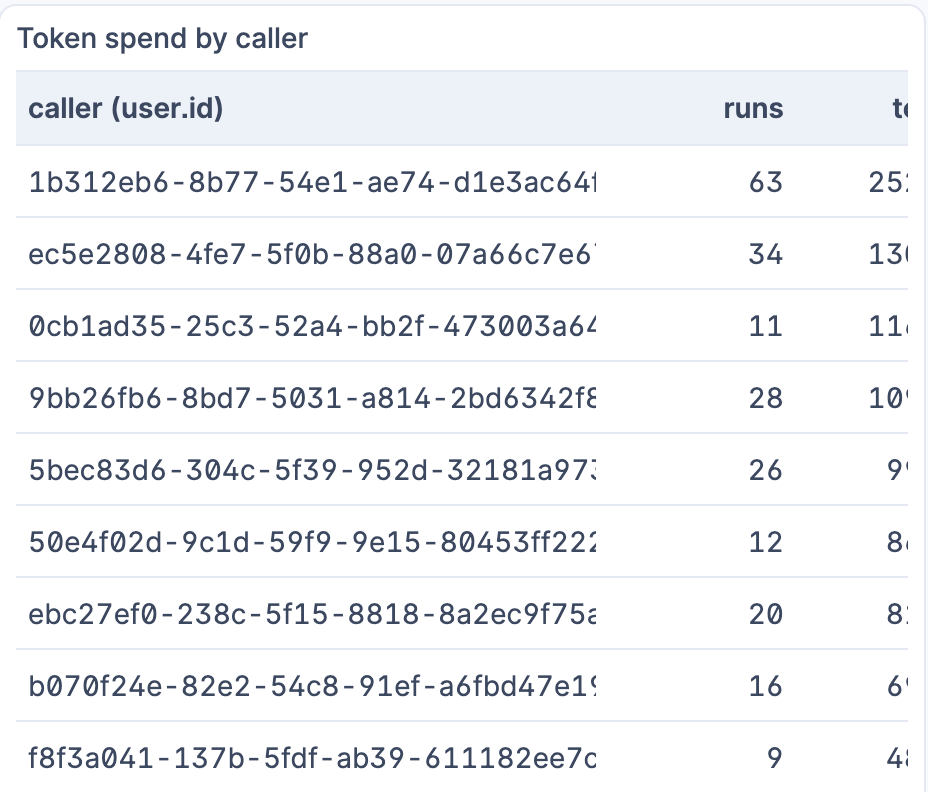
按调用方统计的 Foundry Agent Token 消耗,最高的一位 Entra 用户 ID 在 605 次运行中占了 63 次
最繁忙的 session 与会话
使用数据表。session 是一次访问,conversation 是其中的一个线程。当你想了解人们实际如何使用 Agent 时,应当打开那些运行次数多、会话数也多的 session。
FROM traces-generic.otel-*
| WHERE TO_LOWER(attributes.gen_ai.operation.name) == "invoke_agent"
| STATS runs = COUNT(*),
        conversations = COUNT_DISTINCT(attributes.gen_ai.conversation.id)
    BY session = attributes.microsoft.session.id
| SORT runs DESC
| LIMIT 10
```json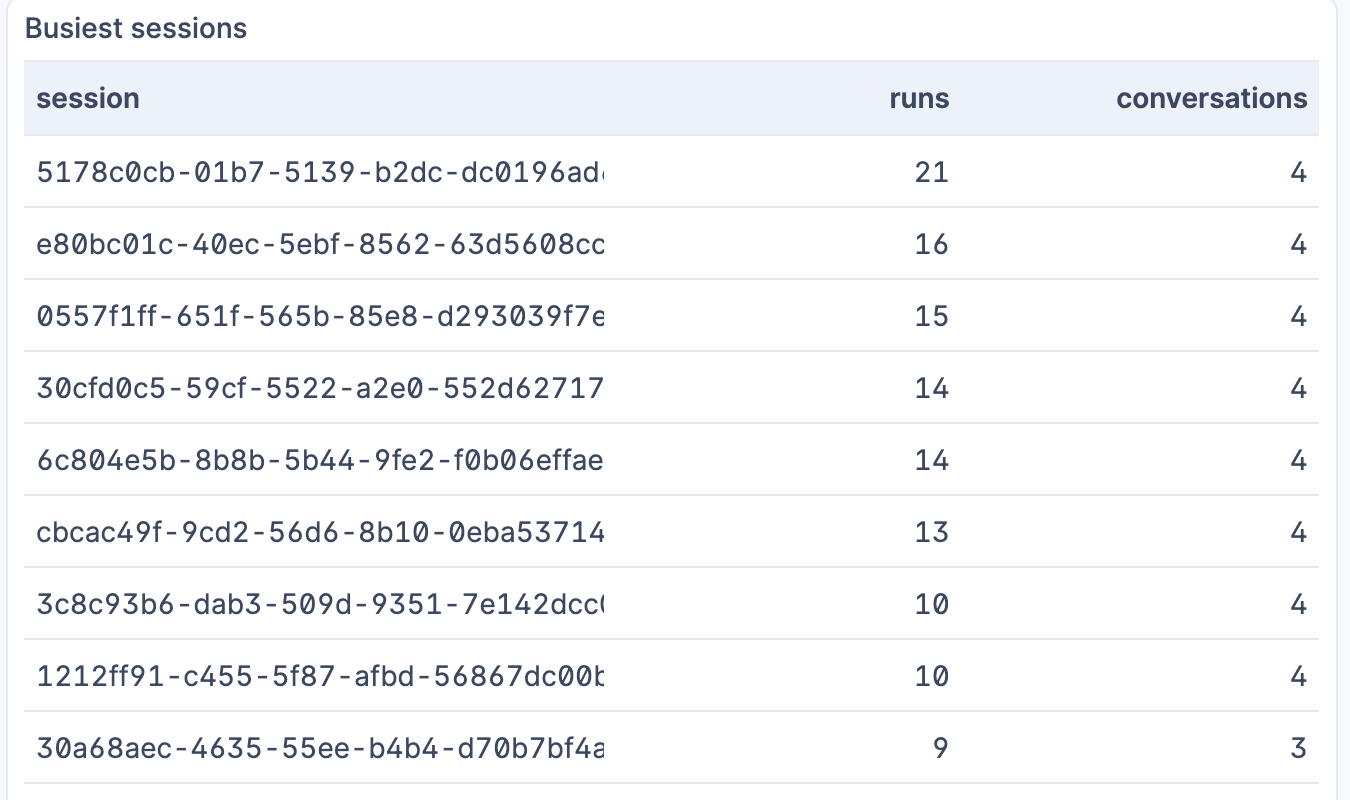
在 Kibana 中构建 Foundry Agent 仪表盘
你可以导入一个现成的仪表盘,也可以按以下步骤逐面板构建。
导入现成的 Kibana 仪表盘
foundry-agent-traces-dashboard.ndjson 是该仪表盘的导出文件,包含全部九个面板以及针对 agent、tenant、channel、conversation 和 session 的五个过滤器。要把它导入你自己的 Kibana:
- 打开 Stack Management,然后打开 Saved Objects。在 Elastic Cloud Serverless 上,打开 Project settings、Management,然后打开 Saved objects。
- 选择 Import,选择
**.ndjson**文件,并保留默认选项。 - 打开 Dashboards,选择 Foundry agent traces。时间选择器默认为最近 24 小时。
这些面板读取 traces-generic.otel-*,并未限定为单个 Agent,因此会覆盖写入该数据流的每个 Agent。要缩小范围,请使用顶部的 Agent 和 Tenant 过滤器。
你也可以通过 saved objects API 导入该文件:
curl -X POST "https://<your-kibana-url>/api/saved_objects/_import?overwrite=true" \
  -H "Authorization: ApiKey <your-api-key>" \
  -H "kbn-xsrf: true" \
  -F file=@foundry-agent-traces-dashboard.ndjson
```json
逐面板构建仪表盘
要手动创建仪表盘:
- 在 Kibana 中打开 Dashboards,新建一个仪表盘。
- 选择 Add panel,然后选择 ES|QL。
- 粘贴其中一个查询并运行。Kibana 会根据结果形状推荐图表类型,因此请选择上文为该查询列出的类型。
- 把面板保存到仪表盘,然后对其余查询重复上述步骤。
仪表盘的时间选择器通过 @timestamp 作用于每个 ES|QL 面板,因此查询中无需为时间过滤添加任何内容。要按 agent、tenant、channel、conversation 或 session 过滤,请为该字段添加一个 ES|QL control,就像导入的仪表盘所做的那样。
请注意,示例中的 lookup_order 工具会立即返回,因此在你包裹真实调用之前,自己的工具面板会显示接近零的延迟。
生成 605 次示例 Agent 运行以填充仪表盘
如果你还没有一个繁忙的 Agent,generate_sample_traces.py 会通过 OTLP 发送 24 小时的真实感 trace,外加一周的历史数据。它发出的 invoke_agent、Chat 和 execute_tool span 以及 Agent 365 属性与上面的容器相同,共 605 次 Agent 运行、约 3,000 个 span,服务名为 support-agent-sample。
pip install opentelemetry-sdk opentelemetry-exporter-otlp-proto-http

export OTEL_EXPORTER_OTLP_ENDPOINT="https://<your-motlp-endpoint>"
export ELASTIC_API_KEY="<your-api-key>"
python generate_sample_traces.py
```json
脚本覆盖当前小时之前的 24 个完整小时,因此仪表盘的默认时间范围会完整显示这些数据。上文预览中的每个面板都来自这份数据,下一节中的每个数字都可以通过运行脚本和查询复现。
示例数据说明了什么:一次 Token 尖峰、一个慢工具和 79 次失败
本文开头的预览来自上面的示例数据。它包含四个工具(web_search、mcp_ticket_lookup、code_interpreter、file_search),而最小容器只有一个,因此你自己的工具面板会列出你的 Agent 实际调用的工具。Kibana 按浏览器的时区绘制时间轴,因此你图表上的时钟时间会与预览不同。有四件事值得注意:
- Token 图表在窗口结束前约九小时处有一个陡峭的尖峰,集中在
gpt-4o色带,约为通常每小时总量的两倍。Token 消耗最大的运行表说明了原因:那一小时里有四次运行分别使用了 12,060 到 41,200 个输入 Token,而典型运行只有几千个;其中最高的一条 trace4f2a91c0发起了 14 次模型调用。这四次运行合计约 110,000 个 Token,构成了尖峰的大部分。把排名第一的 trace ID 粘贴到 Elastic APM 中即可打开瀑布图。如果它显示 Agent 反复调用同一个工具,你就发现了一个循环,而循环会返回 HTTP 200,永远不会抛出错误。 - 工具面板把
**web_search**的 p95 排在约 10 秒,远远领先于其他所有项,延迟面板显示了它的代价:invoke_agent的 p95 为 13.1 秒,而 p50 为 4.6 秒。任何触及web_search的运行都要为此付出代价。 - 失败 span 表把 79 次失败拆分为
chat上的限流(37)、工具超时(21)、内容过滤器拦截(12),外加一小部分连接错误(6)和触及 Token 上限(3)。限流失败指向模型部署上的配额问题,超时则指向同一个慢工具。web_search上 10 秒的 p95 主要就是这些超时,因此修复它们对这个数字的改善最大。 - 调用方和 channel 面板说明了这些数字背后是谁。 在 605 次运行中,336 次来自 Teams,165 次来自 Web,104 次来自 Outlook。消耗最高的调用方在 63 次运行中约占 253,000 个 Token,也就是说少数调用方驱动了大部分花费。当 Token 图表中的尖峰与某位调用方对得上时,你就知道该查看谁的使用情况、该去问谁。
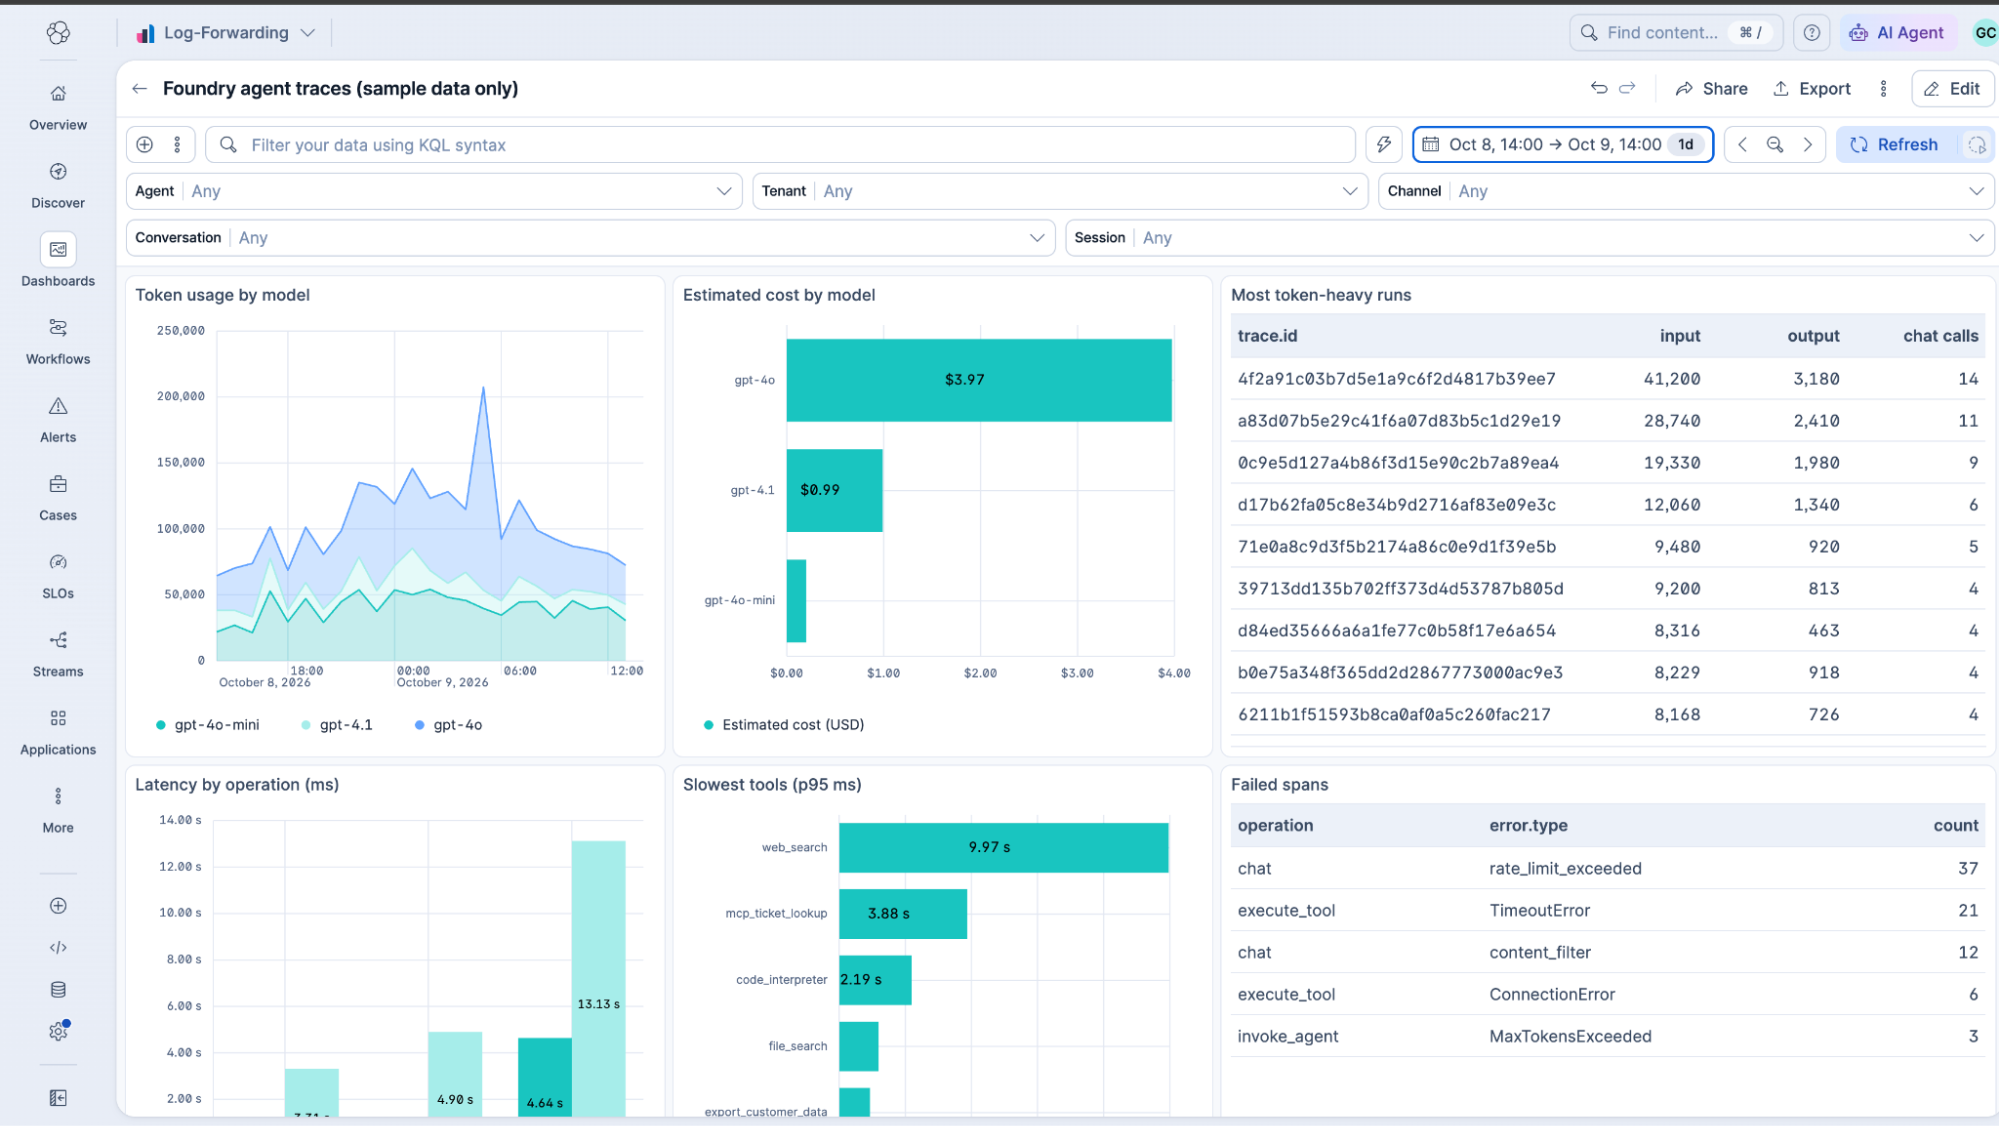
Microsoft Foundry Agent trace 的 Kibana 仪表盘:Token 用量、预估成本、延迟、最慢工具与失败 span
捕获 Foundry Agent 调用从未使用过的工具
一个 Agent 突然调用它从未调用过的工具,值得一看。这可能是一个新功能,也可能是 prompt injection 在把 Agent 引向它不该触碰的东西。下面的查询基于 30 天回溯窗口,找出最近一天内首次出现的 Agent 与工具组合。
FROM traces-generic.otel-*
| WHERE TO_LOWER(attributes.gen_ai.operation.name) == "execute_tool" AND @timestamp >= NOW() - 30 days
| STATS first_seen = MIN(@timestamp), calls = COUNT(*)
    BY agent_id = attributes.gen_ai.agent.id, tool = attributes.gen_ai.tool.name
| WHERE first_seen > NOW() - 24 hours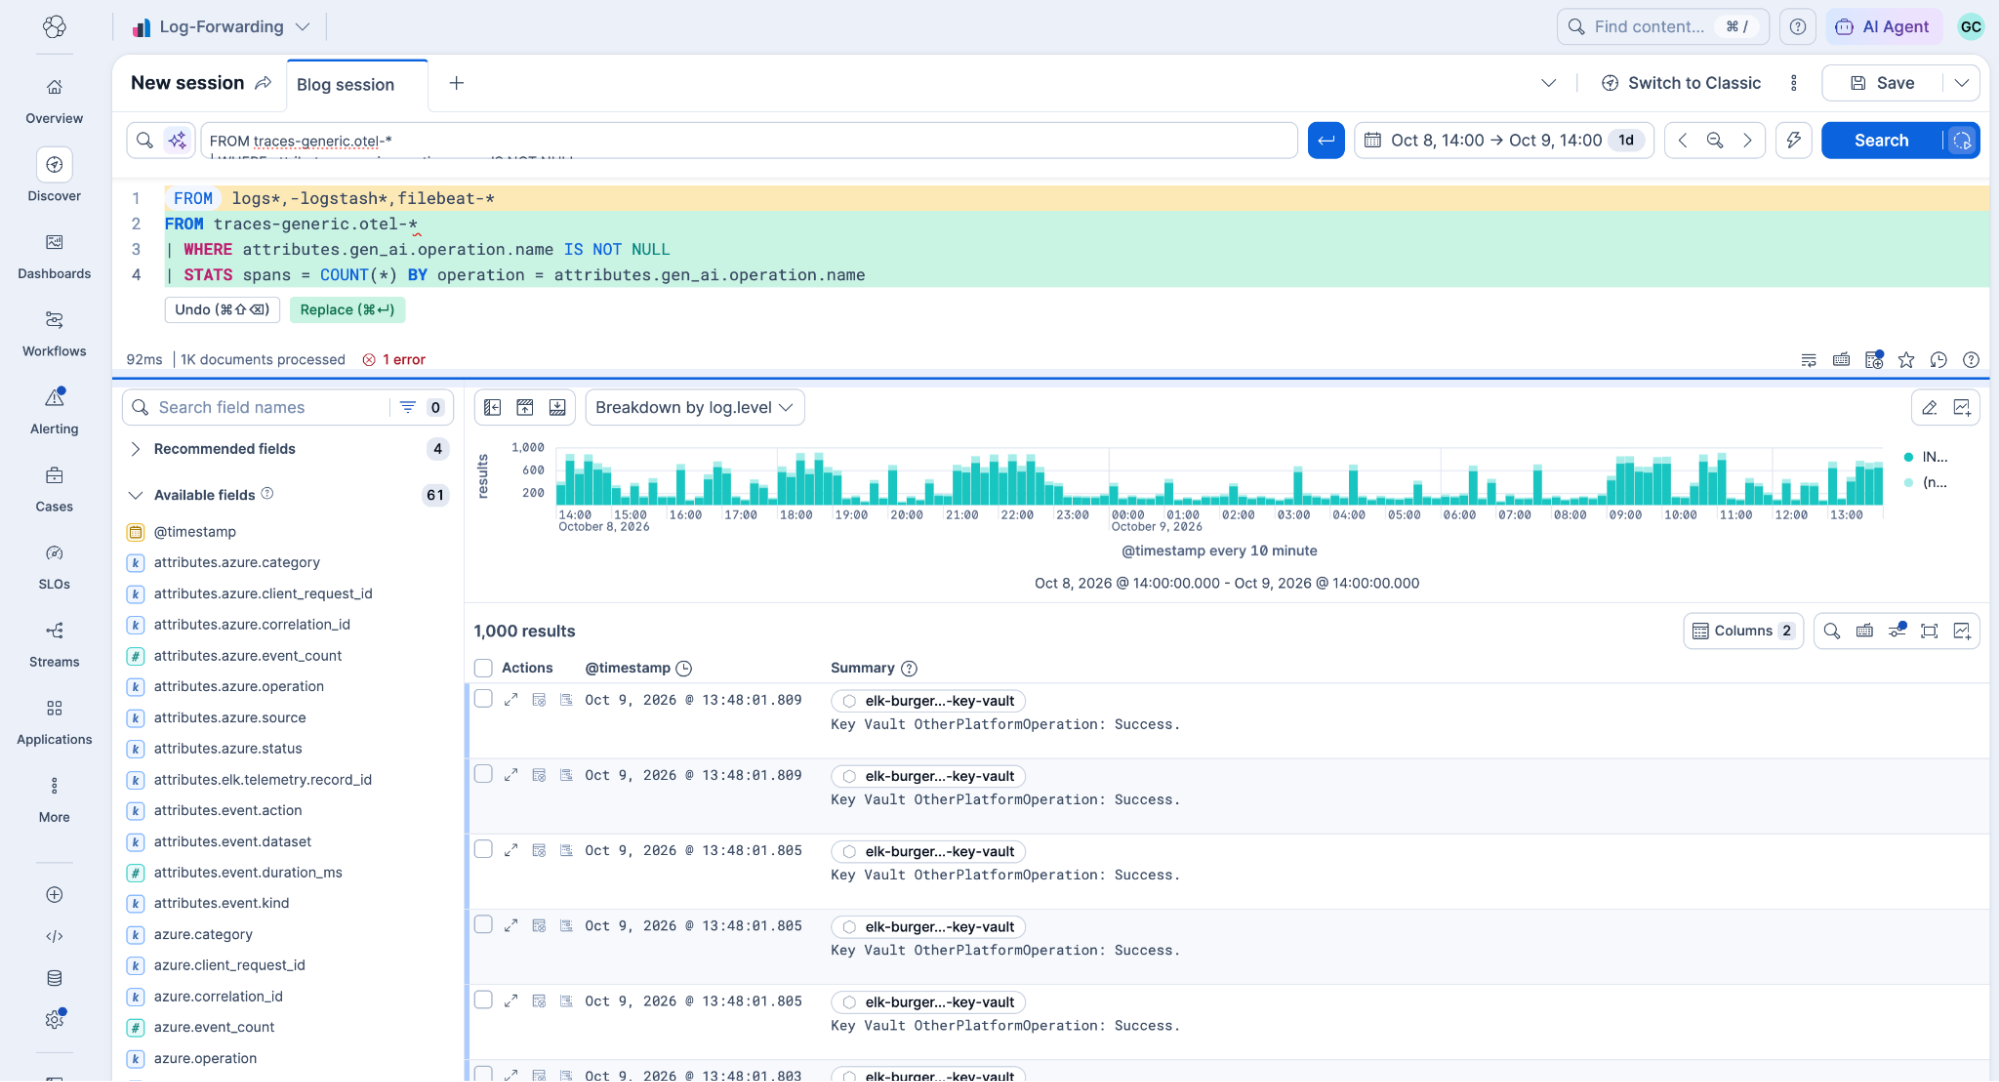
Kibana Discover 中的 ES|QL 查询,找出最近 24 小时内首次出现的 Foundry Agent 与工具组合
示例数据中就有一次:export_customer_data 出现在窗口的最后几小时,而该 Agent 此前只使用过它的四个常规工具。要把它作为检测来运行,请打开 Elastic Security,新建一条 ES|QL 规则,粘贴查询,并按小时调度。如果你不使用 Elastic Security,它也可以作为普通的 Kibana 告警使用。每次新增工具的部署之后都会有噪声,因此请在规则运行一周后调整回溯窗口并抑制已知工具。
能否从 Foundry prompt agent 或 Copilot Studio 获取 trace?
这套仪表盘方案覆盖的是 Foundry 托管 Agent——你拥有容器,可以把它的 span 发往任何地方。prompt agent 完全运行在 Foundry 内部,没有容器可供埋点,因此其服务端 trace 留在 Application Insights 中。Microsoft Copilot Studio 和 Microsoft 365 Agent 同样运行在微软一侧,没有属于你的容器可以添加 exporter。本文的任何内容都不会把这些 trace 发往 Elastic。桥接它们或许是可行的,例如把 Application Insights 数据导出到 Azure Event Hubs,再用 Elastic 的 Azure 集成读取,但那是另一条管道、另一套 schema(也是后续文章的话题)。
生产环境检查清单:采样、版本固定与内容采集
在上线之前就决定 Elastic 接收哪些消息内容,而不是之后。
采样会改变数字。这些面板对到达的 span 求和,因此如果你使用尾部采样只保留 10% 的常规 trace,Token 和成本总量会大致按这个比例少算。像前一篇文章建议的那样保留错误和慢 trace,并且要么对 Agent trace 不做采样,要么按采样率缩放成本面板。
固定你的版本。示例在 azure-ai-agentserver-core 2.2.0、azure-ai-agentserver-invocations 1.2.0、azure-ai-projects 2.8.0 和 microsoft-opentelemetry 1.3.9 上测试过。distro 和 GenAI 约定都在演进,上文提到的 Chat 大小写就是那种可能在版本之间变化的细节。每个查询中的 TO_LOWER() 能让仪表盘继续工作——如果它确实还在工作的话。
在账单到来之前对失控的 Token 用量告警
从 Token 消耗最大的运行查询开始。把它保存为一条 ES|QL 告警规则,在任意单条 trace 超过你正常单次运行 p95 略高的 Token 阈值时触发,这样循环中的 Agent 会在同一小时通知你,而不是出现在月度账单上。然后添加新工具检测,并在开启 Agent 365 导出之前,决定你的 Elastic 项目应当保存哪些内容。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号