知识库、Agent 记忆、Context Layer:中间层百花齐放,底座为什么还是 Elasticsearch
原创
知识库、Agent 记忆、Context Layer:中间层百花齐放,底座为什么还是 Elasticsearch
原创
点火三周
发布于 2026-11-18 20:13:21
发布于 2026-11-18 20:13:21
知识库、Agent 记忆、Context Layer,名字一个比一个新。但如果你把这些产品拆开,往下看一层,会发现它们需要的东西几乎一样。
这篇文章想说清楚一件事:中间层怎么换,底座都应该选 Elasticsearch。
三个词,向底层要的是同一样东西
先把这三个词摆在一起看。
知识库是最老的叫法。企业把文档导进去,用 RAG 让模型检索后回答。它解决的是“查得到”:制度、手册、合同、工单。
Agent 记忆是今年创业圈最热的方向。Agent 要记住用户是谁、上次聊到哪、做过哪些决定。它解决的是“记得住”:跨会话、跨任务,而且每个用户的记忆不能串。
Context Layer 是英文圈今年讨论最多的企业 AI 术语之一,主要由数据治理厂商在推。按国内目前流行的拆法,它包含四类上下文:业务口径的语义、数据的血缘、新鲜度和质量这类运营信号,以及权限合规这类策略约束。它解决的是“懂业务”:Agent 拿到的数据要口径对、版本新、有权限。
三件事听起来各不相同。但它们在运行时做的动作是一样的:Agent 要干活之前,从一大堆数据里找出此刻该用的那一小部分,交给模型。
所以它们对底层提的要求也一样,就四条:
- 找得准。 关键词、语义、图片,用户怎么问都能找到。
- 找得快。 Agent 一个任务要查很多轮,每一轮慢一点,整个任务就慢很多。
- 不越权。 每一次检索都要带上“这个人能看什么”。
- 够新。 刚改的制度、刚发生的对话,下一秒就要能查到。
TextIn 发布会上讲的痛点也印证了这一点:信息散在各个系统里,同一份材料有多个版本,Agent 容易漏掉信息、用错过时资料。这四条里,没有一条是中间层自己能解决的。它们都是检索引擎的事。
中间层越热闹,底座越不该跟着换
看一个具体的例子。腾讯开源的知识库框架 WeKnora,早期 README 里支持的检索后端只有两个:PostgreSQL(pgvector)和 Elasticsearch。现在的列表是八个:pgvector、Elasticsearch、OpenSearch、Milvus、Weaviate、Qdrant、Apache Doris、Tencent VectorDB,通过一个环境变量切换。
这说明两件事。
第一,中间层正在变得中立。框架作者不想替你选底座,所以把能接的都接上。这是好事,选择权回到了企业手里。
第二,选择权回到企业手里,选错的代价也回到了企业手里。框架可以明年换一个,后年再换一个。但数据进了哪个引擎,权限在哪里配,运维团队熟悉哪套系统,这些是换不动的。
检索方法也一样在换。过去两年,从向量 RAG 到 GraphRAG,再到 SAG 和 SAG2,每一代都有人宣布上一代“死了”。SAG2 的开源实现 SAG-Wiki 是一个本地桌面工具,用的是 SQLite。但同一个团队的主力产品 SAG,生产部署方案里列的存储组合是 MySQL / PostgreSQL / OceanBase 加 Elasticsearch。桌面上可以随便试,真到了企业里,还是要一个能扛住的引擎。
所以企业该问的问题不是“现在哪个中间层最火”,而是:下一次中间层换代的时候,我的数据要不要跟着搬?
如果底座选对了,答案是不用。
为什么是 Elasticsearch
“支持列表里有 ES”和“应该选 ES”是两回事。八个后端都能接,凭什么是它?
答案是:三种中间层各自最难的那一块,Elasticsearch 都在同一个引擎里给了。下面一个一个说。
知识库:最难的是“怎么问都能找到”
纯向量检索的问题大家已经见过了:表名、条款编号、产品型号这类精确的词,embedding 接不住。SAG2 证明了 BM25 加上判定模型可以在多跳问题上赢过纯向量,但它自己的评测里,语义类问题又是最弱的一类。
结论很简单:词法和语义,两条腿都要有。
在 Elasticsearch 里,同一份数据可以同时建 BM25 倒排索引和 semantic_text 向量索引,用 retriever 的 RRF 在一次请求里融合。重排可以通过 Inference API 接任何 reranker。中文场景下,IK 分词、同义词、领域词典都是现成的。想做 SAG 那样的多轮检索循环,more_like_this 和 significant_text 能直接做“从好结果里挑词、再查一轮”。腾讯云 ES 的官方文档里,也有完整的 RRF 混合检索说明。
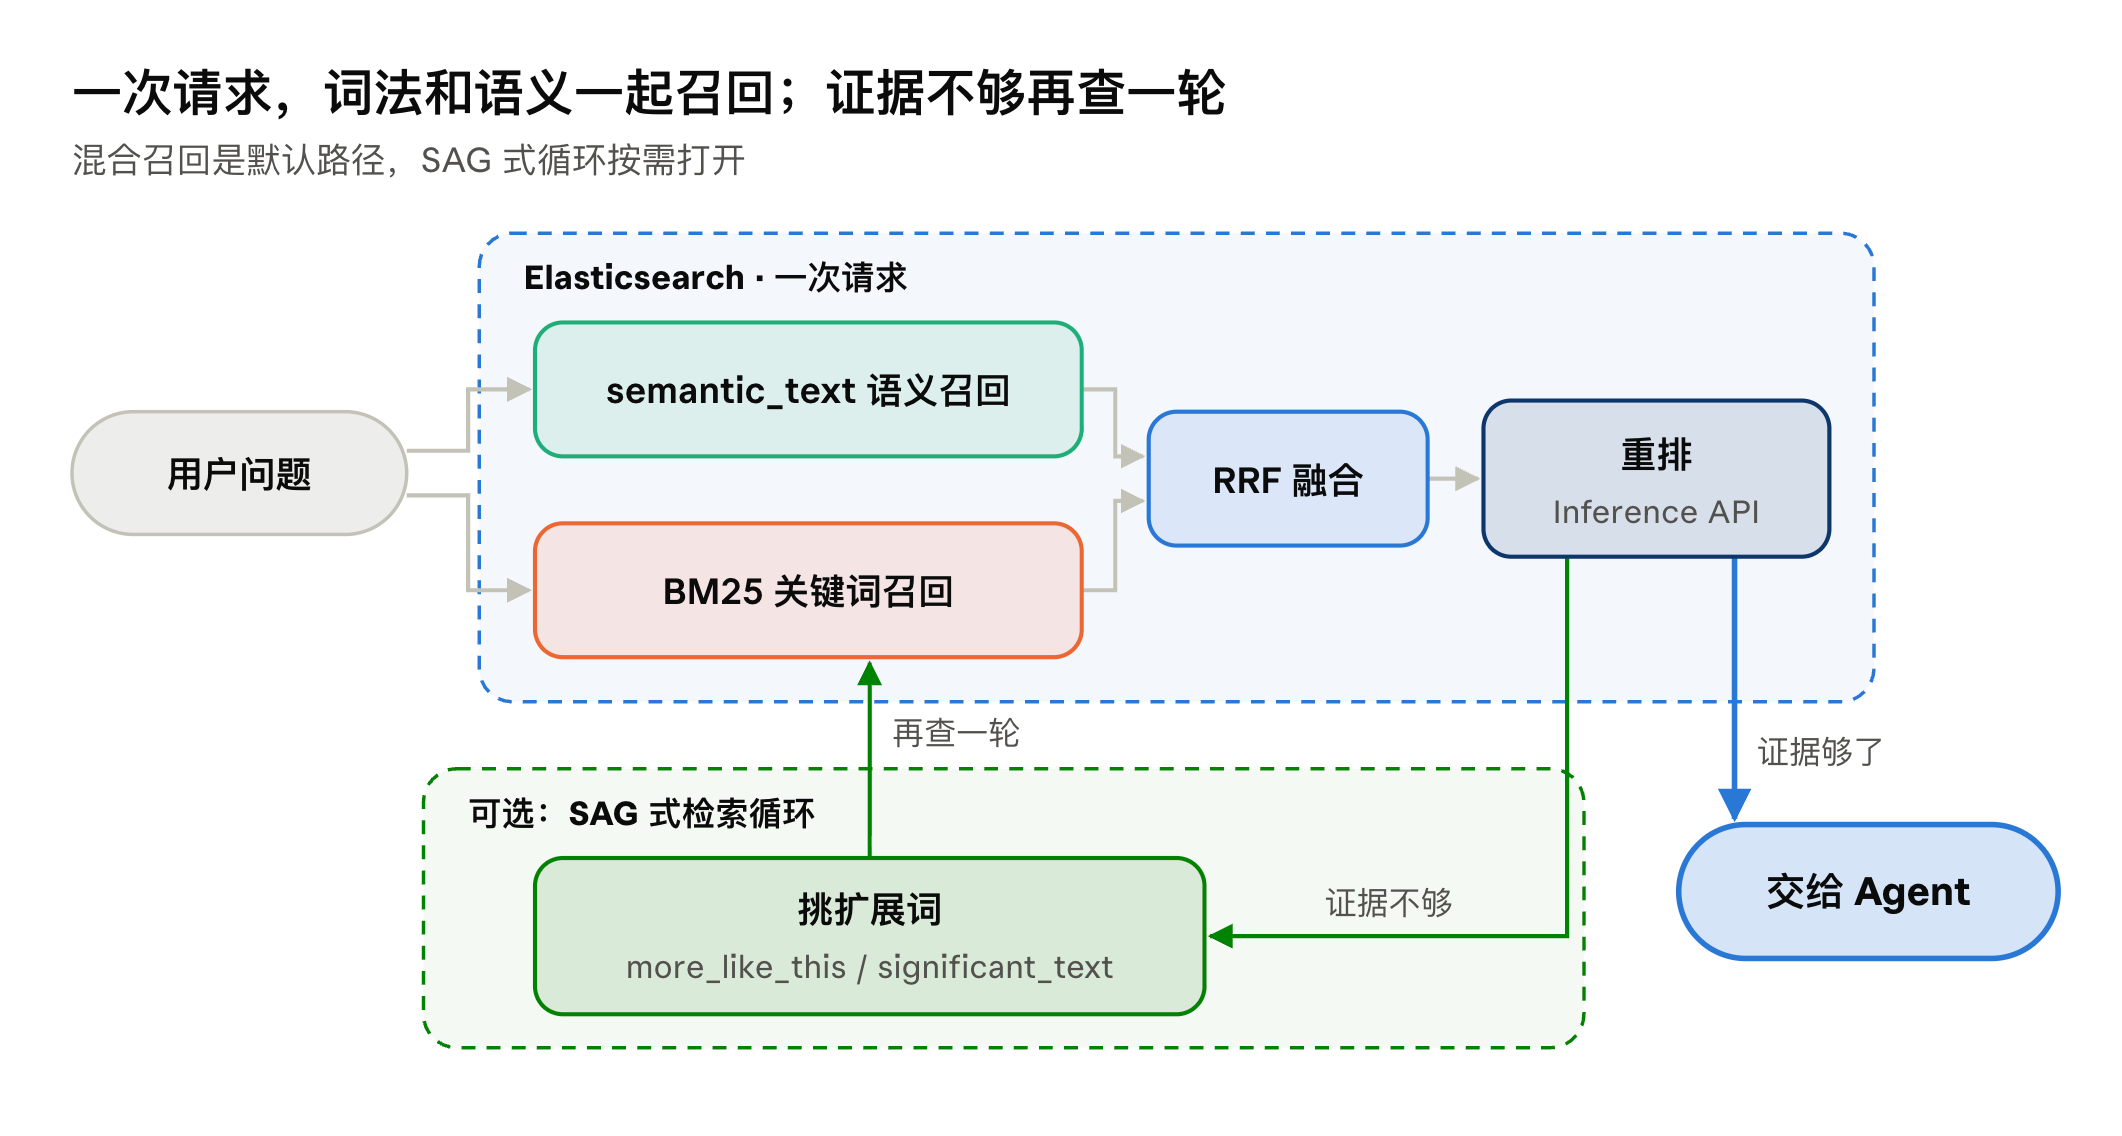
上半部分是常规的混合检索:关键词和语义两路同时召回,用 RRF 融合后重排。下半部分是可选的 SAG 式循环:证据不够时,从好结果里挑词再查一轮。两条路用的是同一份索引。
今天选 RAG,明年想试 SAG,改的是查询,不是数据。
Agent 记忆:最难的是“又新又不串”
记忆和文档不一样。它写得多,变得快,而且强烈地属于某一个人。
这对底座提了三个具体要求,Elasticsearch 都有对应:
- 写进去马上能查。 默认 1 秒刷新,Agent 刚记下的东西,下一轮对话就能检索到。
- 越新越重要。 用 decay 函数按时间给分数打折,三个月前的偏好自然排在昨天的后面。旧记忆可以用 ILM 自动降级、归档或删除。
- 每个人只看到自己的。 文档级安全(DLS)在引擎层过滤,不是查完再过滤。几千个用户的记忆放在一个索引里,也不会串。
还有一点经常被忽略:记忆检索往往是“结构化条件 + 语义”混在一起的。比如“这个用户上周在项目 A 里做过的、和预算有关的决定”。用户 ID、时间、项目是过滤条件,“和预算有关”是语义。Elasticsearch 在一个查询里就能同时处理这两部分。
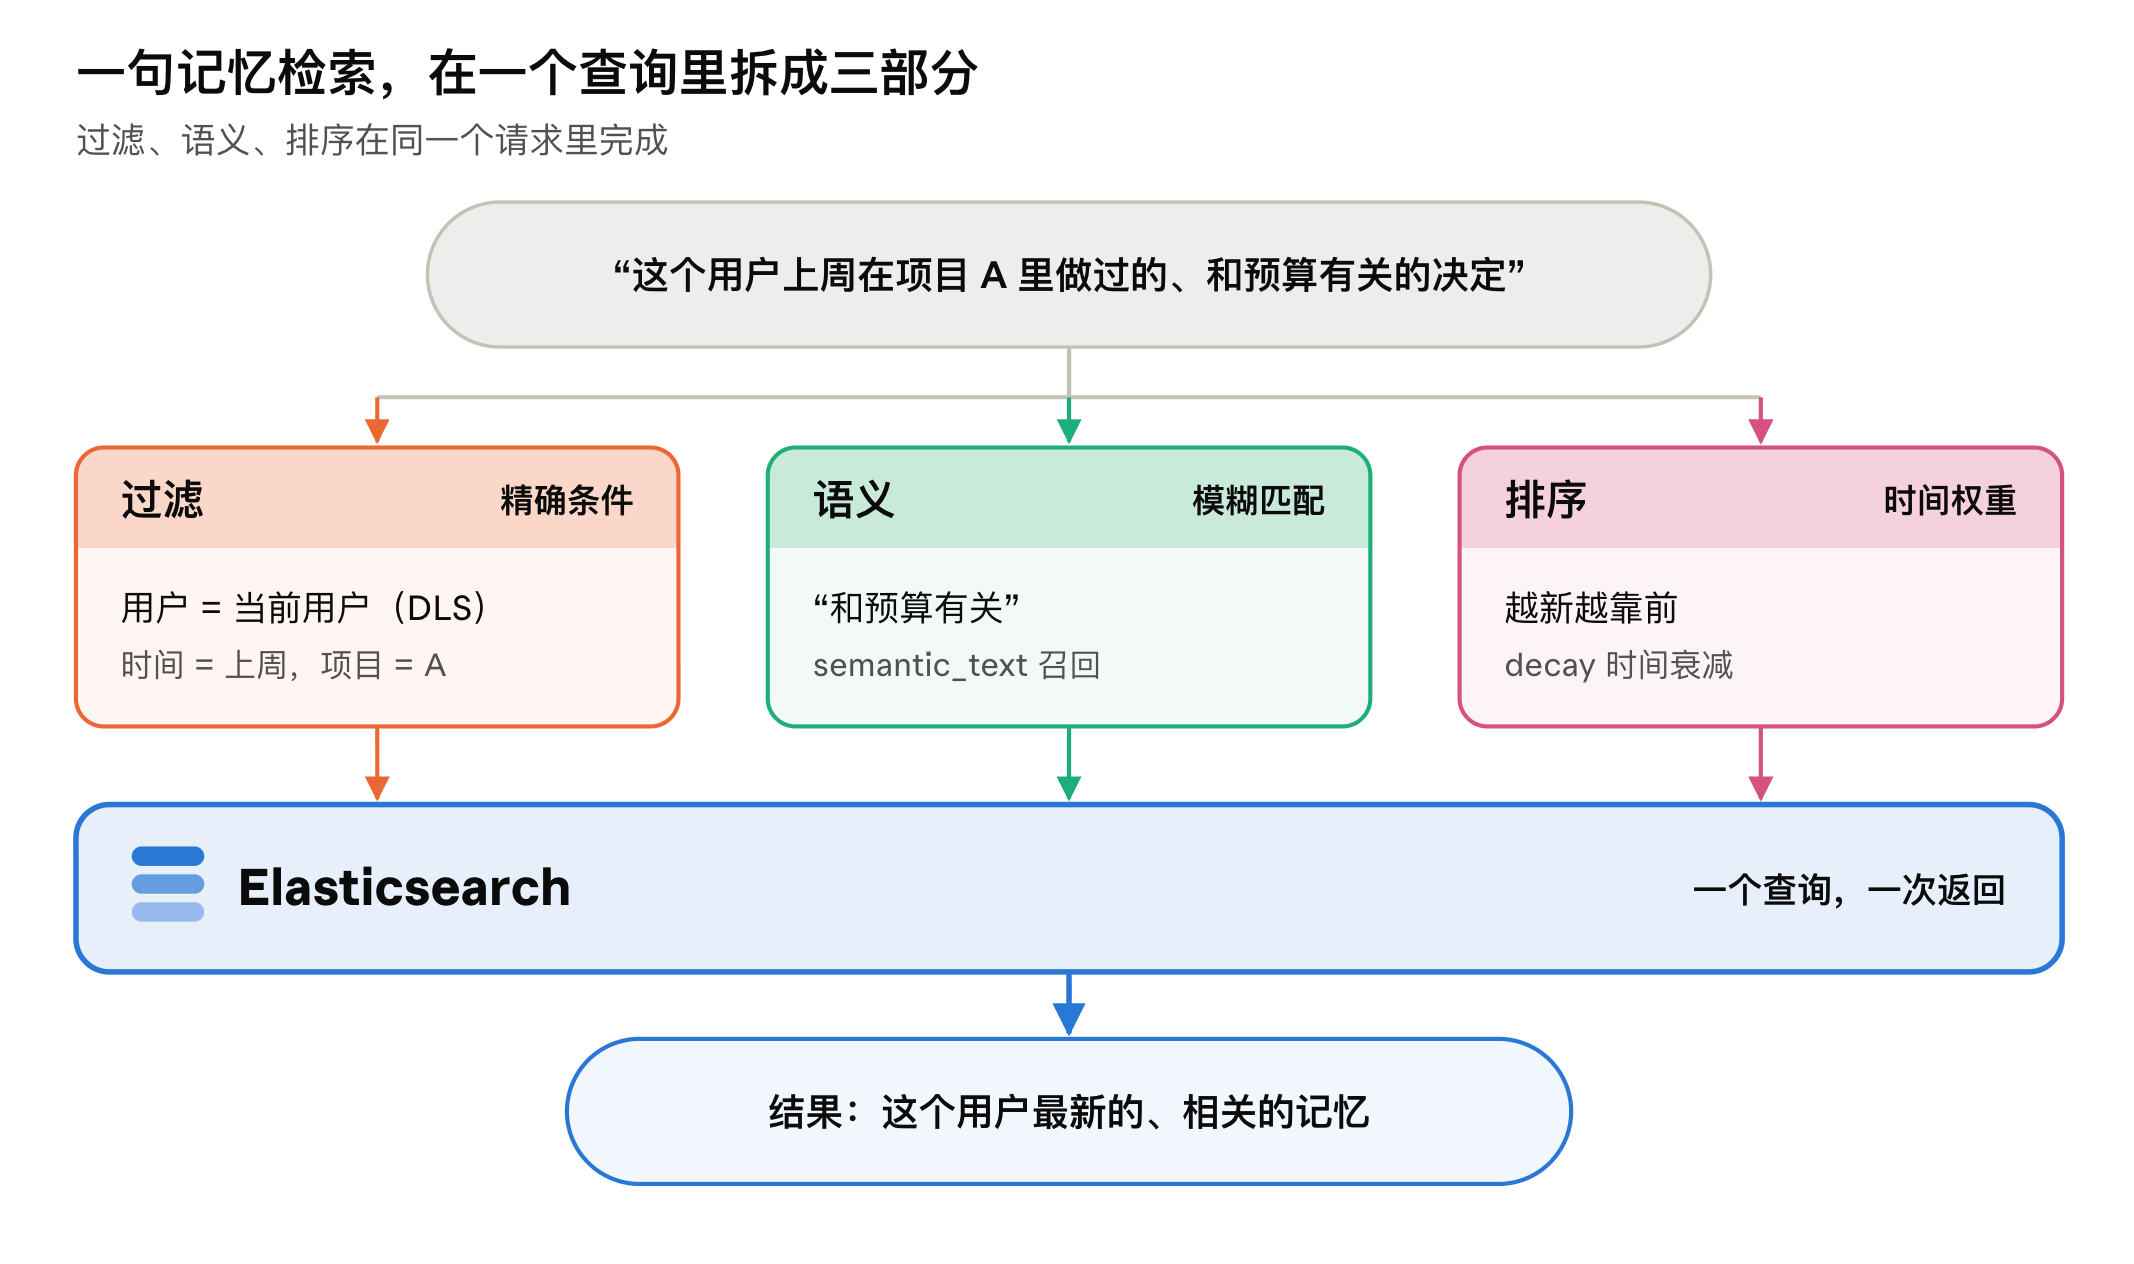
一句自然语言的记忆检索,在 Elasticsearch 里拆成三部分:权限和条件过滤、语义召回、按时间衰减排序,最后一次返回。
Context Layer:最难的是“口径对、版本新、有权限”
Context Layer 要汇总的东西散在各处:数据目录里的口径定义、数仓里的血缘、各个系统里的文档和工单。Agent 需要一个地方,能一次查全。
Elasticsearch 本来就是做这件事的:把异构数据统一索引,再按需检索。元数据、文档、日志可以放在同一个集群里,用同一套权限控制。每条数据带着时间戳,“这个口径是什么时候更新的”可以直接查出来,也可以直接用来排序。
更重要的是可观测。Agent 每一轮检索查了什么、拿到了什么、为什么漏了某一条,都可以记成 trace 存回 Elasticsearch。Context Layer 一旦出错,Agent 会非常自信地给出错误答案。能把过程查清楚,比什么都重要。
一个引擎,三种形态
把三块放在一起看,ES 真正的优势不是某一项功能。PostgreSQL 也能做 BM25,Milvus 的向量也很快。它的优势是:知识库、记忆、Context Layer 可以跑在同一个引擎上。
这意味着一份数据,一套权限,一套运维,一套监控。中间层框架换了,下面不动。
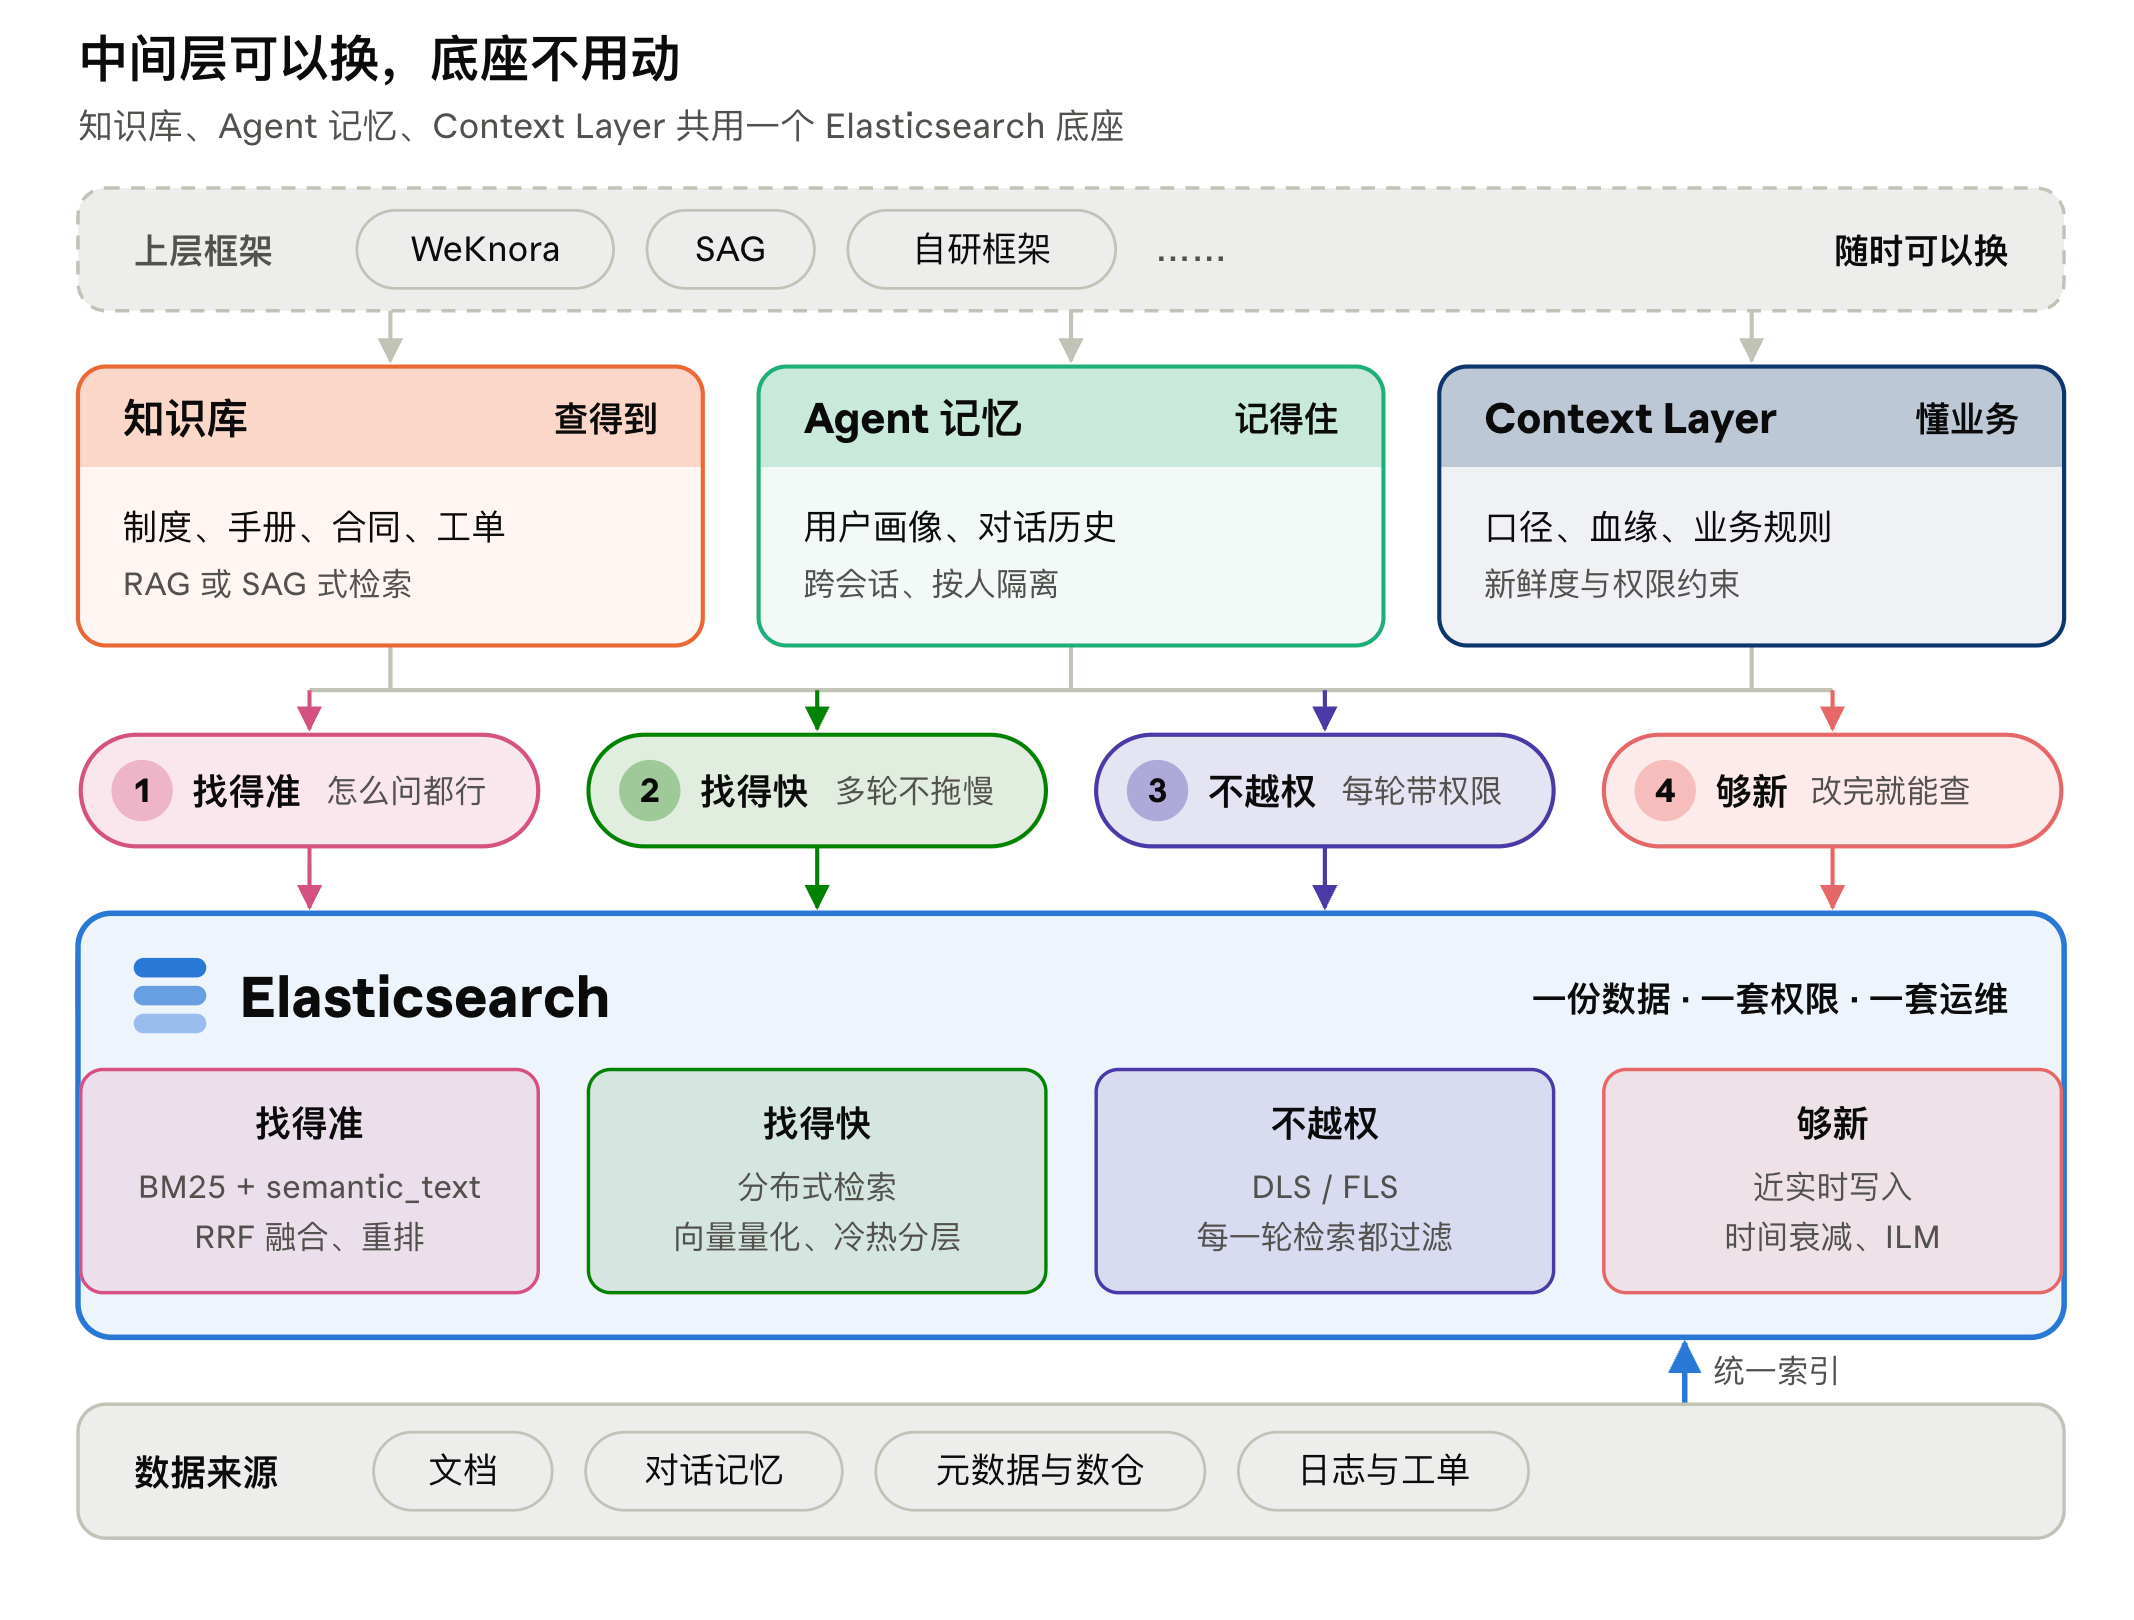
知识库、Agent 记忆和 Context Layer 对底层提的是同样四个要求,Elasticsearch 在一个引擎里全部给出;上层框架怎么换,下面不动。
规模上来之后,比的是成本
上面说的都是“能不能做”。真到了企业里,很快会变成另一个问题:做这么多,要花多少钱?
一个几千人的企业,知识库可能有几百万份文档,记忆每天新增几十万条,Context Layer 还要汇总各个系统的元数据。切成段落、算成向量之后,很容易就是十亿级。全放在内存里,成本会非常高。
这正是底座之间真正拉开差距的地方。Elasticsearch 在这几年做了很多降本的工作:BBQ 量化可以把向量压到原来的一小部分,冷热分层可以把不常查的数据放到便宜的存储上,还有基于对象存储的存算分离。
这部分涉及的数字和配置比较多,下一篇单独算账:《十亿向量放哪里?用 Elasticsearch 给知识库和 Context Layer 算一笔账》。
Elasticsearch 不做什么
最后要说清楚边界,免得这篇文章读起来像“ES 什么都能干”。
Context Layer 里最难的那部分,是定义口径:什么叫“活跃用户”,GMV 包不包含退款,哪张表是权威来源。这是数据治理和语义层的工作,需要业务方和数据团队坐下来一条条定。Elasticsearch 不替你做这件事。
它做的是:口径定义好以后,让 Agent 在需要的时候,又准、又快、又不越权地把它找出来。
这个分工其实是件好事。上面的中间层可以百花齐放,可以每年换一个最新的框架,可以从 RAG 换到 SAG 再换到下一个名字。下面的底座只做一件事,而且一直做下去。
所以,下一次你看到一个新的知识库、记忆层或 Context Layer 产品,可以先问它一句:你的底座是什么?能不能换成 Elasticsearch?
如果能,你就可以放心地去试。试错的成本,只是换一个框架。
参考来源
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号