Midscene.js 能解决什么,又解决不了什么
原创
图片
你写过这样的自动化脚本吗?
#app > div.ant-modal-wrap > div:nth-child(2) > button.ant-btn-primary页面改了个版,这串 CSS 选择器直接失效。你打开 DevTools,对着 DOM 树一层层数,改完这个又坏那个。UI 自动化的维护成本,一大半耗在这类"脆弱定位符"上。
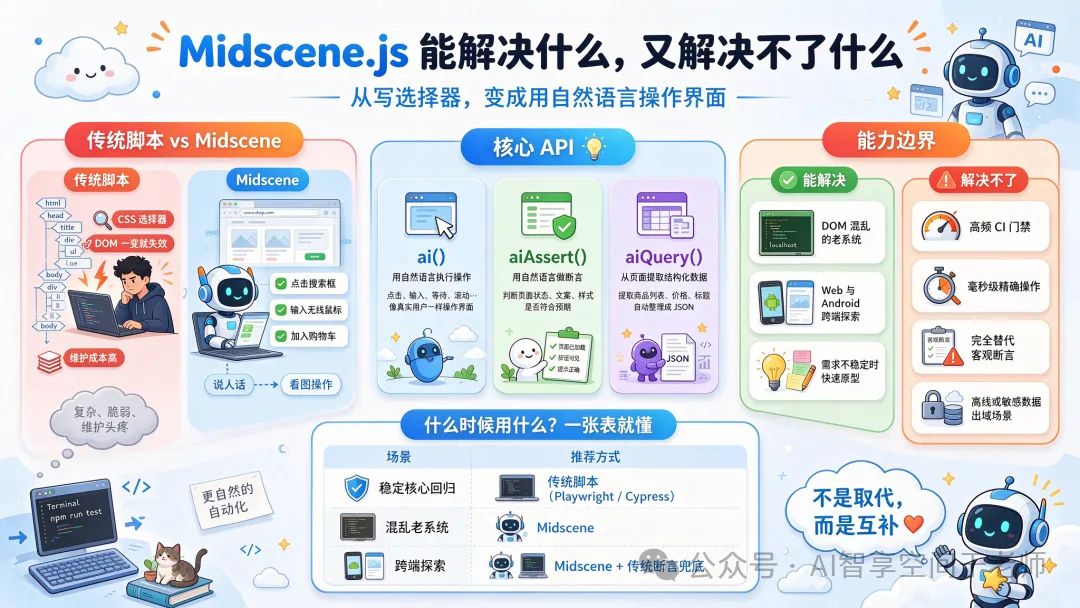
Midscene.js 换了个思路:既然人是看着屏幕操作的,那 AI 也看着屏幕操作。它用视觉模型理解界面,你用自然语言说"点击搜索框,输入无线鼠标,加购",它自己看图找到位置、完成操作。不写选择器,不怕 DOM 结构变化。
听起来很美。但它不是万能的——视觉驱动有自己的成本、稳定性边界和适用区间。这一篇,我把 Midscene.js 能解决的、需要小心的、根本解决不了的讲清楚,再给你一张和传统脚本的分工表。
一、从"定位 DOM"到"理解画面"
传统自动化走的是 DOM 定位路线:靠 CSS 选择器 / XPath 找到元素,操作它。优点是精确、快;缺点是 DOM 一变就失效。
Midscene.js 走的是 视觉理解路线:截取屏幕画面,用多模态大模型理解"哪个是搜索框""哪个是加购按钮",然后输出操作。优点是抗 DOM 变化(只要看起来没变就行)、贴近人的操作方式;缺点是每次要调视觉模型,有成本和延迟。
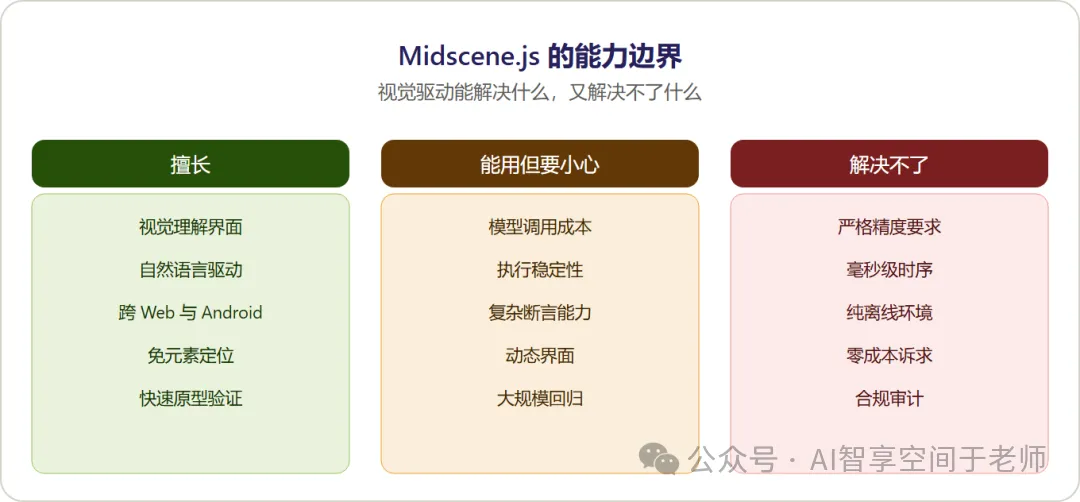
Midscene 能力边界
Midscene 能力边界
它提供三类核心 API(以官方文档为准):
ai():用自然语言执行操作,如ai('点击搜索框并输入无线鼠标')aiAssert():用自然语言做断言,如aiAssert('页面显示订单确认')aiQuery():从页面提取结构化数据,如aiQuery('返回所有商品的价格')
一句话记住:它把"写选择器"变成了"说人话",把"DOM 结构"变成了"视觉画面"。
二、5 分钟上手
看一个典型流程(以 Playwright 集成方式为例,API 以官方文档为准):
import { chromium } from'playwright';
import { PlaywrightAgent } from'@midscene/web';

const browser =await chromium.launch();
const page =await browser.newPage();
await page.goto('https://shop.example.com');

const agent =newPlaywrightAgent(page);

// 自然语言驱动:不用写任何选择器
await agent.ai('在搜索框输入"无线鼠标"');
await agent.ai('点击搜索按钮');
await agent.ai('在结果列表里找到第一款商品,点击加入购物车');
await agent.ai('点击右上角购物车图标');
await agent.ai('点击结算按钮');

// 自然语言断言
await agent.aiAssert('结算页显示商品"无线鼠标",数量 1');

// 结构化提取
const total =await agent.aiQuery('提取页面上的应付总金额');
console.log(total);// { value: 129.00, currency: 'CNY' }
对比传统脚本,你会发现:没有一行 CSS 选择器,全是人话。页面 DOM 怎么变都无所谓,只要视觉上"搜索框还在那个位置"。
三、能解决什么
场景 1:DOM 结构混乱、选择器难写的老系统
很多老系统的 DOM 是"祖传"的——层层嵌套、动态 class、没有稳定的 testid。给这种系统写传统自动化是噩梦。Midscene 直接看图操作,绕开了 DOM 混乱的问题。
场景 2:跨端统一——Web 和 Android 用同一套人话
Midscene 同时支持 Web 和 Android。同一句"搜索并加购",在 Web 和 App 上都能跑。对需要多端覆盖的团队,这降低了脚本的分裂程度。
场景 3:快速原型和探索性验证
需求还不稳定、页面还在改的时候,写传统脚本是浪费——改一次页面改一次脚本。用 Midscene 说人话快速验证流程走得通,等页面稳定了再决定是否固化成传统脚本。
四、解决不了什么
边界 1:成本和延迟——每次操作都要"看一眼"
视觉驱动每次操作都要截图 + 调视觉模型。一条 10 步的用例,可能要调十几次模型,成本和耗时远高于传统脚本(传统脚本是纯代码执行,几乎零延迟)。
这意味着:Midscene 适合"执行频率不高但维护成本高"的场景(如探索、跨端、老系统),不适合"高频回归、要求秒级反馈"的 CI 门禁。
边界 2:精度要求高的操作——它不如代码精确
让 AI"点击那个按钮",在按钮密集的页面上可能点错。精确度要求高、需要毫秒级时序的操作(如拖拽排序、抢购秒杀),传统脚本用精确坐标和时序控制,远胜视觉模型。
边界 3:断言的客观性——aiAssert 也有"幻觉"
aiAssert('订单创建成功')这类自然语言断言,本质上还是模型在判断。它可能出现"看起来像成功就确认成功"的问题。这和前面讲的原则一致:关键断言要用客观信号兜底——最好结合传统断言(订单号格式、数据库记录)一起用。
// 弱:纯视觉断言,可能误判
await agent.aiAssert('订单创建成功');

// 强:视觉断言 + 客观断言双保险
await agent.aiAssert('页面显示订单确认');
awaitexpect(page.locator('.order-id')).toHaveText(/^SO\d{10}$/);
边界 4:合规和离线环境——数据要出域
视觉驱动要把页面截图发给大模型。如果你的场景涉及敏感数据、合规要求不能外传,或者运行环境完全离线,这条路走不通(除非自建视觉模型,那是另一套成本)。
五、视觉驱动 vs 传统元素定位
维度 | Midscene 视觉驱动 | 传统元素定位 |
|---|---|---|
定位方式 | 视觉理解,说人话 | CSS/XPath,写代码 |
DOM 变化 | 抗(看起来没变就行) | 脆(结构一变就失效) |
单次成本 | 高(调视觉模型) | 极低(纯代码) |
执行速度 | 慢(每步截图+推理) | 快 |
精度 | 中(可能点错) | 高(精确坐标/元素) |
适合场景 | 老系统、跨端、探索、原型 | 高频回归、精确操作、CI 门禁 |
断言可靠性 | 中(需客观兜底) | 高 |
Midscene 不是来"取代"传统自动化的,而是来补传统自动化最痛的那块——脆弱定位符导致的维护地狱。聪明的团队会把两者混着用:稳定的核心回归用传统脚本跑得快,混乱的老系统、跨端探索用 Midscene 降低维护成本。别指望一个工具打天下。
六、高频面试题
Q1:视觉驱动 UI 自动化和传统元素定位的本质区别是什么? 传统靠 DOM 选择器,精确但脆弱;视觉驱动靠多模态模型理解画面,抗 DOM 变化但慢且贵。本质区别是"理解的对象"不同——一个是 DOM 结构,一个是视觉画面。
Q2:为什么说 aiAssert 不能完全替代传统断言?因为自然语言断言也是模型判断,存在"看起来像成功就确认"的幻觉风险。关键业务结果要用客观信号兜底,比如订单号格式、数据库记录、接口返回。
Q3:什么场景不该用 Midscene?高频回归(要求秒级反馈、成本敏感)、精度要求高的操作(拖拽、时序)、有数据出域合规要求或离线环境。这些场景传统脚本更合适。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号