AI 能写 80% 的代码,剩下的 20% 才是公司留你的理由
原创
AI 能写 80% 的代码,剩下的 20% 才是公司留你的理由
原创
Lethehong
发布于 2026-11-21 08:10:35
发布于 2026-11-21 08:10:35
先说结论,能被 AI 写掉的那 80% 从来不是公司的成本大头。真正让公司离不开人的,是剩下那 20% 里没人愿意接、也没法交给模型的那部分。这篇讲清楚那 20% 长什么样。
图 1 本文配图:文章主题场景示意
这句话问的根本不是 AI
我第一眼看到这个面试题,反应不是焦虑,是觉得这题出得挺鸡贼。
它表面上在问 AI 的能力边界,实际上在问一件更扎心的事,如果 AI 真能写掉 80% 的代码,那公司每年花在你身上的那笔钱,买到的到底是什么。
注意这个 80% 是个什么口径。它指的是从需求到能跑起来的那段,写函数、拼接口、调样式、补样板。这些活的共同点是,输入明确,输出可验证,错了重来成本低。
面试官心里其实有答案。他问这句话,不是想听你说 AI 不行,也不是想听你说 AI 很强所以我要转型。他想听的是,你知不知道自己每天在干的活里,哪一部分是这种可被验证的、输入明确的活。
你要是答不上来,那这题就废了。因为答不上来意味着,你自己也没分清哪些活值钱。
那 80% 为什么最先被吃掉
我把手头这类活拆开看了一遍,发现它们有个共同结构。
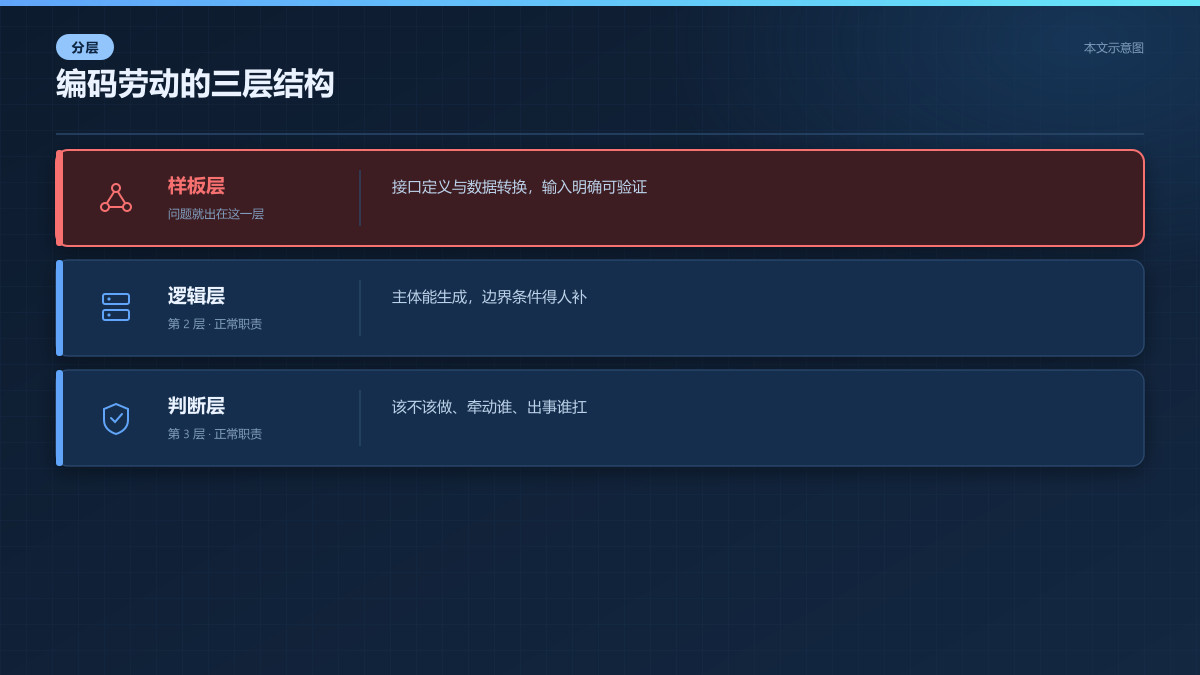
图 2 本文示意图:同一个项目按可替代性拆开,被吃掉的只是最上面那层
第一层,需求本身是别人嚼过的。产品经理写完文档,或者你自己脑子里已经想清楚了要什么,剩下的就是把想法翻译成代码。翻译这件事,模型现在做得比大多数人快。
第二层,正确性有现成的裁判。单测能跑,编译能过,页面能打开,这些都替你验了。模型写错了,你立刻知道,改起来也快。
第三层,失败的成本被隔离住了。一个函数写歪了,删掉重写就是。它不会半夜三点把生产库锁死,不会让一个客户的订单数据消失。
这三层叠在一起,才构成那 80%。换句话说,被吃掉的不是「写代码」这件事,是「写那种错了也无所谓的代码」这件事。
这里有个我自己的判断,可能有点反直觉。越是规范、越是文档齐全、越是流程成熟的团队,那 80% 被吃掉得越快。因为规范本身就是给机器准备的输入格式。
剩下那 20% 到底长什么样
我试着列了几类,列完发现它们有个共同点,都不是「写」的问题。
第一类,判断该不该做。需求文档里写着要做这个功能,但你知道这个功能一上线,会跟三个月前那个补丁打架。这种判断没有文档,没有单测,只有你在这个系统里待了两年攒下的直觉。
第二类,在信息不全的时候拍板。线上出事了,日志只给了半截线索,你手里有三个可能的假设,必须在十分钟内选一个去验证。选错方向,修复时间翻倍。这种决策模型替不了,因为它要为后果负责,模型不负责。
第三类,跨人的协调。这个改动要动到隔壁组的接口,你得去谈,得说清楚为什么值得他们改,得在排期上争一个位置。这件事的本质是说服,不是编码。
第四类,为结果兜底。代码是 AI 写的,但上线之后炸了,追责追到的是你。责任这个东西没法外包给模型,公司也不会接受一个「是 AI 写的」的解释。
你把这四类加起来看,会发现它们都不产出代码行,但它们决定了哪些代码该被写出来,以及写出来之后出了事谁扛。
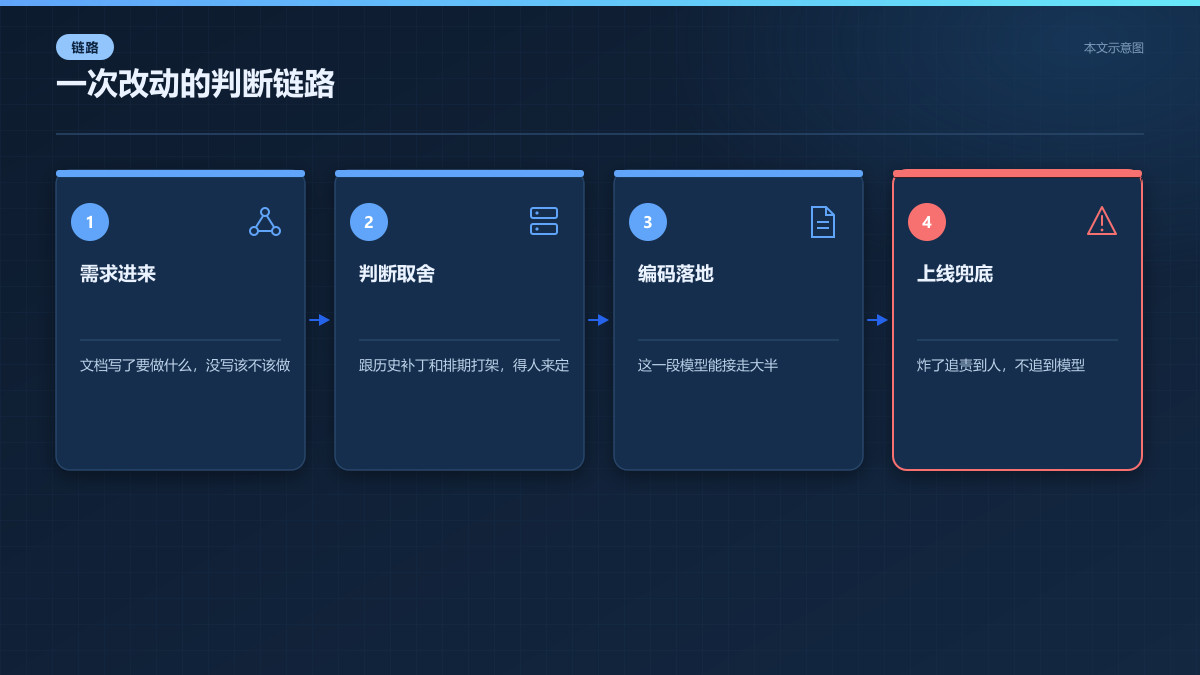
图 3 本文示意图:从需求进来到上线兜底,卡点全在模型够不着的地方
公司买的从来不是打字速度
我得说清楚一个事,不然容易变成给打工人灌鸡汤。
公司当然在乎效率。AI 写代码快,这是实打实的成本下降。但成本下降之后,公司不会因此少要人,它会提高对每个人的期望。以前一个人一天写两百行算正常,现在可能期望你一天交付三个模块。
所以「AI 能写 80%」这句话,对公司的真实含义不是「可以裁掉 80% 的人」,而是「剩下的人得干原来五个人的判断活」。
这里有个数字我想摆出来。假设一个十人团队,AI 把编码环节压缩了八成,那省下来的时间不会变成摸鱼,会变成更多的需求、更快的迭代、更频繁的上线。判断的密度反而上去了。
这也是为什么我判断,短期内被淘汰的不是「不会用 AI 的人」,是「只会写代码、不会做判断的人」。前者可以学,后者得靠年头和踩坑攒。
我怎么验这个判断
光说没用,我拿自己手头一个真实项目对了一遍。
这个项目大概三千行代码,我把它按「AI 能不能独立完成」分了三档。第一档是纯样板,接口定义、数据转换、表单校验,占了大概六成,这档我确实可以整段丢给模型。
第二档是逻辑有分支但边界清楚的,占了大概两成五。模型能写出主体,但边界条件得我补。比如一个分页查询,正常路径它一次就对,但空结果、超大页码、并发修改这几个边界,它默认不管。
给自己代码分档(示意代码,把手头模块按可替代性粗分三档,看清时间花在哪)
import os

# 粗分档,靠文件名和行数估,不追求精确
TIERS = {
    "sample": ["dto", "schema", "validator", "mapper"],
    "logic": ["service", "handler", "usecase"],
    "judge": ["gateway", "adapter", "migration", "config"],
}

def classify(path):
    name = os.path.basename(path).lower()
    for tier, keys in TIERS.items():
        if any(k in name for k in keys):
            return tier
    return "unclassified"

counts = {k: 0 for k in list(TIERS) + ["unclassified"]}
for root, _, files in os.walk("./src"):
    for f in files:
        if f.endswith((".py", ".ts", ".go")):
            p = os.path.join(root, f)
            lines = sum(1 for _ in open(p, encoding="utf-8", errors="ignore"))
            counts[classify(p)] += lines

total = sum(counts.values()) or 1
for k, v in counts.items():
    print(f"{k:<12} {v:>7} 行  {v / total:.1%}")

# 结果只用来照镜子,不用来考核任何人
# 判断层占比持续走低,才是真正该紧张的时候
第三档是剩下的一成五,全是跟外部系统打交道、跟历史包袱纠缠、跟人协调的部分。这部分我一行都没让模型碰,不是它写不了,是它不知道这个改动会牵动谁。
对完之后我修正了自己的说法。不是 80% 对 20%,在我这个项目里更接近 85% 对 15%。但关键是那 15% 花掉了我六成的时间。
这个比例每个项目都不一样,公开信息里也没有权威统计,我只能说这是我自己的口径。你拿自己的项目对一遍,数字大概率跟我不一样,但结构应该差不多。
所以面试那题该怎么答
我不会给标准答案,那种东西背下来也没用。我给个思路。
别急着证明 AI 不行,那是自欺。也别急着表忠心说我要学 AI,那是空话。
我见过一个答得比较实的说法,大意是,AI 能写的那部分我确实在用它写,省下来的时间我花在了它写不了的地方,比如这个需求该不该做、这个改动会牵动谁、出了事我怎么兜。
这个答法好在哪,它承认了工具的能力,同时把价值锚在了判断和责任上。面试官要的就是这个。
反过来,如果你答「AI 写的代码我不放心,还是我自己写」,那基本就结束了。因为这句话暴露的是你不会用工具,而不是你有不可替代性。
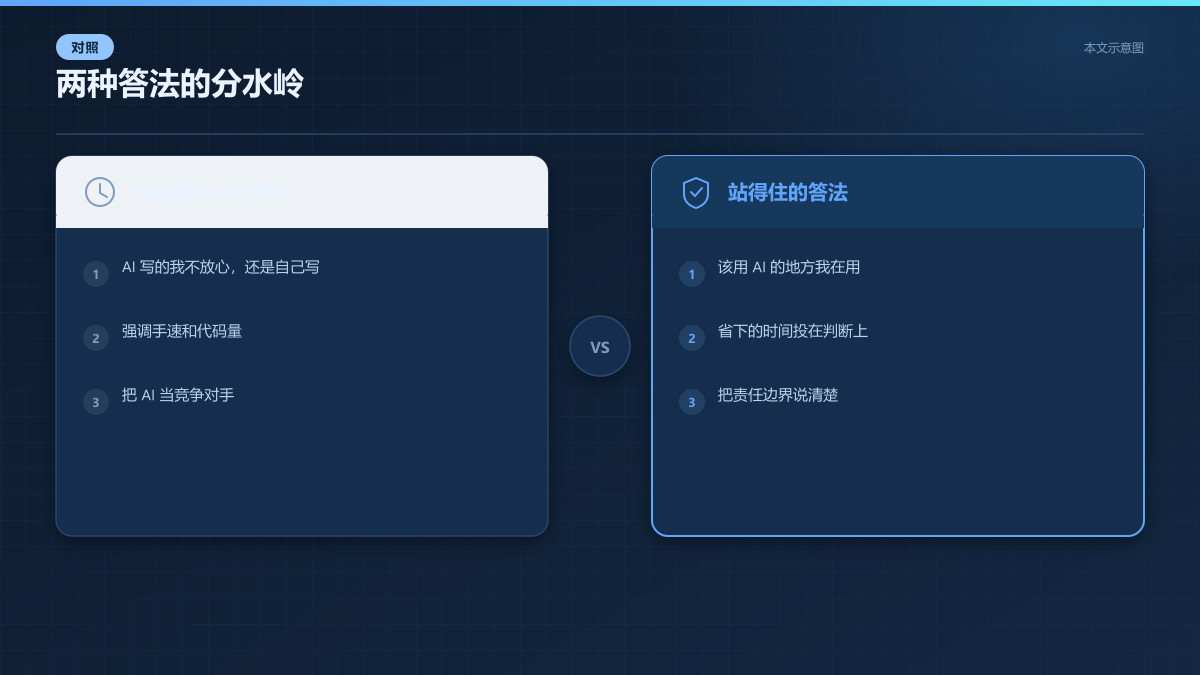
图 4 本文示意图:同样一句话,答的是工具能力还是自身价值,结果完全不同
这条线还会往上移
我得说清楚这次分析的局限。
第一,那个 80% 是别人的口径,不是我测出来的。不同团队、不同技术栈,这个数字能差很多。前端可能更高,嵌入式可能低得多。
第二,我判断那 20% 短期难替代,是基于现在的模型能力。模型在长上下文、工具调用、自主验证上还在往前走,这条线会往上移。移到哪停,我不知道。
第三,也是最不确定的一点。当 AI 写的代码占到九成以上,人对系统的理解会不会退化到无法做判断。这个风险是真的,但我没看到好的解法。
看判断层占比变化(示意代码,隔一个月跑一次,对比判断层行数占比的走向)
#!/usr/bin/env bash
# 每月跑一次,把结果追加到 trends.txt
set -euo pipefail

OUT="trends.txt"
STAMP=$(date +%Y-%m)

# 上一步的 python 脚本输出重定向进来
python3 classify_tiers.py > "/tmp/tiers_${STAMP}.txt"

JUDGE=$(grep '^judge' "/tmp/tiers_${STAMP}.txt" | awk '{print $2}')
TOTAL=$(awk '{s+=$2} END {print s}' "/tmp/tiers_${STAMP}.txt")

if [ -z "$TOTAL" ] || [ "$TOTAL" -eq 0 ]; then
  echo "没读到行数,先检查 src 路径" >&2
  exit 1
fi

RATIO=$(awk -v j="$JUDGE" -v t="$TOTAL" 'BEGIN{printf "%.2f%%", j*100/t}')
echo "${STAMP} judge=${JUDGE} total=${TOTAL} ratio=${RATIO}" | tee -a "$OUT"
所以我的结论不是「放心,AI 替代不了你」,而是「被替代的是不产生判断的编码劳动,这个边界每个月都在动,你得盯着它动到哪了」。
盯的方式很土,每隔一段时间拿自己手头的活重新分一次档,看那第三档是变厚了还是变薄了。变薄了,就该紧张了。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章,我们,下次再见。
写在最后
AI 能写掉多少代码,这个问题每个月都有新答案。真正不变的是,公司付钱买的从来不是打字,是在信息不全时敢拍板、拍完板敢兜底的那个人。这条线会一直往上移,你能做的就是隔段时间回头看一眼,自己手里还剩多少判断活。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号