面向 CPU 缓存命中率的 AC 自动机优化

背景
以前陆陆续续看到一些文章,讨论经典数据结构在现代 CPU 上的缓存局部性。(比如 Rust 标准库的有序字典容器 BTreeMap,会在一个节点中连续存放多个元素,以减少分配次数并改善缓存利用。具体解释可以参考 Rust 标准库文档)。
CPU 按缓存行加载数据。逐个分配的节点可能相距很远,沿指针访问时容易连续遇到缓存未命中。为了提高 CPU 缓存命中率,这次改造把查询中可能相继访问的数据尽量放在相邻地址,让后续访问有机会复用已加载的缓存行。我也想试试改造一些常见的底层数据结构,比如链表、LRU Map。不过在开始通用容器改造之前,先拿我之前写的 AC 自动机做个实验。
这个 AC 自动机最早用于脏字过滤系统,所以有跳过空白字符、忽略大小写等扩展。
最早的实现是在启动时加载词表并建树,当时超大词表的加载需要 6~7 s。后来增加了序列化 dump,启动时直接加载已构建的树,省去建树后,当时的加载时间缩短到了 1 s 以内。实现见 ac_automation.h。
但 load() 仍会逐个分配树节点,每个节点还用 std::map 管理子节点。在大型工程中,这些分配容易与其他业务对象交错。旧版还提供了 utf8_char_t 模板参数,用一个 8 字节数组保存一个 UTF-8 字符;对通常只占 1 字节的 ASCII 字符和占 3 字节的常见汉字,这种定长表示也有额外开销。后面的基准使用单字节 skip 配置,需要与这个 UTF-8 模板版本区分。
这次 v2 主要做了几项改造:
- 把 tokenizer 切分出的 token 映射成
uint32_t符号 ID,原始 token 字节集中存储,边上只保存 ID。 build()后将节点和子节点标签放进连续数组,用有序标签上的二分查找代替std::map查找。- 增加 token 别名规则,例如配置后可把“二”和“2”归一化为同一符号,合并等价的匹配路径。
- 增加可配置的左右边界规则,减少短词的误匹配。例如配置忽略大小写和相应边界后,可让“SM”命中,同时排除“SMS”和“smile”。
- 让序列化分段接近查询时的数组布局,减少加载时逐节点建树的工作。整数按小端格式编码,加载仍需分配、复制、校验和重建派生索引,并非直接把文件映射成 C++ 对象。
实现见 ac_automation_v2.h。构建离线索引阶段仍使用动态容器收集词条,查询使用冻结后的只读快照,二者的数据结构不同。
冻结快照的布局
v2 的节点按广度优先顺序编号。每个节点用 16 字节保存子节点区间的起点、数量、失败链接和输出词条链表头;另有每节点 4 字节的标签数组,保存进入该节点的符号 ID。同一父节点的子节点标签有序且连续,标签的数组下标就是目标节点 ID。查询时,零个或一个子节点直接处理,多个子节点才做二分查找。具体布局见 头文件中的 Frozen memory layout 说明。
这让查询不再依赖每节点的 std::map 和独立分配,但并不意味着每条匹配路径都连续:失败链接仍会跳转,符号查找和边界检查也有成本。加载主要处理几块连续数组,省去大量小对象分配,这是它与旧版加载路径的重要区别。
下面比较的是两版实现的整体表现,其中同时包含了存储布局、分词、skip、边界规则和结果处理方式的差异。虽然新增功能也可能增加处理开销,但是 CPU 缓存命中率带来得收益肯定大于等于整体的性能提升。
ac_automation_v2 vs ac_automation 性能对比报告
词表使用开源服务器框架 atsf4g-co 内的脏字表 install/resource/compliance/text_filter.acv2。测试环境为 WSL2 Debian 13(trixie)、g++ 14.2.0,单线程,RelWithDebInfo(-std=c++20 -O2 -g -DNDEBUG);词表与二进制均位于 WSL 原生文件系统。
共运行 4 个独立进程,各轮交错测试两版实现,以减小机器状态变化的影响。构建与加载离线索引取 4 次运行中 round 0 的最小值;稳态数据取各进程 round 1..N 的中位数,再取其中最小值;匹配取各进程 5 轮的中位数,再取其中最小值。文中“首轮”只指新进程中的 round 0,不表示操作系统页缓存或 CPU 缓存已清空。
测试还构造了碎片化堆和多组语料,用于观察这类分配与访问模式下的表现。下表是这组测试记录的摘要。
结论速览
场景 | v1 | v2 | 说明 |
|---|---|---|---|
构建离线索引与序列化(首轮) | 570.4 ms | 304.7 ms | 按总计计算,v1/v2 耗时比约 1.87 倍 |
Load 配置文件(首轮,文件流) | 187.6 ms | 41.5 ms | 耗时比约 4.5 倍,v2 使用默认加载选项 |
Load(首轮,内存镜像) | 190.4 ms | 3.9 ms | 耗时比约 48 倍,不含文件读取 |
常驻内存探针 | 83.0 MB | 6.4 MB | RSS 增量约为 13∶1,非构建峰值 |
匹配短文本·无敏感词(≤15 B) | 533 ns | 481 ns | v2 耗时较低,差距约 10% |
匹配短文本·含敏感词 | 3653 ns | 929 ns | v1/v2 耗时比约 3.93 倍 |
匹配长文本·无敏感词(300 B) | 17341 ns | 16577 ns | v2 耗时较低,差距约 4% |
匹配长文本·含敏感词 | 21915 ns | 17658 ns | v1/v2 耗时比约 1.24 倍 |
contains()(长文本·含敏感词) | match() 21915 ns | contains() 10392 ns | 耗时比约 2.11 倍,接口返回的信息不同 |
命中次数(短/长,各 5000 条含词语料) | 3878 / 3485 | 5003 / 5129 | v2 命中次数多约 29%~47%,不等于命中文本数增加同样比例 |
无敏感词语料上的命中 | 1~7 次 | 0 次 | 无敏感词语料按 v2 筛选 |
这组记录中,v2 的内存镜像加载和常驻内存差距最明显;含敏感词文本的匹配耗时也较低,无敏感词文本的差距则较小。
测试数据
词表由 v2 镜像提供(老实现无法直接读取该格式):
项 | 值 |
|---|---|
关键词数 | 49,824 |
v2 节点数 / 符号数 | 232,031 / 7,999 |
最长关键词 | 76 token |
nocase | 是 |
skip token | 2,847 个(其中 2,783 个为多字节 UTF-8 token) |
边界规则 | 114 条(426 个成员 token) |
别名(replacement)规则 | 0 条 |
v2 逻辑 payload | 6,627,890 B(+2,052 B 派生符号索引,不序列化) |
保真度验证(每轮运行内自动完成,8/8 通过):
- v2 侧:从加载后的快照提取全部关键词、skip 集、边界规则与 keyword 边界选项,经公开 API 重建后
build()+dump(),与text_filter.acv2字节级一致。匹配基准测的就是生产词表本身。 - v1 侧:同一关键词表 +
set_nocase(true)+ 全部 64 个单字节 skip token。本次采用的单字节 skip 集是 256 位位图,未配置其余 2,783 个多字节 skip token,也没有 v2 的边界规则。构建、dump、load 回读后,与内存构建的 v1 在抽样语料上匹配结果逐条一致。
另外,v1 的多字节模板使用 std::set 保存 skip 字符,因此本次单字节配置的限制不应概括为整个 v1 都不支持多字节 skip。
测试方法
编译使用 RelWithDebInfo,优化参数为 -O2 -g -DNDEBUG。以下堆模型对两版执行相同的扰动操作:
- 预先分配与释放:在自动机工作前,分配 1,200,000 个 32~256 B 的随机小块,再随机释放约 2/3,留下约 80 万个可复用块和 40 万个存活块。v1 的独立节点和 map 节点有机会复用这些空闲块;v2 最终快照主要使用少量大块数组。
- 构建期扰动:每插入一条关键词,伴随一次随机小块分配或回收,模拟词表处理过程中其他对象的分配。
- 语料多样性:匹配语料每组 5000 条,每轮重排顺序,以减少固定访问顺序带来的路径预热。
malloc_trim(0) 仅在阶段计时结束后、RSS 采样前调用,避免释放空闲页改变后续轮次的分配和缺页行为。
采用“进程内中位数,再取进程间最小值”的结果,这样更接近本次实验中观测到的较低耗时。
构建与加载离线索引性能
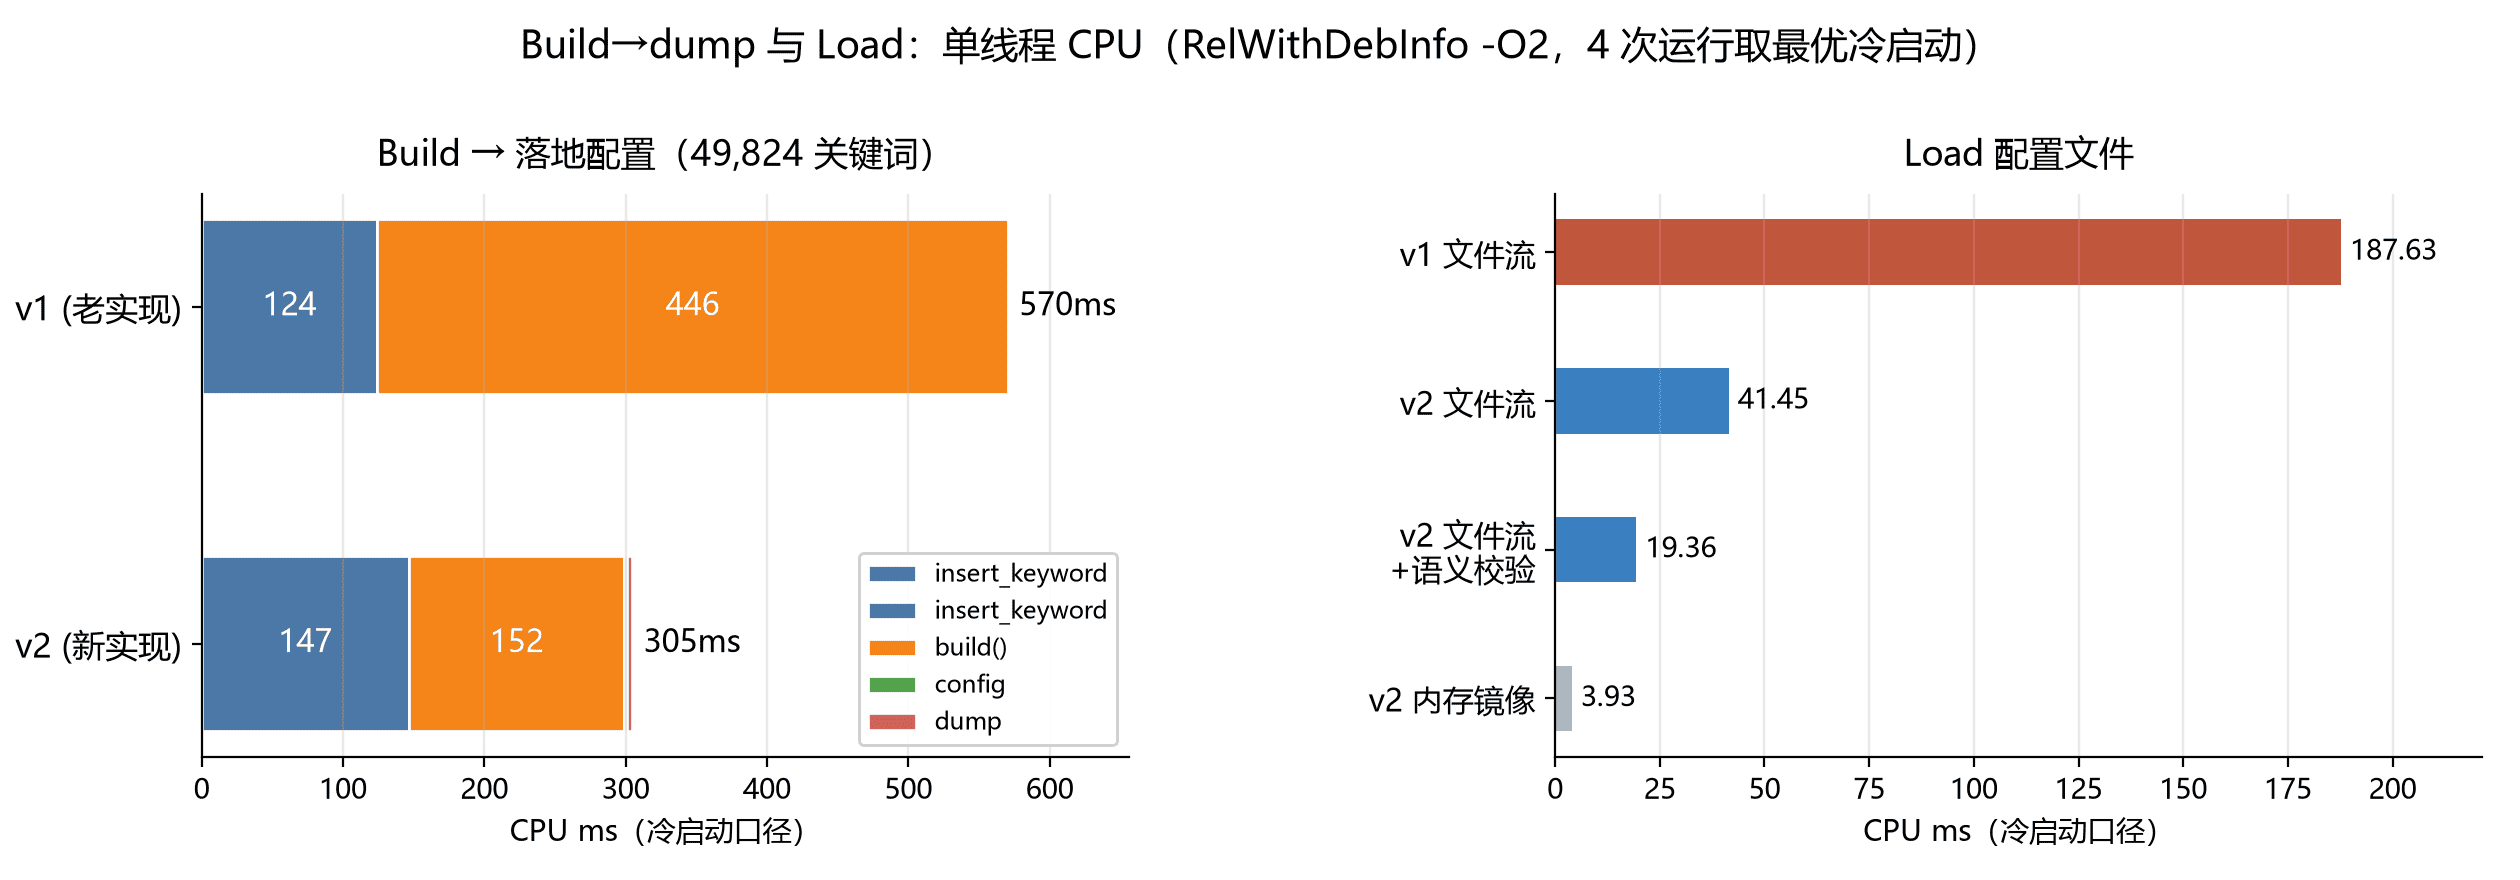
构建与序列化离线索引的首轮记录如下,单位为 ms(4 次运行的 round 0 取最小值):
阶段 | v1 | v2 |
|---|---|---|
配置(仅 v2) | — | 1.8 |
insert_keyword × 49,824 | 124.4 | 146.9 |
init 失败指针(含在首次 dump) / build() | 270.1 | 152.1 |
dump 序列化 | 155.7 | 3.9 |
记录的总计 | 570.4 | 304.7(按总计计算,v1/v2 约 1.87 倍) |
v1 展示的分项合计与记录总计相差 20.2 ms;这里保留原始数值,构建耗时比统一按总计计算。
Build 与 Load 对比
图 1:构建与加载离线索引耗时,左图将 v1 的失败链接初始化与 dump 合并显示。图中的“冷启动”指进程首轮,不表示缓存已清空。
Load 配置文件的首轮记录,单位为 ms:
口径 | v1 | v2 |
|---|---|---|
文件流(默认加载选项) | 187.63 | 41.45 |
文件流 + verify_semantics(compliance 实际配置) | — | 19.36 |
内存镜像(镜像已在内存中) | 190.38 | 3.93(约 48 倍) |
这组数据中,v1 的失败链接初始化、序列化和反序列化都占据了较多时间;v2 的耗时主要集中在插入与 build,与前面介绍的构建结构和冻结快照的区别相对应。
v2 的文件流加载在默认选项下为 41.45 ms,开启 verify_semantics 后为 19.36 ms,反而降低了。可能是IO本身的缓存抖动导致,但是即便是最大值,也v2的加载速度也远高于v1版本。
load(span) 的 3.93 ms 只统计镜像已经在内存中的加载阶段,不包含读取文件,也不覆盖额外语义校验的开销。compliance 的实际加载路径使用文件流,并设置 verify_semantics = true。若要改成字节缓冲路径,需要在相同校验选项下比较“读取文件 + 加载”的总耗时和峰值内存,再决定是否值得改。
过滤与匹配性能
语料共 4 组,每组 5000 条,确定性生成。短文本不超过 15 B(两组平均长度为 9.5 B、12.1 B),长文本恰为 300 B。含词语料在随机位置嵌入 1 个真实敏感词,并经重建的 v2 检查确实命中;无敏感词语料则经重建的 v2 筛选为零命中。
v2 使用与 task_action_filter_text.cpp 相同的调用模式,复用结果 vector 和 match_context,默认 UTF-8 分词、非重叠匹配;v1 使用 ac_automation::match()。两版结果容器的构造和复用方式不同,耗时包含了这些 API 使用方式的影响。下表中的比值只比较两版的 match(),数值越小,v2 耗时越低。
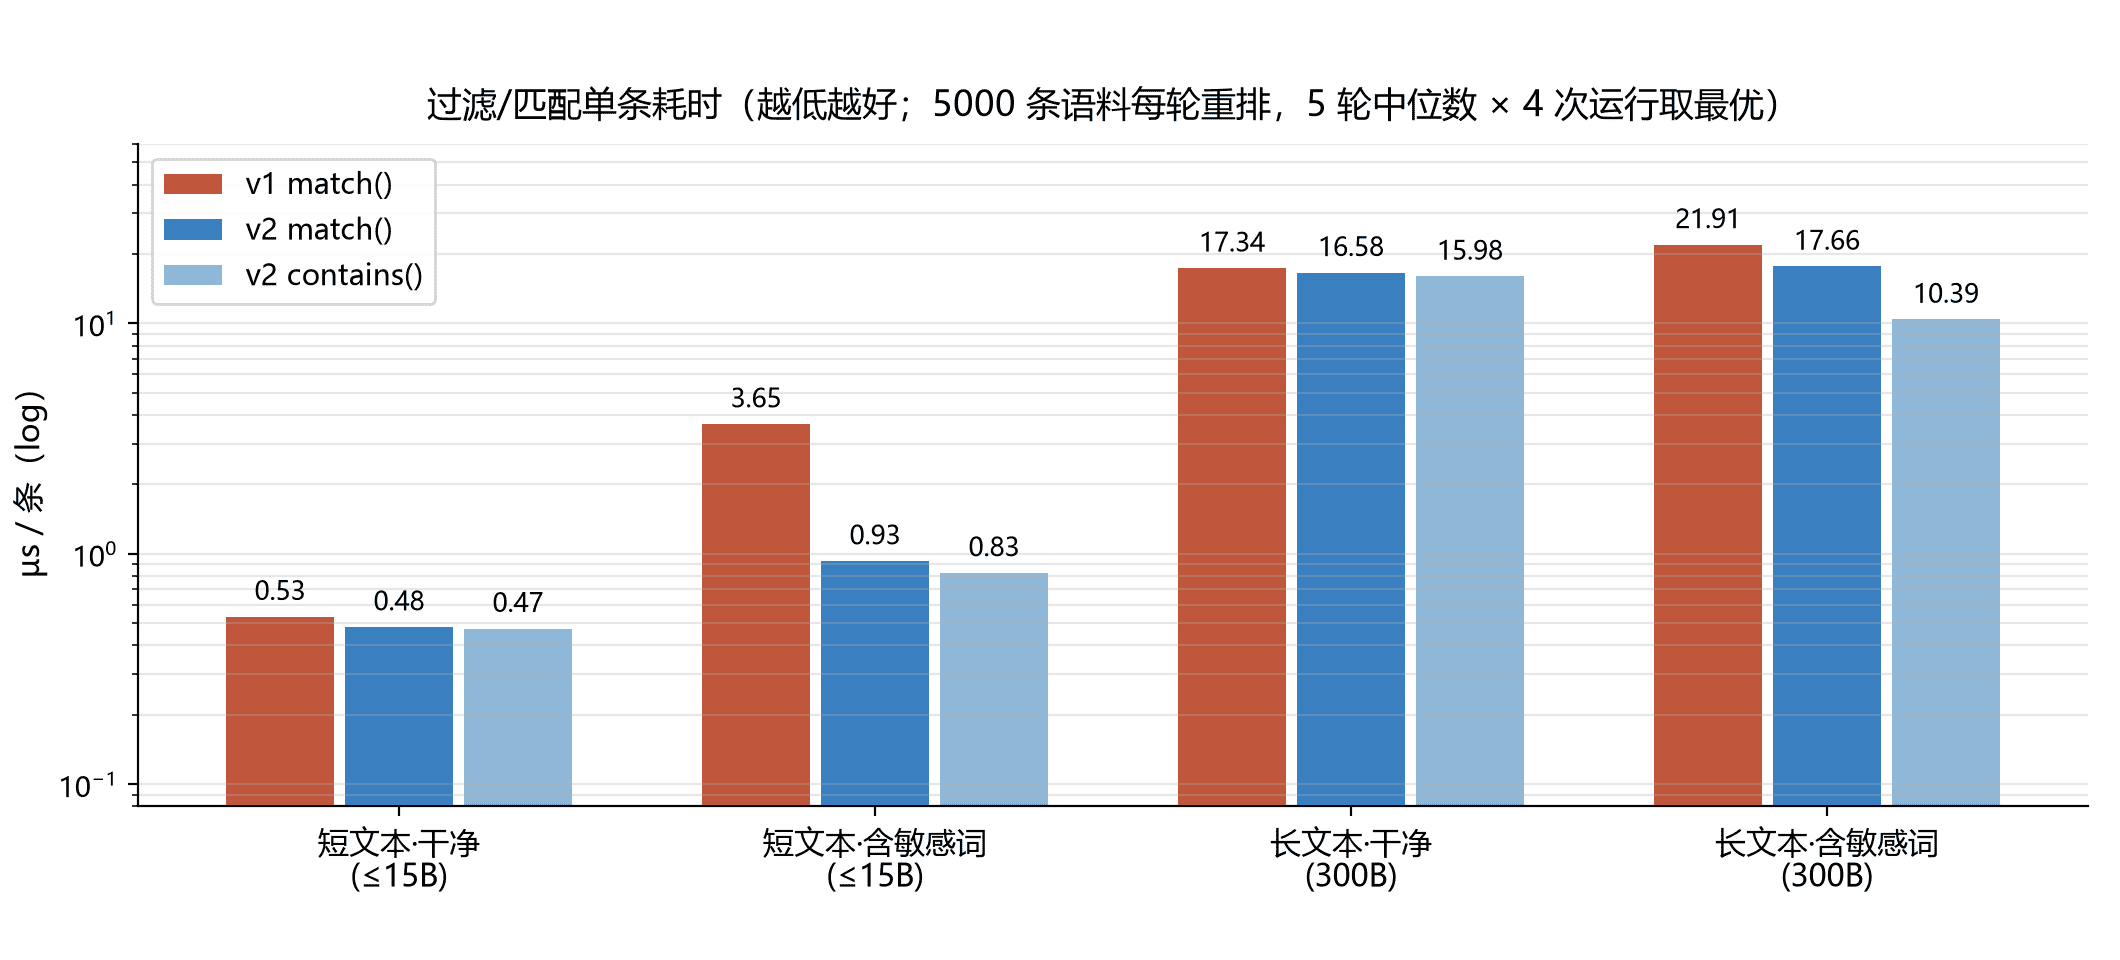
语料 | v1 match | v2 match | v2 contains | v2 match / v1 match |
|---|---|---|---|---|
短·无敏感词(≤15 B) | 533 ns | 481 ns | 473 ns | 0.90x |
短·含敏感词 | 3653 ns | 929 ns | 825 ns | 0.25x |
长·无敏感词(300 B) | 17341 ns | 16577 ns | 15985 ns | 0.96x |
长·含敏感词 | 21915 ns | 17658 ns | 10392 ns | 0.81x |
(吞吐,长·无敏感词:v1 ≈ 17.3 MB/s,v2 ≈ 18.1 MB/s)
匹配/过滤对比
图 2:同一组记录换算为每条文本的微秒耗时,纵轴为对数刻度。含词语料的 contains() 可在首次有效命中后停止,与收集匹配结果的 match() 所完成的工作不同。
这四组记录中,v2 的 match() 耗时均低于 v1。其中短文本含词组的差距最大,无敏感词两组差距约为 4%~10%。
两版的功能差异也体现在输出上:
- 两组含词语料各有 5000 条文本,v1 的命中次数分别为 3878、3485,v2 为 5003、5129。按次数计算,v2 多约 29%~47%;但一条文本可以有多次命中。
- 无敏感词语料由 v2 自身筛选,v2 零命中是生成条件的一部分。v1 的 1~7 次命中是因为功能行为上的差异(边界、别名等v1不支持)。
内存与离线索引占用
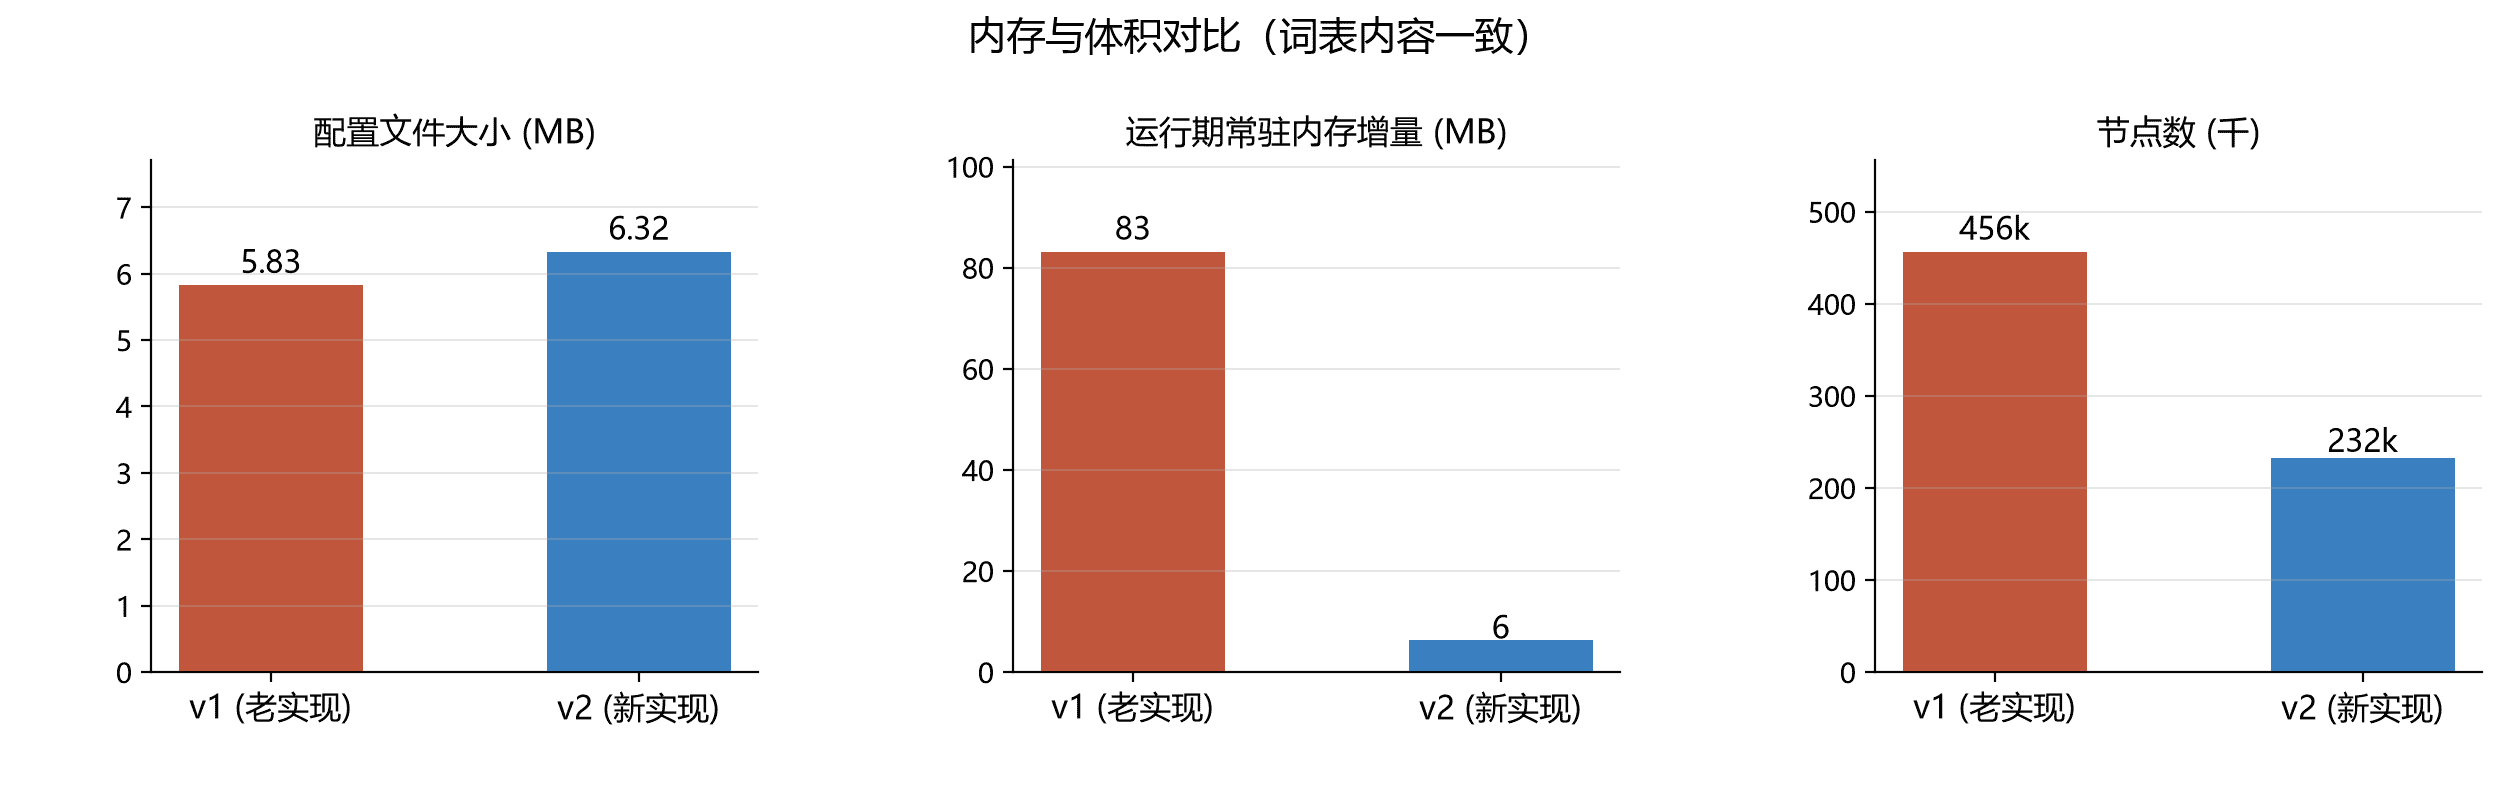
项 | v1 | v2 |
|---|---|---|
配置文件 | 5.83 MiB | 6.32 MiB |
受控探针的 RSS 增量(malloc_trim 后) | 83.0 MB | 6.4 MB(约 13∶1) |
另一组探针:碎片化堆下的 RSS 增量 | 39.0 MB | 6.3 MB |
存储组成 | 455,815 个 trie 节点及其 map 节点、字符串和分配器开销 | 6,627,890 B 逻辑 payload + 2,052 B 派生索引,另有容器和分配器开销 |
节点数 | 455,815 | 232,031 |
内存与离线索引占用对比
图 3:文件体积、受控探针的 RSS 增量和 trie 节点数。图中文件体积的“MB”实际按 MiB 换算;中图 v2 的整数标签为四舍五入,精确记录是表中的 6.4。
碎片化堆下 v1 的 RSS 增量为 39 MB,低于另一组探针的 83 MB。复用预先释放的空闲块,可以让一部分自动机存储落在已经计入基线的驻留页中,这可能是这个内容抖动的原因。但是整体量级还是可以参考的。
总结
对这份词表和这组碎片化堆、合成语料记录,我们更看重 v2 在加载与常驻内存上的变化:内存镜像加载耗时约为 v1 的 1/48,受控探针的 RSS 增量约为 1/13;构建离线索引总耗时由 570.4 ms 降至 304.7 ms。
这次实验和之前的 《实现strong_rc_ptr(比shared_ptr更快的引用计数智能指针)》 有一点相通:都需要把具体访问方式和内存成本放进业务场景里考察。不过前者主要减少引用计数的原子操作带来的同步开销,这次主要调整数据布局和加载方式。 接下来我也会慢慢尝试优化其他数据结构。
欢迎有兴趣的小伙伴们互相交流。
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号