AAAI 2025 | ChatTime:首个理解与生成统一的时序文本多模态基础模型

AAAI 2025 | ChatTime:首个理解与生成统一的时序文本多模态基础模型

时空探索之旅
发布于 2024-12-27 19:37:30
发布于 2024-12-27 19:37:30
标题:ChatTime: A Unified Multimodal Time Series Foundation Model Bridging Numerical and Textual Data
作者:Chengsen Wang, Qi Qi, Jingyu Wang, Haifeng Sun, Zirui Zhuang, Jinming Wu, Lei Zhang, Jianxin Liao
机构:北京邮电大学,鹏城实验室,中国联通
论文:https://arxiv.org/abs/2412.11376
代码:https://github.com/ForestsKing/ChatTime
关键词:多模态问答,时间序列基础模型
TL; DR:本文提出了多模态时间序列模型ChatTime,创新性地将时间序列建模视为“外语”, 统一时间序列的生成和理解 。实验验证表明,ChatTime在多任务场景下展现了卓越的潜力和实用性。
1 研究背景
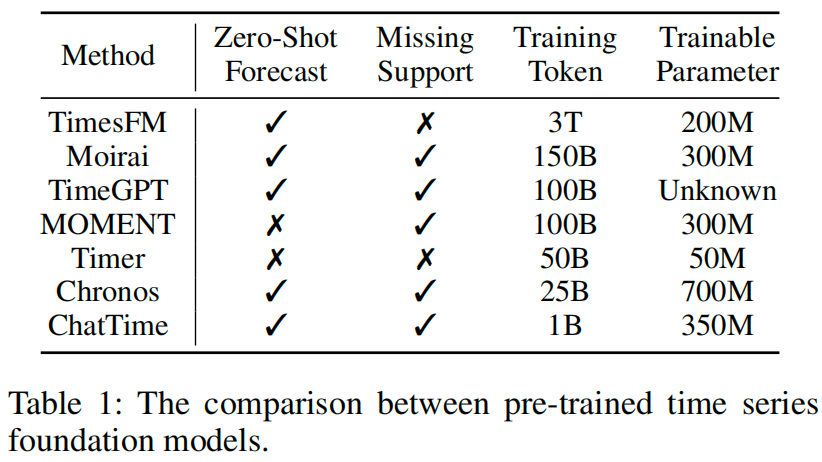
预训练大型语言模型的迅猛发展为时间序列领域注入了新的活力。部分研究尝试通过大规模时间序列数据构建通用基础模型,但这种从零开始的训练方法效率低下,且无法整合多模态文本信息。另一些研究则将预训练语言模型的权重融入时间序列框架,但这种方法需要在每个新数据集上重新微调,且缺乏零样本学习能力。此外,这两种方法都无法生成文本输出,限制了其应用范围。那么,如何在计算资源有限的情况下,构建一个既能支持时间序列与文本双模态输入输出,又具备零样本预测推理能力的通用基础模型?
为此,研究者提出了一种创新性建模方法,将时间序列建模视作一种“外语”,并构造了首个开箱即用的多模态时间序列通用基础模型ChatTime。这种建模方法不仅以最小的代价解决了广泛的时间序列问题,还为未来进一步借鉴大型语言模型和多模态研究成果铺平了道路。为验证ChatTime在多任务、多场景下的表现,研究者设计了三个多模态实验,包括零样本预测、上下文辅助预测以及时间序列问答,并创建了专门的多模态数据集以填补该领域的研究空白。实验结果表明,ChatTime展现出卓越的潜力和实用性,为时间序列分析任务提供了全新的解决方案和研究视角。
2 模型架构
通过将时间序列建模为外语,ChatTime赋予了预训练大型语言模型处理时间序列的能力,而无需从零开始训练或修改模型架构。具体而言,ChatTime首先通过缩放、分箱和添加特殊字符将时间序列编码为外语单词。然后,基于扩展后的词表,tokenizer将这些外语词汇与文本一同转换为token id,并输入后续的大型语言模型进一步处理。
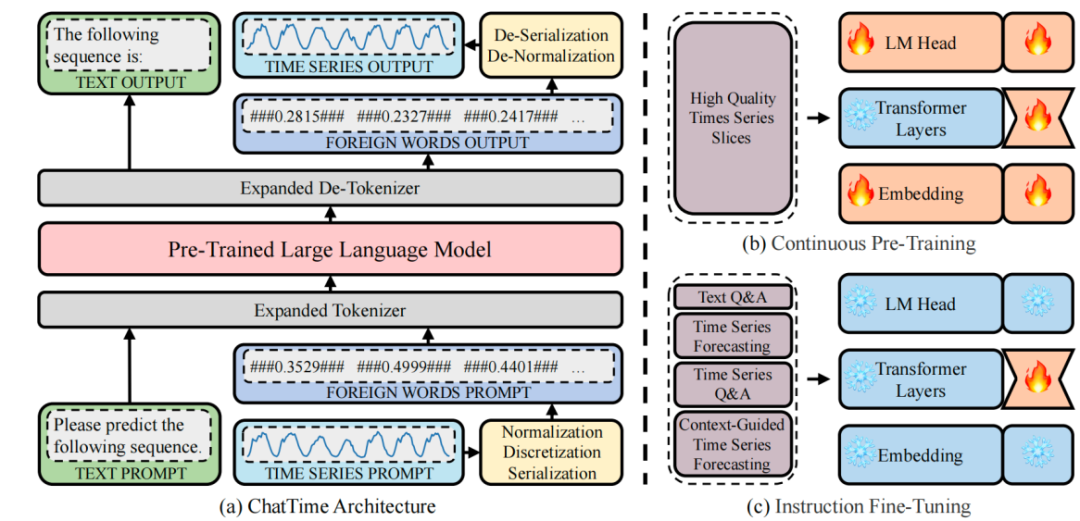
缩放:时间序列通常为无界连续域中的实值数据。ChatTime通过使用min-max缩放技术,将这些无界的时间序列实值映射到-1至1的有界范围。在实际推理过程中,预测序列是未知的,因此缩放是基于历史序列的统计值进行的。考虑到预测序列的数值可能超出历史序列范围,研究者将历史序列缩放至-0.5至0.5之间,而剩余的区间则作为预测序列缩放的缓冲区。
分箱:缩放后的时间序列仍为连续的实值,无法直接映射为有限的外语词汇。因此,研究者采用分箱技术将连续实值离散化。具体而言,他们将-1至1的区间均匀划分为10000个分箱,缩放后的每个实值都被映射到相应的分箱中,分箱的中心值作为量化后的离散值。
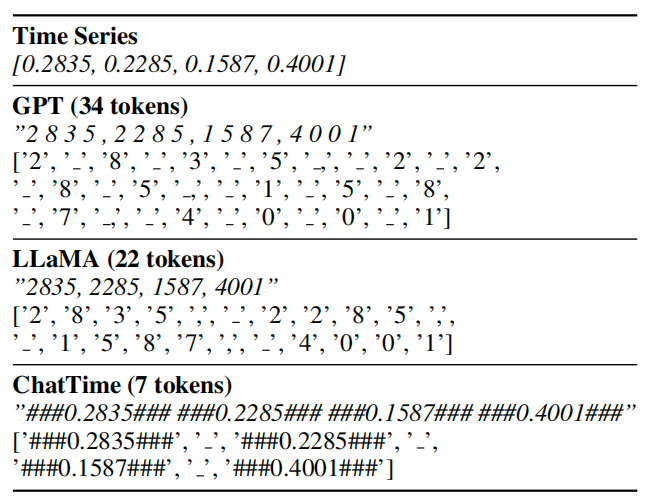
添加特殊字符:LLMTIME提出了两种方法来逐位tokenize时间序列。然而,这种方法会导致大量token消耗,增加训练和推理的开销。为了解决这一问题,研究者在离散化后的时间序列的首尾添加特殊字符“###”,从而构建新的外语词汇。通过扩展tokenizer的词表,每个数值所消耗的token数量得以大幅减少。
3 微调方法
ChatTime的训练过程分为 Continuous Pre-Training 和 Instruction Fine-Tuning 两个阶段。
在 Continuous Pre-Training 阶段,研究者利用高质量的时间序列切片对 Llama-2-7b-base 进行预训练,得到 ChatTime-1-7b-base。预训练数据来自 Monash 和 TFB 两个开源大型时间序列库,涵盖约 100 个子数据集,涵盖多个领域、不同粒度和长度的时间序列。为了最大化数据集的利用率,研究者采用了五种不同大小的窗口和步长,对原始时间序列进行滑动切片。考虑到时间序列中的大量重复模式及有限的计算资源,研究者对 10M 个原始时间序列切片进行了 K-means 聚类,将其分为 1M 类和 25K 类,每类随机抽取一个样本作为代表,从而构建出高质量的时间序列切片数据集,分别用于继续预训练 (1M) 和下一阶段的指令微调 (25K)。
在 Instruction Fine-Tuning 阶段,研究者使用四种任务的数据集对 ChatTime-1-7b-base 进行微调,最终得到 ChatTime-1-7b-chat。微调数据来自四个任务,每个任务抽取 25K 条样本。首先,为了保留文本推理能力,研究者使用 Alpaca 数据集进行单模态文本问答任务。其次,利用预训练阶段聚类后的 25K 个高质量时间序列切片,进行常规时间序列预测任务。上下文辅助预测和时间序列问答任务涉及时间序列和文本两种模态的相互转换,相关数据集较为稀缺。因此,研究者搜集了三个上下文辅助预测数据集,并合成了一个时间序列问答数据集,填补了这一领域的空白,提供了宝贵的资源。
4 实验效果
为验证ChatTime在多任务、多场景下的表现,研究者设计了三个多模态实验,包括零样本预测、上下文辅助预测以及时间序列问答。实验结果表明,ChatTime展现出卓越的潜力和实用性,为时间序列分析任务提供了全新的解决方案和研究视角。
零样本预测
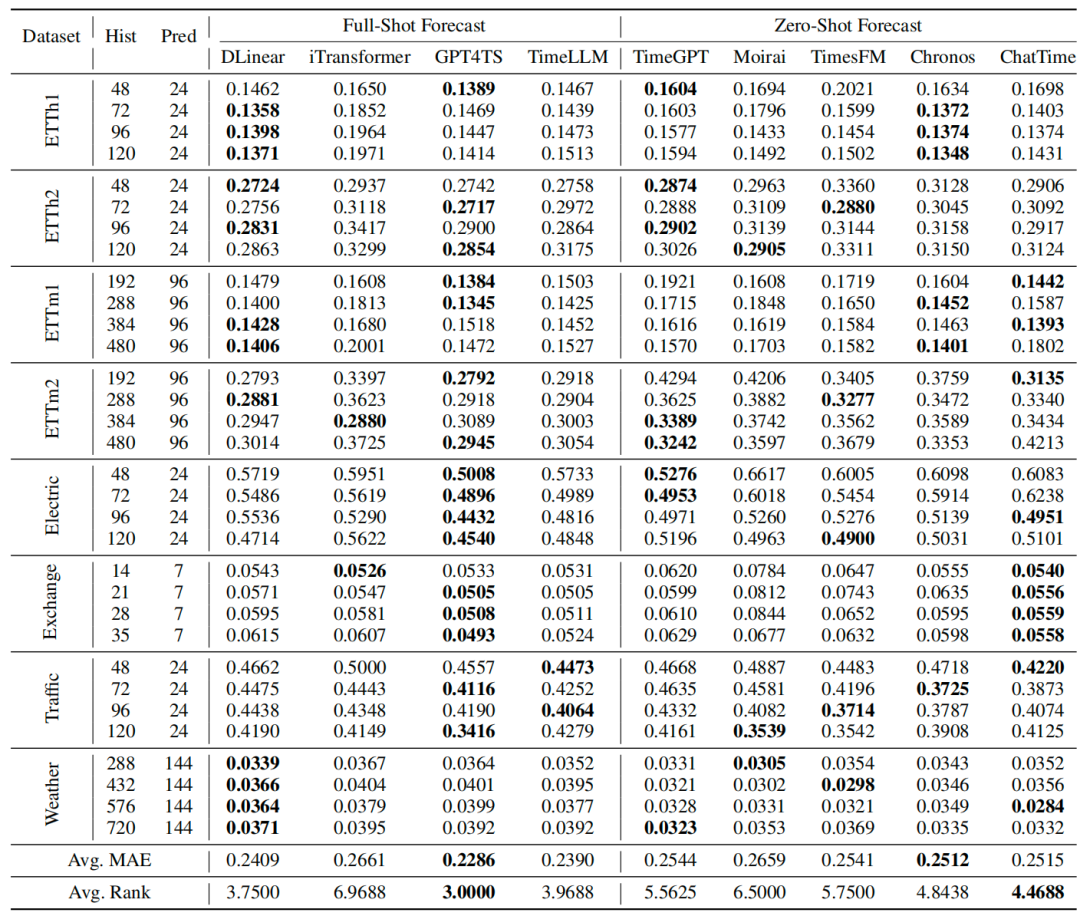
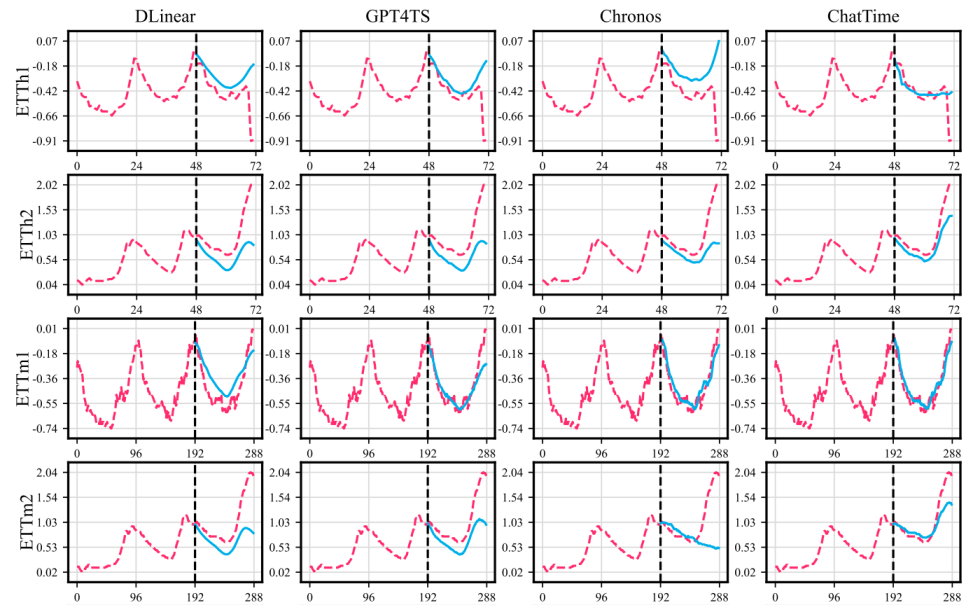
得益于对现有预训练大型语言模型的微调,而非从零开始训练,ChatTime 在仅使用4%预训练数据的情况下,就达到了先前最先进方法Chronos 99.9%的零样本预测精度。与全样本预测模型相比,ChatTime 也实现了与最先进方法GPT4TS 91.0%相当的预测精度。
上下文辅助预测
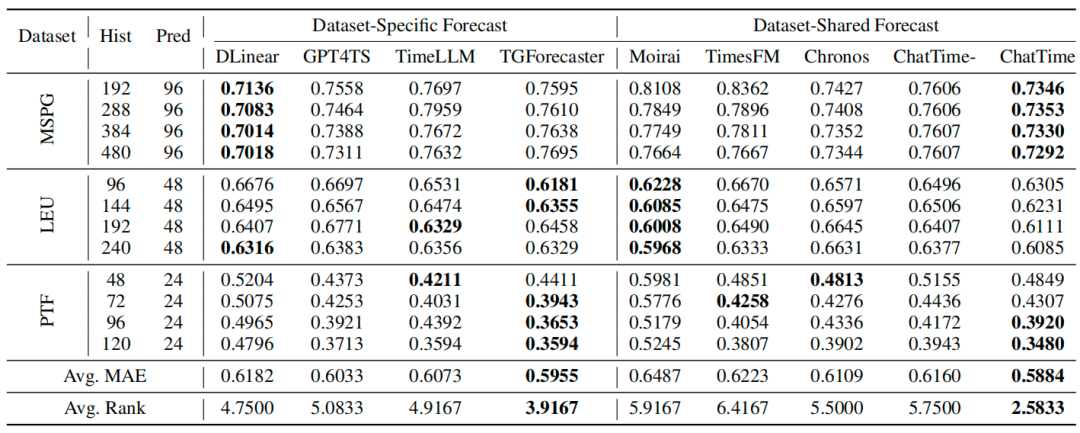
在加入文本信息后,ChatTime 和 TGForecaster 在预测性能上都超越了其他基线模型。借助 Llama2 强大的文本推理能力,ChatTime 在无需针对不同数据集和历史长度单独训练的情况下,超越了各场景单独训练的 TGForecaster。此外,使用双模态信息的 ChatTime 显著优于仅使用单模态数值的 ChatTime-,验证了上下文辅助的有效性。

时间序列问答
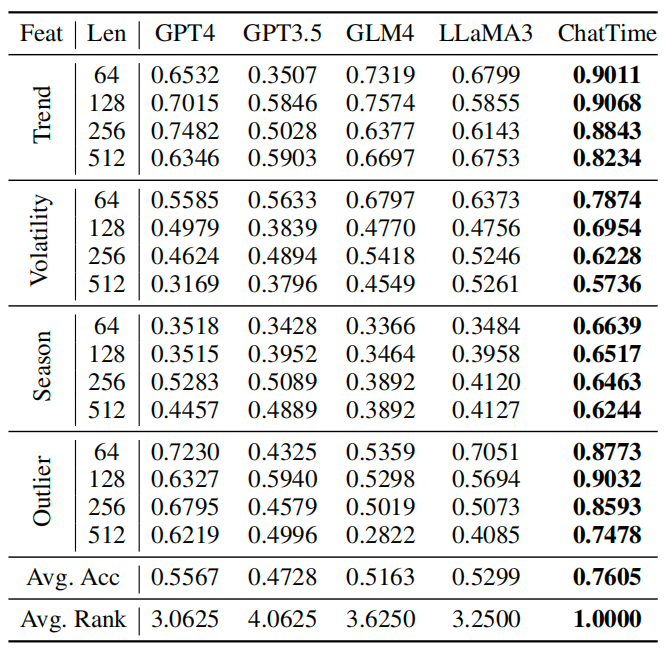
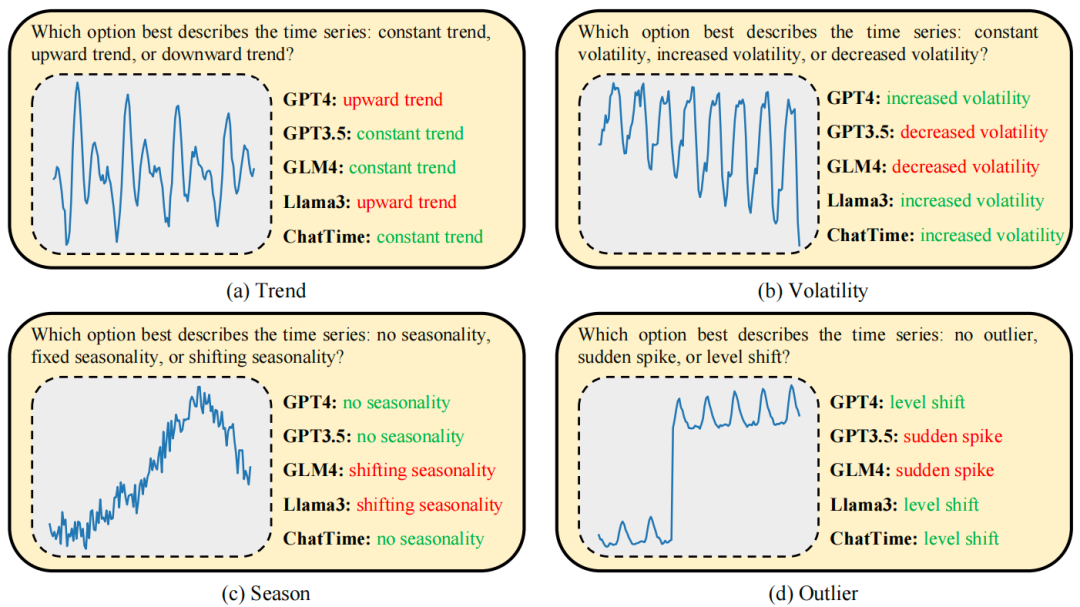
理解时间序列的典型特征是进行各种时间序列分析任务的基础。尽管通用的预训练大语言模型在文本任务上取得了显著成就,但在时间序列理解上的表现却未能达到同样的水平。ChatTime 基于预训练大型语言模型 Llama2,通过扩充词表并进行微调,成功保留了预训练模型的推理能力,并且在时间序列的典型特征理解方面表现出色。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2024-12-27,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号