Hadoop HDFS-DataNode(dn)详细介绍


作者介绍:简历上没有一个精通的运维工程师,下面的思维导图也是预计更新的内容和当前进度(不定时更新)。
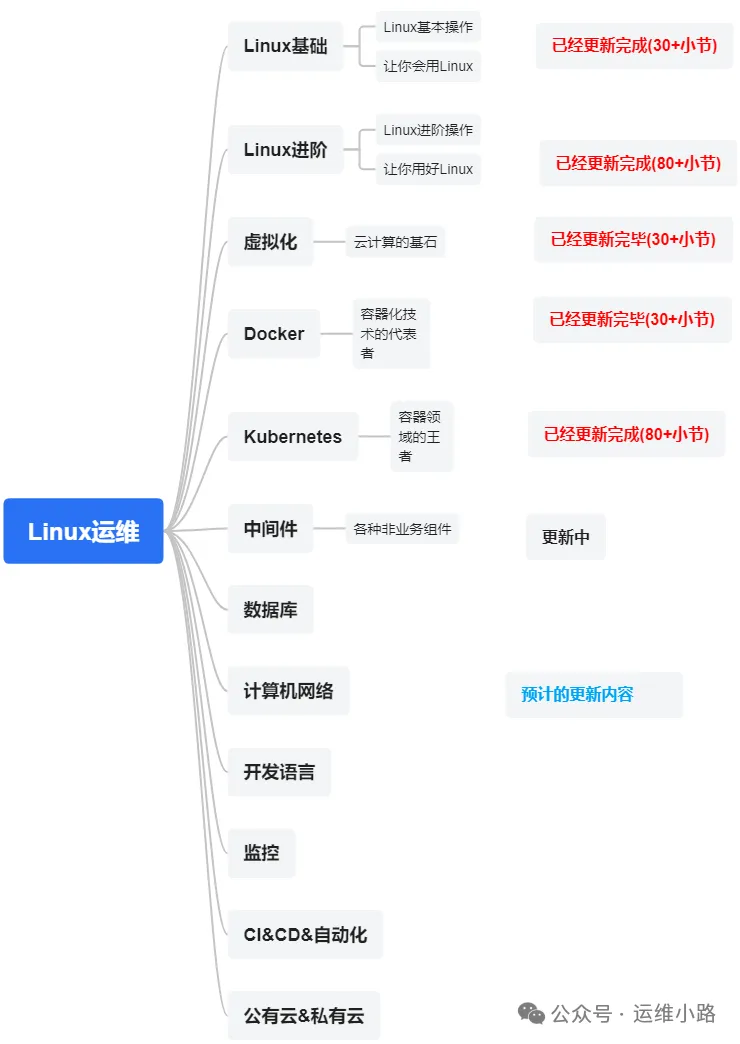
中间件,我给它的定义就是为了实现某系业务功能依赖的软件,包括如下部分:
Web服务器
代理服务器
ZooKeeper
Kafka
RabbitMQ
Hadoop HDFS(本章节)
前面我们介绍了HDFS的安装,在单机版本里面一共启动了3个java进程:
NameNode,DataNode,SecondaryNameNode,下面我们就来分别介绍这3个进程,今天是DataNode。
DataNode 是 Hadoop 分布式文件系统(HDFS)中负责实际数据存储与读写的核心组件,与 NameNode 形成 “主从架构”——NameNode 掌管元数据与决策,DataNode 则承担具体的数据块存储、传输及状态汇报工作。其设计聚焦于高吞吐量、容错性与分布式协作,以下从核心功能、工作机制、数据管理及优化策略展开详解。
一、核心功能
数据块的存储与管理:DataNode 是 HDFS 中数据的 “物理载体”,所有用户数据最终以数据块(Block) 形式存储在 DataNode 的本地文件系统(如 Linux 的 ext4、XFS)中。每个数据块默认大小为 128MB(可配置),一个大文件会被拆分为多个块(最后一块可能小于默认大小),并根据 NameNode 指令存储在不同 DataNode 上(默认 3 个副本)。
- 数据块在本地以文件形式保存,文件名由块 ID 与副本索引组成(如
blk_1073741825_1001.meta),同时伴随一个元文件(.meta),记录块的校验和(用于数据完整性校验)。 - DataNode 需确保存储的块与 NameNode 记录的元数据一致,定期通过 “块报告” 向 NameNode 同步本地块列表。
客户端数据读写执行:DataNode 直接与客户端交互完成数据传输,是 HDFS 高吞吐量的关键执行者:
- 读操作:客户端从 NameNode 获取目标块的存储地址后,直接与对应 DataNode 建立连接,通过 TCP 协议读取块数据(支持并行读取多个块以加速大文件读取);
- 写操作:客户端根据 NameNode 分配的块存储节点列表,将数据块按 “流水线模式” 写入第一个 DataNode,该节点接收数据后立即向第二个节点转发,依次传递直至所有副本写入完成,最后由最后一个节点向客户端返回确认。
集群状态汇报与协作
- 心跳机制:每 3 秒向 NameNode 发送一次心跳信息,包含自身存活状态、磁盘使用率、负载等数据。若 NameNode 超过 10 分钟未收到心跳,会判定该 DataNode 失效并触发副本修复;
- 块报告:每小时(或 NameNode 主动请求时)向 NameNode 发送一次 “块报告”,列出本地存储的所有数据块信息,供 NameNode 校验副本完整性并更新元数据。
二、数据块的生命周期管理
DataNode 对数据块的管理贯穿 “创建 - 存储 - 复制 - 删除” 全生命周期,且完全受 NameNode 调度:
- 块创建:客户端写入数据时,DataNode 接收数据并写入本地临时文件,待整个块写入完成且校验和无误后,重命名为正式块文件(避免不完整块被误读),同时更新块列表;
- 块复制:当 NameNode 检测到某块副本数不足(如 DataNode 失效),会向存有该块的 DataNode 发送 “复制指令”,DataNode 读取本地块并传输到目标节点,直至副本数达标;
- 块删除:当文件被删除或副本数调整时,NameNode 向冗余块所在的 DataNode 发送 “删除指令”,DataNode 立即删除对应块文件及元文件,并在下次块报告中同步状态;
- 块校验:DataNode 定期对本地块进行校验和计算(与元文件中的校验和比对),若发现数据损坏(如磁盘错误导致块内容变更),立即向 NameNode 报告,触发块修复。
三、工作机制的关键细节
流水线写入机制:为提升大文件写入效率,HDFS 采用 “流水线复制” 策略:客户端将数据块写入第一个 DataNode 时,该节点接收一部分数据(如 64KB 缓冲区满)后,立即向第二个 DataNode 转发,同时继续接收客户端后续数据。这种 “边接收边转发” 的模式避免了数据在单节点完整存储后再复制的延迟,将写入时间从 “串行复制” 的 n*T 缩短为接近 T(n 为副本数,T 为单块传输时间)。
机架感知与数据本地化:DataNode 会向 NameNode 汇报自身所属的机架信息(通过配置文件指定机架路径,如 /rack1/node1),NameNode 据此优化块存储策略:优先将块存储在客户端所在机架的 DataNode(“数据本地化”),减少跨机架网络传输;副本分配时确保至少有一个副本在不同机架,避免单机架故障导致数据丢失。DataNode 无需参与机架决策,仅需准确上报自身位置信息。
磁盘负载均衡:DataNode 通常配置多块磁盘以提升存储容量与吞吐量,其内部会通过 “轮询策略” 将新块均匀分配到不同磁盘,避免单盘过载。同时,会定期检查各磁盘的使用率,若某磁盘使用率过高(如超过阈值 90%),会向 NameNode 上报,由 NameNode 调度将部分块迁移到同节点的其他磁盘。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2025-07-07,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号