文档抽取系统:将“非结构化数据”转化为“结构化资产”的桥梁
原创
文档抽取系统:将“非结构化数据”转化为“结构化资产”的桥梁
原创
中科逸视OCR
发布于 2026-09-14 18:12:49
发布于 2026-09-14 18:12:49
月底,财务部的桌子上堆起了半人高的发票和报销单;法务部需要审核上百份合同里的免责条款;供应链部门要从几十种不同格式的海外订单中提取SKU和价格。
这时候,如果还靠一个个肉眼盯着屏幕、手动复制粘贴到Excel表格,不仅效率低得让人头秃,更重要的是——看花眼是小事,看错行才是灾难。
但如果在今天,你只需要像发朋友圈一样,把一叠乱七八糟的纸质或电子文档“喂”给电脑,下一秒,它们就自动变成了整齐划一的数据库表格。这听起来像科幻电影?不,这就是正在发生的智能文档抽取技术。
今天,我们就来扒一扒这项让职场人从繁琐录入中解放出来的“黑科技”,看看它到底是怎么做到的。
核心秘密:“双眼协作”的超级大脑
很多小伙伴可能会问:“现在的OCR(光学字符识别)不是已经很成熟了吗?为什么还需要这么复杂的系统?”
这里有个巨大的误区:OCR能帮你“认字”,但无法帮你“理解”。
传统的OCR就像是一个视力极好、写字极快的速记员。你把《红楼梦》扔给它,它能在一秒钟内把每一个字都精准地打印出来。但是,如果你问它:“书里林黛玉第一次出场时穿的是什么颜色的衣服?”速记员会把整本书重新念一遍给你听,因为他虽然认识每一个字,但他不知道“红色”这个词在文学语境下代表什么。
而我们的新一代文档抽取系统,采用的是 “OCR + 大模型(LLM)”的双剑合璧模式。这就像是给速记员配了一位博学的博士顾问。
1. 第一只眼:OCR —— 精准的“扫描仪”
首先,OCR引擎介入工作。它的任务是将图片格式的PDF、扫描件转化为机器可读的文字流。这一步保证了信息的无损获取,哪怕文档排版再乱、字体再花哨,它也能先把所有字符“抠”出来。
2. 第二只眼:大模型 —— 智慧的“理解者”
这才是关键!转化出的文字流会立刻进入大语言模型(LLM)。大模型拥有海量的知识储备和强大的逻辑推理能力。它不再只是机械地寻找匹配词,而是在阅读理解。
当大模型看到“甲方需在收到发票后30日内付款”这句话时,它不仅能提取出数字“30”,还能理解这意味着这是一个“账期”字段,而不是一个普通的日期。它能处理模糊表述、缩写、甚至手写体的上下文关联,从而精准定位到你需要的那个“关键字段”。
简单比喻:
- 传统OCR = 拿着放大镜找关键词的手电筒(只能找死的字)。
- OCR+大模型 = 一边拿着手电筒照明,一边由一位高智商律师在旁边实时解读合同含义。
功能特点:不仅是快,更是“懂你”
除了技术上的硬核加持,这套系统在用户体验上也做到了极致的“懒人友好”。
“少样本”学习,无需大量标注
- 以前训练AI识别新类型的发票,需要专家花几周时间标注成千上万张图片。现在,你只需要上传几张典型样本(比如3-5张不同样式的合同),系统就能通过小样本学习(Few-shot Learning)迅速掌握规律。这种“举一反三”的能力,大大降低了使用门槛。
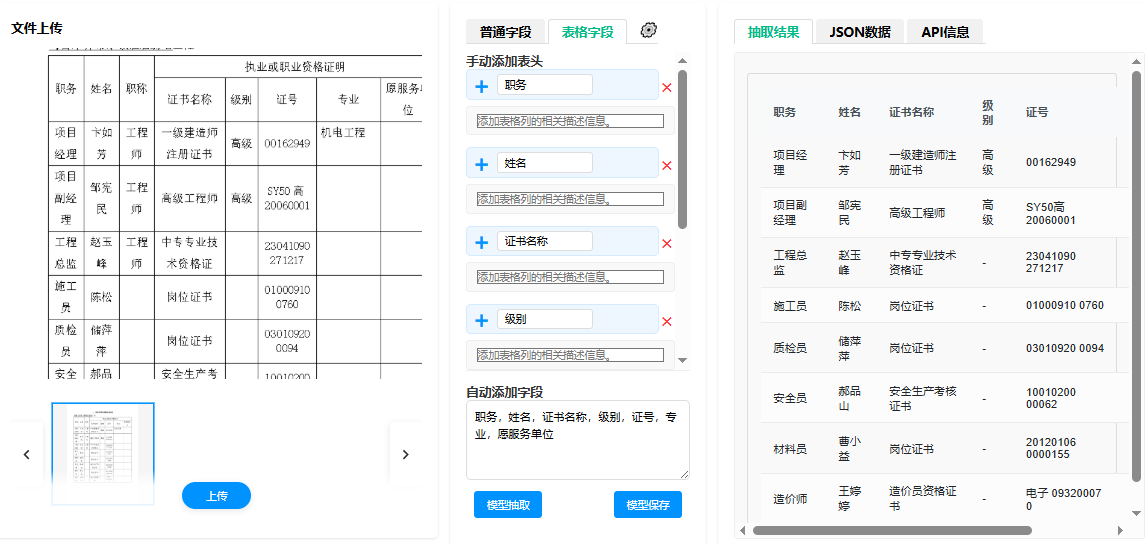
所见即所得的自定义配置
- 你不需要会写代码。系统提供可视化的界面,你可以直接圈选出文档中的特定区域(如金额、日期、名称),并赋予它一个标签。你想抽什么字段?随便定。无论多生僻的字段,都能通过简单的拖拽和定义来实现。
全格式兼容的“万能 extractor”
- 结构化数据:标准的Excel、ERP接口格式。
- 非结构化痛点:无论是中英混杂的海外发票、带有复杂印章的法律文书,还是企业内部杂乱的会议纪要,系统均能清洗干扰信息,输出纯净的结构化JSON或CSV数据。
高准确率与自我进化
- 每一次人工校验修正,都会成为系统训练的养分。系统具备反馈学习机制,用得越久,对你特定业务场景的理解就越精准,错误率呈指数级下降。
应用领域:哪里痛苦,它就救哪里
这项技术的应用边界非常宽广,几乎涵盖了所有需要处理海量文档的行业:
- 金融与保险:自动审核贷款申请表、保险理赔单据,快速提取身份证号、银行卡号、病史摘要,将原本需要几小时的核保过程缩短至秒级。
- 法律事务:批量审查千份合同,自动比对标准模板,高亮显示异常条款、缺失项或风险点,为律师节省大量的尽职调查时间。
- 跨境贸易:面对全球各地格式各异的税务发票、提单、原产地证,系统能自动识别多种语言和小语种,统一转化为标准化的报关和入账数据。
- 人力资源与行政:从简历、劳动合同、入职材料中自动提取关键信息,建立员工数字档案库,避免重复填写表单。
- 医疗健康:从病历文本、检查报告、处方笺中提取患者基本信息、诊断结果和用药建议,助力医疗大数据的分析与应用。
结语:从“数据搬运”到“价值洞察”
在过去,80%的企业数据以非结构化的形式躺在文档里沉睡,人类花费了80%的时间去把它们搬运出来。而现在,文档抽取系统正在打破这道墙。
它不仅仅是一个工具,更是一种思维方式的转变:让机器去做枯燥的“搬运工”,让人类去做关键的“决策者”。当你不再被琐事纠缠,你就能有更多的精力去思考战略、去服务客户、去创造真正的创新价值。这,或许就是科技最迷人的地方——用看不见的算法,守护你看得见的生活。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号