让 AI 当程序员:Simple Agent 的架构设计与局限性分析

让 AI 当程序员:Simple Agent 的架构设计与局限性分析

用户12724357
发布于 2026-09-15 15:24:00
发布于 2026-09-15 15:24:00
让 AI 当程序员:Simple Agent 的架构设计与局限性分析
引言:AI 程序员真的靠谱吗?
你有没有想过,对着一个 AI 说"帮我做一个学生管理系统",然后它真的能给你写出一个能跑的应用?
这个问题听起来像是科幻,但我前两天Vibe Coding了这样一个开源项目——Simple Agent,它真的做到了。在经过我这几天的探索和测试, 让我意外的不是它能生成代码,而是它的工程化程度:4 阶段流水线、导入验证、失败自动重试、人类介入机制……这哪里是一个玩具项目,分明是一套正经的软件工程方法论。
今天我们来深度拆解这个项目,聊聊它是怎么设计的,有什么局限,以及 AI 编程这件事到底走到了哪一步。
一、它到底是干什么的?
Simple Agent 的核心能力有两层:
第一层:通用 Agent 能力 它让大语言模型(LLM)能够调用工具——文件读写、Shell 命令执行、正则搜索、数学计算、跨会话记忆——来完成多步骤任务。简单说,就是给 AI 装上了"手",不只是聊天,而是能实际操作文件系统。
第二层:开发工作流能力 更关键的是,它把"做一个App"这样的自然语言需求,变成了一套结构化的开发流水线。你输入需求,它输出可运行的项目代码,整个过程不需要人工写一行代码。
它不是一个聊天机器人,而是一个AI程序员实习生——你告诉它要做什么,它写代码、跑测试、遇到问题会停下来等你指导。
二、4 阶段流水线:如何把需求变成代码?
这是 Simple Agent 最核心的设计,以下是它的运转方式:
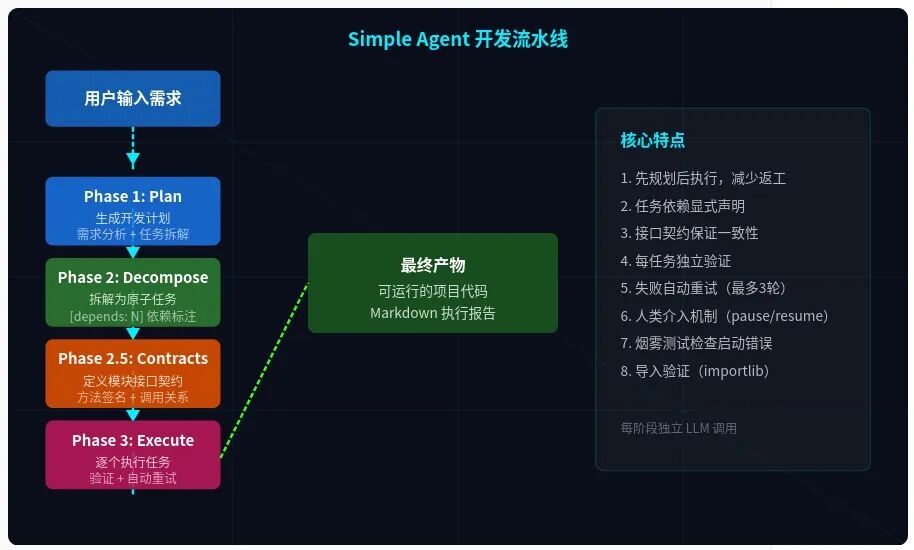
图1:Simple Agent 4 阶段开发流水线架构
阶段详解
- Plan 阶段LLM 分析需求,生成一份"需求分析 + 任务拆解大纲"。先想清楚"要做什么",而不是直接上手写代码。
- Decompose 阶段把大纲拆成具体的原子任务,每个任务只做一件事,并标注任务之间的依赖关系
[depends: N]。 - Contracts 阶段在真正写代码之前,LLM 先定义模块之间的接口契约。就像建筑项目中的图纸会审,确保各模块对得上。
- Execute 阶段按依赖顺序逐个执行任务。每执行完一个任务,用
importlib直接加载文件检查语法错误;失败的任务最多自动重试 3 轮。 - Smoke Test:启动应用检查运行时错误,确保生成的项目能跑起来。
三、Agent 核心循环是怎么工作的?
看完了流水线,我们深入到单个 Agent 的实现:
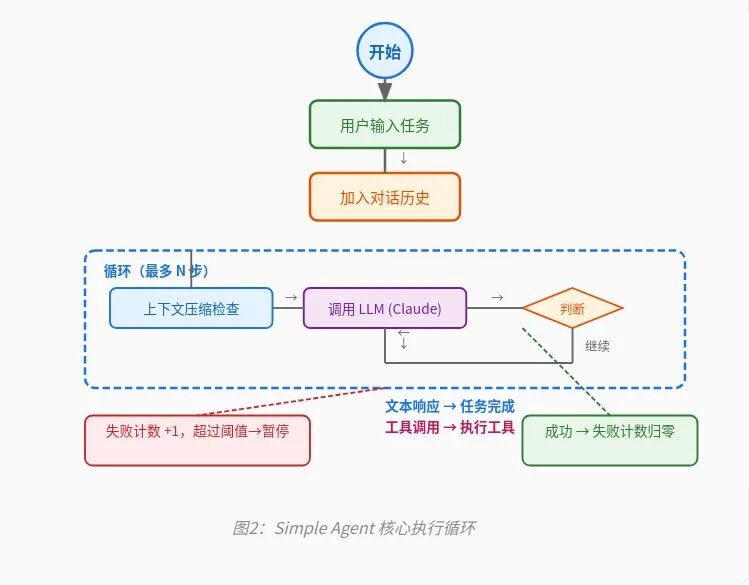
图2:Simple Agent 核心执行循环
两个设计值得注意:
1. 上下文压缩 对话越来越长时,Token 会接近模型上限。Simple Agent 的做法是:在超过 80% 上限时,调用 LLM 把历史消息压缩成一段摘要,保留关键信息。这比等到溢出才报错要优雅得多。
2. 失败暂停机制 连续失败超过 3 次,Agent 不会无限重试,而是暂停工作流,保存详细的 Markdown 报告,等人类介入。这个设计非常重要——AI 生成代码质量不稳定,必须有人工兜底。
四、工具系统:LLM 怎么操作文件?
Simple Agent 用的是工具注册中心模式:
class ToolRegistry:
def register(self, tool: BaseTool) # 工具自注册
def get(self, name: str) -> BaseTool # 按名查找
def to_api_format(self) # 转换为 Claude API 格式
目前内置了 8 个工具:
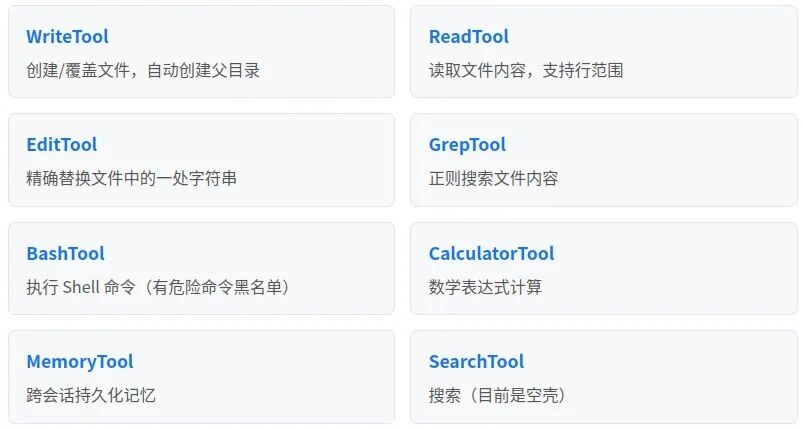
一个安全细节:BashTool 有命令黑名单,拦截 rm -rf /、mkfs、dd if= 等危险操作。但要注意,它使用的是 shell=True,并非真正的容器沙箱,这是在便捷性和安全性之间的权衡。
五、实际效果:它能生成什么样的项目?
根据项目 demo 目录,已经成功生成的项目包括:
图书管理系统
PyQt6 GUI + SQLite,包含会员管理、借阅管理、罚金管理, 这个项目的PRD是使用下面技能进行创建的,比较复杂。
/brainstorming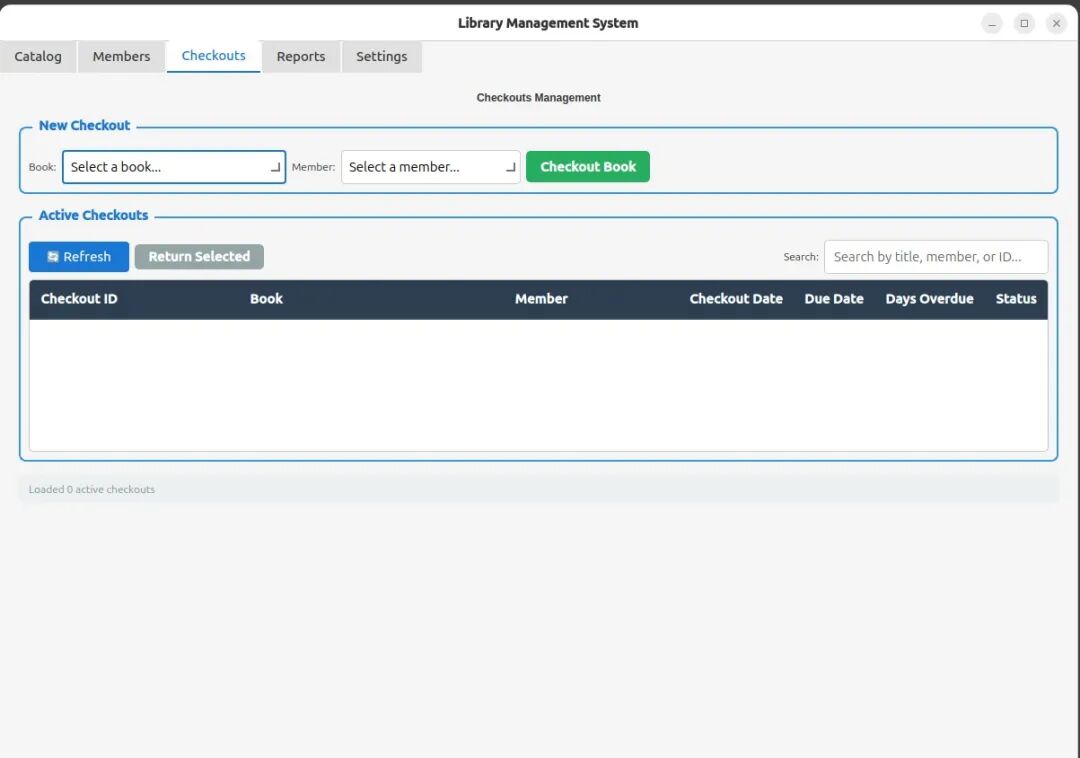
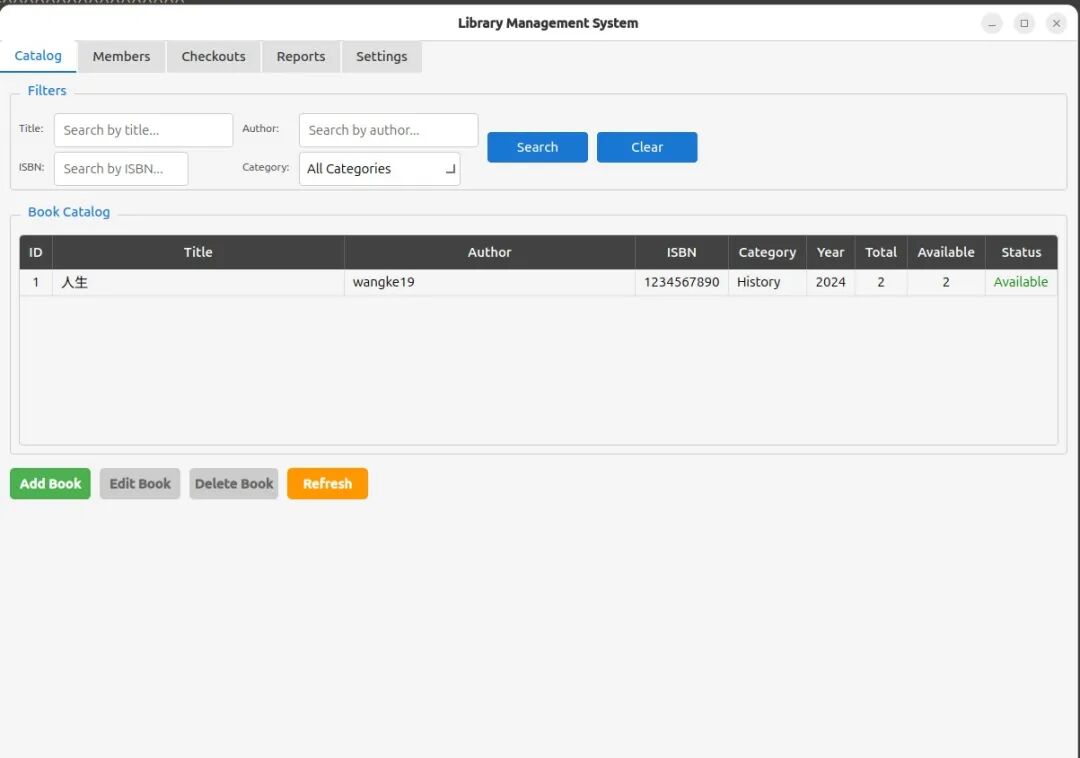
- 库存管理应用数据库 + 业务流程
- 学生管理系统Qt 界面 + 数据库 CRUD
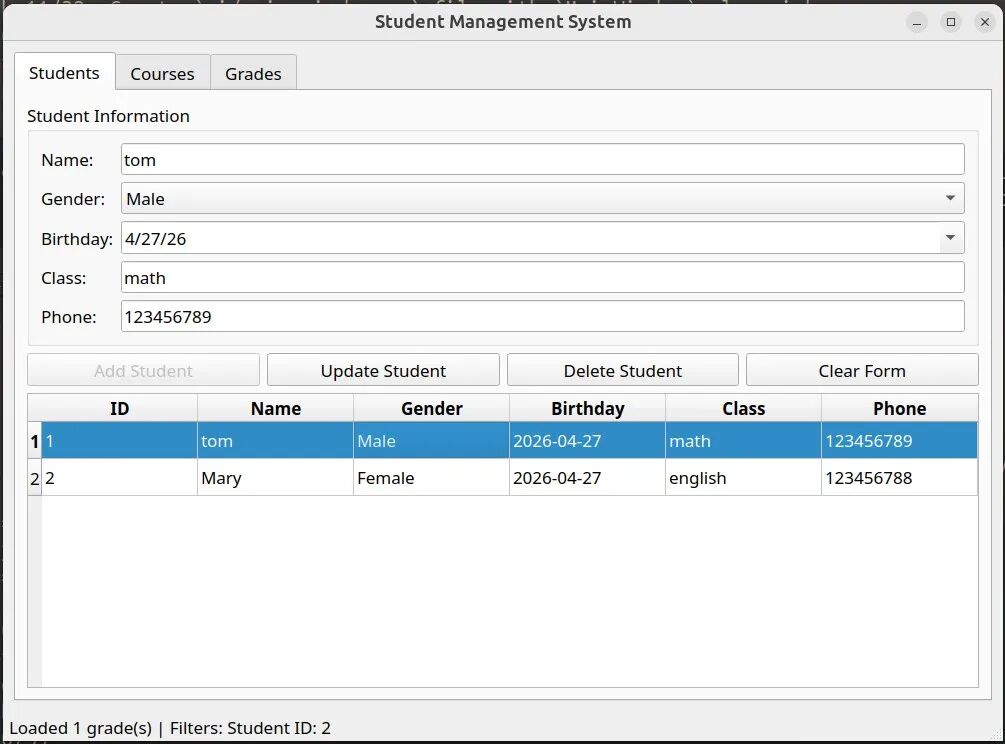
每个项目都包含完整的数据库层、界面层、服务层,以及初始化脚本。从自然语言需求到完整可运行的项目,这个目标它确实做到了。
六、不能干什么?局限性分析
技术层面的局限
1. 任务串行执行
虽然每个任务标注了 [depends: N] 依赖关系,但代码里是完全串行执行的,没有任何并行调度。很多可以并行创建的文件(比如独立的无依赖模块)也只能一个一个等。
2. 只支持 Anthropic LLM 客户端硬编码使用了 Anthropic 的 SDK,不支持 OpenAI、Google Gemini、LocalAI 等。如果想用其他模型,需要自己改代码。
3. 状态不持久化
工作流状态只存在内存里。--resume 恢复时,它实际上是从上次保存的 Markdown 报告文件里重新解析出任务状态,再继续执行。这个解析逻辑比较脆弱,报告格式一改就可能出错。
4. 上下文压缩有损 压缩后的摘要可能丢失技术细节,尤其是跨文件的依赖关系和变量命名。长时间工作流中,这种信息损失会累积。
5. Smoke Test 只检查启动错误 它只验证"应用能不能启动",不跑单元测试、不做 lint、不做类型检查。生成的代码能跑,但代码质量完全取决于 LLM 当下的能力。
产品层面的局限
没有 Web UI:纯 CLI 交互,门槛较高。技术栈不深的用户很难上手。
无监控告警:没有 metrics、没有 tracing,出现问题只能看日志。
工具生态贫瘠:只有 8 个内置工具,而且 SearchTool 是空壳。没有 Web 搜索、数据库操作、API 调用等能力,Agent 的能力边界很受限。
七、值得称赞的工程设计
1. 契约驱动开发
在执行任务之前,先用 LLM 生成模块之间的接口契约。后续每个任务的 Prompt 里都会注入这个契约,确保整个项目的方法名、参数类型、调用关系是一致的。
这个设计思路非常超前——它本质上是形式化方法的简化版,让 AI 生成代码前先"对图纸",减少返工。
2. 导入验证机制
大多数 AI 编程工具只看 LLM 输出的代码好不好看。Simple Agent 的做法是实际加载文件验证:
# 用 importlib 直接加载 Python 文件,检查是否有 ImportError
spec = importlib.util.spec_from_file_location('_check', filepath)
mod = importlib.util.module_from_spec(spec)
spec.loader.exec_module(mod)
这个判断非常正确——"能加载"是比"看起来对"更可靠的验证标准。
3. 重试状态机
3 次重试上限、依赖任务失败时暂停、无依赖任务时跳过——这套逻辑处理了实际开发中的多种情况,不是简单的"失败就重来"。
4. 测试覆盖
项目有 120+ 测试用例,包含单元测试和集成测试,mock 层次清晰。这在个人项目中非常难得,说明作者是有工程纪律的。
八、它符合"Harness Engineering"规范吗?
Harness Engineering 的核心理念是:通过系统化的验证环、自动化脚手架和工程纪律,让 AI 生成的代码从"不可靠"变为"可信赖"。
原则 | Simple Agent 实践 | 评分 |
|---|---|---|
Verified Loop(验证环) | Execute 后有 import 检查 + Smoke Test + Auto-Retry | ⭐⭐⭐⭐ |
Human-in-the-loop Pause | 失败超阈值时暂停,保存报告,支持 resume | ⭐⭐⭐⭐⭐ |
Incremental Verification | 每任务独立验证,不等到最后 | ⭐⭐⭐⭐ |
Sandboxed Execution | 工具限制在 working_dir,路径遍历防护,bash 黑名单 | ⭐⭐⭐ |
Formal Contracts | define_contracts 生成接口契约 | ⭐⭐⭐⭐ |
Regression Prevention | 有 Smoke Test,但缺少自动化单元测试 | ⭐⭐ |
Observability | Markdown 报告 + 日志,无结构化 tracing | ⭐⭐⭐ |
符合度约 65-70%。核心思想对,但 Regression Prevention(自动化回归测试)和 Observability(结构化可观测性)这两块还差得比较远。
九、值不值得继续开发?
值得,理由如下:
- 核心价值真实用自然语言需求直接生成可运行应用,这个需求是真实存在的
- 工程化程度高不是概念验证,代码结构清晰,测试完整
- 差异化定位不同于 Copilot 的"辅助编程",这是"全自动端到端开发",有独特的产品价值
- 可扩展性好架构没有过度设计,添加工具、多模型支持、持久化都很自然
但风险也要正视: LLM的不稳定性是项目质量的根本瓶颈。框架再完善,也无法保证生成的代码一定正确。以及,没有商业化路径,纯个人项目持续维护是个问题。
十、下一步规划?
Phase 1(1-2 周):稳定性提升
- 任务状态持久化(用JSON文件存结构化状态,而不是解析 Markdown)
- 增强
--fix为多步修复(重读代码 → 分析根因 → 修复) - 把 ruff/mypy 检查加入 Smoke Test
Phase 2(1 个月):多 Provider + 并行
- 抽象 LLMClient 接口,支持 OpenAI
- 实现基于依赖的并行任务调度
Phase 3(2 个月):用户体验
- Web UI(用 Gradio 或 Streamlit)
- 流式输出(不用等完整输出)
- Git 集成(每次任务完成后自动 commit)
长期:生态扩展
- 工具生态(WebSearch、数据库操作、API 客户端)
- 多 Agent 协作
- RAG 知识库
结语
Simple Agent 是一个让我意外的项目。它不是另一个"用 AI 写代码"的玩具,而是一个认真思考了 AI 编程边界的项目——知道什么能做,什么不能做,什么需要人工介入。
4 阶段流水线、上下文压缩、pause/resume 机制、导入验证——这些设计都不是花架子,而是实际工程问题的实际解法。
当然,它也有明显的局限。串行执行、只支持Anthropic API格式LLM调用、回归测试缺失……
这些问题不难解决,但需要持续的投入。
AI 编程这件事,目前的真实状态是:能做到 60 分,但离 90 分还差得远。Simple Agent 的价值在于,它把这 60 分做到了一致性和可重复——不管你什么时候跑,只要 LLM 能力在,结果质量就是稳定的。
这或许才是 AI 编程目前最该追求的东西。
项目地址:https://github.com/wangke19/simple-agent
欢迎交流与转载,注明出处即可。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-04-28,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号