智谱GLM5.1 Coding 是真的强

智谱GLM5.1 Coding 是真的强

用户12724357
发布于 2026-09-15 15:40:35
发布于 2026-09-15 15:40:35
有一段时间没有更新我的AI Agent项目Simple-agent了,最近花了些时间不务正业,去尝试做下音乐人,在AI的协助下创建自己喜欢的风格的歌曲。有兴趣的可以去听听:
这就是我的人生(AI协助下完成创作)
此心安处是故乡(AI协助下完成创作)
孤影难留(在AI协助下完成创作)
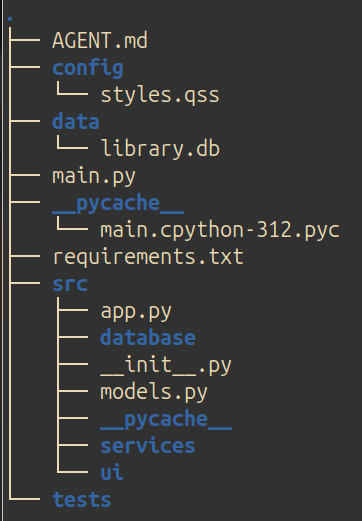
回到正题,我一直在打磨Simple Agent,每天都在不停跑测试。我最近在做一个实验:用 LLM 自动生成一个完整的图书管理系统(PyQt6 + SQLite),包含 5 个数据库表、6 个 Service、5 个 Tab、多个 Dialog。不是生成一个文件,而是从 PRD 到可运行的完整项目
下面是这个由Simple Agent自动生成的项目结构:
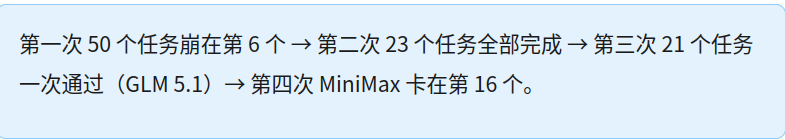
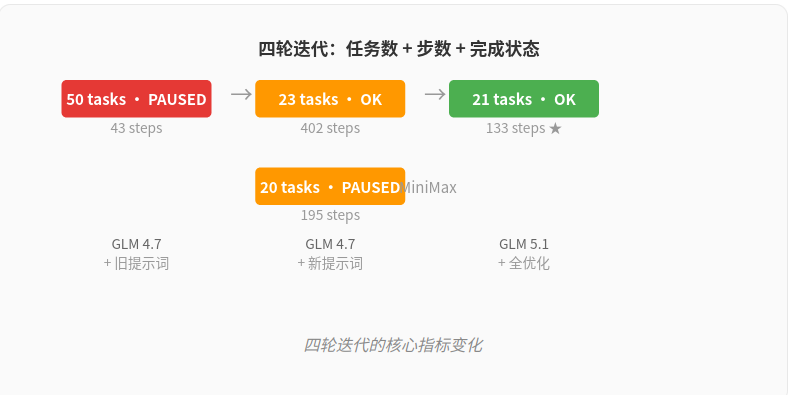
结果经历了四次迭代:
这篇文章记录了从失败到成功的完整优化过程——不是调参玄学,而是一套可复制的工程方法。踩过的坑都是可以复用到其他任何AI Agent的开发和调试过程中。
一、问题:让 LLM 生成完整应用有多难?
我的流水线是这样的:
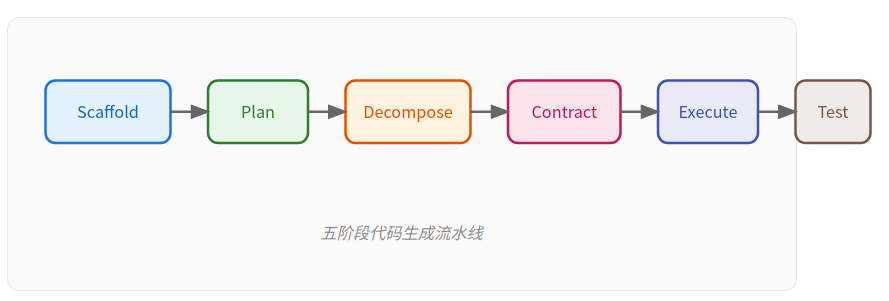
五阶段代码生成流水线,任何一个阶段的约束不到位,LLM就会自由发挥,你会发现结果每次都不一样。
第一次用 GLM 4.7 + 原始提示词,结果 50 个任务崩在第 6 个。
问题出在哪?
症状:任务 6 读取不存在的文件
任务分解把 schema 拆成了 5 个任务(每个表一个),把 service 的每个方法拆成独立任务,甚至还有独立的"验证任务"。任务 6 的工作是"验证 execute_read() 返回 dict"——它去读 book_service.py、member_service.py,但这些都是任务 8-24 才会创建的文件。
Task 6 step 3: file_read(src/services/book_service.py) → FAILED (file not found)
Task 6 step 4: file_read(src/services/member_service.py) → FAILED (file not found)
Task 6 step 5: file_read(src/services/settings_service.py) → FAILED (file not found)
→ max_failures=3 triggered, agent paused
三个连续的文件读取失败,直接触发了最大失败次数限制,整个流水线停了。
二、第一层优化:任务分解粒度
根因是分解提示词的"小"定义有问题:
# 原始提示词
"Each task must be:
- Small: one file write or one command execution"
"一个文件写入" 导致 50 个任务。更致命的是,验证型任务(任务 6、45-50)和创建型任务混在一起,验证任务试图读还不存在的文件。
修复:按功能内聚分解,而非按文件数量,任务拆分不是越原子化越好。
# 新提示词
"Each task must be:
- Self-contained: creates ALL files it needs within the task
- Functional: one complete feature (e.g. one service with all methods)
Target 15-25 tasks. Merge related work:
- A module and its helper classes → ONE task
- A service with all CRUD methods → ONE task
- Schema (tables + indexes + triggers + seed data) → ONE task
- Do NOT create verification-only tasks"
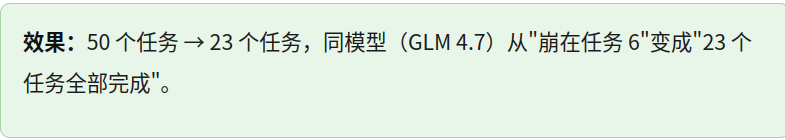
三、第二层优化:三层提示词一致性
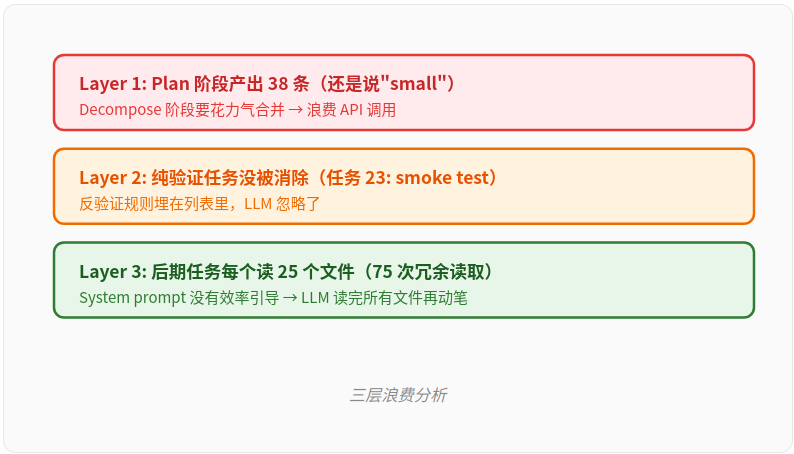
23 个任务虽然全部完成,但用了 402 步(平均 17.5 步/任务)。分析发现三个浪费层:
修复三个问题:
1. Plan 提示词和 Decompose 对齐。 之前 Plan 说"small",Decompose 说"functional"——两阶段口径不一致。统一后 Plan 直接产出 ~20 条。
2. 加强反验证规则。 从一行 bullet point 改为独立的 CRITICAL RULES 块:
CRITICAL RULES:
- Do NOT create smoke test, verification, or testing tasks.
- Do NOT create 'Verify xxx works' tasks.
- The LAST task should be the application entry point.
3. Agent 系统提示词加效率规则。 告诉 LLM 规则和 schema 已经注入,不需要重读:
Efficiency rules:
- The task prompt already includes project rules and schema.
  Do NOT re-read AGENT.md or schema files.
- Only read files directly relevant to the current task.
- Validate with a quick syntax check, then stop.
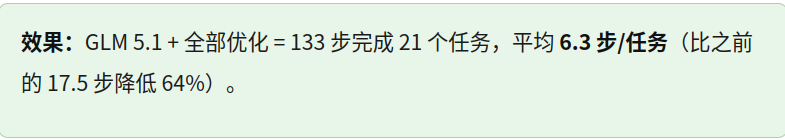
四、第三层优化:Scaffold 的角色边界
有个 bug 很有意思:生成的 App 启动报错"no such table: settings"。
initialize_database() 返回 True,但数据库里一个表都没有。
排查发现,initialize_database() 搜索 schema 文件时找到了 src/database/schema.sql——它是 scaffold 创建的空文件(0 字节占位符)。有内容的 database_init.sql 排第二,永远不会被找到。
但这不是直接原因,深挖下去:
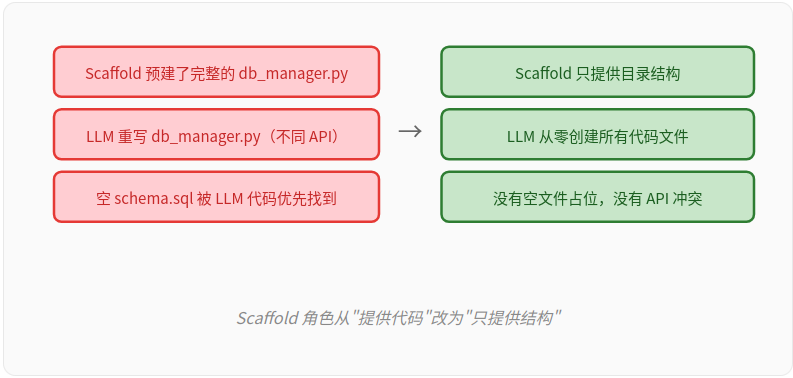
Scaffold 角色从"提供代码"改为"只提供结构"
根因不是 LLM 约束,而是架构设计:Scaffold 越界提供了代码实现(预建的 db_manager.py),但 LLM 的任务是"创建整个应用",它自然会重写这个文件。两套代码竞争同一个文件,API 不一致是必然结果。
修复:Scaffold 只提供结构(目录、__init__.py、入口文件),不创建任何业务代码。
五、模型对比:GLM 5.1 vs MiniMax-M2.7
同样的提示词和流水线,我因为GLM 1000万词元/5h 给消耗完了,不得不换成了我手里MiniMax-M2.7的coding plan继续跑项目,两个模型的表现差距很大:
指标 | GLM 5.1 | MiniMax-M2.7 |
|---|---|---|
状态 | 全部完成 | 卡在 16/20 |
总步数 | 133 | 195(未完成) |
失败数 | 4(全部自恢复) | 13(5 个任务卡死) |
任务完成率 | 21/21 | 15/20 |
步数/任务 | 6.3 | 13.0 |
Smoke Test | 1 个 PyQt6 API 幻觉 | 多个缺失文件 |
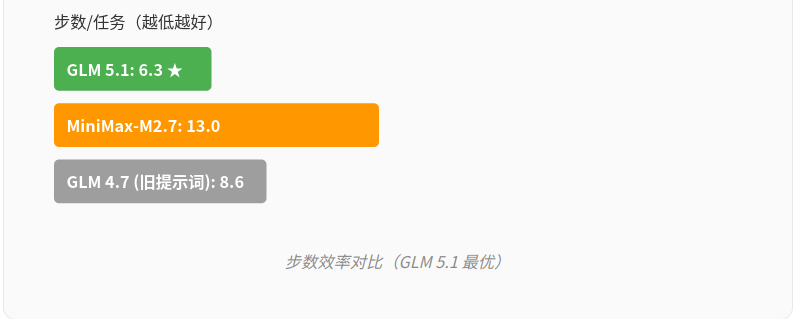
步数效率对比(GLM 5.1 最优)
关键差异不在"谁更聪明",而在于步数纪律:
- GLM 5.1:读 2-3 个文件 → 写文件 → 验证 → 结束。4 次失败全部是"文件不存在"的自恢复错误。
- MiniMax:读 5-7 个文件 → 继续读 → 还在读 → 步数用完了,文件没写出来。13 次失败中有 5 次是结构性卡死。
MiniMax 还会在输出里留 <minimax:tool_call> XML 片段,格式合规性差一截。
还有一个意外发现,GLM 5.1 在PyQt6上数据训练比Minimax 2.7上要充分,项目严格要求使用PyQt6,但是有些属性和方法Minimax 2.7竟然用PyQt5的,因为它在PyQt6上的数据训练不足。
六、四轮迭代的关键数据
我最初是用的GLM 4.7跑项目,后来切换到5.1想看看效果如何,下面是几次的结果:
迭代 | 模型 | 提示词 | 任务数 | 结果 | 步数 |
|---|---|---|---|---|---|
1 | GLM 4.7 | 旧("one file write") | 50 | 崩在任务 6 | 43 |
2 | GLM 4.7 | 新(功能内聚) | 23 | 全部完成 | 402 |
3 | GLM 5.1 | 全部优化 | 21 | 全部完成 | 133 |
4 | MiniMax | 全部优化 | 20 | 卡在任务 16 | 195 |
四轮迭代的核心指标变化
七、六条经验总结
1. 提示词质量 > 模型能力
GLM 4.7 + 好提示词(23 tasks, completed)胜过 GLM 5.1 + 坏提示词(50 tasks, paused at 6)。先修提示词,再选模型。
2. "一个文件写入" 不是好的任务粒度
真实开发按功能内聚,不按文件数。一个 Service 的 CRUD + 过滤 + 删前校验是一个整体,拆开会制造依赖链断裂。
3. 验证任务是反模式
"验证 xxx 是否工作" 类型的任务在依赖之前执行就会崩。验证应内建在每个创建任务中,不单独拆出。
4. Scaffold 只提供结构,不提供实现
预建代码会被 LLM 重写,API 不一致是必然。Scaffold 的职责是目录、包标记、入口文件——不是业务代码。
5. 空占位文件是陷阱
空的 schema.sql 通过了 path.exists() 检查但没有数据,欺骗了后续的文件搜索逻辑。不要创建空文件。
6. 工具错误消息是反馈回路的一部分
"File not found" 让 LLM 猜测;"'src/services' is a directory, files: book_service.py, member_service.py..." 让 LLM 一次就修正。提高错误消息质量,回报是减少 API 调用浪费。
写在最后
LLM代码生成不是一个"给提示词就行"的黑盒。它是一条工程流水线,需要像对待 CI/CD 一样认真对待每层的输入输出。
提示词是配置,Scaffold 是基础设施,工具是运行时。每一层的设计缺陷都会在下游放大。从 50 个任务崩在第六个到 21 个任务一次通过,不是换了个更好的模型——是修好了流水线的每一层。
项目开源地址:github.com/wangke19/simple-agent
欢迎交流与转载,注明出处即可。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-05-05,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号