省 Token 的真相:别让 Flash 模型写你的第一版代码

省 Token 的真相:别让 Flash 模型写你的第一版代码

用户12724357
发布于 2026-09-15 19:09:23
发布于 2026-09-15 19:09:23
用 Claude Code 这类 AI 编程工具的开发者,多半都做过同一件事:想办法省 token。在之前的一篇文章里改了3行配置,我的Claude Code Token消耗降了75%我配置了Claude Code的三层模型路由还有压缩窗口的方案来省token。其实还有精简 CLAUDE.md、缩短分支名的方案可以省token.
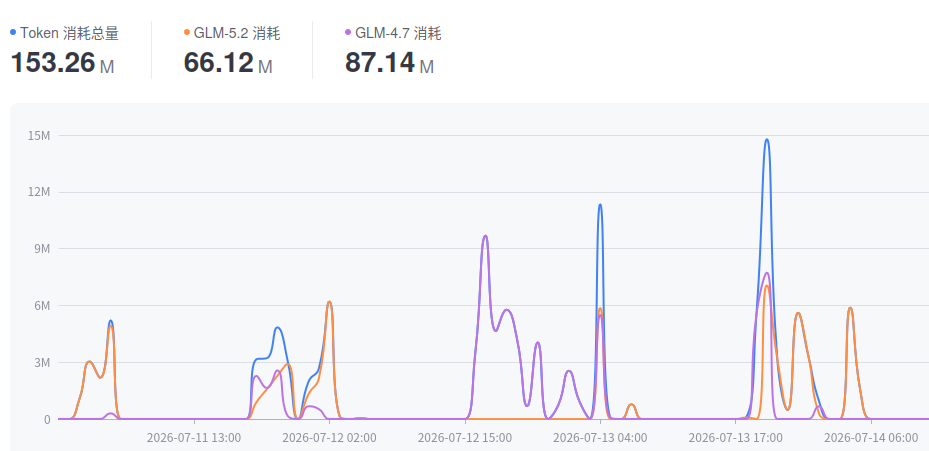
下面这张图,就是我在之前一篇文章改动配置后,目前的token消耗情况,可以看出,GLM5.2的消耗明显降低,GLM4.7明显增加,目前我还没有遇到5小时使用额度的限制。
但今天一次三小时的精简 CLAUDE.md复盘让我意识到:我上一篇文章里犯了一个错误——"省小钱亏大钱"。Claude Code的环境变量里的 subagent 跑着不擅长写代码的 Flash 模型;
CLAUDE_CODE_SUBAGENT_MODEL="glm-4.7-flash"我之前没意识到,在用glm5.2进行完项目的规划和设计后,为了省token,在代码实施的阶段,我采用glm-4.7-flash作为sub-agent进行开发的模型,把第一版代码的质量忽略掉了。
这篇文章是一次完整复盘——我把自己的 CLAUDE.md 从 2571 字符激进精简到776,删掉了项目经验;从一个错误的精简动作开始,到调研四个国产模型的真实能力边界,最后回到一个反常识的结论:我的 subagent 模型,可能从一开始就选错了。
记住,免费永远是最贵的。
起因:一份"省 token 方案"引发的踩坑
故事的起点是一份很标准的省 token 清单:三层模型路由(Sonnet/Opus/Haiku 槽位各用不同模型)已实施;
AUTO_COMPACT_WINDOW 压缩窗口:已实施;
Git 短分支命名:待实施;
CLAUDE.md 精简:待实施;
输出控制 / 上下文控制:使用习惯。
我当时的想法是 ——"精简 CLAUDE.md 这事我熟",于是我叫Claude Code把所有"看起来通用"的内容都压缩了,结果是:Go 最佳实践的 4 条详细规范 → 合并成一行;Conventional Commits 的 7 种 type 列表 → 删掉;Two-Commit Rule 的完整说明 → 压成"PRs = 2 commits";PR Guidelines 的 5 条详细 SOP → 压成一行。
这不是我想要的,它把我一些是项目实践中的经验,都给删除了。那一瞬间我才意识到,Claude Code没有一个标准进行精简,它把信息密度的精简,误当成了内容的删除。
第一次反思:CLAUDE.md 不是 prompt,是跨模型规范
我重新打开被精简的 CLAUDE.md,逐条审视。
Two-Commit Rule 是什么?它不是常识,而是在自己具体的Golang 项目里总结出来的 PR 强约束:
第一个 commit 只放基础设施代码(exclude go.mod、go.sum、vendor/、生成产物);第二个 commit 放依赖或生成产物(如 make update 输出)。
这种规则没有任何通用知识可以替代,是工程项目开发过程中代码Review,PR revert时候的经验。哪怕你给模型最详细的"行业最佳实践",它也猜不到这个团队要求 PR 必须正好两个 commit、且必须按这个顺序拆分。
同样的:"Baseline on upstream/main, not fork" 是该项目特定的基线选择;"Run make update; commit only files changed vs upstream" 涉及项目自带的生成器;"Conflicts in generated files: git checkout upstream/main -- , re-run generator" 是一条完整的项目 SOP。
写入CLAUDE.md的信息,这个应该是对所有模型的规范和约束。这句话看似平常,实际上揭示了 CLAUDE.md 的本质——它不是给某一个模型看的 prompt,而是给将来可能接入的所有模型的跨模型规范。
我自己的配置里就同时跑着GLM、DeepSeek、MiniMax等多种国产模型。如果某条规则假设"GLM-4.7知道这件事",那当切换到DeepSeek V4 Flash 或 MiniMax M3 时,这条规则就失效了。换句话说,CLAUDE.md 必须以"能力下限模型"为基准来设计,而不是以"当前主力模型"为基准。
这是个非常重要的认知重构。原来的精简思路是"通用内容可以删",但正确的问题是:"能力下限模型"是否能可靠地掌握这些内容?
调研下限:四个国产模型的真实能力
要回答这个问题,必须先搞清楚下限模型是谁、能力是多少。我调研了四个候选模型。
GLM-5.2(Opus 槽位,项目规划用)
智谱 2026 年 6 月发布的开源旗舰。官方定位 "Built for Long-Horizon Tasks",1M 无损上下文,Terminal-Bench 2.0 拿到 81.0,比 GLM-5.1 的 62.0 提升近 20 个点。AI 编程榜单开源第一,仅次于 Fable-5。这是我配置里的 Opus 槽位(项目规划用),能力最强。
DeepSeek V4 Flash
2026 年 4 月 24 日发布,284B 总参 / 13B active MoE。SWE-bench Verified:79.0%(Pro 版 80.6%)。Terminal-Bench 2.0 在 V4 系列表现强劲,是开源模型里的 frontier 选手。
MiniMax M3
官方博客明确写到"frontier-level performance on coding and agentic work",1M context,完成了 147 个 benchmark、1959 次评测,覆盖 software engineering、terminal execution、tool use、agent tasks。第一个同时具备 frontier coding/agentic + 1M context 的 open-weight 模型。
MiniMax M2.7
是我的另一个候选。SWE-Pro 56.22%,能自主处理 30%-50% 工作流。能力档位明显低于前三个。
四个候选模型 SWE-bench 对比:
模型 | SWE-bench | 定位 |
|---|---|---|
DeepSeek V4 Flash | 79.0% | 开源 frontier |
MiniMax M3 | ~78% | frontier coding + 1M context |
GLM-4.7 旗舰 | 73.8% | 主力对话 |
MiniMax M2.7 | 56.2% | 中档 |
但这里有个关键陷阱——以上全部都是"备选模型",不是"实际下限模型"。
关键转折:subagent 实际用的是 glm-4.7-flash
我之前真实的 Claude Code 配置:
ANTHROPIC_MODEL="glm-4.7"
ANTHROPIC_DEFAULT_SONNET_MODEL="glm-4.7"
ANTHROPIC_DEFAULT_OPUS_MODEL="glm-5.2"
ANTHROPIC_DEFAULT_HAIKU_MODEL="glm-4.7-flash"
CLAUDE_CODE_SUBAGENT_MODEL="glm-4.7-flash"
看出问题了吗?
Sonnet 槽位(主力项目规划):glm-4.7 旗舰,SWE-bench 73.8%;
Opus 槽位(复杂任务):glm-5.2,frontier 级;
subagent(实际写代码):glm-4.7-flash,SWE-bench 59.2%。
实际写第一版代码的主力是 GLM-4.7-Flash 的 59.2%。
规划再好,规划完之后干活的是 subagent。这就像一家公司:CEO 是顶级专家,但所有具体执行都交给实习生——CEO 再聪明也救不回来。
⚠ 重活交给了最弱的模型
深度评估:Flash 不适合做 subagent
于是我就调查glm-4.7-Flash 做为 sub-agent 进行项目实施第一版写代码的主力,是否合适?我开始系统调研 Flash 的真实表现。
官方数据看起来还行:SWE-bench 59.2%(同级 SOTA),τ²-Bench Telecom 接近 99%(terminal agent 强),30B 总参 / 3B active MoE,200K context,价格便宜 Claude 42 倍。
但社区实测反馈暴露了几个致命问题:
问题 1:长上下文推理降级
HuggingFace 社区讨论明确指出, glm-4.7-Flash 的"长上下文推理分数很差"。虽然宣传 200K context,但在 coding agent 这种需要长对话累积上下文的场景下,性能会显著退化。而 subagent 的工作模式正好是长上下文——多轮工具调用、读多个文件、累积项目状态。
问题 2:Tool-calling schema 兼容性失败
openclaw issue #27281 直接写到:glm-4.7-Flash在agent 框架中"consistently fails",原因是不接受 tool-calling schema 的某些部分。这对 subagent 是毁灭性的——subagent 的核心工作就是 tool use。
问题 3:Reasoning tag 格式 bug
glm-4.7-Flash 不发开标签,导致推理内容"泄露"。很多 agent 框架依赖完整的 reasoning 分离来工作,这个 bug 会破坏整个工作流。
问题 4:复杂多步任务不稳定
arXiv GLM-5 paper 提到 glm-4.7-Flash在困难任务上"only rarely or fails consistently"。SWE-bench 59.2% 看似不低,但剩下的 40.8% 都是多步复杂任务——而写代码几乎从来都是多步任务。
社区共识
我把所有找到的资料汇总,得到一个清晰的结论:glm-4.7-Flash 不在任何一个"budget subagent 推荐"的列表里。
社区推荐的 budget subagent 模型是:GLM-4.7 旗舰(不是 Flash);DeepSeek V3.2 / V4;Qwen3-Coder-Next(agentic tool use 上甚至超越 Claude Opus)。
没有任何一个评测推荐 glm-4.7-Flash 做 subagent。它强的是 τ²-Bench Telecom 这种"短回合 terminal 任务"——单次跑个命令、解析输出。但 subagent 是"长链路 agentic 任务",完全是两个赛道。
glm-4.7-Flash 的能力错位:
glm-4.7-Flash 擅长 | subagent 需要 |
|---|---|
短回合 terminal 任务 | 长链路 agentic 任务 |
单次命令调用 | 多轮 tool calling 链 |
输出解析 / 短回答 | 长上下文累积 |
τ²-Bench(99%) | SWE-bench(59.2%) |
用错场景,59.2% 的能力也发挥不出来。
配置升级:方案 A
评估结论很清晰:glm-4.7-Flash 不适合做 subagent 主力。最后我得出了两个替换方案:
方案 | subagent 改为 | SWE-bench | 优势 | 代价 |
|---|---|---|---|---|
A(强烈推荐) | glm-4.7 旗舰 | 59.2% →73.8% | 同生态零切换,+14.6 个百分点 | 成本略升 |
B | deepseek-v4-flash | 79.0% | 编程最强 | 需切换 API |
具体改动很小:
~/.claude/settings.json 或环境变量, 从 flash 升级到旗舰
CLAUDE_CODE_SUBAGENT_MODEL="glm-4.7"
ANTHROPIC_DEFAULT_HAIKU_MODEL="glm-4.7-flash" # 保留 Flash 仅做轻量任务
这里有几个决策逻辑值得展开:
为什么选 A 而不是 B(DeepSeek)
DeepSeek V4 Flash 的 79.0% 确实最高,但跨生态切换涉及 API key、base URL、模型 card 全部重配。更重要的是——用户的整个工作流已经围绕 GLM 生态搭建(skill 路径、记忆系统、配置文件)。换生态的迁移成本远大于 5 个百分点的 SWE-bench 差距。
为什么 Haiku 槽位保留 glm-4.7-Flash
Haiku 槽位在 Claude Code 里通常处理"读个文件、跑个简单命令"这种轻量任务。glm-4.7-Flash 在这类短回合任务上确实强(τ²-Bench 99%),且价格便宜。把 它留在 Haiku 槽位,是让便宜模型干便宜活。
为什么我没有选MiniMax大模型?详见 我的MiniMax Starter套餐完全废了:从按次计费到按Token计算
核心原则:subagent 不能省
第一版代码质量直接决定后续 review/rework 成本。规划阶段省下来的 token,会在 review/rework 阶段加倍偿还。一个写得烂的第一版,需要主模型花更多 token 去 review、修复、重构,最终总成本反而更高。
重新精简:按新下限制定策略
配置升级后,能力下限从 Flash 的 59.2% 提升到 GLM-4.7 旗舰的 73.8%。但还有一个关键数据点不能忽略:GLM-4.7 的 Terminal-Bench 2.0 只有 41%。
这意味着:73.8% 的 SWE-bench 说明写代码没问题,但41% 的 Terminal-Bench 说明复杂 shell 工作流仍是弱项。所以精简策略要双轨:
代码相关通用知识(Go 最佳实践、Conventional Commits):可以删;
复杂 git 工作流(rebase --onto、generated artifacts 冲突处理):必须保留具体命令。
基于这个策略,我重新精简:
保留内容:
保留内容 | 原因 |
|---|---|
graphify 触发规则 | 自定义 skill |
Priorities 决策顺序 | 团队偏好,影响判断 |
脱敏占位符完整列表 | K8s 场景特定规范 |
Go 文件命名 + 验证命令 + 测试要求 | 项目工具链 |
Commit 格式 + 示例 | 项目特定 area 写法 |
Branch naming 约定 | 团队规范 |
Two-Commit Rule 完整内容 | 团队强规则 |
PR Guidelines 全 5 条(含 git rebase --onto) | Terminal-Bench 41% 是 GLM-4.7 弱项,复杂 git 工作流需明确指令 |
最终结果:2571 → 1789 字符,减少 30%,项目经验 0 损失。
内容减少比例——从最初的70%(过度精简)到最终的30%(科学精简),减少了一半。 这是适合我自己目前所使用的所有的开发模型。
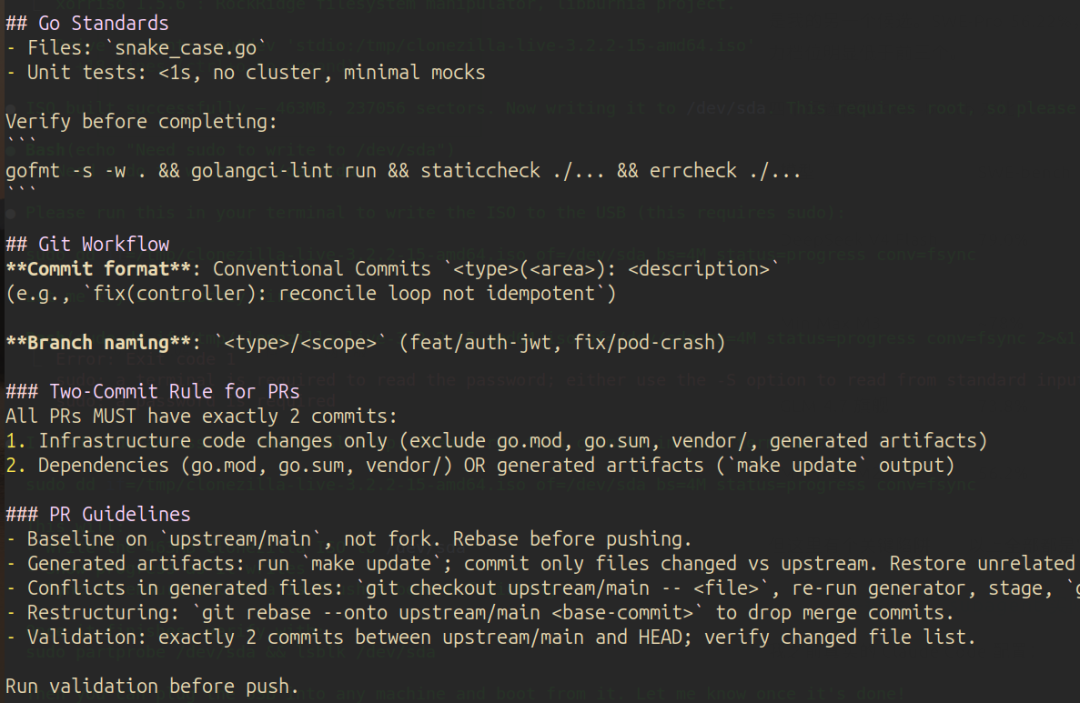
下面是我的Golang开发相关的一些约束,
方法论沉淀:四象限决策框架
把这次复盘抽象成可复用的决策框架。判断 CLAUDE.md 每条内容该不该删,看两个维度:内容性质(项目特定 vs 通用知识);下限模型能力(强项 vs 弱项)。
四象限决策矩阵:
通用知识 | 项目特定 | |
|---|---|---|
模型弱项 | 保留要点(给模型提示锚点) | 必须详细写(含具体命令、流程、SOP) |
模型强项 | 直接删(行业规范、基础语法) | 精简保留(项目独有的规则、命名) |
用这次复盘的具体例子套进四象限:
象限 | 案例 | 处理 |
|---|---|---|
项目特定 + 模型弱项 | Two-Commit Rule、PR Guidelines(含 git rebase --onto) | 完整保留 |
通用知识 + 模型弱项 | (本次未遇到,但如 Terminal-Bench 41% 暴露的复杂 shell) | 保留要点提示 |
项目特定 + 模型强项 | Commit 格式<type>(<area>): <desc>、branch naming | 精简保留 |
通用知识 + 模型强项 | Conventional Commits type 列表、Go happy path/context | 直接删 |
关键提醒:模型"强项"必须有数据支撑
这里有一个非常重要的方法论陷阱:"模型强项"不能凭直觉判断,必须查benchmark。
我最初也想当然认为"大模型都会git操作"。直到查到GLM-5.2 在 Terminal-Bench 2.0 拿到 81.0,GLM-4.7 拿到 41.0,同系列模型分数差了一倍。如果仅凭"大模型应该都会 git"的直觉,就会在 GLM-4.7 上栽跟头。
所以正确的精简流程必须是:确定实际下限模型(不是备选模型,是配置文件里真正跑的那个);查该模型在每个相关维度的 benchmark(SWE-bench、Terminal-Bench、τ²-Bench 等);对每条 CLAUDE.md 内容应用四象限框架;遇到不确定的能力边界,偏向保留(向下兜底)。
结语:选模型和写 prompt 是同一件事
这次复盘最深的体会是:选模型和写 prompt 不是两件事,而是同一件事的两面。
选了能力强的模型,prompt 可以精简;选了能力弱的模型,prompt 必须详细。反过来,prompt 的详略程度,本身就隐含了对模型能力的假设。脱离模型谈 prompt 优化,就像脱离硬件谈软件性能——都是空中楼阁。
所以下次当你想精简 CLAUDE.md、优化 system prompt、设计 agent workflow 时,先问自己三个问题:实际跑的是哪个模型?这个模型在我关心的维度上 benchmark 是多少?我准备删的内容,属于四象限的哪一格?
想清楚这三件事,再动手。否则你省下的token,可能在你看不到的地方加倍偿还。
最后回到一个具体建议:如果你也在用Claude Code + 国产模型,检查你的 CLAUDE_CODE_SUBAGENT_MODEL。这个不起眼的配置项,决定了你的第一版代码质量。如果它指向任何一个Flash变体——GLM-4.7-Flash、DeepSeek-V4-Flash 或类似的轻量模型——把它换成同系列的旗舰版。成本会略微上升,但代码质量会有显著的提升,给后续的 Review和维护减轻工作量。这笔账,怎么算都划算。当然,如果你是土豪,没必要,所有的活都可以只用最贵的大模型。
欢迎分享给正在使用 Claude Code 的朋友
或在评论区分享你的省 token 经验踩坑故事
本文基于 2026.07.16 的一次 Claude Code 配置复盘整理。涉及的 benchmark 数据均来自官方文档与社区实测。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-07-17,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号