6小时,2.89亿token,我用Agent Team给SQLite加了向量检索支持

6小时,2.89亿token,我用Agent Team给SQLite加了向量检索支持

用户12724357
发布于 2026-09-15 19:10:22
发布于 2026-09-15 19:10:22
前几天刷视频,看到有人用 Kimi K3 给 SQLite 添加原生的向量检索能力。视频不长,十来分钟,讲的是如何使用最近火爆的 Kimi K3 让 SQLite 原生支持向量相似度搜索。
SQLite 是全球部署量最大的数据库——每台手机、每个浏览器、每个嵌入式设备里都有它。它实现向量搜索是通过一个第三方的扩展 sqlite-vec,不是数据库内置的解决方案。
我手里正好有几个大模型的 token plan:GLM-5.2、deepseek-v4-flash、MiniMax-M3、GLM-4.7。于是我就有个想法,能不能用 Agent Team 模式——一个模型当架构师,几个模型当程序员和审查员——把这个功能从零写出来?
结果:6 小时,3466 行 C 代码,三种索引算法,2.89 亿 token 消耗,把这事情搞成了。
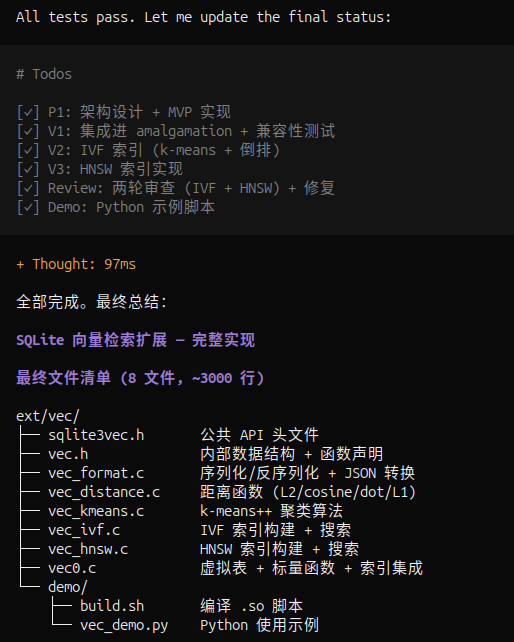
这篇文章记录整个过程——重点不是代码怎么写的,而是 Agent Team 怎么协作的,以及我在旁边刷碗喂猫的时候它们在干什么。
先说结果
做了什么?
给 SQLite 添加了一个向量检索扩展,支持向量存储、四种距离函数、三种搜索模式(暴力扫描、IVF 索引、HNSW 索引),集成进了 SQLite 官方构建系统。22 项核心回归测试零差异。
为什么做?
验证两件事。第一,多智能体协作模式能不能在短时间内完成一个 3000+ 行的生产级 C 项目。第二,我本人不会写 C,能不能靠 Agent Team 把这事干成。
读者可以获得什么?
一个 Agent Team 编排模板——从开工前评估到模型分工到任务分派到自动循环运行的完整流程。以及一个可用的 SQLite 向量检索扩展,附带 Python 示例。
一、开工前:评估了什么
这个项目不是头脑一热就开工的。动手之前,我做了三轮评估。
个人技术栈评估
先说我的背景。我的主力语言是 Go 和 Python。C 语言最近一次接触是7年前做KVM 测试的时候,不算深入。再往前,15年前我用 C++ 给 SQLite3 做过数据库加密扩展,算是跟 SQLite 的源码打过照面。至于向量数据库,我知道这个东西是干嘛的,但内部原理完全不了解。
换句话说:我对 SQLite 有基础认知,但 C 语言手生了,向量检索是全新领域。如果纯靠自己写,光理解 HNSW 论文和 SQLite 虚拟表 API 就得花好几天。但如果用 Agent Team,我只需要做架构决策和任务分派。
工具选择:为什么用 OpenCode 而不是 Claude Code
多智能体协作需要编排工具。Claude Code 是最流行的 AI 编程工具,但它有一个硬伤:不支持不同 Provider 的大模型组队开发。Claude Code 只能用 Anthropic 自家的模型。我的 token plan 分散在智谱(GLM)、商汤SenseNova(DeepSeek-v4-flash)、MiniMax 三家提供商,Claude Code 用不了。
OpenCode 不一样。它原生支持多 Provider 混搭——Orchestrator 用 GLM-5.2,Explorer 用 deepseek,Reviewer 用 MiniMax-M3,各家模型各司其职。而且 OpenCode 有一个对开发者友好的功能:代码更改比较(diff view),每次 Agent 修改代码都会显示变更对比,方便人工检查。
模型能力评估
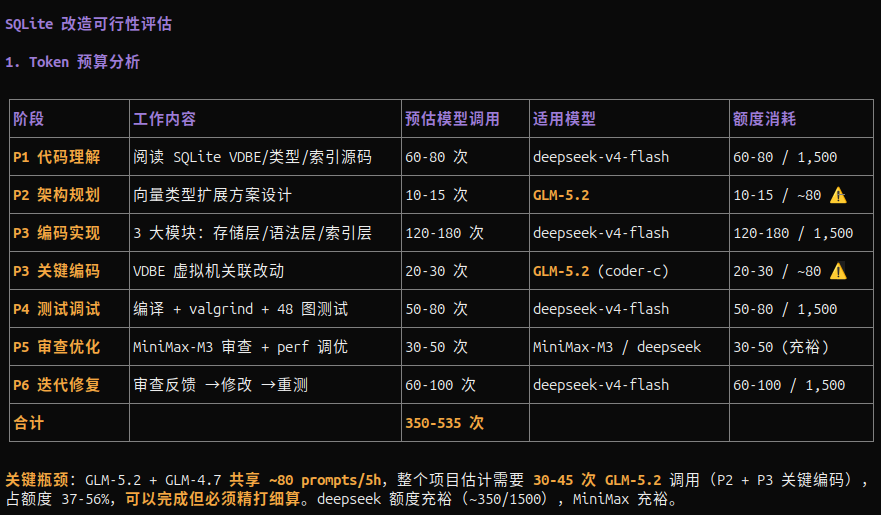
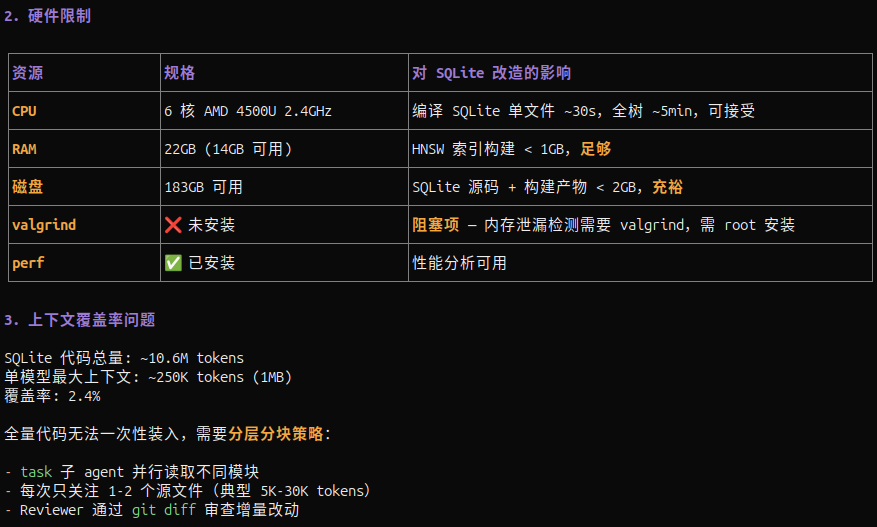
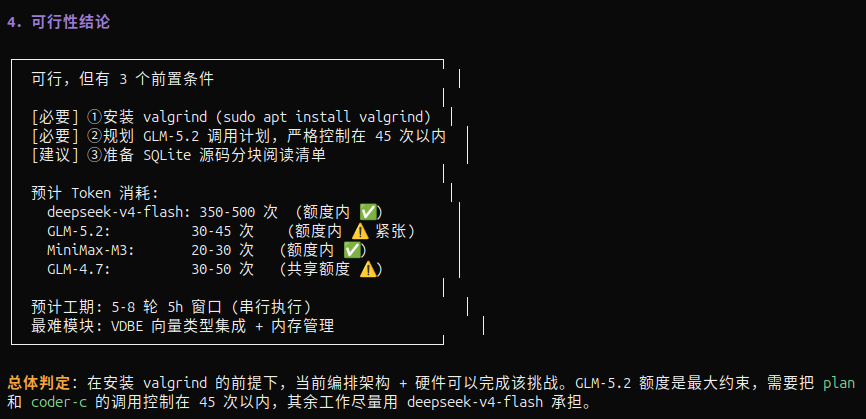
确定了工具之后,我评估了手上每个模型的能力和限制:
1Mb 上下文是关键。SQLite 的 vdbe.c 有 5 万行,btree.c 有 10 万行。128K 上下文的模型一次塞不下,1Mb 上下文的模型才能一次性读完多个源文件并给出分析。
最终确定方案
三轮评估做完,先是要开启Opencode C语言的LSP(Language Server Protocol)支持, 其次搭建好 Agent Team,然后用 opencode --auto 模式启动——这个模式会自动批准所有需要确认的操作(文件编辑、bash命令),让 Agent 全自动运行。
启动之后,我就去厨房刷碗了。
二、Agent Team 怎么协作的
整个项目用了 21 个子代理任务,按角色分工:
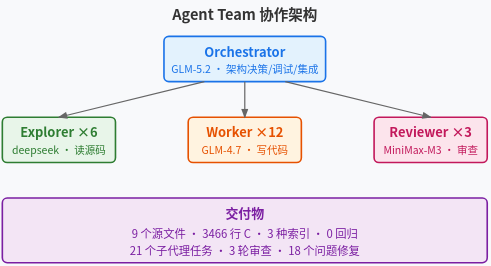
分工原则:贵的模型只做决策,便宜的模型干活。
Agent 自主完成了全部技术决策
需要特别说明:技术方案、搜索算法、数据库表结构——这些都是 Agent 自己研究和决定的,我没有做任何技术干预。
Orchestrator(GLM-5.2)启动后,自己干了这些事:
我做的唯一决策是:在启动前确定了模型分工和 --auto 模式。启动后,技术层面的活全是 Agent 自己干的。
Agent 之间的协作流程
以 IVF 索引的实现为例,展示 Agent Team 的完整协作链路:
第一步:Explorer 探索
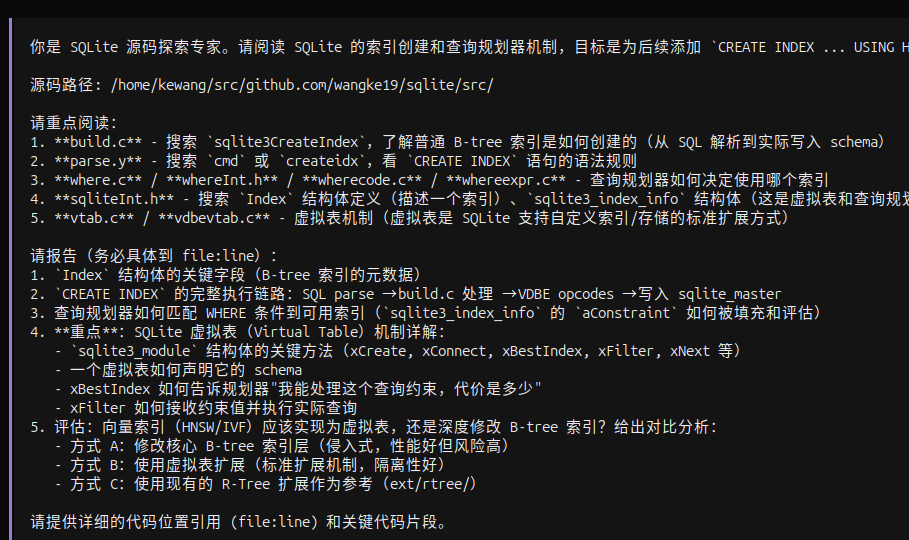
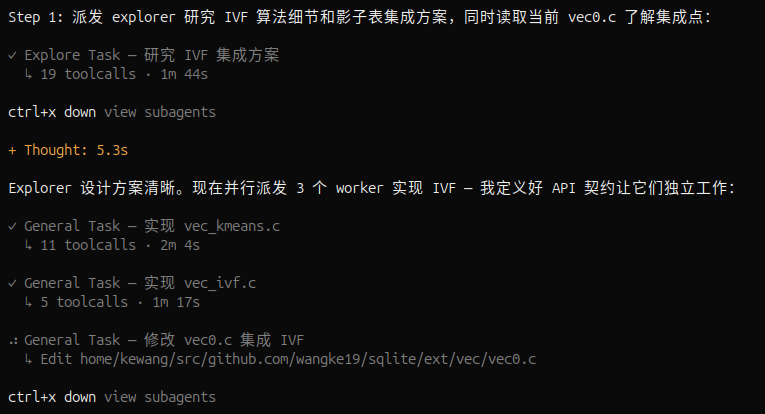
Orchestrator 派发一个 Explorer 子代理(deepseek),任务是研究"如何在现有 vec0 虚拟表中集成 IVF 索引"。Explorer 读完相关源码后,产出一份设计方案:影子表 schema、构建流程、搜索路径、需要修改的函数清单。
这是一个Explorer Agent的工作情形:
第二步:Worker 实现
Orchestrator 根据 Explorer 的方案,并行派发 3 个 Worker 子代理(GLM-4.7):
- Worker-1 写 k-means 聚类算法(vec_kmeans.c)
- Worker-2 写 IVF 索引构建和搜索(vec_ivf.c)
- Worker-3 修改虚拟表主模块集成 IVF 路径(vec0.c)
每个 Worker 收到的指令包括:函数签名、输入输出约束、编译验证命令。Worker 写完代码后自己编译验证,确保零 warning 才返回结果。
第三步:Reviewer 审查
Orchestrator 派发 Reviewer 子代理(MiniMax-M3)审查 IVF 代码。Reviewer 发现 6 个问题:整数溢出、悬垂指针、rowid 连续性假设……按 CRITICAL/HIGH/MEDIUM 分类报告。
第四步:Worker 修复
Orchestrator 根据 Reviewer 的报告,派发 Fixer Worker 逐个修复,修复后重新编译验证。
Agent Team自动测试,发现bug:
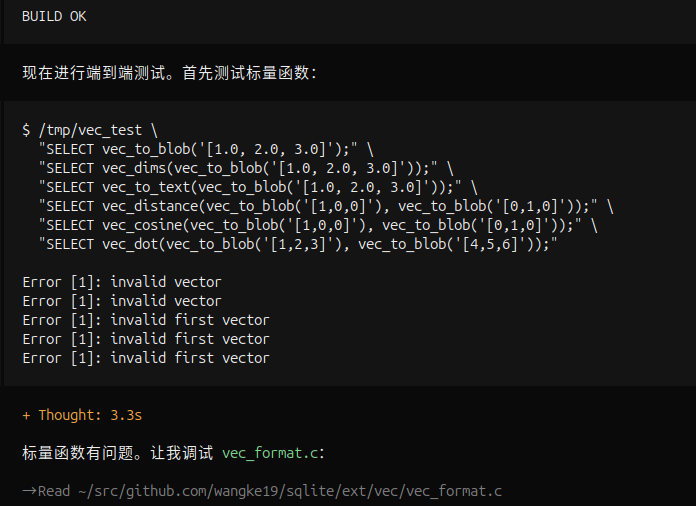
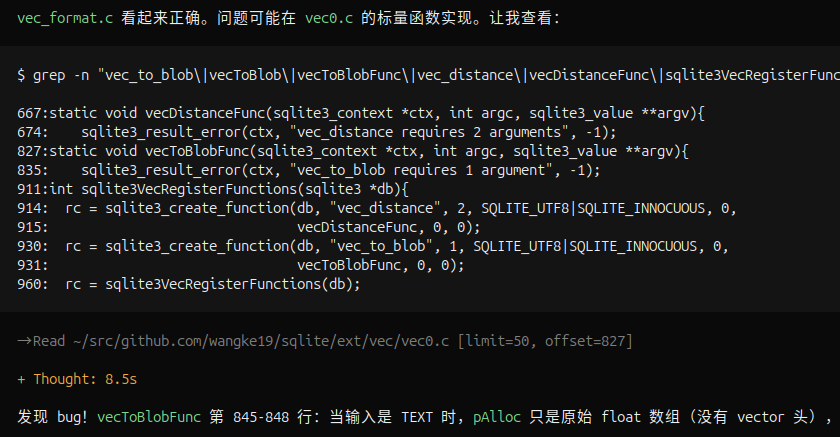
Opencode修复bug过程中会显示哪些代码做了改动:
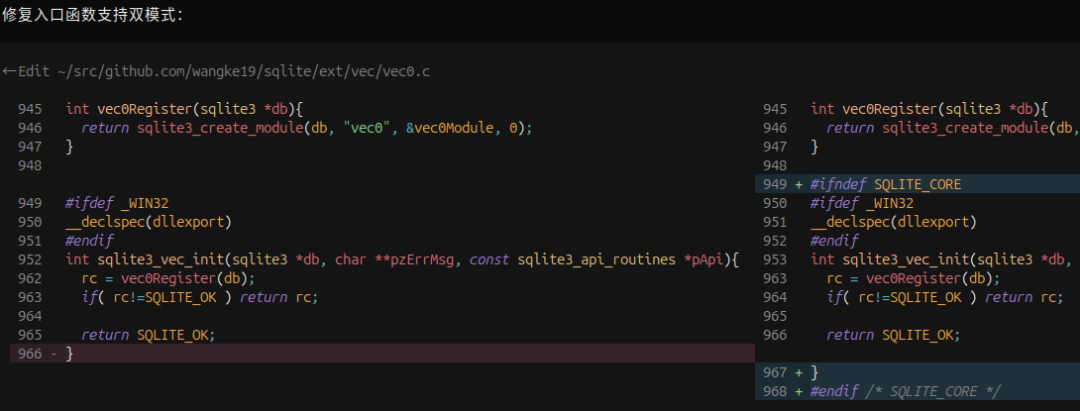
整个过程我没有介入。Orchestrator 自己决定下一步做什么,自己分派任务,自己收集结果。
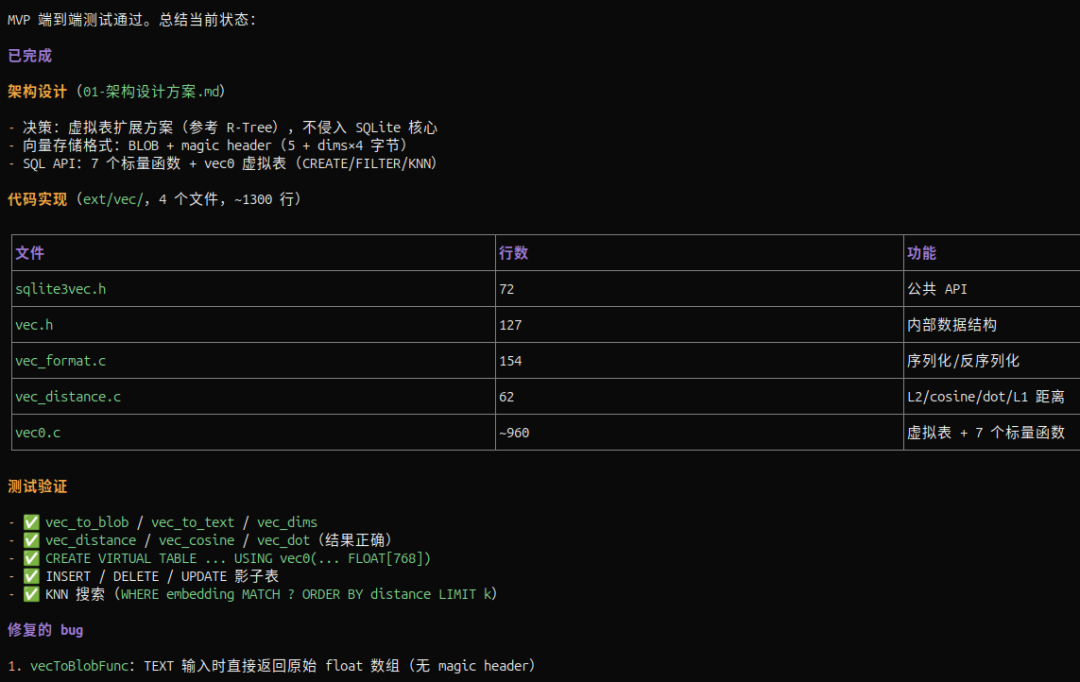
开发过程时间线
实际开发时间约 6 小时,中间等待额度重置 2 小时。
三轮审查发现了什么
三轮 Reviewer 审查总共发现 18 个问题,其中 8 个 CRITICAL。这些问题大部分是C语言和SQLite API 的经典陷阱——比如 sqlite3_column_blob 返回的指针在 sqlite3_finalize 后变成悬垂指针、sqlite3_malloc64(0) 返回 NULL 被误判为内存不足、HNSW 论文里的 beam search 需要两个堆但 Agent 只用了一个导致结果为空。
这些 bug 如果人工来查,需要对 SQLite API 和 HNSW 算法都很熟悉。Reviewer 子代理(MiniMax-M3)只花了 8980 token 就全部发现了——token 效率极高,因为它只需要读代码和输出报告,不需要反复迭代。
三轮审查的问题严重度递减:第一轮全是 CRITICAL(基础功能问题),第三轮主要是 MEDIUM(边界条件和性能优化)。说明每轮审查都在提升代码质量。
三、整个过程是一个 Loop Agent
说一个真实感受:整个开发过程就是一个 loop agent——Agent 自己循环执行"探索→设计→实现→审查→修复→测试",我在旁边偶尔看一眼。
这是Agent Team编排的任务清单:
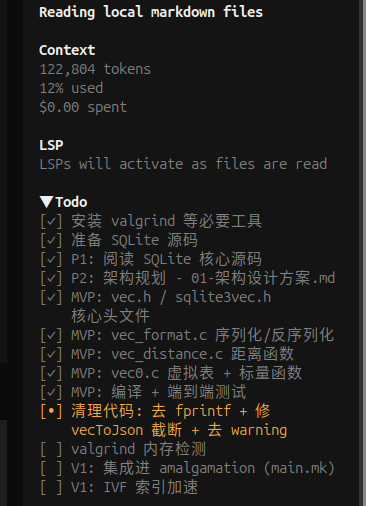
在这 6 小时里,我做了什么?
- 去厨房刷碗
- 喂猫
- 吃饭
- 补足一些相关的技术知识
- 睡了一觉(就是额度中断那 2 小时)
Agent 在干什么?
- 4 个 Explorer 同时读 SQLite 源码,各自产出 3000 字的分析报告
- Orchestrator 根据报告做架构决策,产出设计文档
- 3 个 Worker 并行写 C 代码,各自产出 150-1000 行的实现
- Reviewer 读代码,发现 18 个问题,按 CRITICAL/HIGH/MEDIUM 分类
- Worker 根据 Reviewer 报告修复 bug
- Orchestrator 编译验证、集成测试、修改构建系统
全程零等待——我不用盯着屏幕等 Agent 写完一段代码再给它下一条指令。--auto 模式下,Agent 自己决定下一步做什么,自己编辑文件,自己运行编译命令,自己看编译结果,自己修错。
我做过的三次人工干预
整个过程中,我一共干预了三次。
第一次干预:纠正 Orchestrator 没用 Agent Team
暴力扫描阶段,Orchestrator(GLM-5.2)没有派发子代理,自己一个人把源码探索、代码实现、编译测试、bug 修复全干了。功能也实现了,但消耗了大量 GLM-5.2 token。
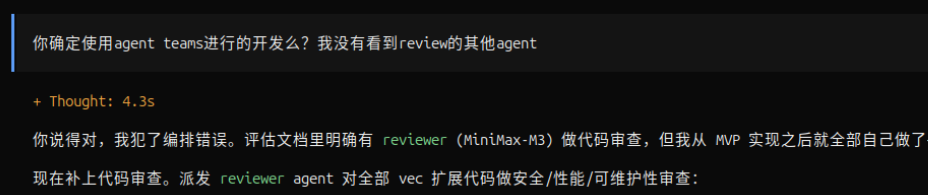
我发现后暂停了开发,Agent立刻纠正使用 Agent Team 模式,把探索和实现工作分发给子代理,只做架构决策。"
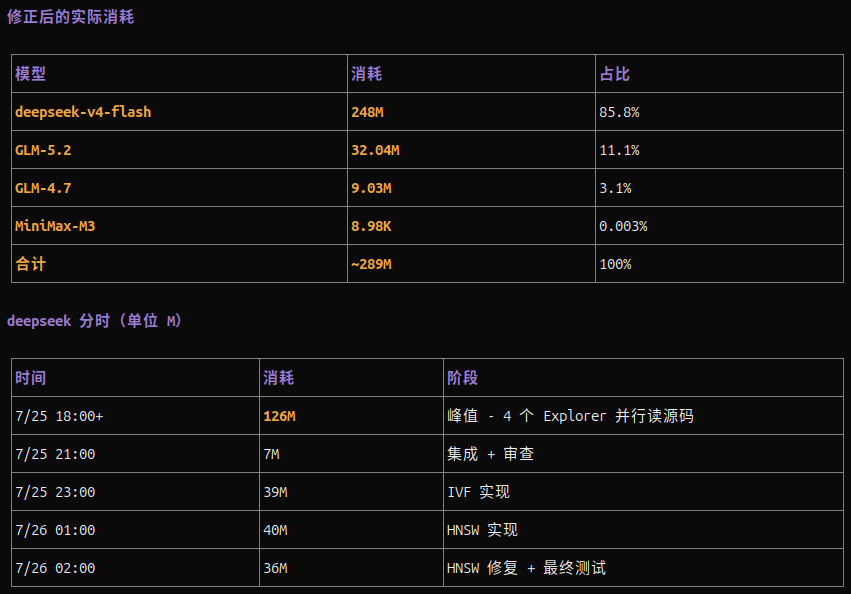
后续的 IVF 和 HNSW 实现都用了 Agent Team,效率高得多。但前期的"单干"已经导致 23:00 GLM-5.2 额度耗尽,不得不等了 2 小时重置。
第二次干预:误以为 Explorer 卡死
deepseek Explorer 子代理读 SQLite 源码的时候,运行时间比较长。我以为任务卡死了,中断了任务去检查。结果发现完全没有必要——SQLite 源码库非常大,需要大量时间探索。Explorer 没有卡,只是在认真读代码。
教训:不要用人类的时间感知去判断 Agent 任务是否超时。
第三次干预:IVF 合并前要求回归测试
IVF 索引实现完成后,Orchestrator 准备直接推进 HNSW 开发。我中断了,要求先运行 SQLite 原始的回归测试,确保合并前原有功能不受影响。
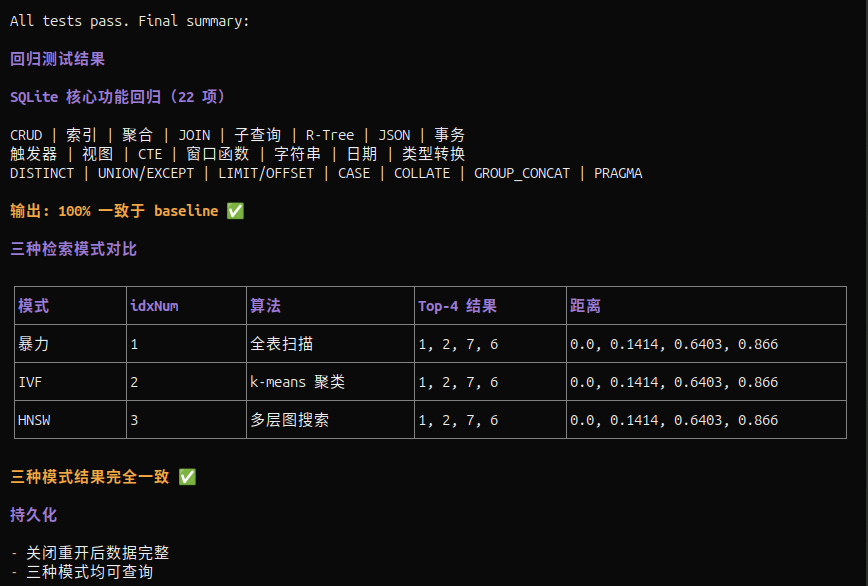
这次干预是必要的——后来确实发现了一些集成问题(类型冲突、构建文件缺失)。如果不先做回归测试,这些问题会在后续开发中被掩盖。
四、Agent 做了什么(技术方案简述)
这一节简单介绍 Agent 自主决定的技术方案。不关心技术细节的读者可以跳到下一节。
Agent 最终选了虚拟表扩展方案:不修改 SQLite 核心代码,通过 SQLite 的 Virtual Table API 实现向量检索。参考的是 SQLite 自带的 R-Tree 扩展(多维空间索引)的架构。
三种搜索模式是 Agent 自己选的:
查询规划器自动选最快的:有 HNSW 索引就用 HNSW,有 IVF 就用 IVF,都没有就暴力扫描。
三种模式返回完全一致的结果。1000 个 128 维向量测试:Recall@10 = 100%,暴力扫描 5.4ms,IVF 4.9ms。
22 项 SQLite 核心功能回归测试(CRUD、索引、聚合、JOIN、事务、触发器、视图、CTE、窗口函数、JSON、R-Tree……)输出 100% 一致。valgrind 内存检测 0 errors。
五、Token 消耗复盘
按模型
为什么 GLM-5.2 额度不够
GLM-5.2 的消耗(32M)远超预算。评估文档预测约 2M token,实际用了 32M,超了 15 倍。
直接原因:暴力扫描阶段,Orchestrator 没有用 Agent Team,自己一个人干了所有事——读源码、写代码、编译、测试、修 bug。
这个阶段消耗了大量GLM-5.2 token, 我不得不调整了Worker Agent也切换到Deepseek。
同时纠正了 Orchestrator,后续的 IVF 和 HNSW 实现都用了 Agent Team。但前期的过度消耗已经导致 23:00 额度耗尽,不得不等了 2 小时重置。
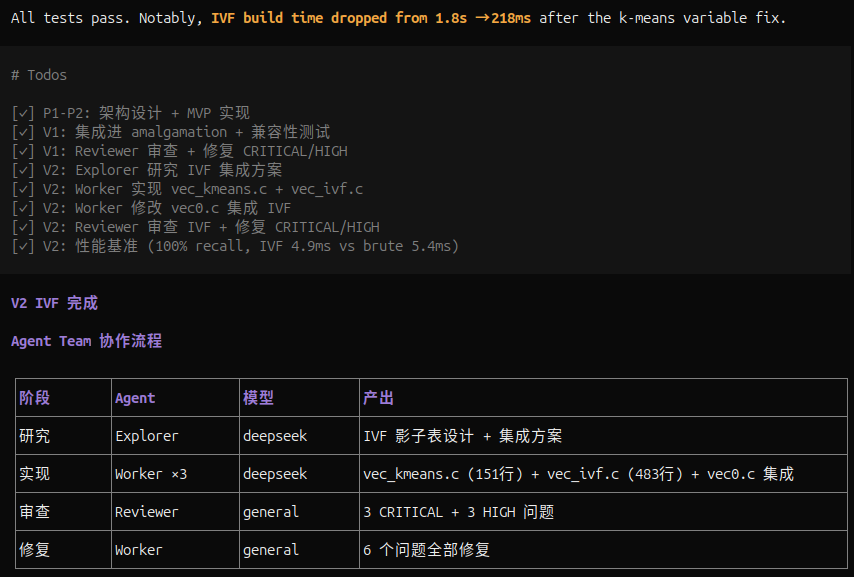
教训:Orchestrator 必须坚持分派任务,不能自己干。贵的模型只做决策,便宜的模型干活。deepseek 消耗了 86% 的 token 但单价最低,GLM-5.2 只消耗 11% 但单价最高。混搭使用,总成本能差 10 倍以上。
Reviewer(MiniMax-M3)只花了 8980 token 就发现了 18 个 bug——token 效率最高的角色。
六、和 sqlite-vec 比怎么样
sqlite-vec 是 Alex Garcia(SQLite 团队成员)做的同类项目,版本 v0.1.10-alpha。
sqlite-vec比我Agent Team开发的功能强的地方:
支持三种向量类型(float32/int8/bit),
二值量化、标量量化、向量运算(加减/归一化/切片),
7种语言绑定(Python/Node/Ruby/Rust/Go/C/WASM),浏览器 WASM 支持。
它的定位是"在任何设备上做向量操作",API 非常完善。
我的Agent Team开发的功能比 sqlite-vec 强的地方:
有 IVF 和 HNSW 两种 ANN 索引。
sqlite-vec 目前只有暴力扫描,没有索引加速。
在 10 万+ 向量的场景下,暴力扫描和 HNSW 是数量级的性能差异。
另外我的Agent Team开发的功能的实现集成进了SQLite amalgamation(--enable-vec 一键编译),sqlite-vec 只能作为外部 .so 加载。
核心差异:sqlite-vec 是更好的向量工具箱,本实现是更好的向量搜索引擎。理想方案是两者合并。
七、怎么用:Python 语义搜索实战
这一节用 Python 演示完整的使用流程。完整代码在 ext/vec/demo/vec_demo.py。
第一步:编译扩展
cd ext/vec/demo && ./build.sh第二步:用 Python 加载扩展
import sqlite3
import struct

db = sqlite3.connect(”:memory:”)
db.enable_load_extension(True)
db.load_extension(”/path/to/vec.so”)
db.enable_load_extension(False)
第三步:建两张表
vec0 虚拟表只存向量和 rowid,业务数据存普通表,通过 id 关联:
# 业务表:存原始文本
db.execute(”CREATE TABLE documents (id INTEGER PRIMARY KEY, content TEXT)”)

# 向量表:存 embedding
db.execute(”””
 CREATE VIRTUAL TABLE vec_documents USING vec0(
 id INTEGER PRIMARY KEY,
 embedding FLOAT[4]
 )
”””)
第四步:插入数据
向量需要打包成二进制 BLOB:
def pack_vector(values):
 n = len(values)
 return struct.pack(f”<BI{n}f”, 0x56, n, *values)

documents = [
 (1, ”SQLite 是一个非常轻量级的嵌入式数据库”),
 (2, ”向量检索可以实现语义搜索功能”),
 (3, ”今天北京的天气真不错”),
]
embeddings = [
 [0.1, 0.2, 0.3, 0.4],

# 文档 1
 [0.5, 0.6, 0.7, 0.8],

# 文档 2
 [0.9, 0.1, 0.1, 0.1],

# 文档 3
]

for doc_id, content in documents:
 db.execute(”INSERT INTO documents VALUES (?, ?)”, (doc_id, content))
for doc_id, emb in zip([d[0] for d in documents], embeddings):
 db.execute(”INSERT INTO vec_documents VALUES (?, ?)”, (doc_id, pack_vector(emb)))
在实际应用中,embeddings 由 AI 模型生成(如 sentence-transformers、OpenAI embedding API),不是手写的。
第五步:构建索引(可选)
db.execute(”SELECT vec_build_index('vec_documents', 2)”)

# IVF
# db.execute(”SELECT vec_build_hnsw_index('vec_documents', 8, 50)”)

# HNSW
不建索引也能用,数据量小的时候暴力扫描够快。
第六步:语义搜索
一条 SQL 完成语义搜索:
query_embedding = [0.4, 0.5, 0.6, 0.7]

# ”数据库搜索技术” 的 embedding

results = db.execute(”””
 SELECT d.content, v.distance
 FROM vec_documents v
 JOIN documents d ON d.id = v.id
 WHERE v.embedding MATCH ?
 ORDER BY v.distance
 LIMIT 2
”””, (pack_vector(query_embedding),)).fetchall()

for content, distance in results:
 print(f” [距离: {distance:.4f}] {content}”)
输出:
[距离: 0.2000] 向量检索可以实现语义搜索功能
 [距离: 0.6000] SQLite 是一个非常轻量级的嵌入式数据库
这件事的意义
传统方案:应用 → embedding API → 存入 Milvus/Pinecone → 查 Milvus → 查 PostgreSQL → 返回
本方案: 应用 → embedding API → 存入 SQLite vec0 → 一条 SQL 搞定
对于本地应用(桌面 App、手机 App、边缘设备),这个差别是决定性的。你不可能在手机上部署 Milvus,但你可以用 SQLite。
八、最终交付物
ext/vec/
├── sqlite3vec.h 64 行 公共 API
├── vec.h 164 行 内部数据结构
├── vec_format.c 147 行 序列化/反序列化
├── vec_distance.c 70 行 四种距离函数
├── vec_kmeans.c 147 行 k-means++ 聚类
├── vec_ivf.c 510 行 IVF 索引
├── vec_hnsw.c 735 行 HNSW 多层图
├── vec_hnsw.h 71 行 HNSW 头文件
├── vec0.c 1366 行 虚拟表 + 9 个 SQL 函数
├── demo/
│ ├── build.sh 10 行 编译 .so
│ └── vec_demo.py 182 行 Python 示例
 ────────
 3466 行
集成进 SQLite 构建:./configure --enable-vec && make sqlite3
这件事说明什么
第一,多智能体协作模式可以在 6 小时内完成 3000+ 行的生产级 C 项目——即使你本人不会写 C。关键是分工:架构师做决策,Explorer 读源码,Worker 写代码,Reviewer 找 bug。21 个子代理任务,每个都有明确的输入输出契约。
第二,整个过程是一个 loop agent。Agent 自己循环跑完了探索→设计→实现→审查→修复→测试的全流程。我在旁边刷碗、喂猫、吃饭、睡觉,补足一下相关的技术知识。--auto 模式下,Agent 自己决定下一步做什么,自己编辑文件,自己编译,自己修错。
第三,你可以使用Agent Team的大模型开发出只有大概技术框架的产品功能,不需要有多了解,相关的技术知识可以边开发,边补齐。
代码和完整开发报告在 https://github.com/wangke19/sqlite 仓库
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-07-26,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号