不止 CPO:拆解NVIDIA Vera Rubin全栈互联,五大网络域构建智能体 AI 算力底座

不止 CPO:拆解NVIDIA Vera Rubin全栈互联,五大网络域构建智能体 AI 算力底座
光芯
发布于 2026-09-16 20:45:50
发布于 2026-09-16 20:45:50
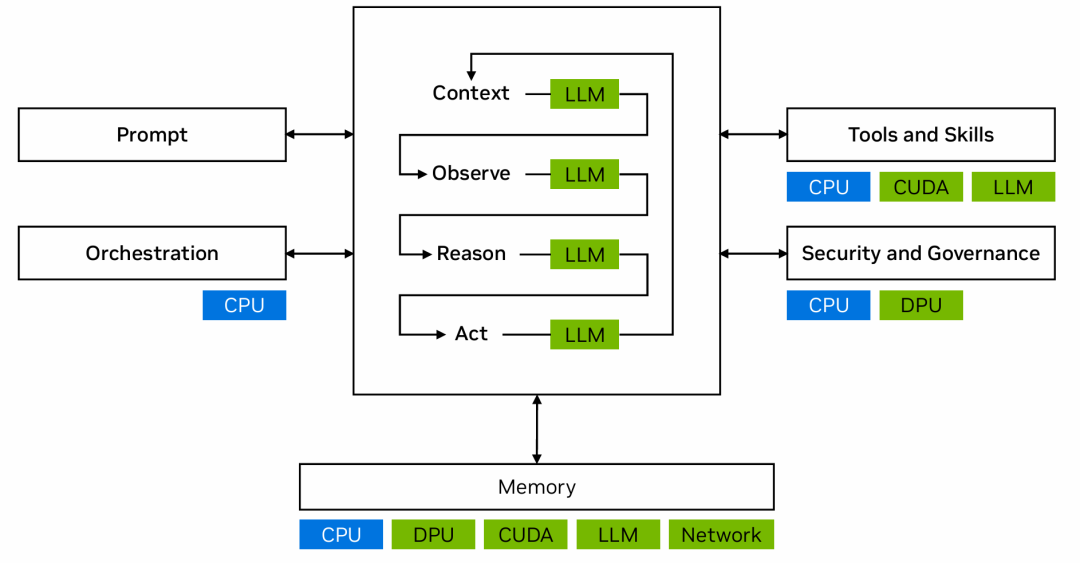
Agent AI已经成为历史上复杂度最高的计算负载,工作流由Prompt输入、上下文维护、环境观测、逻辑推理、工具调用执行构成闭环,单次智能体任务往往会生成数十万token上下文,注意力计算复杂度随上下文长度呈二次增长。真实业务统计显示,Agentic工作负载消耗token数量可达普通对话请求的15倍,对集群网络同时提出高吞吐、低确定性抖动、毫秒级故障自愈、多租户强隔离、异构算力互通、海量KV缓存存储加速的多重硬性约束。传统通用以太网无法兼顾全部指标,AI工厂不能简单堆叠服务器,必须做芯片‑机柜‑网络‑软件深度协同设计。
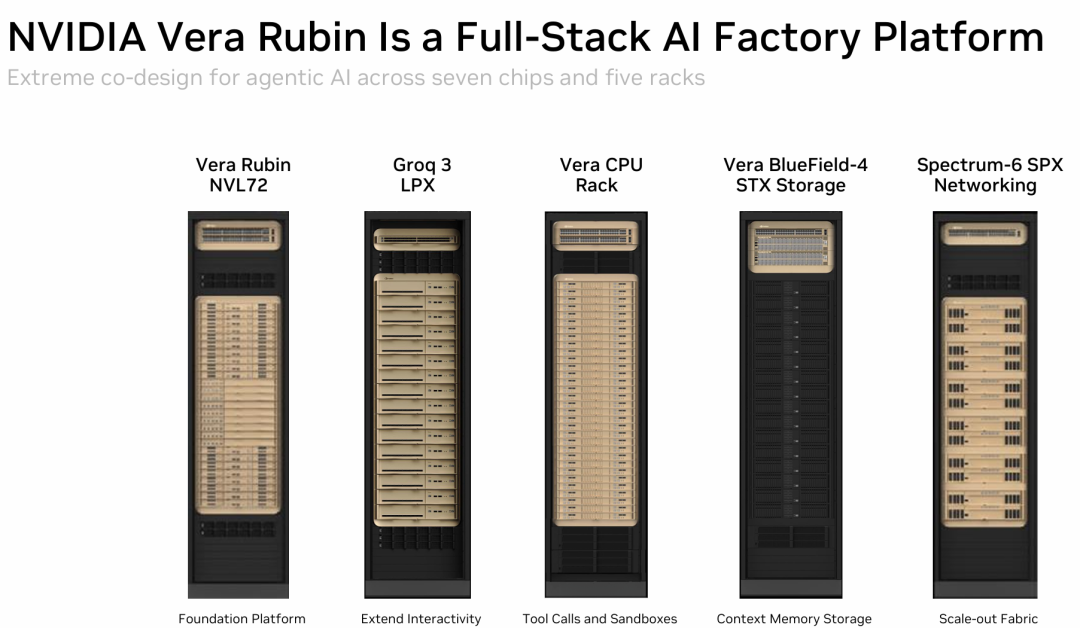
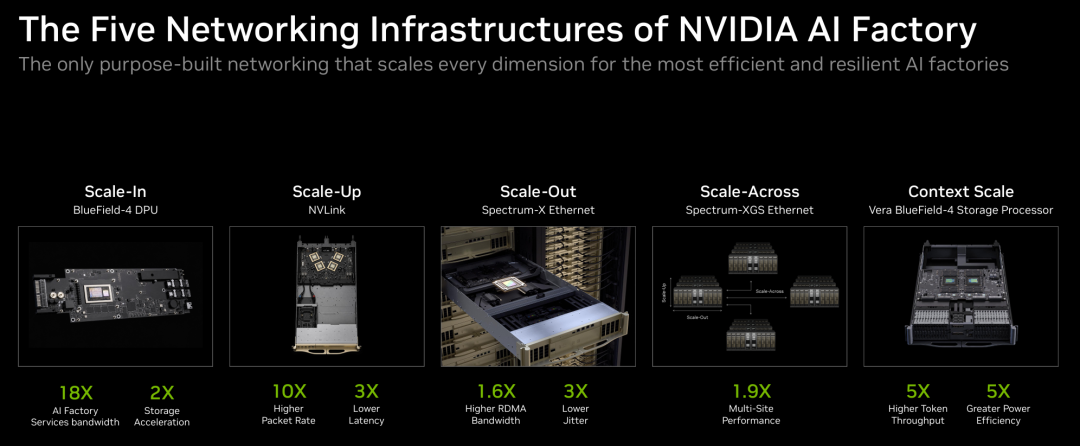
Hot Chips2026上NVIDIA完整披露Vera Rubin全栈AI工厂平台,整套平台由7类芯片、5类机柜组成:NVL72 GPU机柜、Groq3 LPX推理机柜、Vera CPU机柜、Vera BlueField‑4 STX存储机柜、Spectrum‑6 SPX网络机柜,定义出Scale‑Up、Scale‑Out、Scale‑In、Storage‑Scale (Context‑Scale)、Scale‑Across五大专用网络域,同时实现GPU‑LPU异构算力跨域协同;Spectrum‑X配套已经量产的CPO共封装光学系统,解决万卡至512k GPU规模下横向扩展的光互联功耗与可靠性瓶颈。
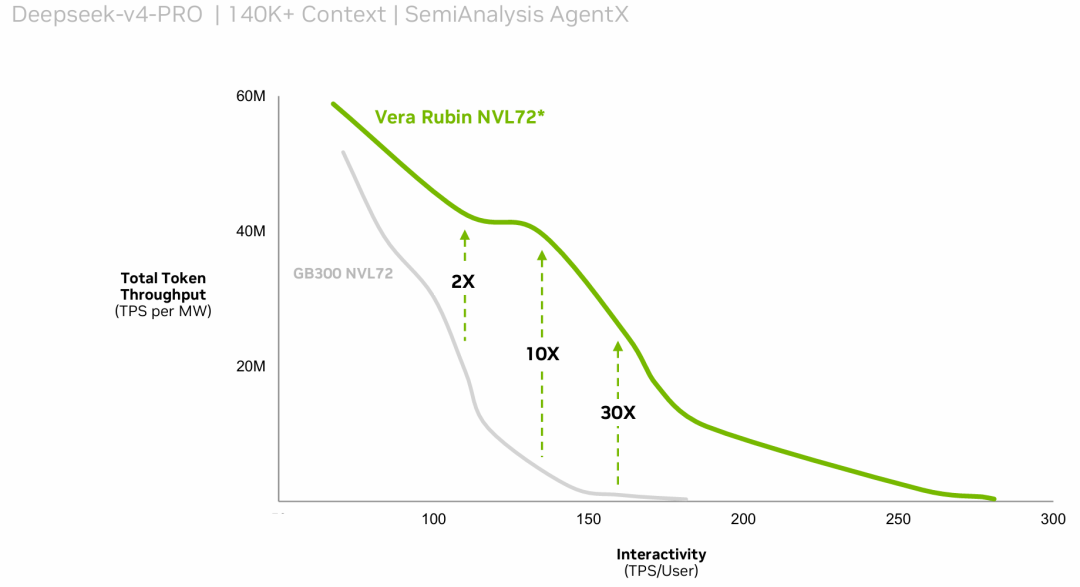
在DeepSeek‑v4‑PRO + SemiAnalysis AgentX智能体基准测试(140K+上下文)下,整套全栈协同的NVL72系统对比上一代GB300 NVL72,在高交互智能体场景实现最高30倍每兆瓦token吞吐提升,中等交互区间分别实现10倍、2倍能效跃升,直观证明网络‑芯片‑存储协同对Agentic负载的决定性价值(该结果为非官方实测,待SemiAnalysis最终复核)。
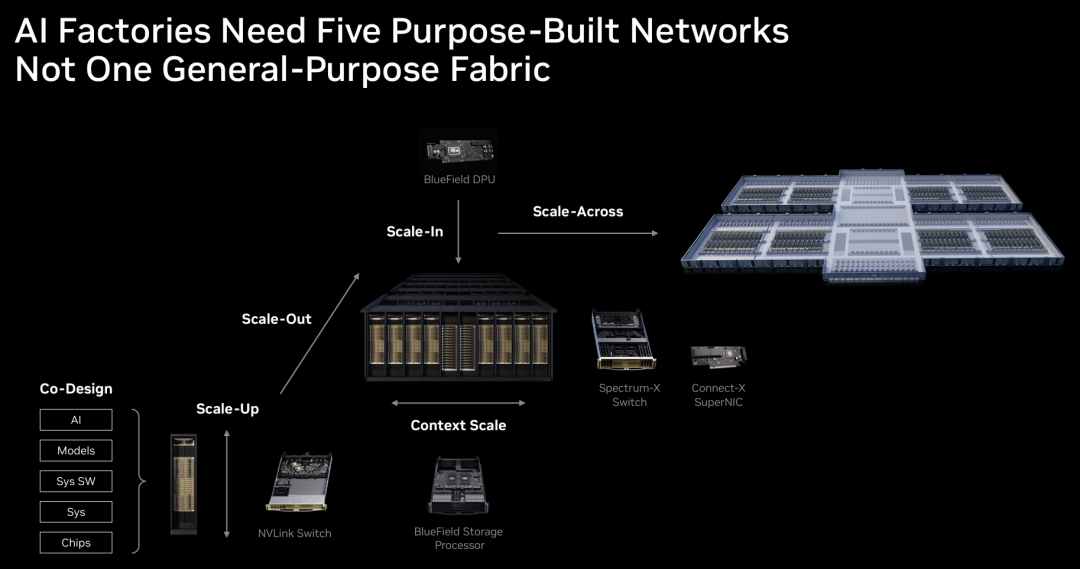
一、五大专用网络:分域构建AI工厂完整互联栈
1. Scale‑Up:NVLink‑6全铜机柜互联,机柜内72GPU紧耦合域
Scale‑Up负责机柜内部GPU纵向高速全互联,硬件载体为NVL72机柜、NVLink6交换托盘,单域最大72块Rubin GPU,单GPU提供3.6TB/s全对全带宽。
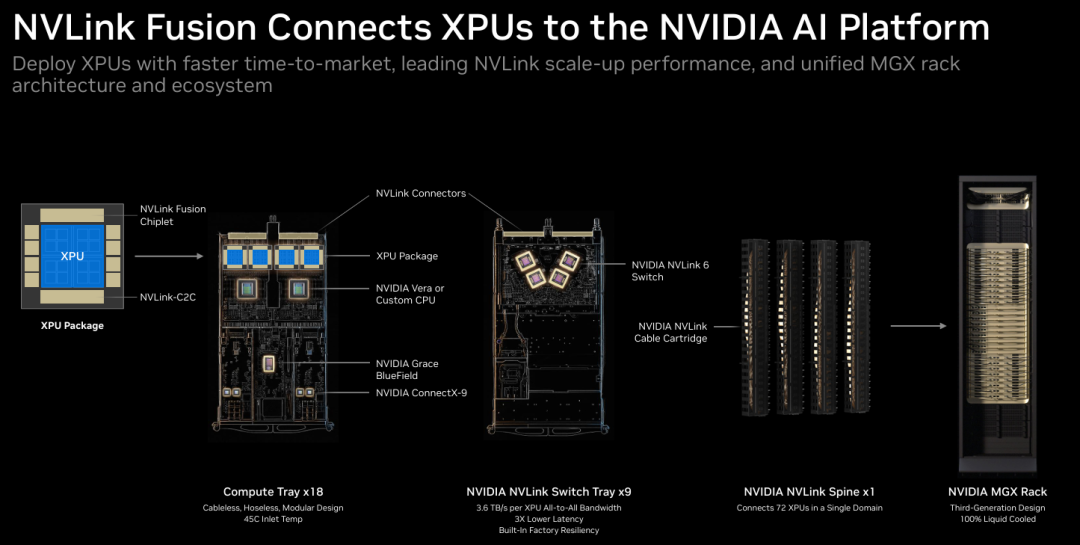
Rubin GPU引入Counted Write计数写入同步机制,淘汰Blackwell世代依赖的MEMBAR内存屏障同步流程;发送端写完数据直接更新硬件计数器,接收端轮询计数器完成同步,消除全局屏障带来的额外延迟,显著改善分布式智能体推理的交互吞吐。
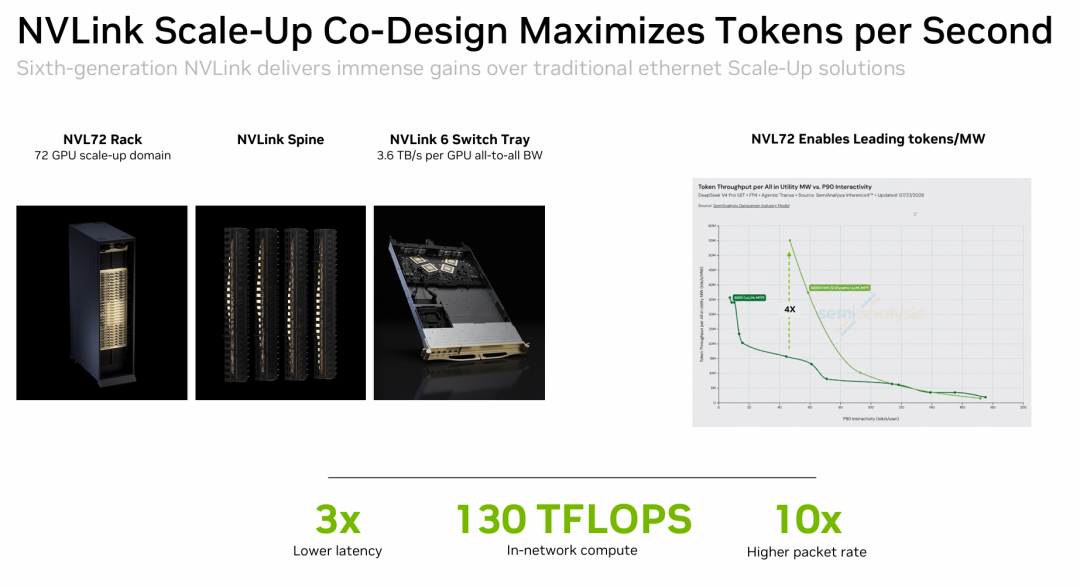
相对传统以太网纵向扩展方案,NVLink‑6获得多重增益:4倍token吞吐、3倍通信延迟降低、内置130TFLOPS网内计算、数据包处理速率提升10倍。
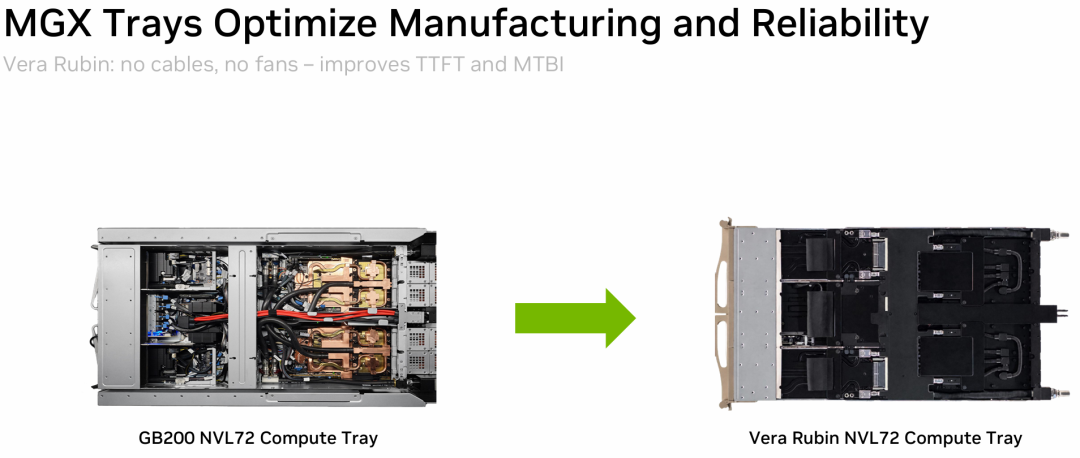
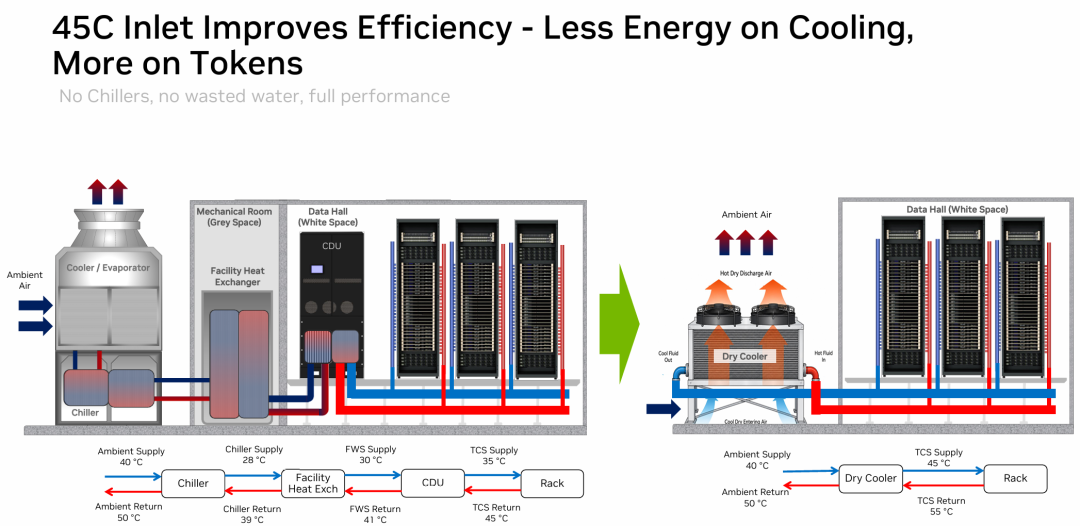
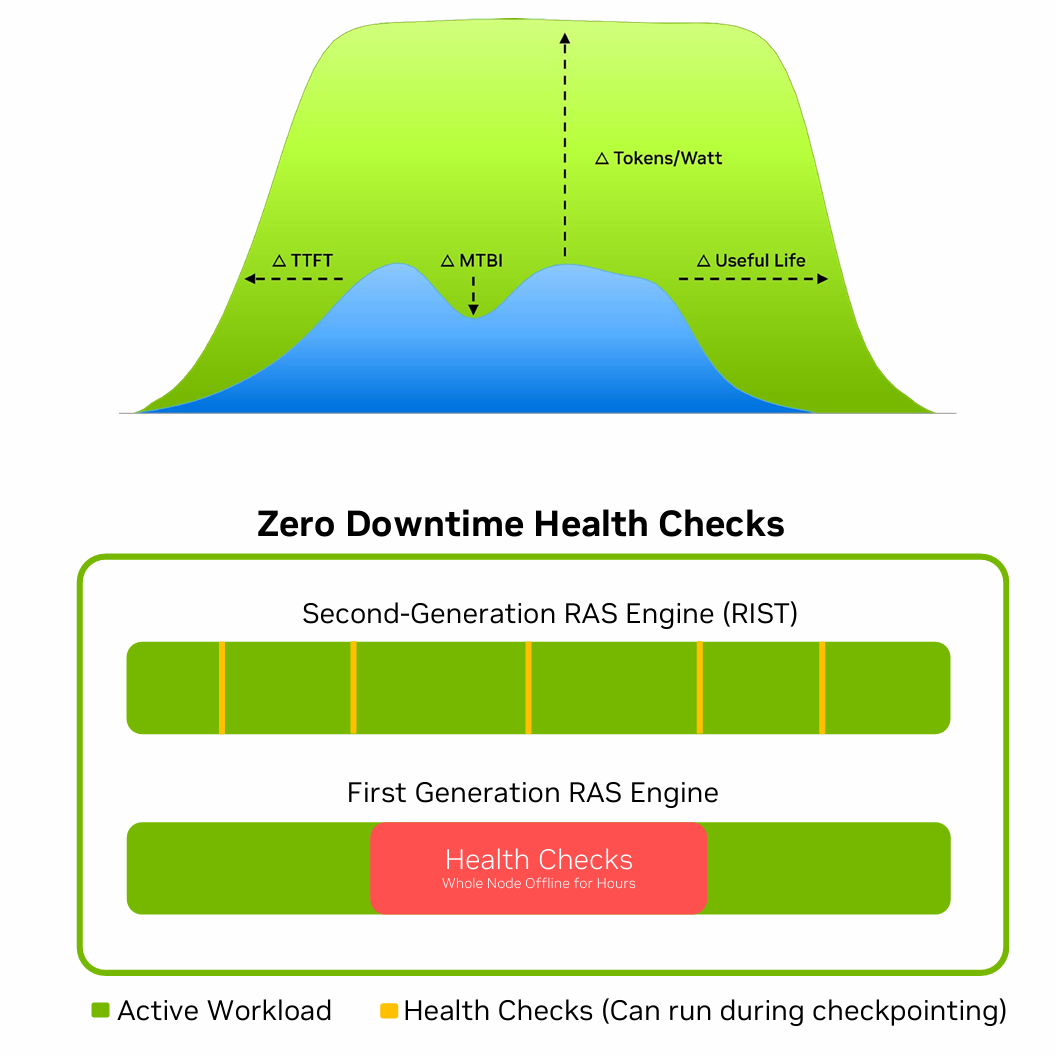
整机基于第三代MGX开放机柜,全铜无缆托盘、无重定时器、支持热插拔,支持45℃进液液冷,无需冷水机组即可满性能运行。第二代RAS(RIST)可靠性引擎实现零停机GPU健康巡检,巡检秒级完成,不再需要将整节点下线数小时;同时支持NVLink链路热插拔、SRAM/DRAM现场维护,提升集群有效吞吐量Goodput。
性能佐证:DeepSeek‑v4‑PRO AgentX负载下,NVL72机柜相比前代GB300 NVL72,在同等功耗下实现最高4倍token吞吐提升,这一成果建立在NVLink‑6低延迟全互联的基础之上。
2. Scale‑Out:Spectrum‑X多平面以太网,512k GPU横向扩展骨干
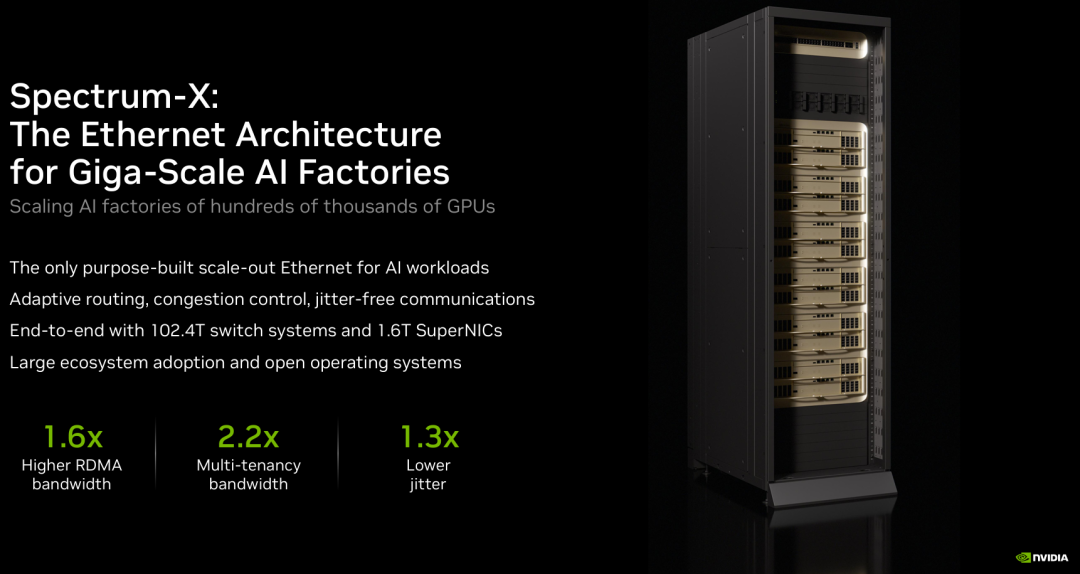
Spectrum‑X是专为AI负载原生设计的横向扩展以太网,硬件包含102.4Tb/s Spectrum‑X交换机、1.6Tbps Connect‑X SuperNIC,硬件内置自适应路由与拥塞控制,面向大模型训练、分布式Agent推理做端到端优化。
与商用OTS普通以太网的实测对比:
- RDMA带宽提升1.6倍,多租户带宽提升2.2倍,网络抖动降低1.3倍;
- DeepSeek‑V3多租户混跑训练:Step耗时最高1.9倍性能提升,隔离租户之间噪声干扰,输出可复现训练结果;
- Nemotron‑Ultra预训练NCCL集合通信:梯度全归约2X、token分发2X、梯度归约散射3.5X、并行矩阵乘法最高14X。
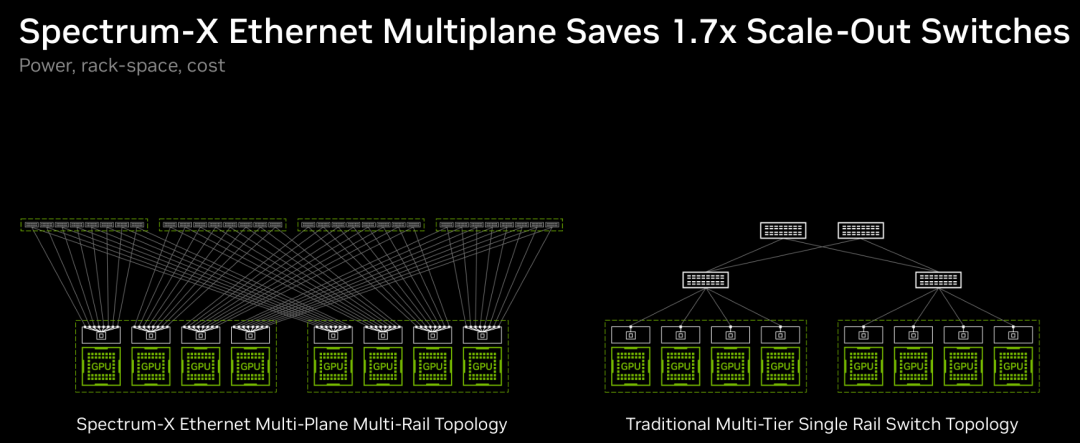
传统叶脊单轨拓扑一旦链路故障直接带宽清零,故障检测耗时1080ms。
- Multi‑Rail多轨:单GPU输出1.6Tbps,4轨架构支撑8k Rubin GPU;
- Multi‑Plane多平面:8平面4轨硬件架构,集群规模再扩展64倍,最大512k Rubin GPU。
工程收益:
- 横向交换机硬件数量节省1.7倍,降低机柜、功耗、采购成本;
- 链路故障仅发生带宽衰减,保留90% RDMA带宽;故障检测2.68ms,故障恢复仅100ms;
- 集群整体有效吞吐量Goodput提升1.6倍。
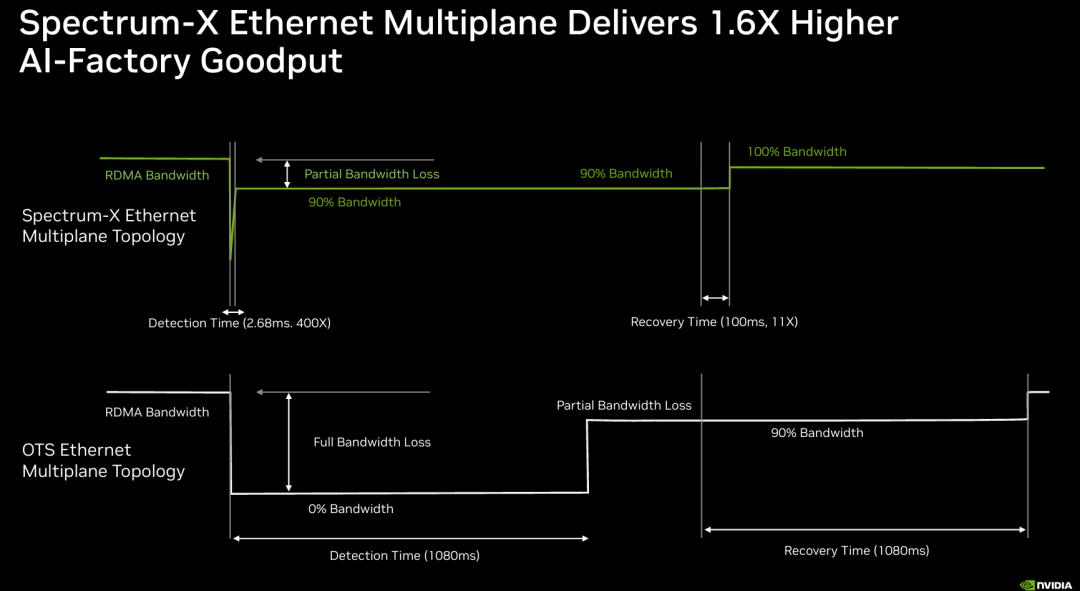
底层光物理层:Spectrum‑X交换机搭载已经量产的Spectrum‑X Photonics CPO共封装光学引擎,是整套超大规模横向扩展网络的物理底座。
3. Scale‑In:BlueField‑4 Astra AI‑Native DPU服务器内部域网络
BlueField‑4是面向AI工厂原生设计的新一代DPU,区别于传统通用云DPU,专门适配Agentic AI多租户、高小包速率、强零信任安全的诉求。通过Astra聚合架构,在一个DPU上完成多块ConnectX‑9 800G网卡的流量汇聚,单计算托盘实现7Tb/s聚合Scale‑In带宽,不需要为每一张网卡都配套完整CPU子系统,相比传统部署方案功耗降低4倍。
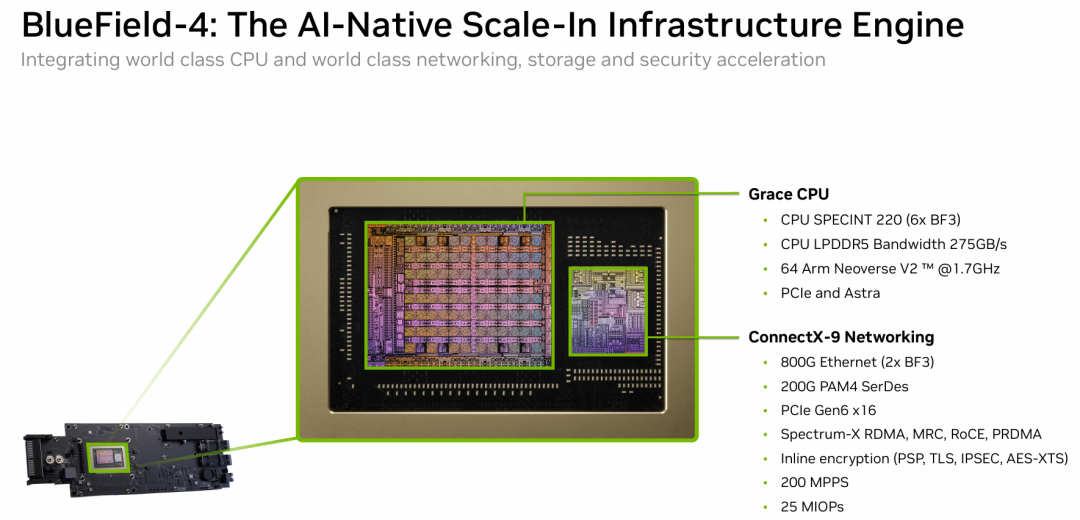
Scale‑In网络承担:主机侧卸载、租户域与数据中心域强隔离、零信任安全、防火墙、遥测监控、存储IO卸载。实测小包场景下可以维持700+Mpps消息处理速率,完美匹配Agentic AI大量细碎控制信令、工具调用小包流量;Spectrum‑X以太网加持下,5GB/10GB/50GB存储文件访问速度分别达到普通以太网的1.3倍、1.4倍、1.5倍。所有租户业务流量全部经过DPU数据通路,安全策略、加密、遥测在7Tb/s线速下完成,不占用主机CPU与GPU资源。
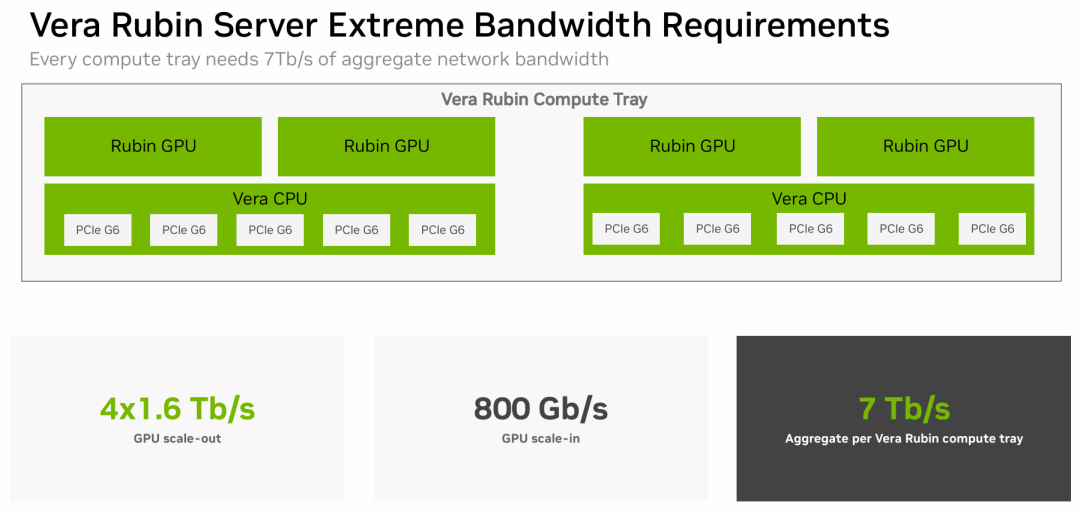
4. Storage‑Scale (Context‑Scale):BlueField‑4 STX存储专用网络
Agentic AI多轮交互带来持续膨胀的KV Cache、海量上下文,传统存储网络成为推理瓶颈。Vera Rubin划分四层KV缓存层级(GPU HBM高速KV、本地内存中转KV、热复用KV、冷/共享大上下文KV),全部由BlueField‑4存储处理器+DOCA MEMOS软件栈管理。
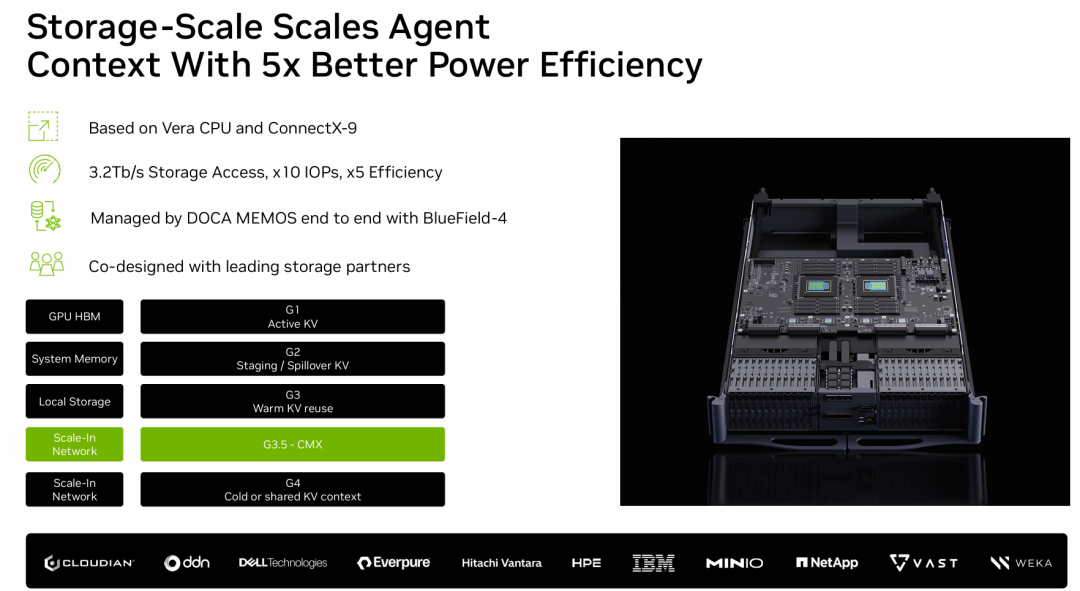
该存储专用网络实现5倍功耗效率提升,3.2Tb/s存储访问带宽,IOPS提升10倍,并且和DDN、WEKA、NetApp等主流存储厂商完成协同适配,专门承接超长上下文Agent任务的冷KV缓存卸载,释放GPU宝贵HBM带宽用于计算。
5. Scale‑Across:Spectrum‑XGS跨站点广域互联网络
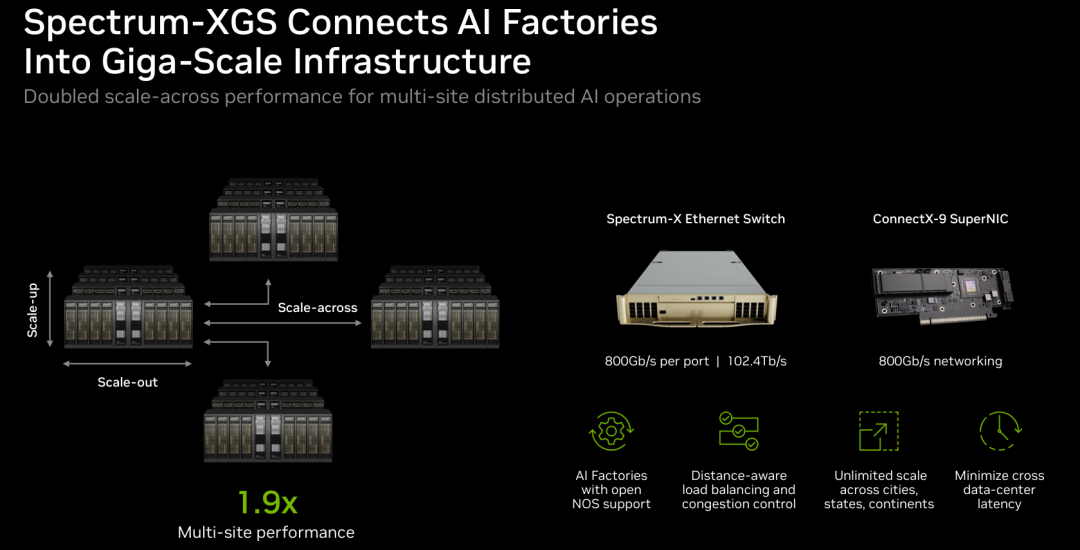
面向多AI工厂跨城、跨大洲分布式协同训练与分布式Agent推理;硬件为ConnectX‑9 SuperNIC,单端口800Gb/s,交换机整机带宽102.4Tb/s,搭载距离感知网络操作系统,优化长距离链路拥塞控制;实现多站点整体性能提升1.9倍,把地理分散的多座AI工厂编织成统一算力池。
二、Spectrum‑X Photonics量产CPO深度解析:解决AI工厂横向扩展光互联瓶颈
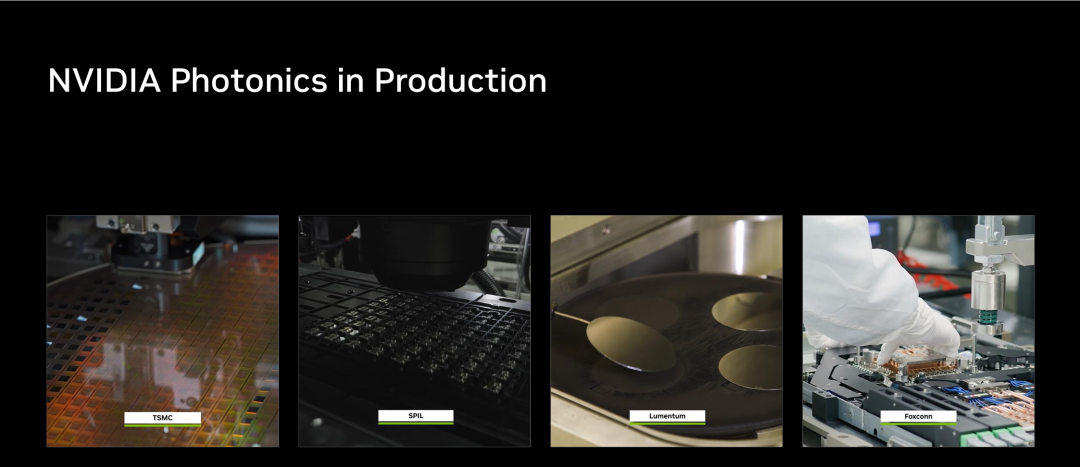
在数十万GPU规模AI工厂中,光模块功耗占集群总功耗约10%;传统可插拔光模块方案存在电信号走线长、DSP功耗高、分立激光器数量庞大、故障点多等痛点,已经成为进一步扩规模的硬约束。NVIDIA Spectrum‑X Photonics CPO共封装光学已经实现量产,不再只是路线图技术。
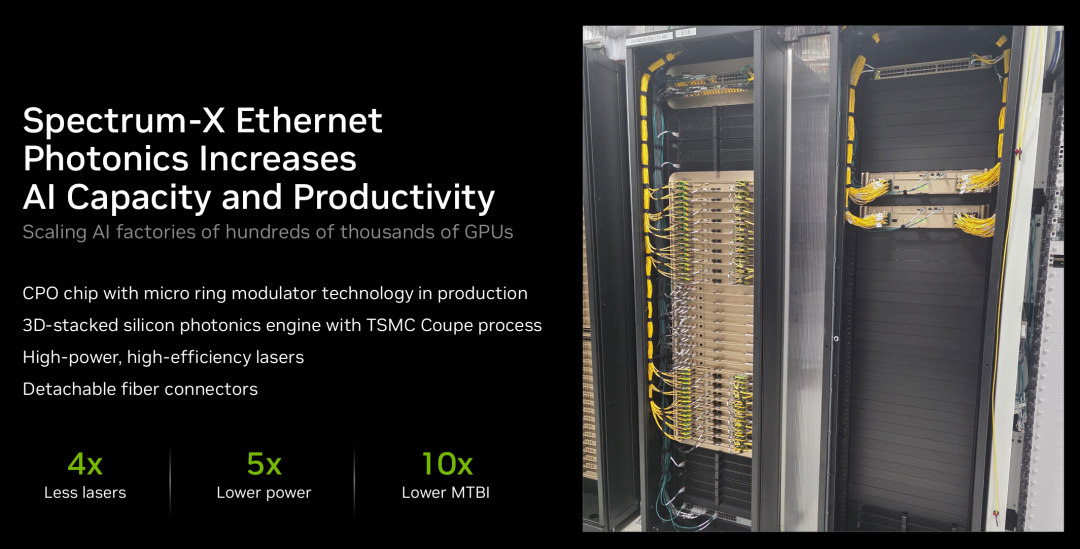
- 封装工艺:采用台积电COUPE 3D堆叠多芯片共封装架构,交换ASIC与硅光引擎MCM共封装;光引擎内部集成微环调制器,将电‑光转换环节紧贴交换芯片,极大缩短电信号传输路径,消除传统可插拔光模块的长PCB走线、重定时器与DSP开销。
- 外置激光源ELS架构:激光器从各个独立收发器剥离,采用集中外置激光源统一向多颗硅光引擎供光;相比传统方案激光器数量减少75%(5倍减少),大幅降低器件数量、功耗与故障源;光引擎还预留冗余备份单元,应对CPO器件焊接后难以现场更换的可靠性挑战。
- 整机硬件规格:SN6810交换机102.4Tb/s(128×800G);更大规格SN6800整机409.6Tb/s(512×800G),单通道200G;配备可拆卸式光纤连接器,适配大规模自动化装配与液冷整机环境。
- 量化工程收益(对比传统可插拔光模块) - 单1.6T端口光互联功耗降低5倍; - MTBI(平均无故障运行间隔)提升10倍; - 链路无抖动稳定运行时长提升5倍;
- 边界取舍:NVIDIA仍然坚持短距离Scale‑Up机柜内部优先使用全铜NVLink,铜互联在极短距离下功耗、成本、可靠性优于光;CPO光互联主要用于Scale‑Out、Scale‑Across跨机柜、跨机架的中长距离流量,铜与光各司其职,形成完整组合方案。
重要逻辑:CPO本身不是独立“黑科技”,必须和Spectrum‑X交换机ASIC、SuperNIC、多平面拓扑、SHARP网内聚合协议做端到端协同,才能释放全部收益,单独更换光器件无法获得对应AI负载性能增益。
三、异构推理互联:Rubin GPU + Groq3 LPX 跨域网络协同
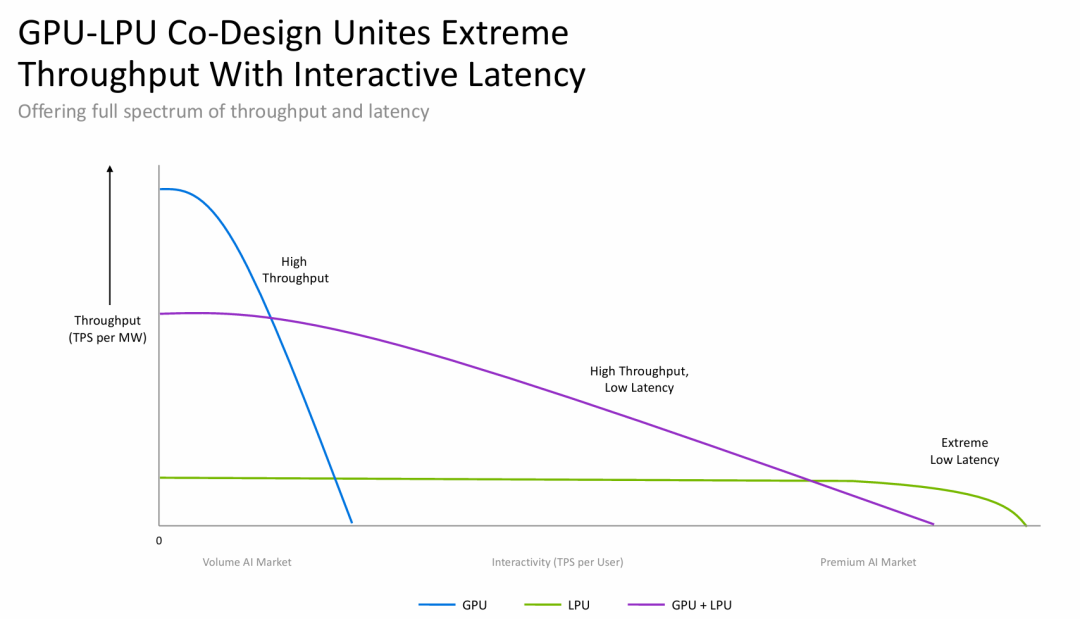
Agentic负载同时需要大算力吞吐与极致解码延迟,Vera Rubin平台引入Groq3 LPX低延迟推理加速器,依靠两套完全不同特性的网络,实现异构算力混合调度。
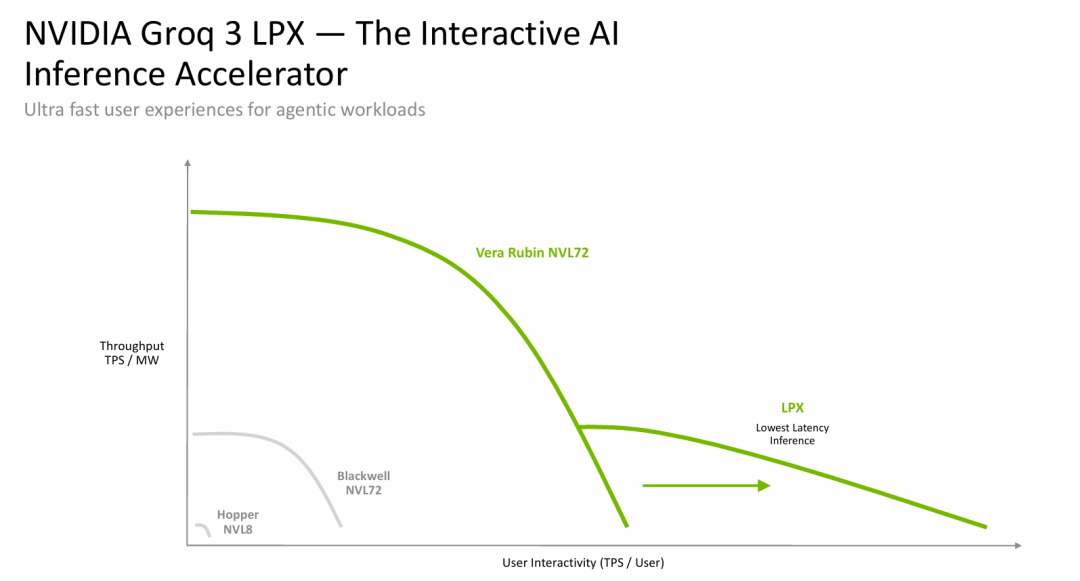
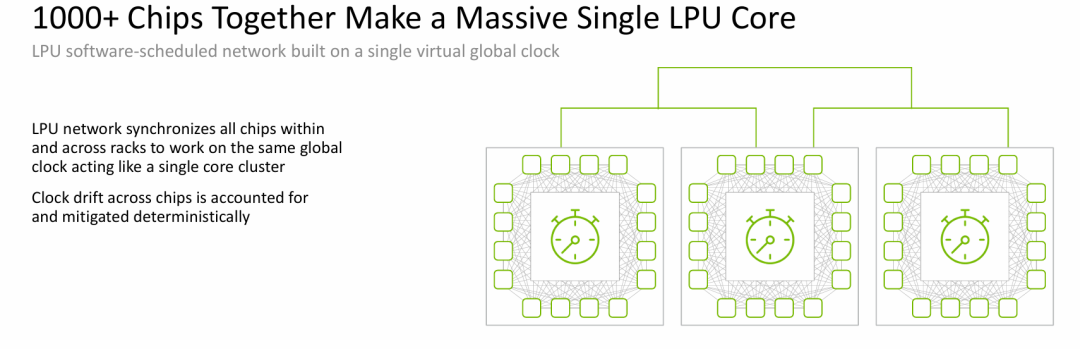
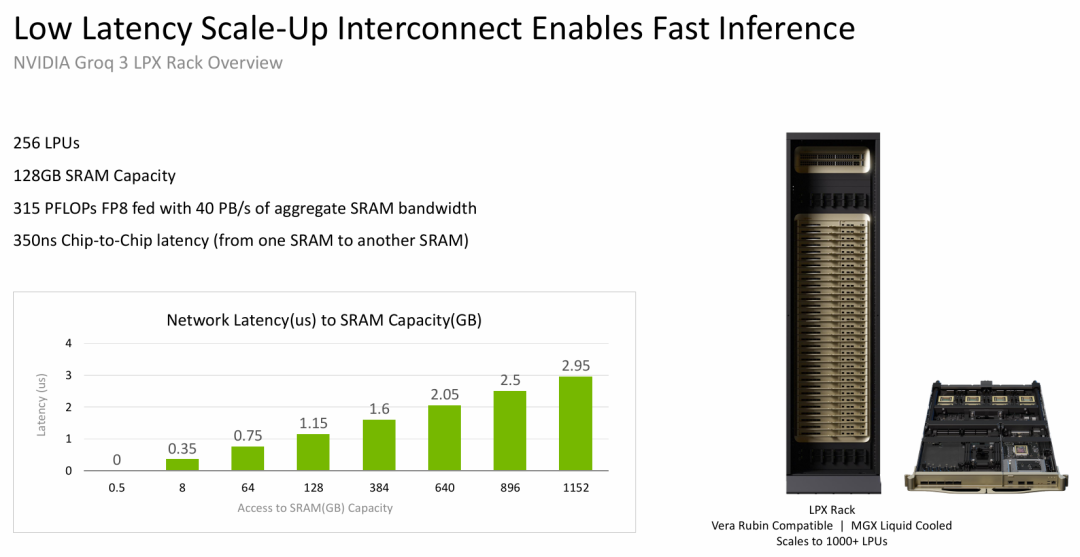
- LPX机柜内部确定性片间互联网络 Groq3 LPX是全SRAM、VLIW软件调度架构;机柜内256颗LPU依靠全局虚拟时钟做芯片同步,千颗芯片协同如同单一大核;芯片同时承担计算单元+路由器角色,编译期就调度好全部消息路由,运行时无自适应路由、无拥塞探测;以张量作为传输单元,报文极简,去掉以太网虚拟通道、硬件流控等开销,小消息推理报文效率极高;芯片‑芯片SRAM到SRAM延迟低至350ns;机柜同样采用无缆全铜MGX液冷设计。
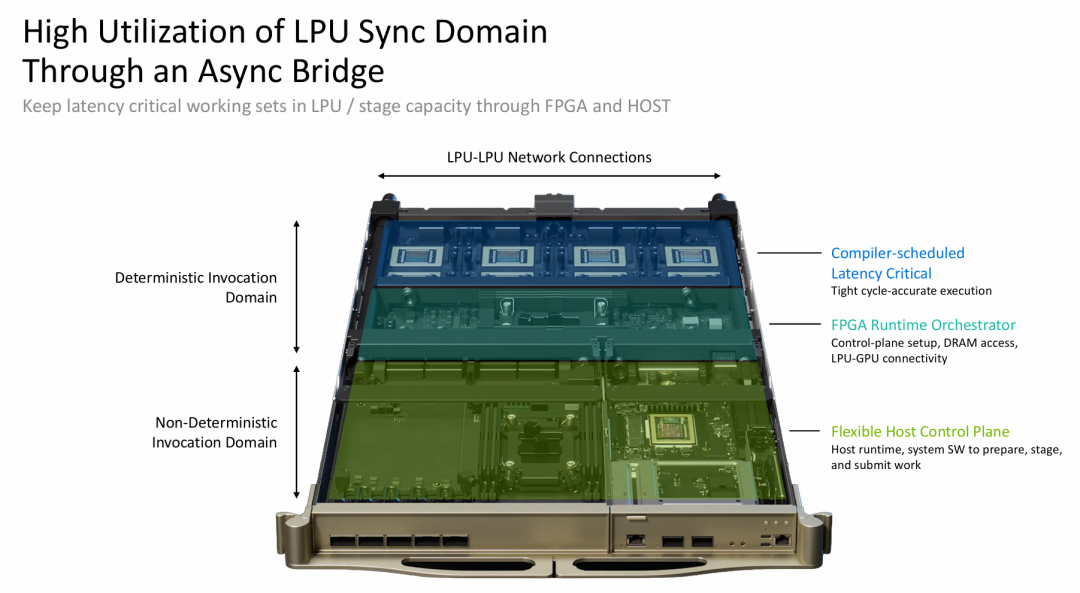
- GPU‑LPU跨算力异步桥接网络 GPU属于非确定性域、LPU属于强确定性域,依靠FPGA异步桥接做域间解耦,设计三种主流协同模式,只传输必要中间张量,尽量减少跨网流量:
- External‑Drafter外部推测解码:LPU运行草稿小模型生成draft token,传给Rubin GPU做大模型校验提交;KV Cache分别保存在各自域内,只有草稿token跨链路传输;在GPT‑OSS‑2T 400K上下文Agent负载下,交互吞吐获得3倍提升。
- ATTN‑FFN分层拆分:Rubin GPU负责长上下文注意力计算、维护巨大KV Cache;LPU承担FFN层高速计算;每完成一次完整注意力层才交互一次中间张量,实现解码吞吐再提升3倍。
- Prefill‑Decode分离卸载:Rubin GPU执行Prefill阶段生成KV Cache,通过桥接网络交给LPX完成高速Decode生成;该模式下交互能力实现5倍提升。
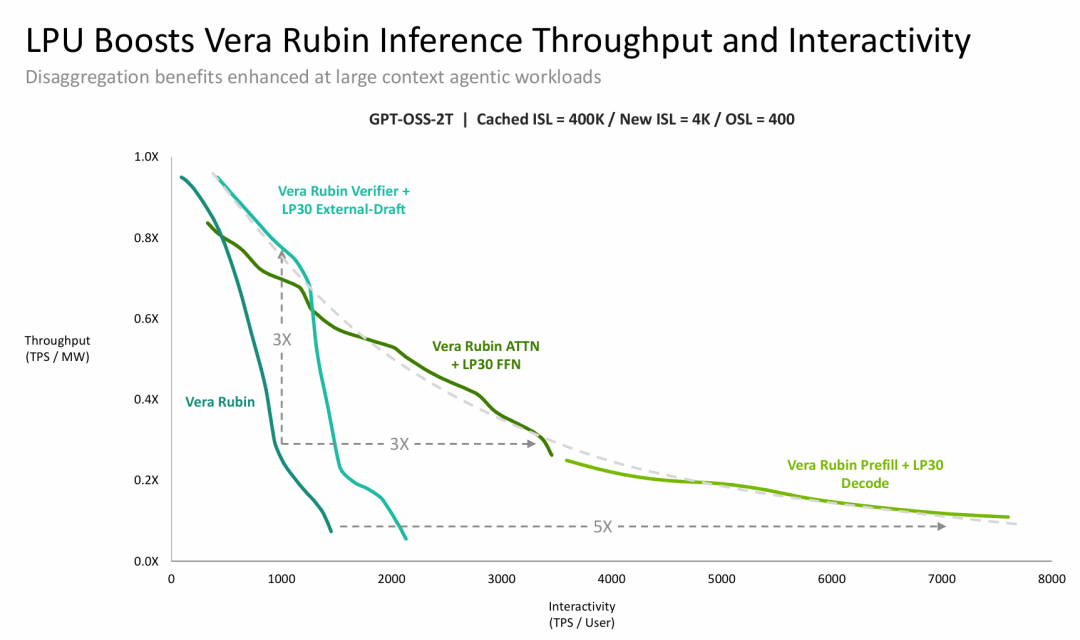
GPU‑LPU混合组网,补齐了单一GPU在超高交互Agent推理场景的延迟短板,整套异构能力建立在Scale‑In高速DPU桥接网络之上。
四、DSX全栈软件体系:网络从仿真、验证到上线的完整生命周期
硬件网络能力需要配套完整软件释放价值,DSX AI Factory平台覆盖仿真、能效、调度、部署全链条:
- DSX OS、功耗优化组件、基础设施库;DSX‑Sim仿真引擎,可数字孪生数十万GPU集群网络行为,上线前提前定位拥塞、拓扑、故障场景;
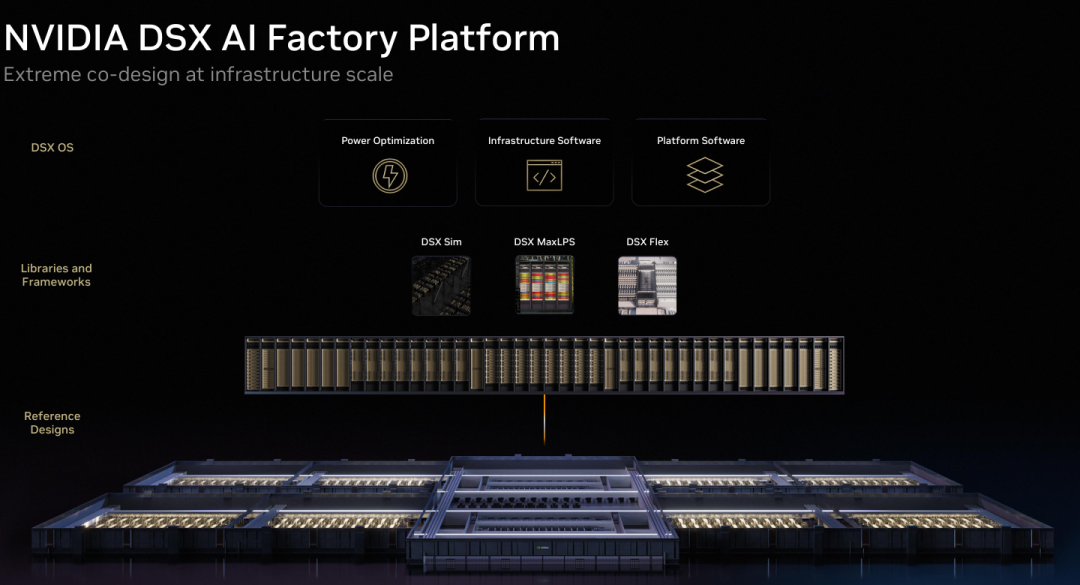
- DSX MaxLPS负责整机功耗管理,包含智能功率平滑IPS技术:GPU机柜峰值功耗降低13%,配合电网平滑技术,同等供电配额下最多可以多部署40%GPU,改善大规模AI工厂电网适配;
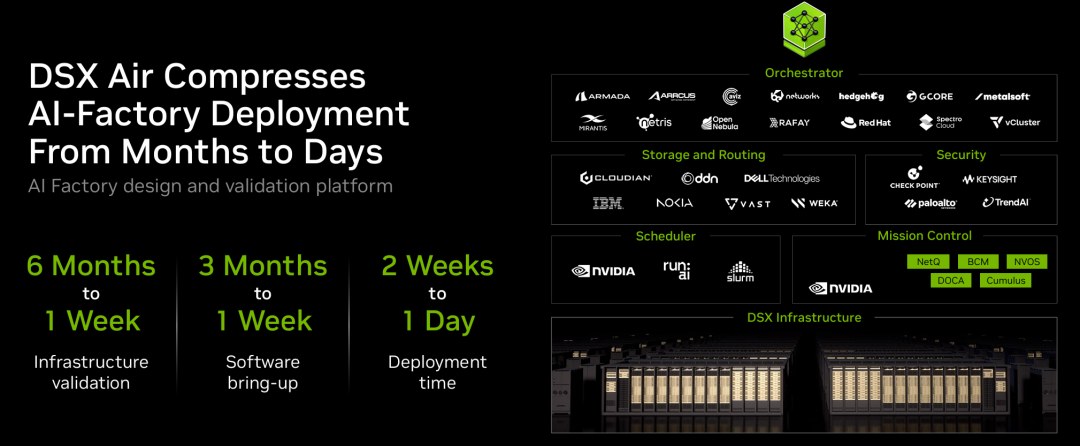
- DSX‑Air部署工具联合生态伙伴,将传统AI工厂部署周期由6个月压缩至数天:基础设施验证1天,软件bring‑up 1周,整体设计验证1‑2周;生态包含NVOS、Cumulus、DOCA、各类编排器、存储、安全组件。
五、整体综合收益汇总(五大网络+CPO+DPU+异构协同对比传统通用数据中心网络)
- 业务总带宽提升18倍;存储访问加速最高5倍;数据包处理速率提升5倍;
- RDMA带宽提升1.6‑3倍;网络抖动降低3倍;端到端延迟下降5倍;
- 跨多站点分布式AI工厂性能提升1.9倍;
- 在DeepSeek‑v4‑PRO AgentX智能体推理场景,整套Vera Rubin NVL72全栈系统,相对上一代GB300 NVL72实现最高30倍每兆瓦token吞吐增益,直观体现“网络‑芯片‑存储‑软件全栈协同”对于Agentic AI的核心价值。
结语
Agentic AI时代,AI工厂网络已经不再是附属配套,而是定义集群上限的核心底座。NVIDIA在Hot Chips2026给出的整套解决方案,核心思路是摒弃“一张通用网包打全部场景”,将AI工厂流量拆分为五大网络域:机柜内NVLink全铜紧耦合、Spectrum‑X多平面以太网做横向扩展、BlueField‑4 DPU承担服务器内部卸载与安全、Storage‑Scale网络专门处理海量KV上下文、Spectrum‑XGS面向跨站点分布式算力;再叠加已经量产的CPO共封装光学解决大规模光互联功耗可靠性痛点;并且通过网络桥接实现GPU‑LPU异构推理算力协同,配合DSX完整软件栈完成从仿真到交付。
万卡向数十万卡AI工厂演进的时代,专用网络域划分、光电协同、DPU深度卸载、异构算力互联、软硬件联合协同,是下一代AI基础设施明确的技术方向。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-08-26,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号