Hot Chips 2026|谷歌第八代TPU(附完整报告)

Hot Chips 2026|谷歌第八代TPU(附完整报告)
光芯
发布于 2026-09-16 20:57:13
发布于 2026-09-16 20:57:13
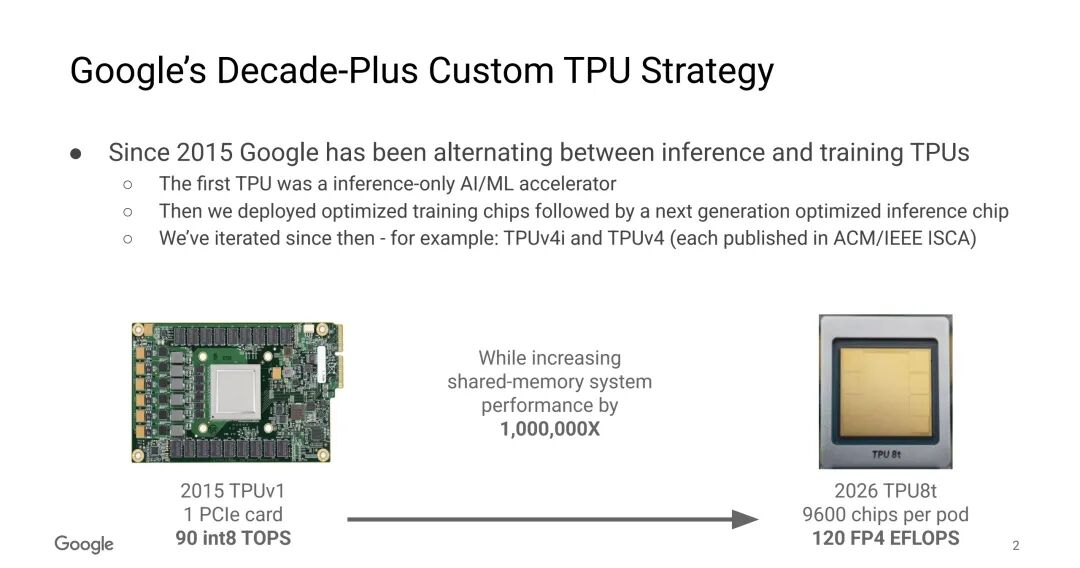
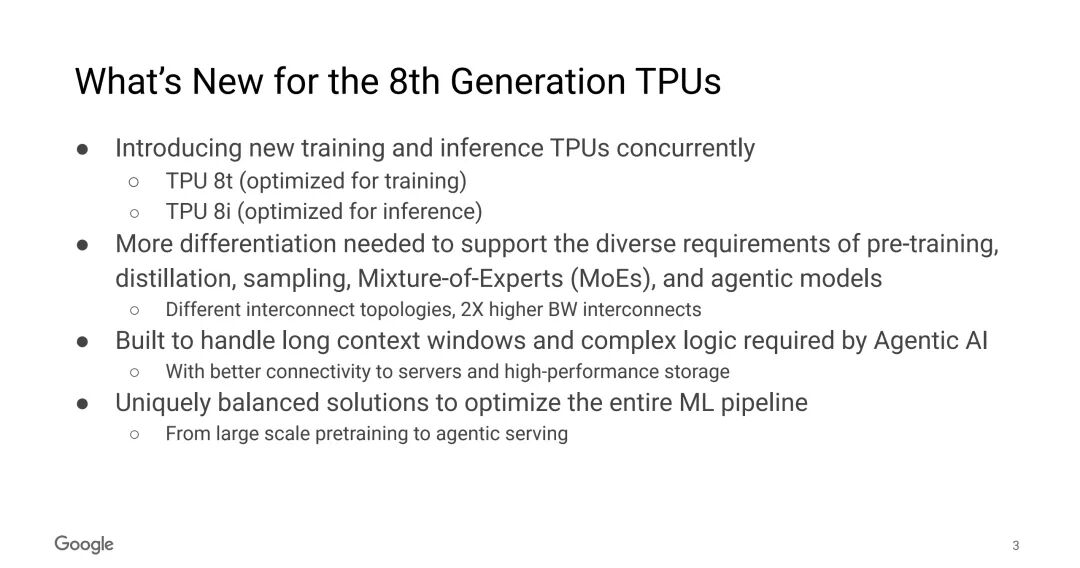
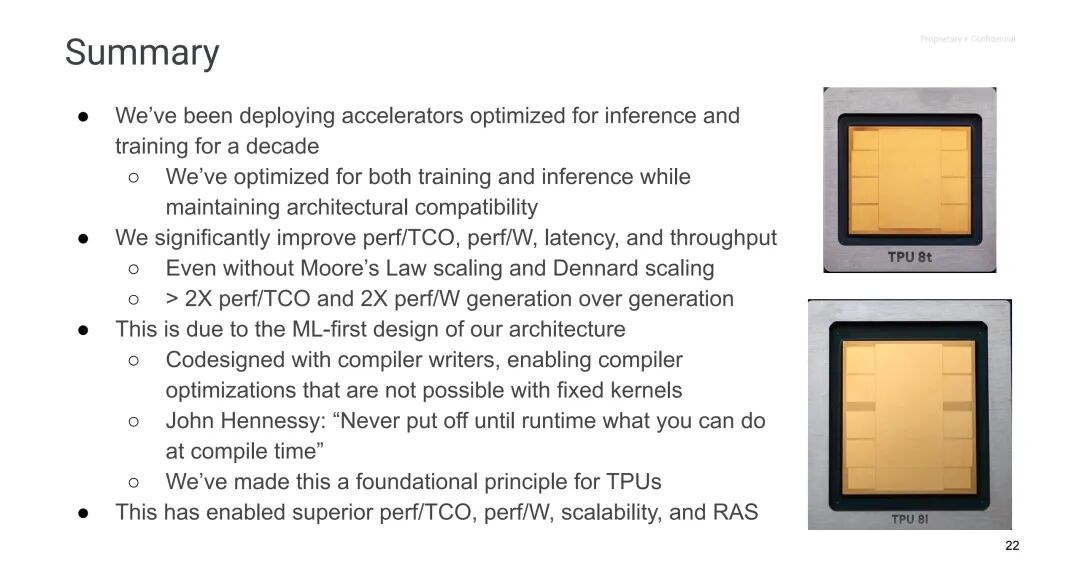
在Hot Chips 2026大会上,谷歌完整公开第八代TPU家族全部技术细节,这是谷歌TPU问世十余年一次重大架构转向:不再追求单芯片兼顾训练+推理,直接推出两颗完全独立芯片——TPU 8t训练芯片、TPU 8i推理芯片,瞄准Agent智能体、MoE混合专家大模型、超长上下文场景,重新定义AI算力硬件思路。
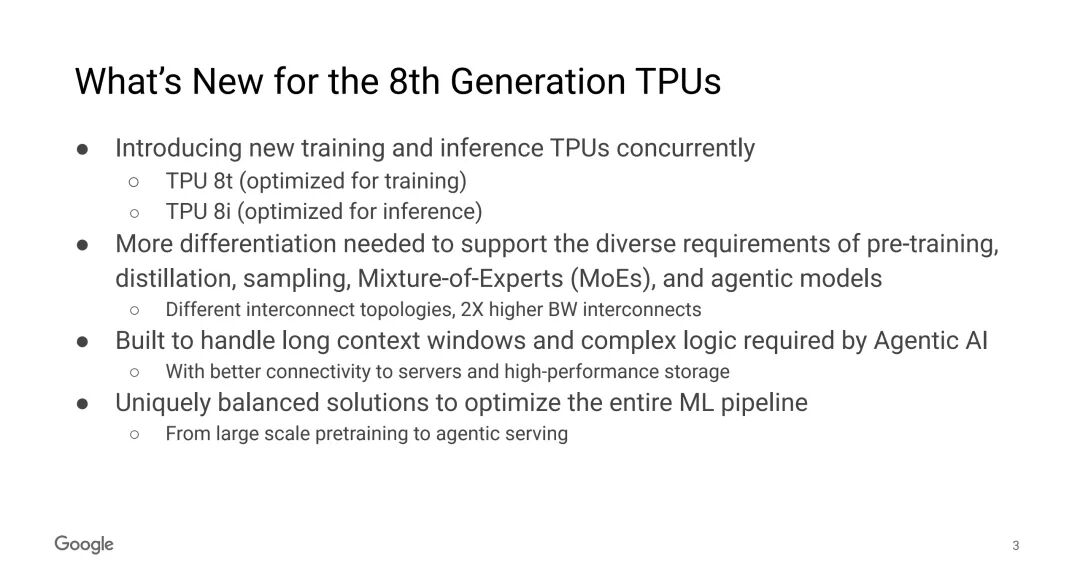
谷歌 TPU v8 全解析:TPU 8t与TPU 8i双芯片、训练端 4 倍 DCN 带宽与 9600 芯片 Pod 互连、推理端 Boardfly 拓扑创新与 80% 推理性能增益
网络定义算力时代:Google TPU v8的双芯片+双网络架构革命
🧠为什么要拆成两颗芯片?
过去TPU一代芯片兼顾训推,但进入Agent智能体时代,两类负载需求已经完全分化:
✅训练(TPU‑8t):极度吃峰值算力,需要超大集群横向扩展,追求算力密度、集群吞吐;
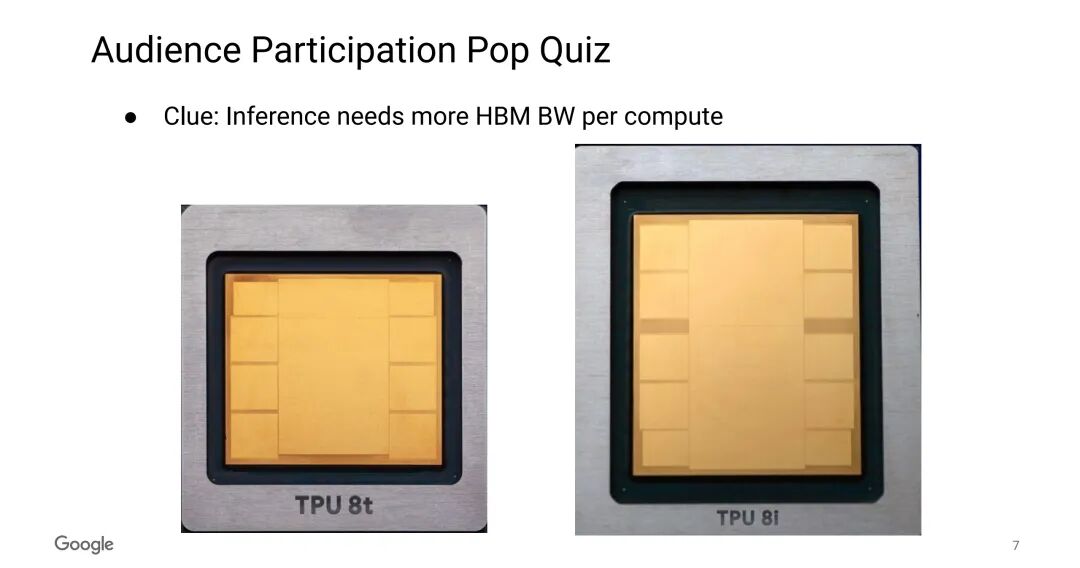
✅推理(TPU‑8i):内存墙是最大瓶颈!MoE、AI智能体大量KV‑Cache,更看重片上高速缓存、内存带宽、低延迟网络,对原始算力要求反而次要。
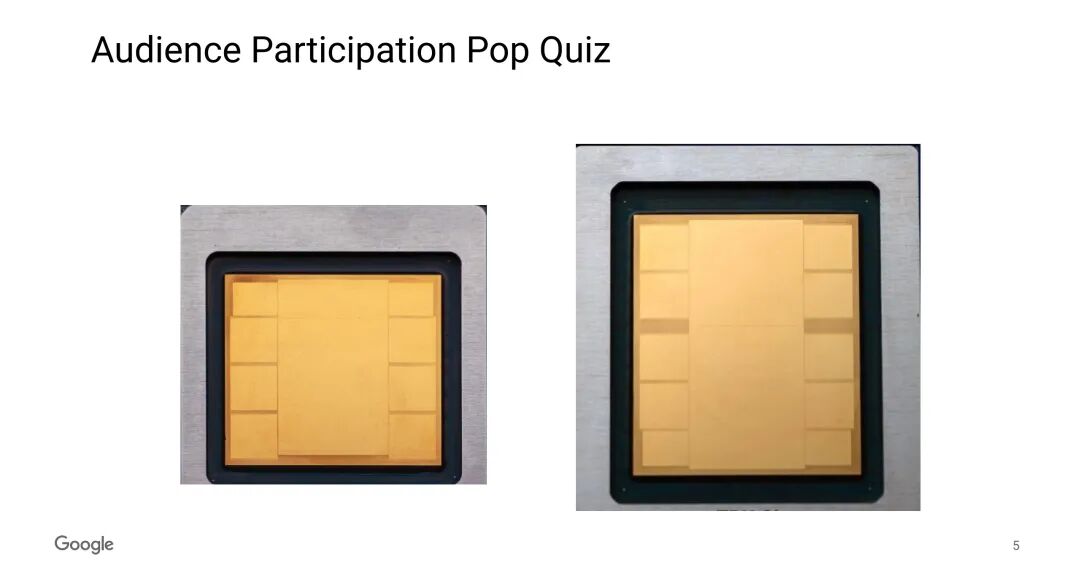
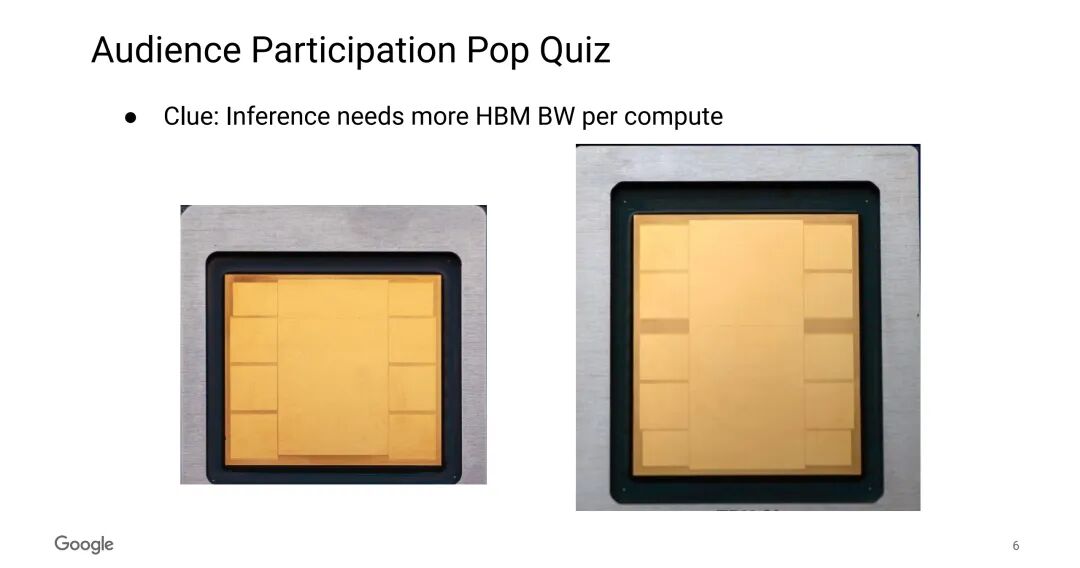
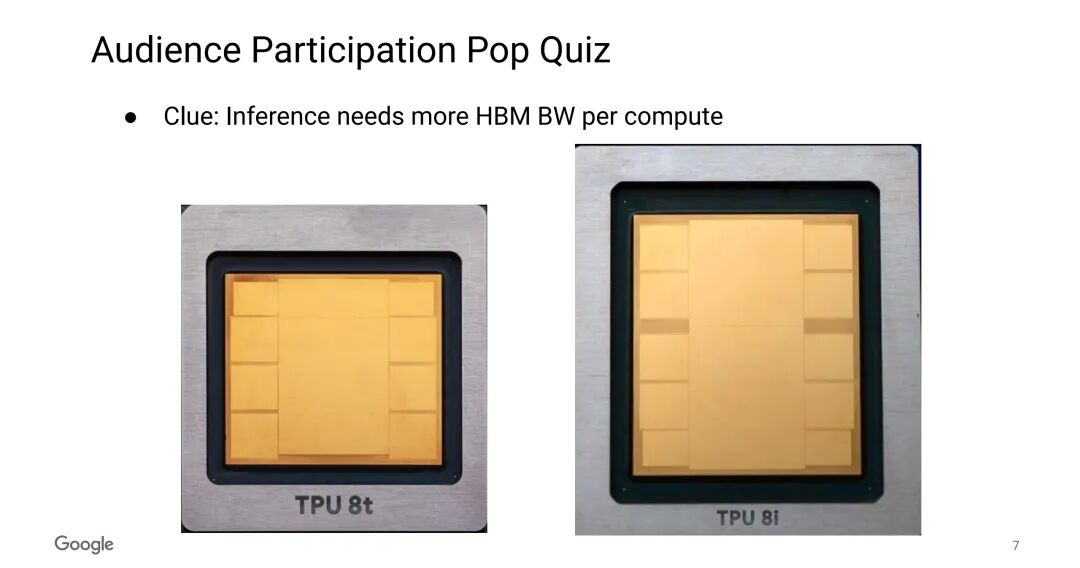
一个有意思的细节:推理芯片TPU8i裸片面积反而更大,因为它需要配置巨量片上SRAM,用来缓存KV Cache,减少访问HBM的开销。
⚡TPU 8t:万亿参数训练巨兽
TPU‑8t是面向超大规模预训练的训练旗舰芯片:
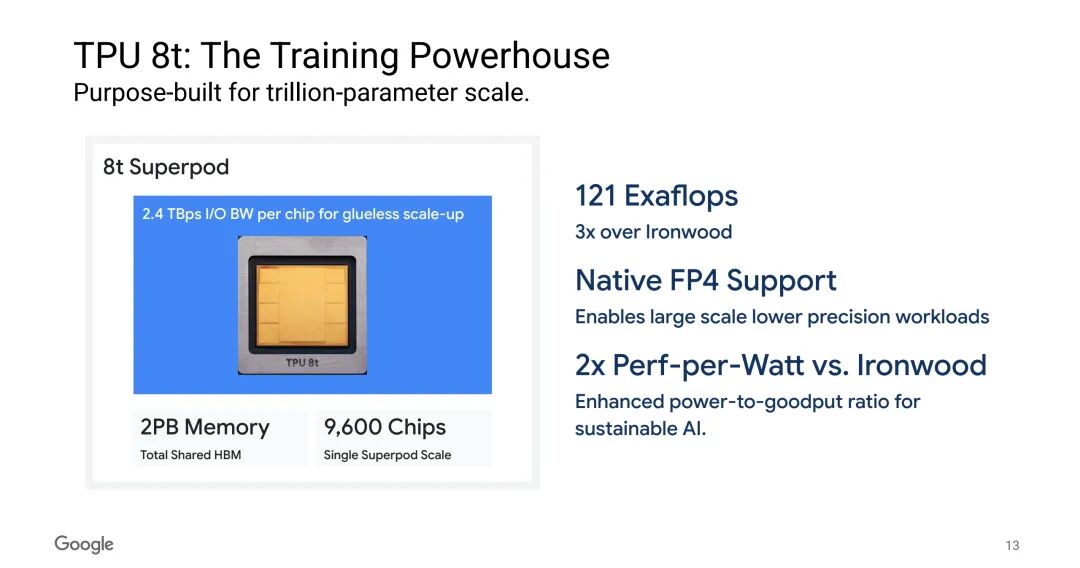
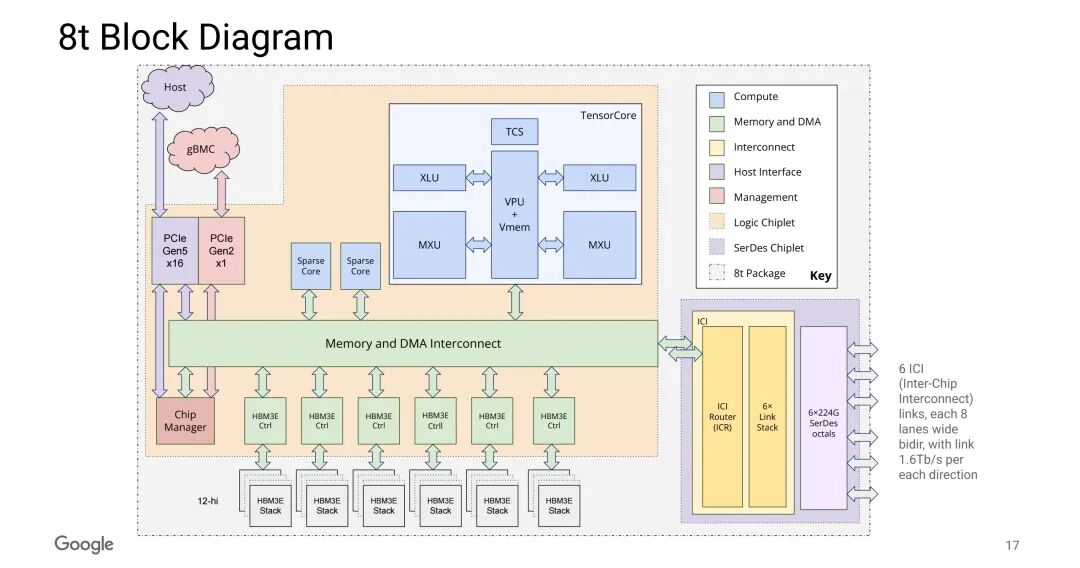
- 原生支持FP4低精度计算,相比上代Ironwood,每瓦性能提升2倍,整体算力达到上代3倍;
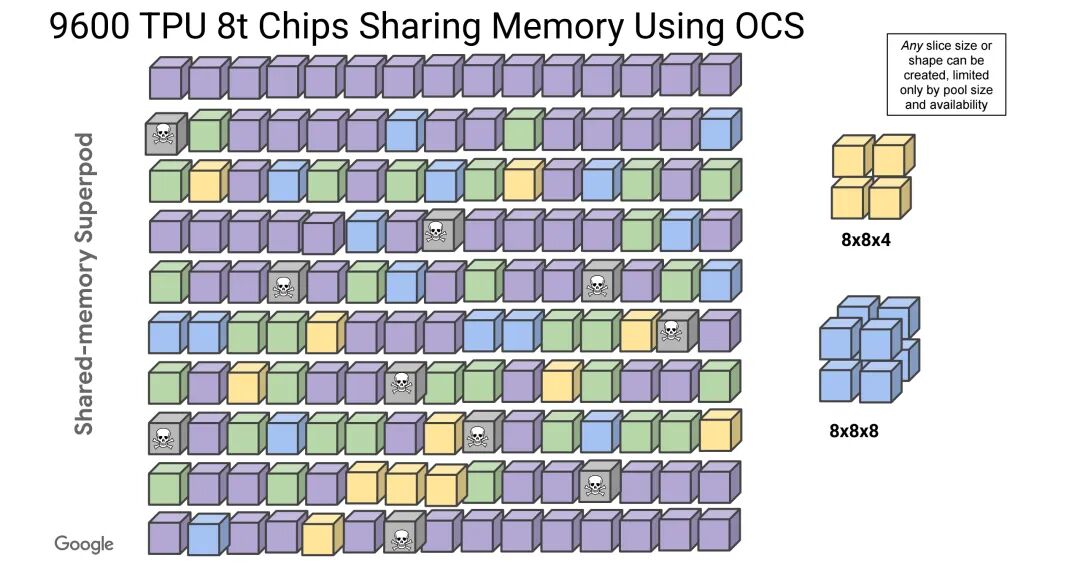
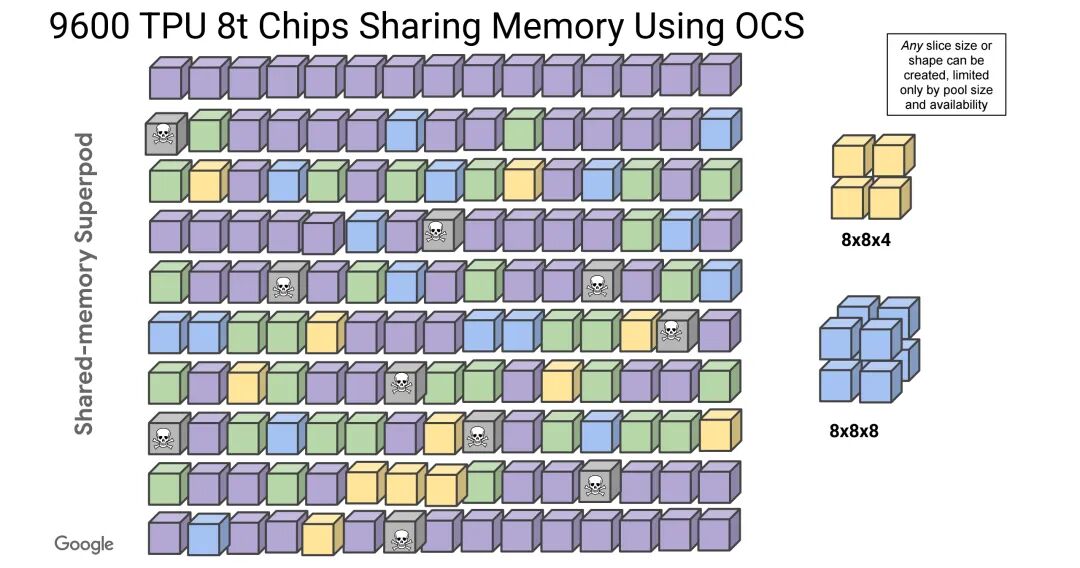
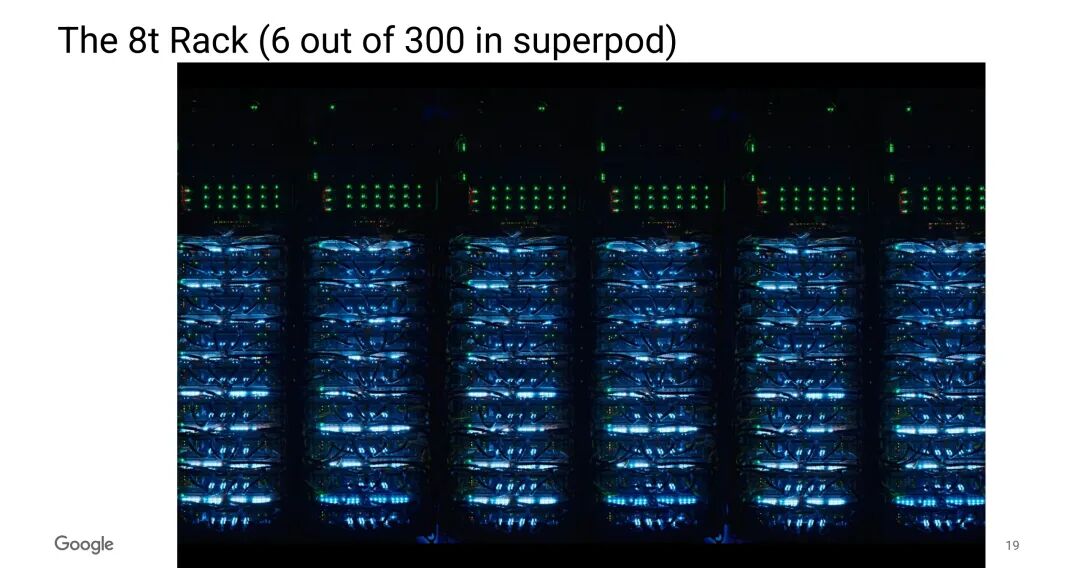
- 单Superpod可塞入9600颗TPU‑8t芯片,共享内存池总HBM高达2PB,FP4峰值算力120 EFLOPS;
- 沿用成熟3D‑Torus互联拓扑,芯片间双向带宽翻倍;
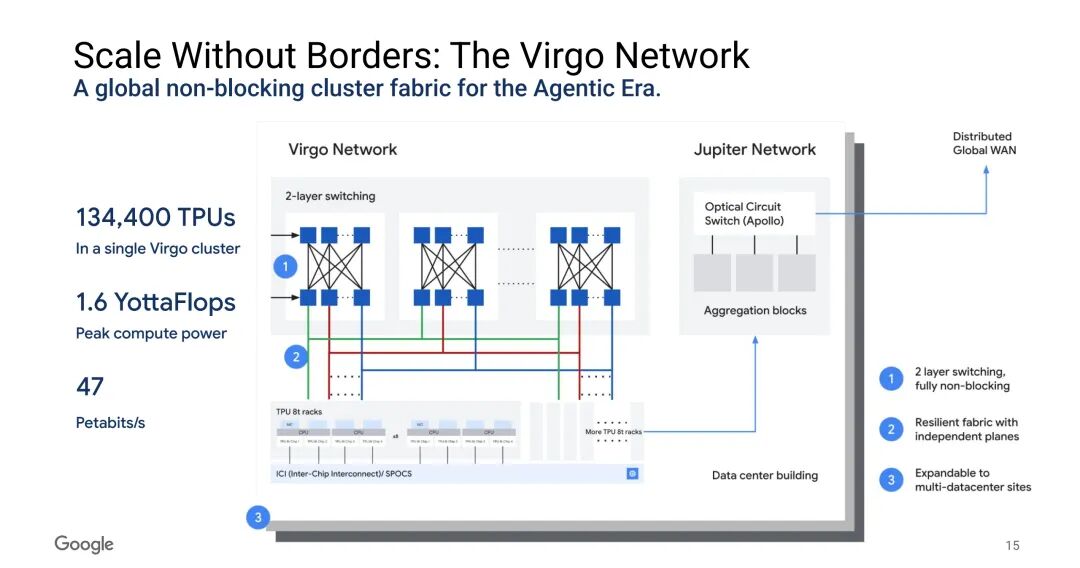
- 全新Virgo全局无阻塞集群网络,单集群最多可接入134400颗TPU,峰值算力1.6 YottaFlops,实现跨数据中心大规模组网;
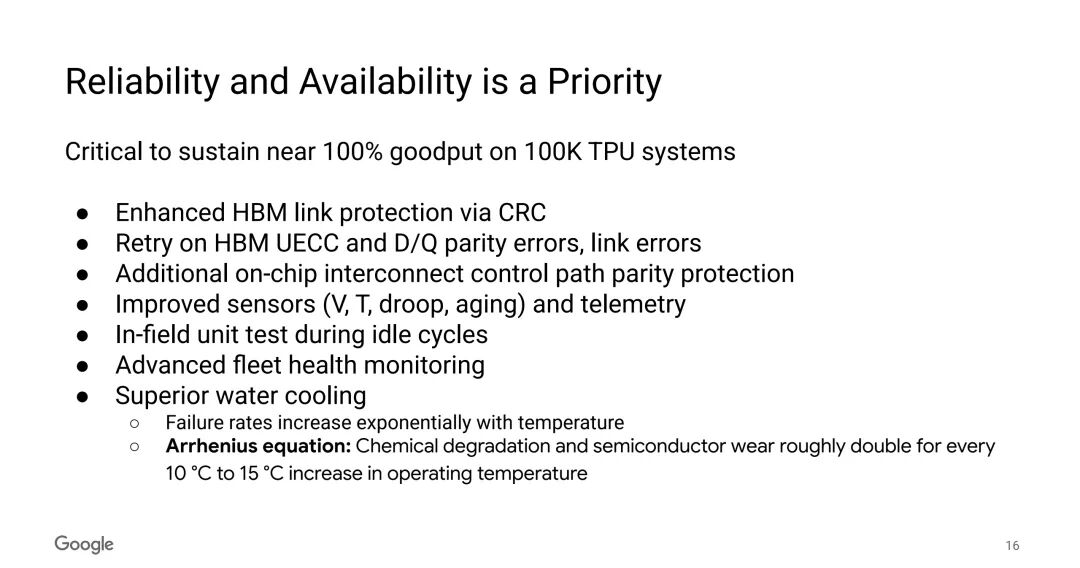
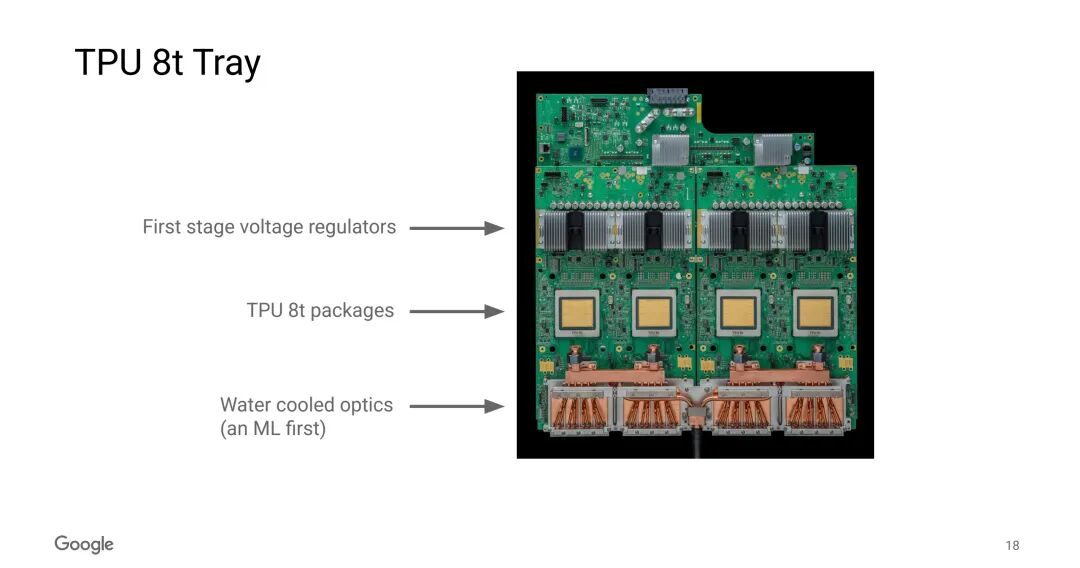
- 硬件级高可靠设计:HBM CRC保护、链路重试、全芯片传感器遥测,空闲周期自动做在线单元测试,搭配水冷,压制半导体老化失效风险,保证十万级芯片集群的有效产出率。
🚀TPU 8i:Agent智能体推理专用,专治内存墙
TPU‑8i主打低延迟推理、强化学习采样、MoE大模型服务,硬件资源疯狂向内存倾斜:
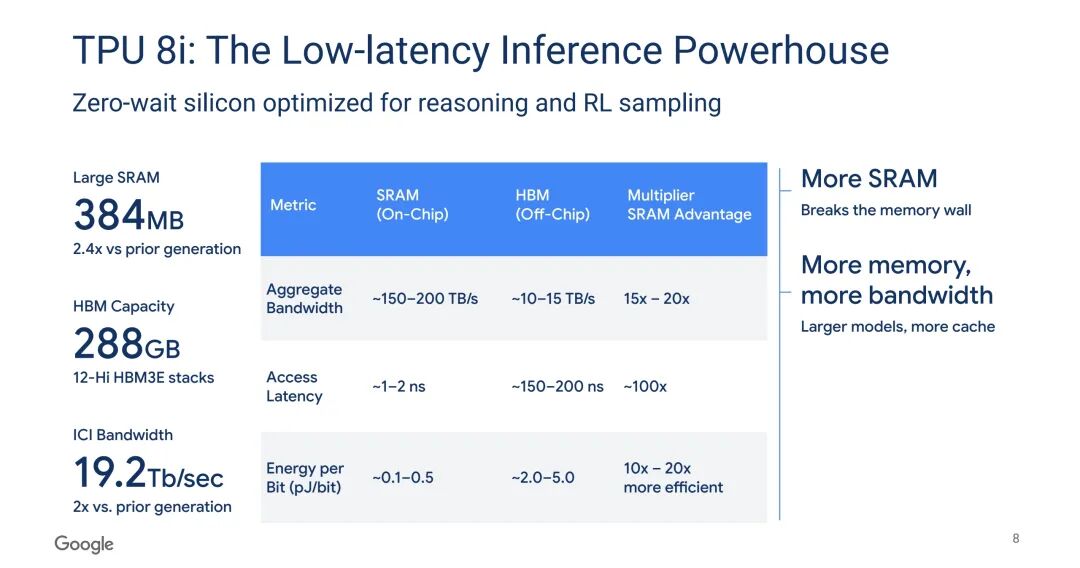
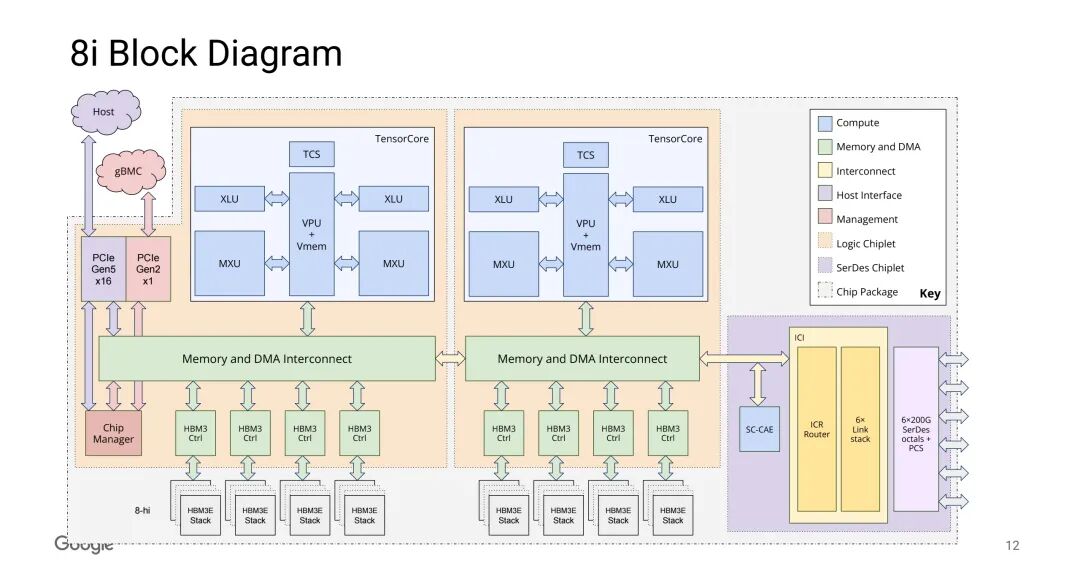
- 片上SRAM达到384MB,是前代2.4倍,SRAM访问延迟仅1‑2ns,相比HBM带宽高15‑20倍,单位bit能耗低10‑20倍,大量KV Cache直接放在片上缓存,绕开“内存墙”;
- 搭载288GB HBM3E,ICI芯片间带宽19.2Tb/s,相比上代直接翻倍;
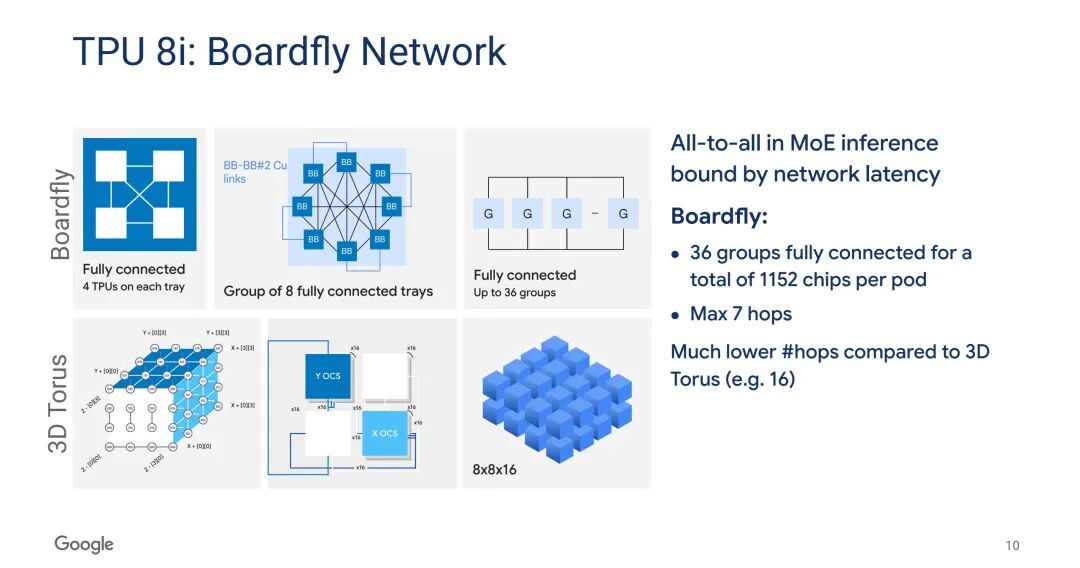
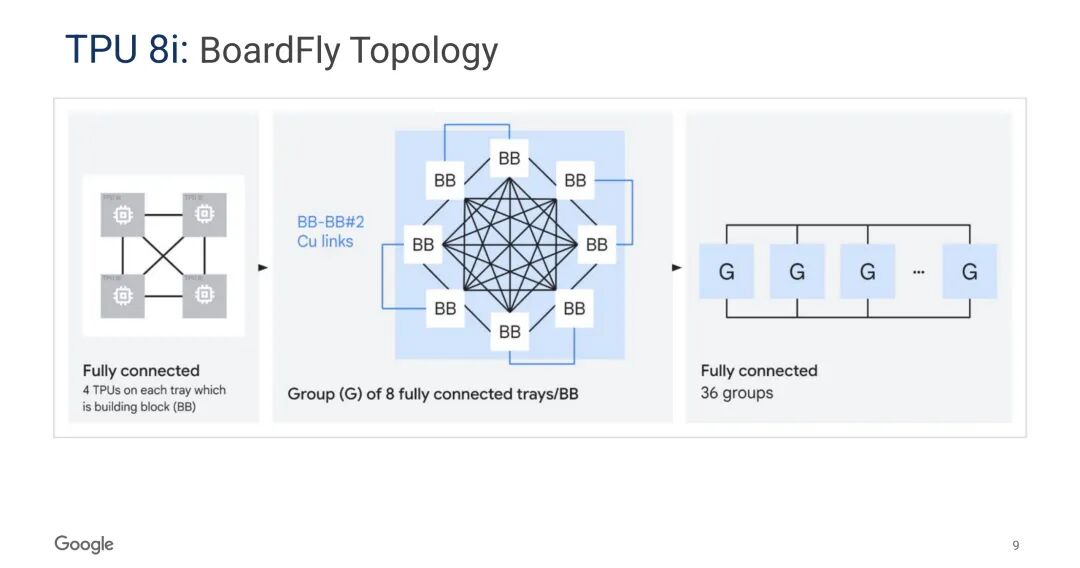
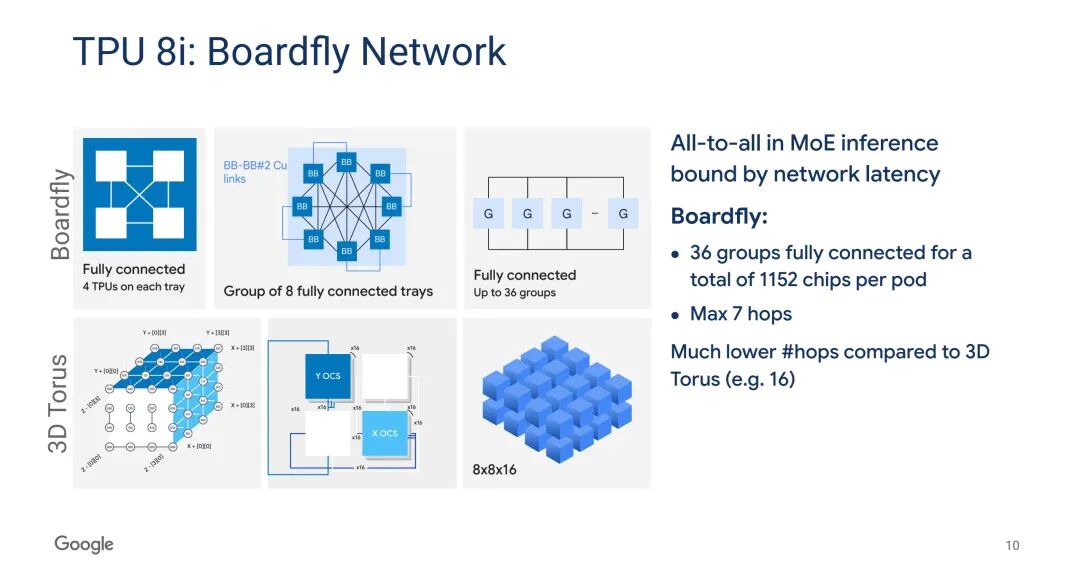
- 独创Boardfly互联拓扑:抛弃训练用的3D Torus,把芯片之间最大通信跳数从16跳压缩至7跳,大幅降低MoE推理all‑to‑all全互联通信的延迟;
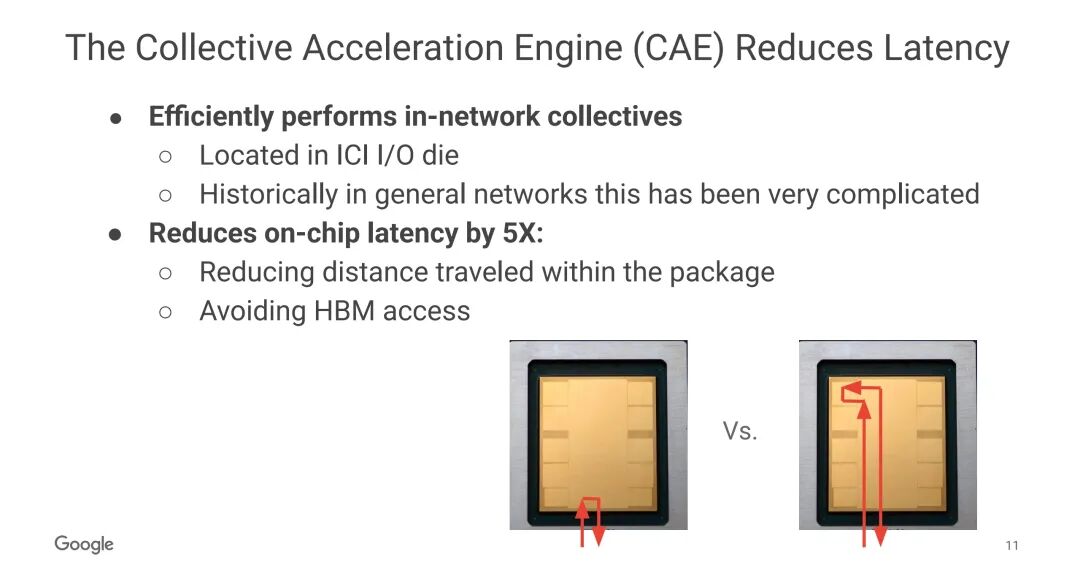
- 集成CAE集体加速引擎,放在IO裸片上,网内完成集合通信运算,片上通信延迟直接降低5倍,不需要反复读写HBM;
- 单Pod最大规模1152颗TPU 8i,完美适配百万级AI智能体并发运行场景。
💻软件全栈打通,老代码无缝迁移
第八代TPU完整兼容谷歌生态:
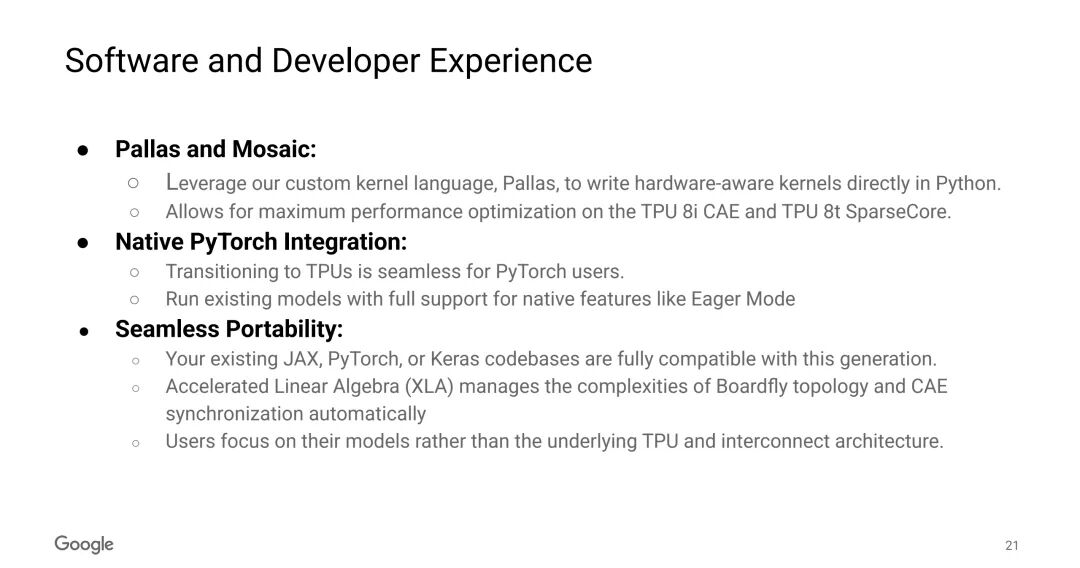
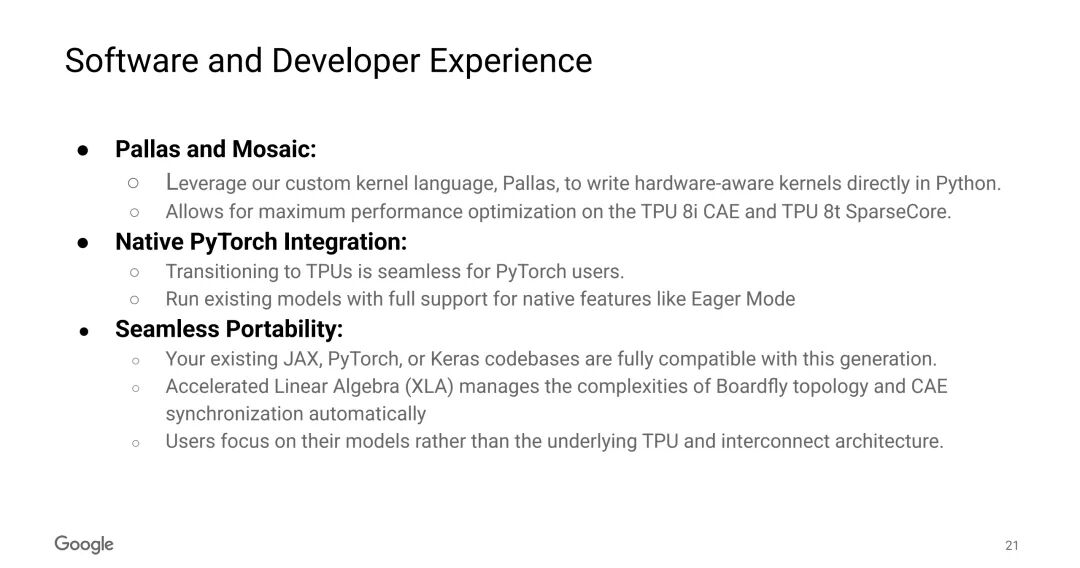
- Pallas自定义内核语言,Python即可编写硬件感知内核,充分释放SparseCore、CAE硬件能力;
- 原生深度支持PyTorch,Eager模式完整可用;
- JAX、Keras存量代码几乎不用修改,XLA编译器自动屏蔽Boardfly、CAE底层互联复杂细节,开发者专注模型本身,不用关心硬件拓扑差异。
✨行业启示:AI硬件进入高度专业化时代
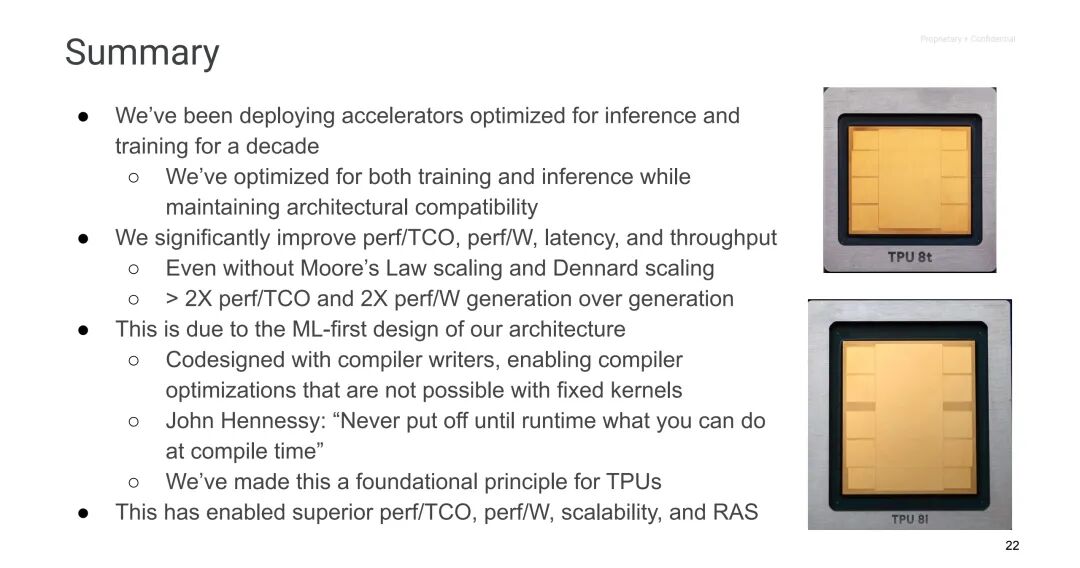
谷歌这次“训推分家”释放出一个很关键信号:随着Agent、MoE大模型爆发,“一颗芯片打全部场景”的思路正在受到挑战。训练追求算力与规模;推理拼命解决内存、延迟。与其妥协折中,不如两套硬件分别做深度优化。
当然两套芯片并非完全割裂,软件层面保持架构兼容,用户可以根据业务,灵活选择8t做预训练蒸馏,8i做智能体推理服务,覆盖从预训练、蒸馏、采样到Agent上线完整ML全链路。
报告原文slides:
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-09-02,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号