手握Ayar Labs+Lightmatter双巨头合作,GUC亮出CPO AI ASIC全栈设计方案

手握Ayar Labs+Lightmatter双巨头合作,GUC亮出CPO AI ASIC全栈设计方案
光芯
发布于 2026-09-16 20:58:47
发布于 2026-09-16 20:58:47
演讲围绕AI ASIC的产业趋势展开,系统介绍了共封装光学(CPO)架构下的Chiplets系统组成,深度拆解了HBM3/4、UCIe全系列互连、224G-SerDes等核心接口的信号完整性设计方案,并进一步阐述了热完整性与机械完整性的多物理场协同优化方法,提出了覆盖从早期设计到签核阶段的系统技术协同优化(STCO)设计方法论。
一、AI ASIC市场趋势:算力需求驱动的高增长赛道
数据中心AI加速器市场正以每年52%的增速快速扩张,其中AI ASIC作为定制化算力载体,产量年增速达44%,是算力产业增长最快的细分赛道之一。根据产业预测,2028年后AI ASIC的市场规模将超越传统CPU与GPU,成为超大规模AI基础设施的核心算力底座。
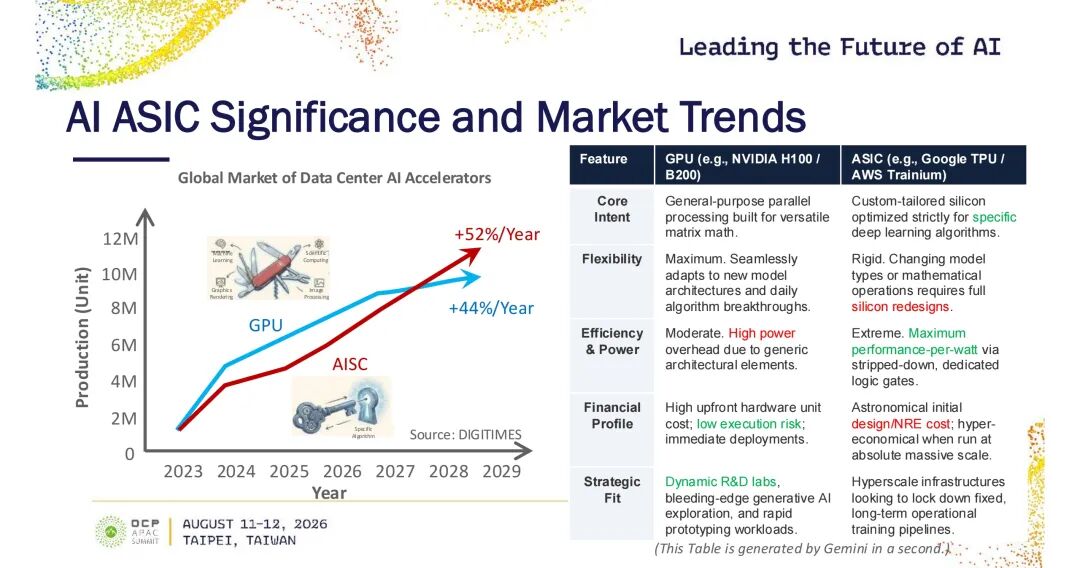
从技术定位看,AI ASIC与通用GPU形成了鲜明的场景互补:
- 核心定位:GPU面向通用并行计算,适配多样化矩阵运算;ASIC则针对特定深度学习算法做定制化芯片级优化。
- 灵活性:GPU可无缝适配新模型架构与算法迭代;ASIC架构固定,切换模型或运算类型需要重新流片。
- 能效水平:GPU因通用架构存在功耗冗余,能效中等;ASIC通过精简专用逻辑门,实现极致的单位功耗性能。
- 成本模型:GPU单颗硬件成本高,但部署风险低、可快速上线;ASIC初始设计/NRE成本极高,但在超大规模量产场景下具备极致的运营成本优势。
- 适用场景:GPU适配前沿AI研发、快速原型验证等动态场景;ASIC则面向超大规模、固定流程的长期训练推理管线。
二、CPO Chiplets系统架构:AI ASIC的先进封装底座
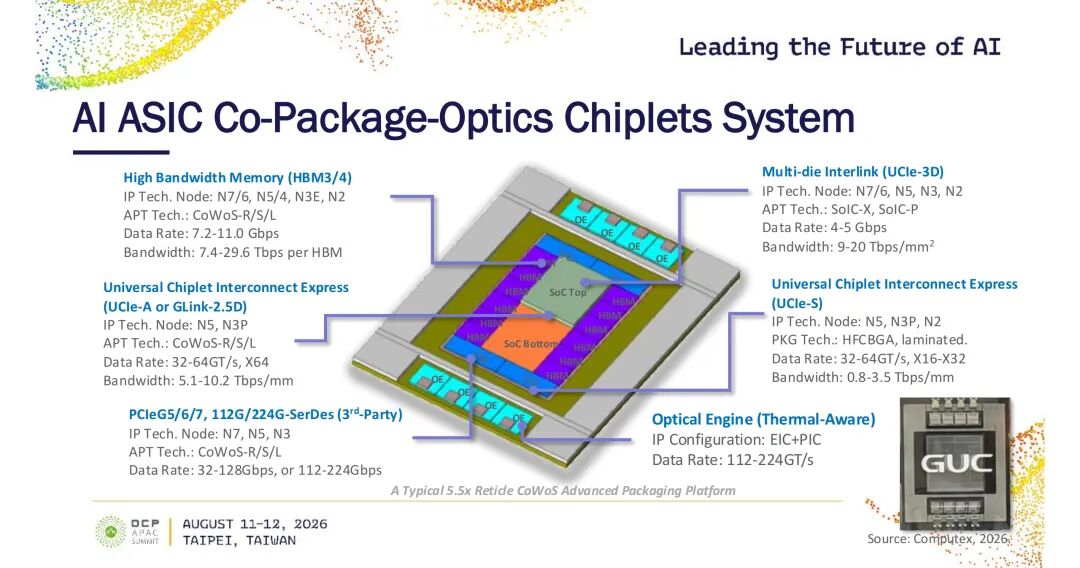
为支撑AI ASIC的超高带宽需求,基于CoWoS先进封装的共封装光学(CPO)Chiplets系统成为主流架构,典型平台为台积电5.5x光罩尺寸的CoWoS封装,集成了计算、存储、互连、光学引擎等多类裸片。
系统核心组成与关键参数如下:
1. UCIe-3D多裸片垂直互连
采用N7/6、N5、N3、N2工艺节点,配套SoIC-X、SoIC-P先进封装技术,互连带宽达9-20 Tbps/mm²,单通道数据速率4-5 Gbps。
2. HBM3/4高带宽存储
覆盖N7/6至N2工艺节点,采用CoWoS-R/S/L封装技术,单颗HBM带宽达7.4-29.6 Tbps,数据速率7.2-11.0 Gbps。
3. UCIe-S(2D封装互连)
基于N5、N3P、N2工艺,采用HFCBGA、叠层基板封装,支持32-64GT/s速率、X16-X32位宽,带宽密度0.8-3.5 Tbps/mm。
4. UCIe-A(2.5D封装互连,又称GLink-2.5D)
基于N5、N3P工艺,采用CoWoS-R/S/L封装,支持32-64GT/s速率、X64位宽,带宽密度达5.1-10.2 Tbps/mm。
5. PCIe与224G-SerDes接口
采用N7、N5、N3工艺,配套CoWoS-R/S/L封装,支持PCIe G5/6/7标准,SerDes速率覆盖32-128Gbps与112-224Gbps。
6. 热感知光引擎
采用EIC+PIC集成架构,单通道速率达112-224GT/s,设计阶段纳入热效应协同优化。
三、关键高速接口的信号完整性设计与优化
高速互连的信号完整性是先进封装AI ASIC的设计核心,演讲针对HBM、UCIe全系列、224G-SerDes五大接口,给出了详细的设计方案与仿真验证结果。
3.1 HBM3/4:GSG交错T型线互连方案
在CoWoS-R(带本地IPD)、CoWoS-L(带eDTC)等先进封装平台中,高速互连与电源分配网络(PDN)设计是性能瓶颈。演讲提出GSG-interleaved T-lines互连结构,可实现低损耗、低串扰、低负载的传输特性。
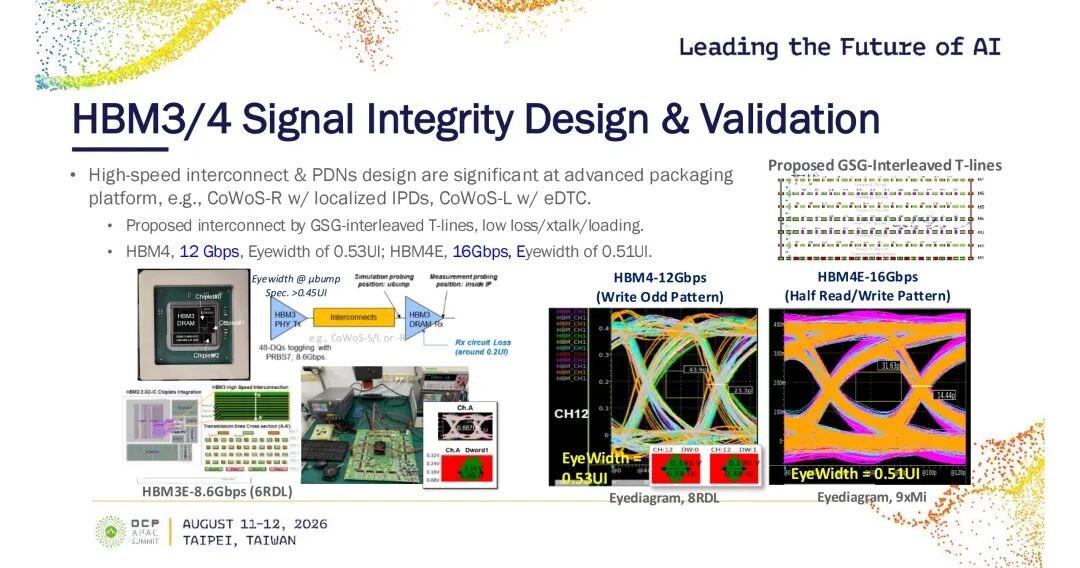
验证结果显示:
- HBM4在12Gbps速率下,μbump处眼宽达0.53UI;
- HBM4E在16Gbps速率下,眼宽达0.51UI;
- 两者均满足>0.45UI的规格要求,同时HBM3E 8.6Gbps场景也通过了信号完整性验证。
3.2 UCIe-A:32-64GT/s IP与3D电磁仿真方法
UCIe-A X64E采用10列4分片的bump版图设计,基于台积电N3工艺,实现64bit位宽下64GT/s的传输速率,Beachfront全双工带宽达10.5 Tbps/mm;配套CoWoS-S/L 8xMi硅中介层,eDTC去耦电容密度达1100nF/mm²。
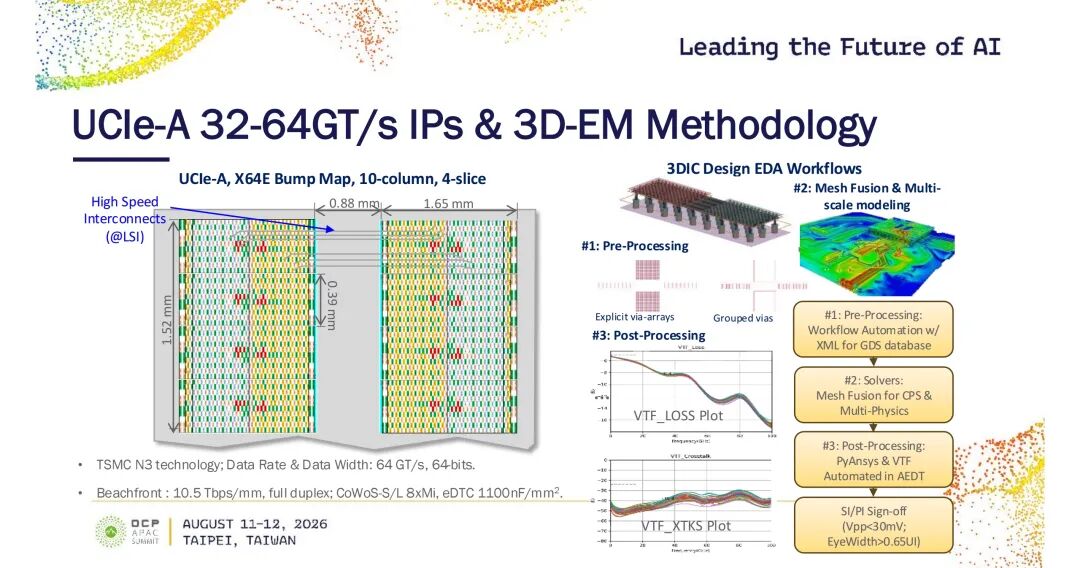
针对不同封装类型与速率组合,信号完整性风险等级存在明确差异:
- 64GT/s:CoWoS-S、CoWoS-L、9层RDL的CoWoS-R可通过验证,8层RDL的CoWoS-R无法通过;
- 48GT/s:8层RDL的CoWoS-R为中等风险,其余封装类型均可通过;
- 32GT/s及以下:全系列CoWoS封装均满足信号完整性要求。
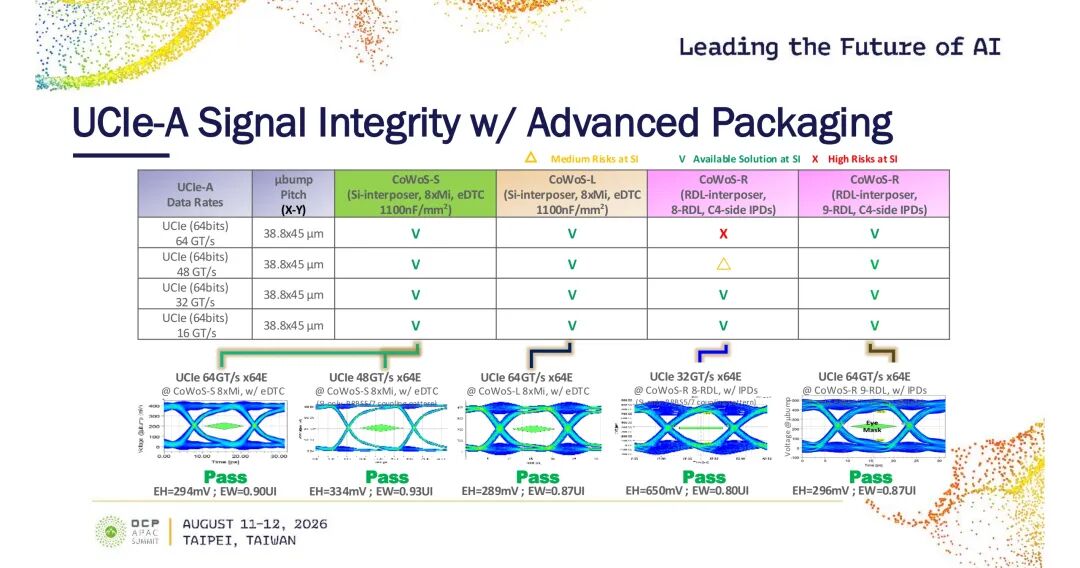
实际仿真结果显示,典型场景下眼高可达289-334mV,眼宽可达0.87-0.93UI,全部通过签核标准。
3.3 UCIe-S:后布线损耗与串扰优化
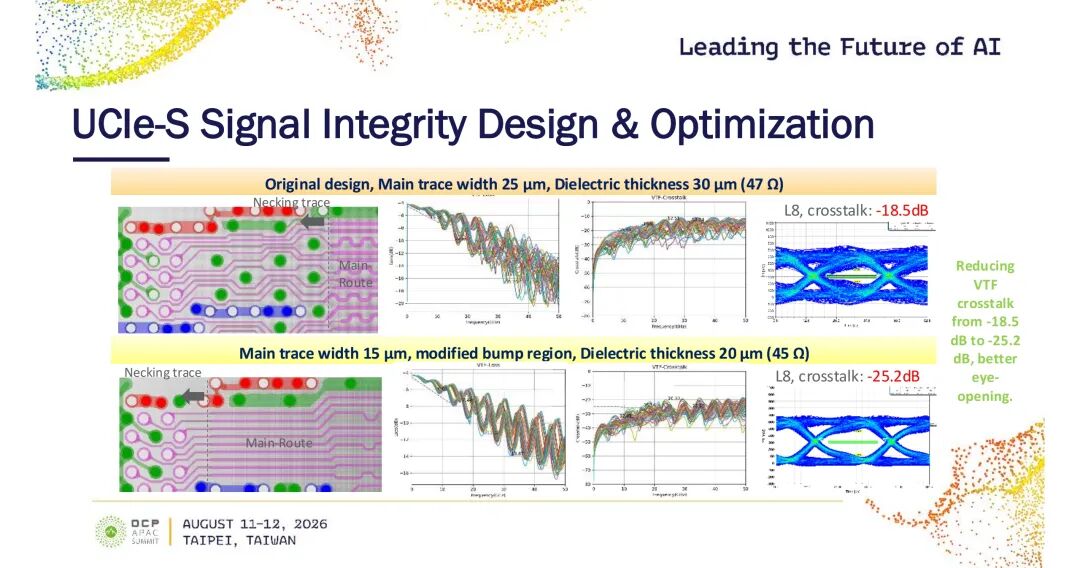
UCIe-S(X32,32GT/s)的设计核心是后布线阶段的电压传输函数(VTF)损耗与串扰优化。设计中存在两个关键风险区域:bump引出区的走线颈缩区域(阻抗突变)、长距离主走线区域。
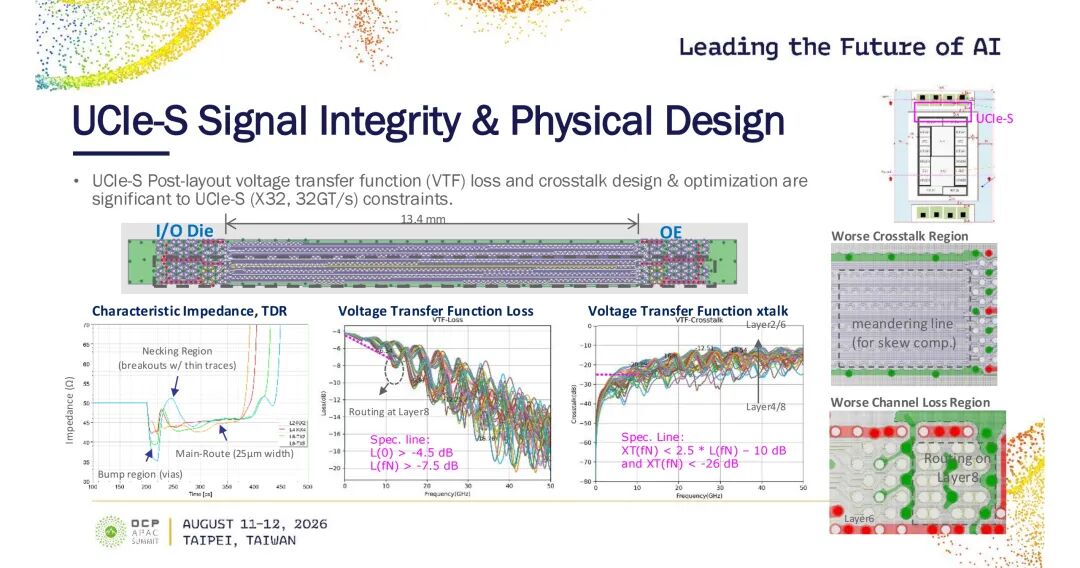
通过结构优化实现了显著的性能提升:
- 原始设计:主走线宽25μm,介质厚30μm(阻抗47Ω),L8层串扰为-18.5dB;
- 优化设计:主走线宽降至15μm,调整bump区结构,介质厚20μm(阻抗45Ω),L8层串扰优化至-25.2dB,眼图开口显著改善。
3.4 UCIe-3D:Hybridbond寄生参数与串扰分析
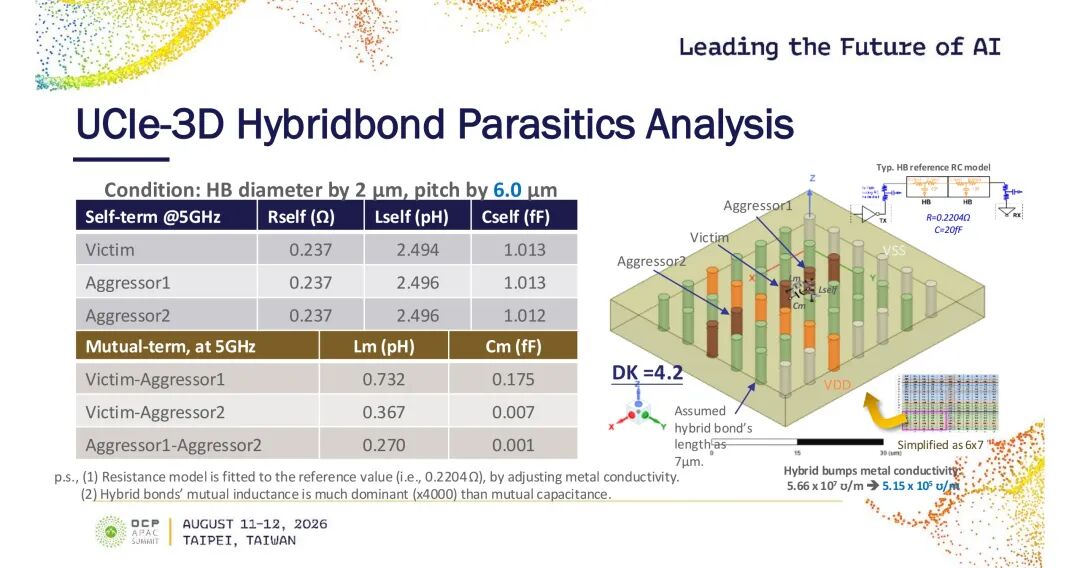
针对直径2μm、间距6.0μm、长度7μm的Hybridbond结构,5GHz频率下的寄生参数仿真显示:
- 自阻约0.237Ω,自感约2.494pH,自容约1.013fF;
- 互感远大于互容(量级差约4000倍),是串扰的主导因素。
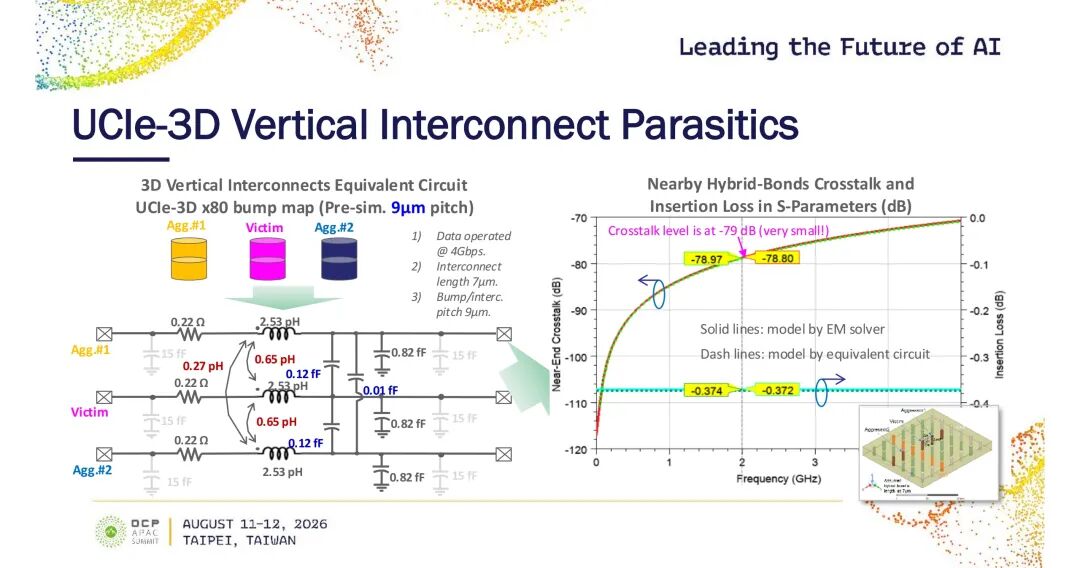
针对9μm间距的UCIe-3D x80 bump版图,等效电路模型与全波电磁仿真结果高度吻合,通道串扰水平约-79dB,串扰量级非常小,不会成为系统瓶颈。
3.5 224G-SerDes:通道预算与互连优化
224G-SerDes的完整信号路径覆盖SoIC-X顶层裸片IP、Hybridbond、BTSV、TIV、SBT扇出、封装基板、PCB、BGA球等多个环节,其中垂直互连(BTSV、TIV)是串扰均衡的关键,其性能由IP bump版图设计主导。
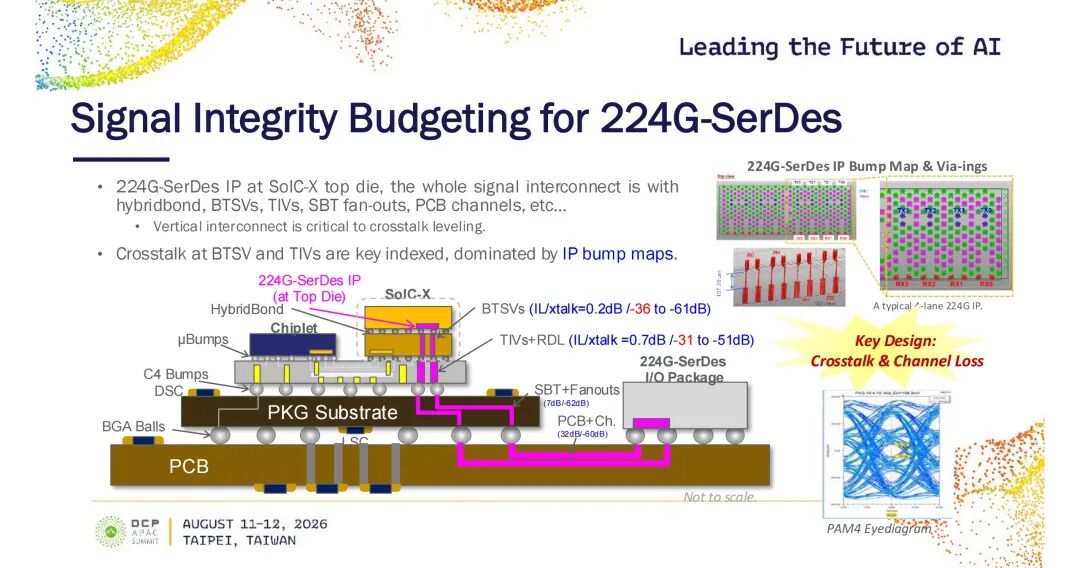
各段通道的性能预算如下:
- BTSVs段:插入损耗0.2dB,串扰-36~-61dB;
- TIV+RDL段:插入损耗0.7dB,串扰-31~-51dB;
- SBT+Fanouts段:插入损耗7dB,串扰-62dB;
- PCB段:插入损耗32dB,串扰-60dB。
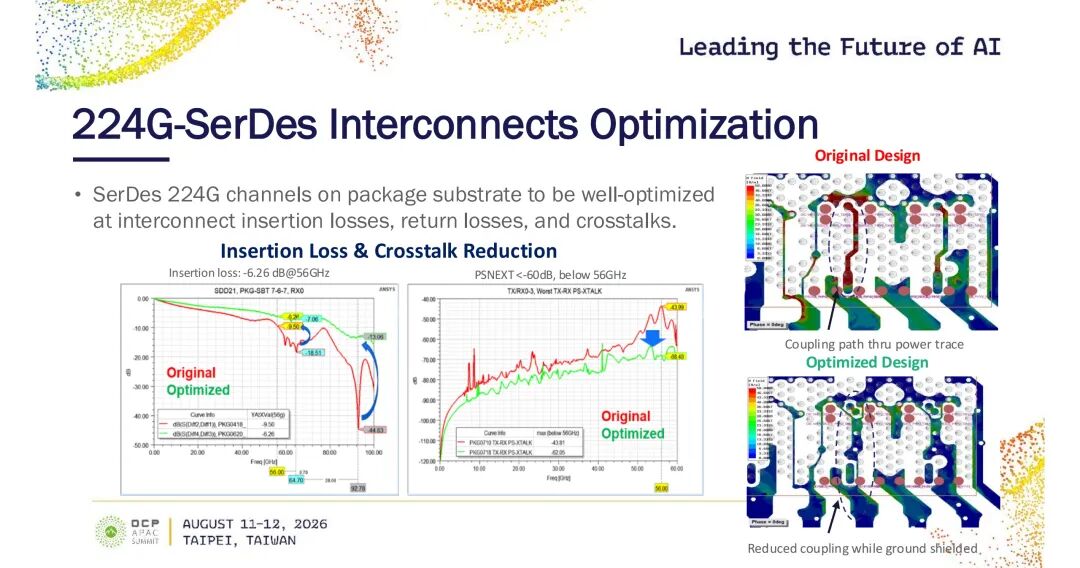
通过地屏蔽优化减少电源走线的耦合路径,56GHz频点下插入损耗优化至-6.26dB,远端串扰PS NEXT低于-60dB@56GHz,满足224G SerDes的通道要求。
四、多物理场协同:热与机械完整性的联合设计
AI ASIC的3.3kW级TDP对封装的热管理与机械可靠性提出了极高要求,需要在设计阶段实现热、机械与电学的多物理场协同优化。
4.1 热完整性:CoWoS-L与冷板协同设计
基于120×130mm尺寸的CoWoS-L封装(集成SoC、HBM、IO、OE芯片),采用入口温度45℃的冷却液冷板方案,流量配置为1.5LPM/KW,压降3.7psi。
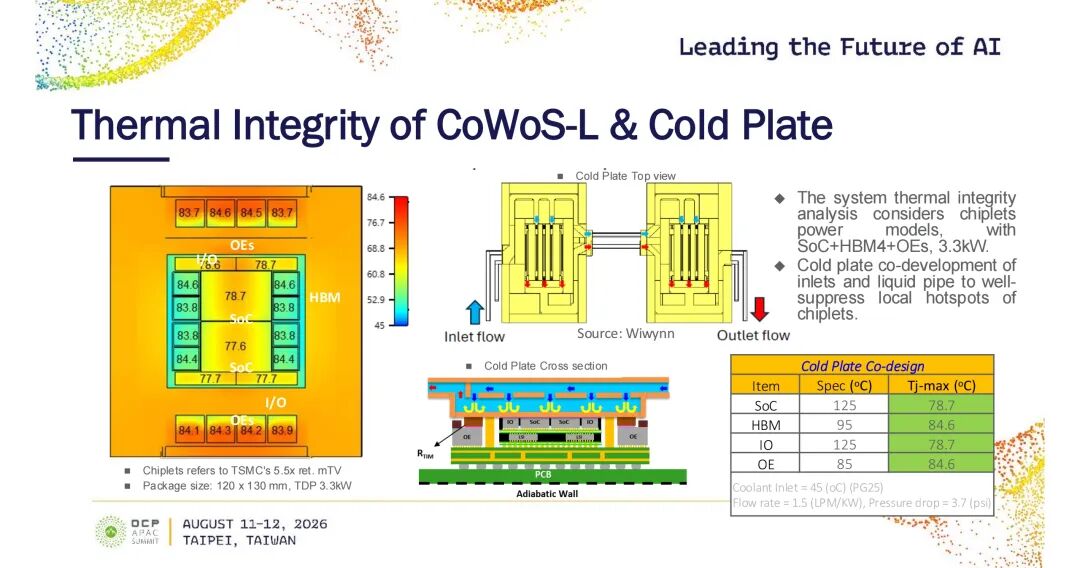
热仿真结果显示,所有芯片结温均满足规格要求:
- SoC:最高结温78.7℃(规格上限125℃);
- HBM:最高结温84.6℃(规格上限95℃);
- IO:最高结温78.7℃(规格上限125℃);
- OE:最高结温84.6℃(规格上限85℃)。
冷板的入口与管路设计有效抑制了芯片局部热点,实现了全封装的温度均匀性控制。
4.2 机械完整性:封装翘曲与共面性
针对CPO热测试载体的芯片布局,分析了C1100与SUS304两种加固环对封装翘曲与共面性(COP)的影响。结果显示:
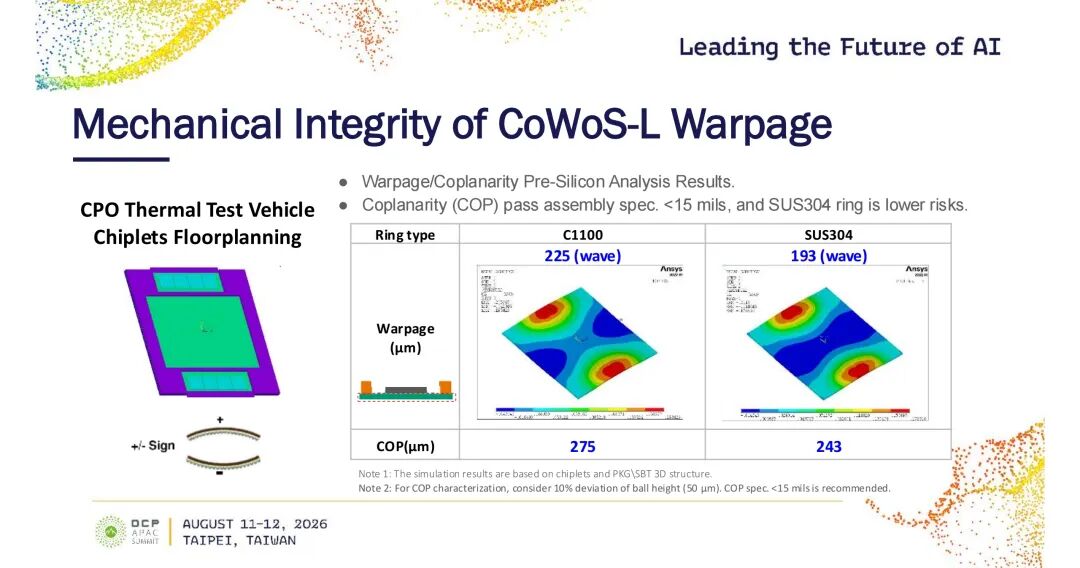
- SUS304环的翘曲量为193μm(波峰),COP值243μm;
- C1100环的翘曲量为225μm(波峰),COP值275μm;
- 两者均满足<15mils(约381μm)的组装规格,其中SUS304环的机械风险更低。
五、总结:STCO系统级协同优化方法论
本次演讲提出的系统技术协同优化(STCO)设计方法,为AI ASIC的先进封装设计提供了完整的技术框架:
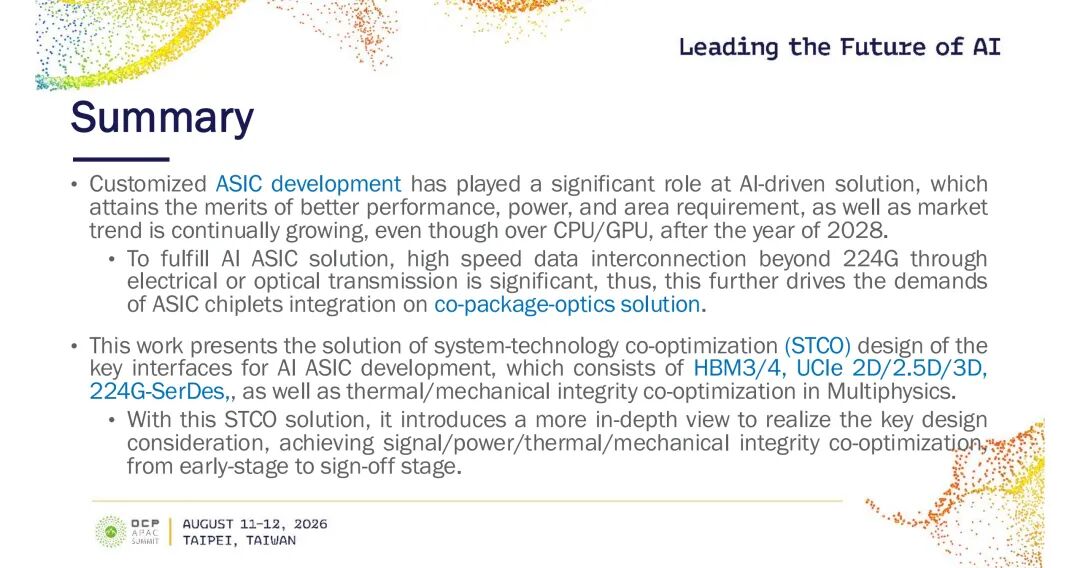
1. 定制化AI ASIC在性能、功耗、面积上具备显著优势,市场持续高速增长,2028年后规模将超越CPU/GPU,成为AI算力核心载体。
2. 224G以上的高速电/光互连是AI ASIC的核心性能瓶颈,直接推动了CPO架构下Chiplets系统集成的技术需求。
3. STCO方法覆盖HBM3/4、UCIe 2D/2.5D/3D、224G-SerDes等关键接口设计,同时纳入热完整性、机械完整性的多物理场协同,可实现从早期设计到签核阶段的信号、电源、热、机械全维度完整性优化,为AI ASIC的高性能、高可靠交付提供支撑。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-09-12,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号