一个月烧掉 18 亿 Token,我看到了 AI 时代的另一种差距

一个月烧掉 18 亿 Token,我看到了 AI 时代的另一种差距

瑭宋元
发布于 2026-09-17 21:43:58
发布于 2026-09-17 21:43:58
14,587 次调用 · 两套 AI 工作台 · 一张 $418 的账单
这篇文章里的每一个数字,都来自我自己的电脑:一半是我从 WorkBuddy 本地日志里一条条抠出来的,另一半来自 Codex 后台的用量面板。没有访谈,没有引用,全是自己烧出来的第一手数据。
今天下午我干了件有点无聊的事:把自己近一个月的 AI 用量彻底盘了一遍。
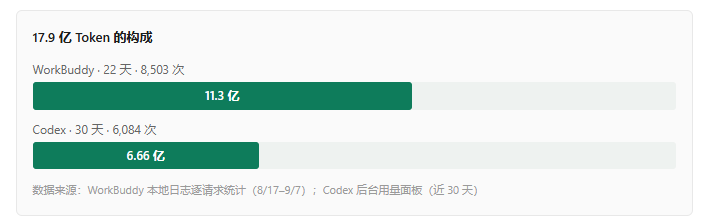
结果把我自己吓了一跳。30 天,14,587 次调用,约 17.9 亿 Token。折算下来,平均每天 486 次、将近 6000 万 Token。什么概念?GPT-4 发布那会儿,全网讨论的"天价"上下文是 3.2 万 Token——我现在一天的消耗,够那时候一整家公司用。
先别急着说"重度用户而已"。看完账单结构你会发现,重点根本不是用量大,而是这些用量花在了哪、怎么花的。那里面藏着一些我自己的没想到,也藏着我想说的核心观点。
先交代这些数是怎么来的
我日常主力是两套 AI 工作台。一套是腾讯的 WorkBuddy,办公智能体,写文章、做研究、做 PPT、处理文件都在上面;另一套是 OpenAI 的 Codex,主要写代码、做数据处理。
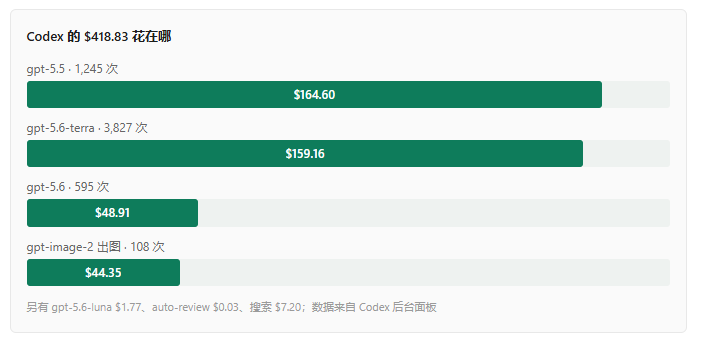
WorkBuddy 那边的数不好拿——客户端压根没有"按模型、按月"的统计面板。我从它的本地数据库和运行日志里,把 22 天里每一次模型请求都翻了出来,一共 8,503 次,累计约 11.3 亿 Token(口径说明:这是每次请求携带的上下文累加,约等于输入侧消耗)。Codex 那边简单,后台直接给:6,084 次、6.66 亿 Token、账单 $418.83。
两边口径不完全一样,但量级是可信的。合在一起,就是我过去一个月真实的 AI 消耗。
两个 AI,干的完全是两种活
把两边数据摆在一起,最有意思的是分工。
WorkBuddy 的 8,503 次请求里,混元 HY3 吃掉 6.18 亿,HY4 从 8 月 29 日上线到月底,短短 10 天就烧了 4.99 亿——因为它的上下文窗口有 100 万 Token,是 HY3 的五倍多,我敢把整本书、整个项目直接丢给它。而 Codex 那边,3827 次请求走了 gpt-5.6-terra,是绝对主力;真正贵的反而是调用次数只有它三分之一的 gpt-5.5,花了 164.60,比 terra 的 159.16 还高。
看到了吗,贵的不是用得多的,是用得不对的。这个道理放在人身上也成立。
这些 Token,到底花在什么活上
光说总量没用。我把 WorkBuddy 那边 8,000 多次请求按会话标题,归到了六类活上,结果如下。
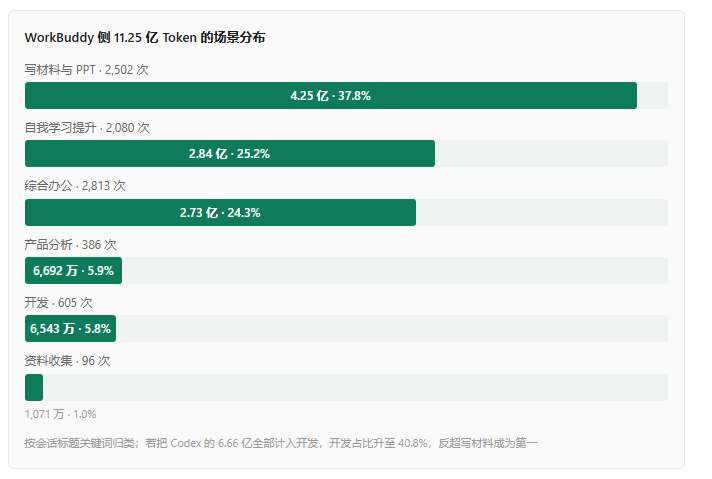
看出门道了吗。在办公智能体上,写材料吃掉了将近四成;而开发只占 5.8%——不是开发不重要,是开发我基本交给 Codex 了。两边加起来,开发才是第一大户(40.8%)。工具分工一旦清晰,账单结构是能读出工作方式的。
下面这六类活,我把自己是怎么用的都摊开说,能抄的直接抄。
写材料、做 PPT(4.25 亿,最贵的一类)。里面有个会话我必须自曝一下:一份面向客户的解决方案 PPT,来回改了 1,371 次,烧掉 2.63 亿 Token,占我整月用量的两成三。不是 AI 笨,是我拿它当"试叙事角度"的工具——同一份内容让它按"打动客户""证明能力""算经济账"分别重写,改的是角度不是错别字。我的做法就一条:别从"帮我做个 PPT"开始,从"这是谁、我们要打动他什么、上一版为什么被否"开始。背景给足,让它先出三版不同角度的提纲,你选一版再展开。
自我学习提升(2.84 亿)。这块我把它当私教和陪练。研究行业事件(比如 Kimi 和 WorkBuddy 的路线之争)、拆开源项目、准备面试,甚至让它给我出 AI 科普的选题。常用句式是"用 30 分钟能看懂的方式讲给我,然后出 3 个问题考我"——学完立刻被考,比收藏十篇文章管用。
综合办公(2.73 亿,请求数最多)。绩效总结、投标响应大纲、公司要求的"AI 赋能提效"材料。这类活最烦人,也最适合。诀窍是:把公司的要求原文直接丢进去,再加一句"我实际做过的是这些",让它先列证据清单,再动笔写。直接让它写,出来的全是空话。
产品分析(6,692 万)。入境游的客户分层、展厅布局、视频脚本、投标技术响应。这类我一定会额外加一句要求:"先反驳我,再说同意的部分。"默认它会顺着你说,你得主动把"唱反调"设成流程的一部分。
开发(Codex 侧 6.66 亿为主)。招投标监测看板、架构图、代理调试。规矩我只守一条:先让它读仓库、出方案,我批了再写代码。跳过方案直接写代码,返工成本比省下的那点时间高得多——这条教训值我那 $418 里的一部分。
资料收集(1,071 万,最省的一类)。只占 1%,不是因为用得少,恰恰是因为效率高:现在搜资料我不再一页页翻,直接给主题、给要求、给输出格式,让深度研究模式一次交稿并附来源。以前要一下午的活,现在一次请求就完事。Token 花得越少的地方,往往越是提效最狠的地方。
三件我没料到的事
盘完数据,有三个点是我事先完全没料到的,写出来给你看看。
输入是输出的 144 倍。Codex 那边统计得很清楚:输入 4.72 亿 Token,输出只有 327 万。我一开始以为是统计错了,后来想明白了——AI 干活的成本大头根本不是"说话",是"读东西"。每一轮对话,它都要把之前所有的上下文重新读一遍。你跟 AI 聊得越深,这个雪球滚得越大。所以会用 AI 的人不是话多,是会把该给它的东西一次性给全,让它少走回头路。
免费,会彻底改变使用行为。HY4 刚上线时限时免费。上线前我用 HY3,日均 2500 万 Token 左右;上线后我切过去,日均 5300 万,直接翻倍。不是因为任务变多了,是窗口变大、成本归零之后,我敢把以前"舍不得"的活全部丢给它——整份标书、一整个代码仓库、几十篇资料。这个观察让我后背有点凉:很多人不是不想用 AI,是每次用都在心里算钱,算着算着就不用了。
大部分请求,我根本不在场。8,503 次请求,我自己手打对话发起的可能连两成。剩下八成,是 agent 在自主干活:深度研究自己拆任务、循环检索,做 PPT 自己迭代十几轮,跑数据自己试错自己修。平均每次请求耗时 16.57 秒,一天几百次——如果这些都要我手动一步步问,一天什么都不用干了。
说句不太严谨的、凭体感的判断:现在评价一个人用 AI 的水平,别看他提示词写得多花,看他敢不敢把一整个任务连锅端给 AI,然后走开。
用量,才是新的鸿沟
铺垫了这么多,说我的核心观点。
这一年大家聊 AI 差距,聊的都是"会不会用":会不会写提示词,会不会选模型。我觉得这个讨论已经过时了。提示词的差距,一个下午就能抹平。真正的差距在用量上——一个月 14,587 次调用和一个月 14 次调用之间,隔着一整条工作效率的鸿沟。
因为用量背后是三样东西:你信不信它(敢不敢把重要任务交给它),你有没有把它嵌进流程(还是想起来才问一句),以及你付不付得起这个成本($418,约三千块人民币,换回来的是我每天好几个小时)。这三样没有一样能靠"学"获得,只能靠真金白银和真实任务喂出来。
我观察到的现象也很直白:身边凡是 AI 转型成功的同事,没有一个是从"学完再用"开始的,全是"先用起来再学"。用量滚起来,判断力才有地方生长。反过来,收藏夹里存了 100 篇 AI 教程、一次实战没跑过的人,半年后还是老样子。
AI 转型不是一场培训,是一次用药量的爬坡。剂量不够,说什么都没用。
如果你想开始,就三件事
不整虚的,说具体能做的。
挑一个你每周都在重复的活——周报、资料整理、竞品汇总,随便哪个——这周开始整个丢给 AI,别一步步问,给它背景、给它样例,让它一口气交初稿。丑就丑,先跑通。
给 AI 办一张"月票"。订阅制比按次付费的心理负担小得多,$20 也好,几十块的国产工具也好,关键是让"用"这个动作不再触发你的算钱本能。我自己的账单摆在这:一个月三千块,买回来的是每天两三个小时。
每月底看一眼自己的用量面板。不用精确复盘,就问自己一句:这个月,AI 替我干的活是不是变多了?曲线是平的,就该警觉了。
顺便说个不相干的。盘数据的时候我发现,那两个测试自定义模型的会话,一个只聊了句"你好啊"就再没打开过——那是我 8 月 17 号半夜配 API 调的。你看,连我自己都有只收藏不使用的时刻。区别只在于,第二天我接着用了。
你上一次让 AI 替你干一整个活,是什么时候?
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-09-08,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号