用 Jev 给机器人装一层"可算账的决策皮层":从 SoC 选型到上线验证
原创
用 Jev 给机器人装一层"可算账的决策皮层":从 SoC 选型到上线验证
原创
龙恒宇
修改于 2026-09-22 11:51:49
修改于 2026-09-22 11:51:49
TL;DR
我把 TypeSafe AI 的 Jev(一个不生成文本、只返回类型化决策的模型)接入机器人任务回路,替换原先"LLM + JSON mode + 重试解析"的失败归因模块做了一个尝试。
尝试效果汇总如下:
指标 | 原方案(LLM JSON mode) | 新方案(Jev) | 改善来源 |
|---|---|---|---|
决策延迟 P50 | 3s ~ 30s | 0.1s ~ 0.8s(含网络 RTT) | 无自回归解码、问题并行 |
结构化输出错误 | 0.58% ~ 45.5% | 0%(构造性保证) | 输出不是字符串 |
决策层单步成本 | 约 $0.014 | 约 $0.00008 | 输出免费 + 输入计价 |
是否需要人工兜底 | 全量抽查 | 按置信度分档 | confidence 可路由 |
最关键的结论不是"快",而是:Jev 让"不确定性"第一次变成了可以写进 if 语句的工程量。机器人场景里,这件事比准确率重要得多。
数据可信度声明
本文严格区分三类数字:
标记 | 含义 |
|---|---|
| 来自 TypeSafe AI 官方文档或公开采访,未经第三方复现 |
| 我这里是基于公开架构信息做的推算,建议还是以自己测算的为准 |
| 需要你按第 6 节方法跑出来的数,本文只分享方法不给最终结果 |
Jev 于 2026 年 9 月中旬发布(也就是刚发布没多久),目前是 hosted API + waitlist 早期访问,无开源权重、无参数量披露、无自托管选项。这一点决定了它的整个工程边界——下面会反复回到这里。
1. 设备、SoC 与目标
1.1 硬件与 SoC
角色 | 型号 | 关键规格 | 说明 |
|---|---|---|---|
端侧主控 SoC | NVIDIA Jetson Orin Nano Super(8GB) | Ampere GPU 1024 CUDA / 32 Tensor Core,6× Arm Cortex-A78AE v8.2,67 TOPS(INT8),25W | 跑 VLA 模型与感知,不跑 Jev |
深度相机 | Intel RealSense D455 | RGB-D,1280×720@30fps,FOV 87°×58° | 目标物位姿估计 |
腕部相机 | 全局快门 USB3 相机 | 640×480@60fps | 抓取接触状态判断 |
末端执行器 | 6-DOF 机械臂 + 二指夹爪 | 力控分辨率 ≥0.1N,带关节扭矩反馈 | 力觉信号是失败归因的关键输入 |
上行链路 | 5G CPE / 厂区 Wi-Fi 6 | RTT ≤ 30ms(厂区内网实测) | Jev 是云端 API,这条链路是硬依赖 |
兜底算力 | 端侧 4B 量化小模型 | Qwen3-4B-Int4 或同级 | 网络不可用时的降级路径 |
SoC 选型的理由:Orin Nano Super 的 67 TOPS 只够跑一个中等规模 VLA,没有余量再塞一个判别模型。这正是 Jev 的切入点——把"判断"这件事外包到云端,端侧只留"执行"。
1.2 软件栈
层 | 版本 | 说明 |
|---|---|---|
OS | Ubuntu 22.04 + JetPack 6.x | — |
机器人中间件 | ROS 2 Humble | — |
语言 | Python 3.10+ | Jev SDK 的硬要求(3.10 起) |
Jev SDK |
| 默认模型 |
认证 | 环境变量 | 从 |
1.3 项目目标与验收标准
要解决的问题:机器人在长程任务(如"把桌上的杯子放进洗碗机")中失败后,原系统只能上报一个 TASK_FAILED 字符串,运维人员要翻 20 分钟日志才能定位原因。
目标:在任务失败后的一次决策周期内,自动产出三件事:
- 归因:这次失败属于哪一类(不能是自由文本,必须是枚举)
- 恢复:下一步该做什么(重试 / 换姿态 / 换工具 / 请求人工)
- 置信度:这个判断有多可信,据此决定要不要人介入
验收标准(写死,不接受"大概能用"):
项 | 门槛 |
|---|---|
决策周期 P50 | ≤ 800ms(含网络 RTT) |
决策周期 P99 | ≤ 2.5s |
结构化解析失败率 | 0(不接受任何 JSONDecodeError) |
归因准确率 | ≥ baseline(LLM JSON mode),允许 ±2pp 波动 |
网络中断时的降级 | RTT > 1.5s 或连续 2 次失败 → 自动切端侧兜底,不阻塞任务 |
单步成本 | ≤ $0.0002 |
2. 环境调研:Jev 是什么,以及它不是什么
2.1 核心机制
Jev 基于 Transformer,但不做自回归文本生成。你发一个 state(任意结构化数据)加一组"类型化问题",它返回类型化的答案和概率。
类比:传统 LLM 是"请你写一段 JSON 告诉我原因";Jev 是"这里有 6 个按钮,你按一个,并按下去的力度告诉我"。
[官方] 三个原语:
原语 | 提问方式 | 返回 | 备注 |
|---|---|---|---|
| 从列表中选一个 |
| 最多 255 个选项 |
| 在有序等级上评级 |
| 2~10 级,score 可落在等级之间(如 1.035) |
| 这句话是真的吗 |
| 无 confidence 字段——概率本身就是信念 |
单一端点:POST https://api.typesafe.ai/v1/systemone
{
  "state": "...",
  "model": "jev-latest",
  "questions": {
    "department": { "type": "choice", "instructions": "...", "criteria": {...} },
    "frustration": { "type": "score", "instructions": "...", "criteria": [...] },
    "is_urgent":  { "type": "noul",  "instructions": "..." }
  }
}两条最重要的性质:
- 问题并行且隔离。加问题几乎不增加响应时间,且问题之间不会互相污染。官方文档里那句 "context rot 在结构上不可能" 是对的——因为根本没有共享的自回归上下文。
- confidence 来自概率分布的形状。例子:billing 0.84 / technical 0.159 / sales 0.001 → confidence 只有 0.596。赢家票数高不代表分布干净。
训练方法是 RLCD(Reinforcement Learning for Calibrated Decisions),官方明确对标 RLHF,理由是 RLHF 优化"人类打分高"会带来两个副作用:过度自信与 mode dropping(忽略冷门但正确的答案)。这两点恰好是自动化决策最致命的。
2.2 候选方案横评
方案 | 延迟 | 输出可靠性 | 成本 | 能否本地化 | 结论 |
|---|---|---|---|---|---|
Jev |
| 构造性 0 错误 | 输入 $0.042/MTok,输出免费 | ❌ 仅云端 | ✅ 选中 |
GPT/Claude + JSON mode | 3s~329s | 0.58%~45.5% 解析错误 | $0.2~$10/MTok | ❌ | 兜底用 |
端侧 4B 小模型 + 约束解码 | 200~600ms | 依赖 grammar,部分可靠 | 硬件摊销 | ✅ | 降级路径 |
纯规则引擎 | <1ms | 100% 确定 | 0 | ✅ | 覆盖不了长尾 |
人工 | 分钟级 | — | 高 | — | 只留给低置信 |
为什么不是"直接上端侧小模型":能解决延迟,但解决不了置信度。小模型输出的 logits 大概率是未校准的(softmax 后的 0.9 不代表 90% 正确),而 Jev 的整个训练目标就是让这个数字可信。对一个要自动决定"要不要继续重试、要不要叫人"的系统,未校准的置信度比没有置信度更危险。
2.3 能放哪一层,不能放哪一层
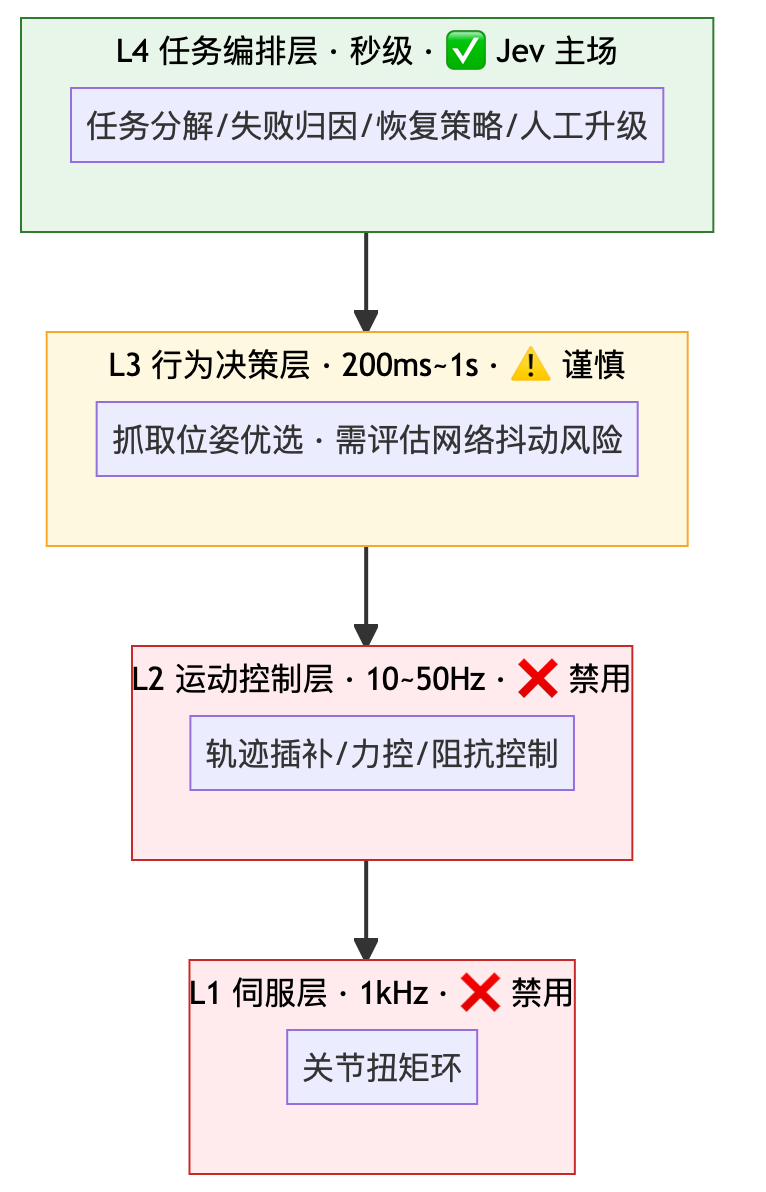
层级图
判断依据:Jev 是云端 API。即使 API 侧 70ms,实际端到端是 70ms + 网络 RTT + 重试抖动。厂区 Wi-Fi 下 P99 可能到 1.5s。这个量级只能进 L4。
这不是缺点,是定位。机器人系统里真正卡住运维效率的是 L4 的"不知道为什么失败",不是 L2 的轨迹精度。
2.4 成本模型
[官方] 输入 $42/十亿 token(即 $0.042/MTok),输出免费。
[推算] 一次典型调用:
状态裁剪后 ≈ 600 input tokens
单次成本 = 600 × 0.042 / 1_000_000 = 2.52e-5 ≈ $0.000025
每天 5000 次决策 → $0.126/天 ≈ $3.8/月
输出免费这一点被低估了。传统 LLM 计费里,输出通常按输入的 5 倍计价,而"归因 + 恢复建议"恰恰是输出重、输入轻——Jev 把这部分直接归零。
3. 项目落地:六步
3.0 整体架构
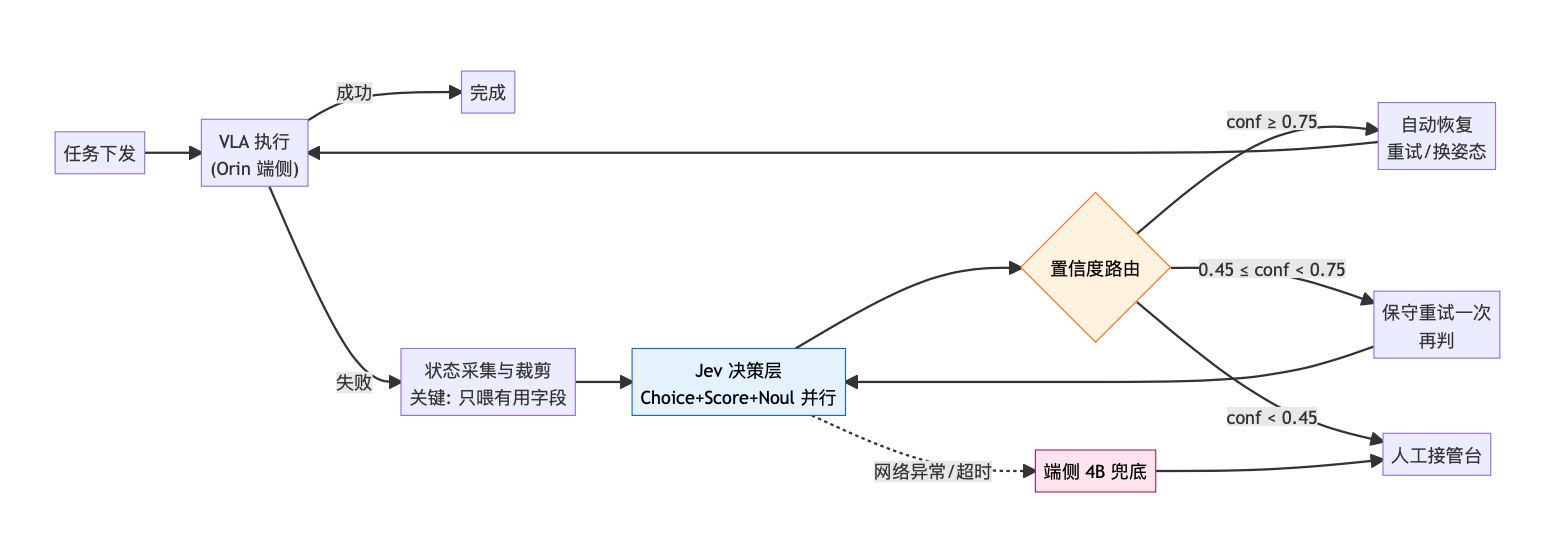
整体架构
3.1 步骤一:定义状态契约(最重要的一步)
Jev 的 state 是任意结构化对象,但 token 是要钱的。不要 dump 整个 ROS 消息。
# state_contract.py
from dataclasses import dataclass, asdict, field
from typing import Any

@dataclass
class RobotFailureState:
    """喂给 Jev 的状态。字段越少越好,每个字段都要能在归因时被引用。"""
    task_id: str
    task_goal: str                    # 自然语言目标,≤ 30 字
    failed_step: str                  # 失败发生在哪一步
    elapsed_ms: int

    # 感知证据
    detected_objects: list[dict]      # [{label, conf, bbox_cx, bbox_cy}],最多 8 个
    target_object: str | None
    depth_valid_ratio: float          # 深度图有效率,0~1

    # 力觉证据(失败归因的杀手锏)
    gripper_force_peak_n: float       # 夹持力峰值
    joint_torque_spike: float | None  # 关节扭矩尖峰
    slip_detected: bool               # 是否检出滑移

    # 运动证据
    ik_success: bool
    collision_flag: bool
    approach_axis: str                # "top" | "side" | "front"

    # 上下文
    retry_count: int
    last_failure_mode: str | None     # 上一次尝试的归因结果
    # ❌ 不要放:完整点云、图像 base64、完整 joint trajectory

    def to_state(self) -> dict:
        d = asdict(self)
        d["detected_objects"] = d["detected_objects"][:8]
return {"robot_failure_context": d}思维链:为什么 slip_detected 和 gripper_force_peak_n 必须进 state?因为"抓到一半掉了"和"根本没抓到"在视觉上几乎一样,只有力觉能区分。如果你把力觉信号砍掉省 token,Jev 的 Choice 准确率会显著下降——这里省下的 token 钱,会以人工接管成本的形式加倍还回来。
3.2 步骤二:定义三种原语问题
# questions.py
from typesafe_sdk import Choice, Noul, Score

FAILURE_MODES = {
    "perception_miss":  "目标未被检出,或检出框与真实位姿偏差过大",
    "pose_error":       "目标检出正常,但末端到位姿态与实际不符(如倾斜、深度失效)",
    "grasp_slip":       "已接触目标,夹持过程中发生滑移或力觉异常",
    "collision":        "运动过程中触发碰撞检测或扭矩尖峰",
    "ik_unreachable":   "目标位姿逆解失败或超出工作空间",
    "occlusion":        "目标被其他物体遮挡,无法建立稳定抓取",
    "hardware_fault":   "末端/关节/传感器硬件异常(夹爪未响应、相机断流)",
    "other":            "以上均不符合,需要人工判断",
    # ↑ other 是强制项,见第 5 节坑点 2
}

RECOVERY_ACTIONS = {
    "retry_same":       "原样重试(适用于偶发抖动)",
    "re_perceive":      "重新感知:换视角/补光/重新标定深度",
    "change_approach":  "更换接近方向或抓取姿态",
    "clear_occlusion":  "先移开遮挡物,再重试目标",
    "change_tool":      "更换末端工具(夹爪→吸盘)",
    "replan_task":      "当前子任务不可行,请求重新规划",
    "escalate_human":   "升级人工接管",
}

def build_questions(state: dict) -> dict:
    return {
        # ① 归因:8 选 1
        "failure_mode": Choice(
            instructions=(
                "根据以下机器人任务执行状态,判断本次失败的最可能根本原因。"
                "优先依据力觉与运动证据;若证据冲突,选择证据最强的一类。"
            ),
            criteria=FAILURE_MODES,
        ),
        # ② 恢复:7 选 1(与①隔离评估,不会互相干扰)
        "recovery": Choice(
            instructions="针对本次失败,选择最合适的一步恢复动作。只考虑单步动作,不要规划多步。",
            criteria=RECOVERY_ACTIONS,
        ),
        # ③ 严重度:4 级有序
        "severity": Score(
            instructions="评估本次失败的严重程度和继续自动重试的风险",
            criteria=[
                "轻微,安全重试多次无风险",
                "中等,可重试但需限制次数",
                "较严重,重试可能造成损坏或安全问题",
                "严重,必须立即停止并人工介入",
            ],
        ),
        # ④ 安全闸门:是/否
        "hardware_risk": Noul(
            instructions="本次失败表现出硬件故障或安全风险迹象(异常扭矩、夹爪无响应、传感器断流)",
        ),
        # ⑤ 值得再试吗:是/否
        "worth_retry": Noul(
            instructions="在更换策略的前提下,再次尝试有较大概率成功",
        ),
}思维链:为什么用 5 个并行问题而不是 1 个大 prompt?
- 并行隔离 → 5 个问题和 1 个问题的响应时间几乎一样(官方性质①)
- 隔离 → "严重度"的判断不会被"归因"的结论带偏(这是 LLM 单 prompt 里最常见的锚定效应)
- 每个问题返回独立概率 → 可以做交叉校验(下面 4.4 会用到)
3.3 步骤三:任务时序
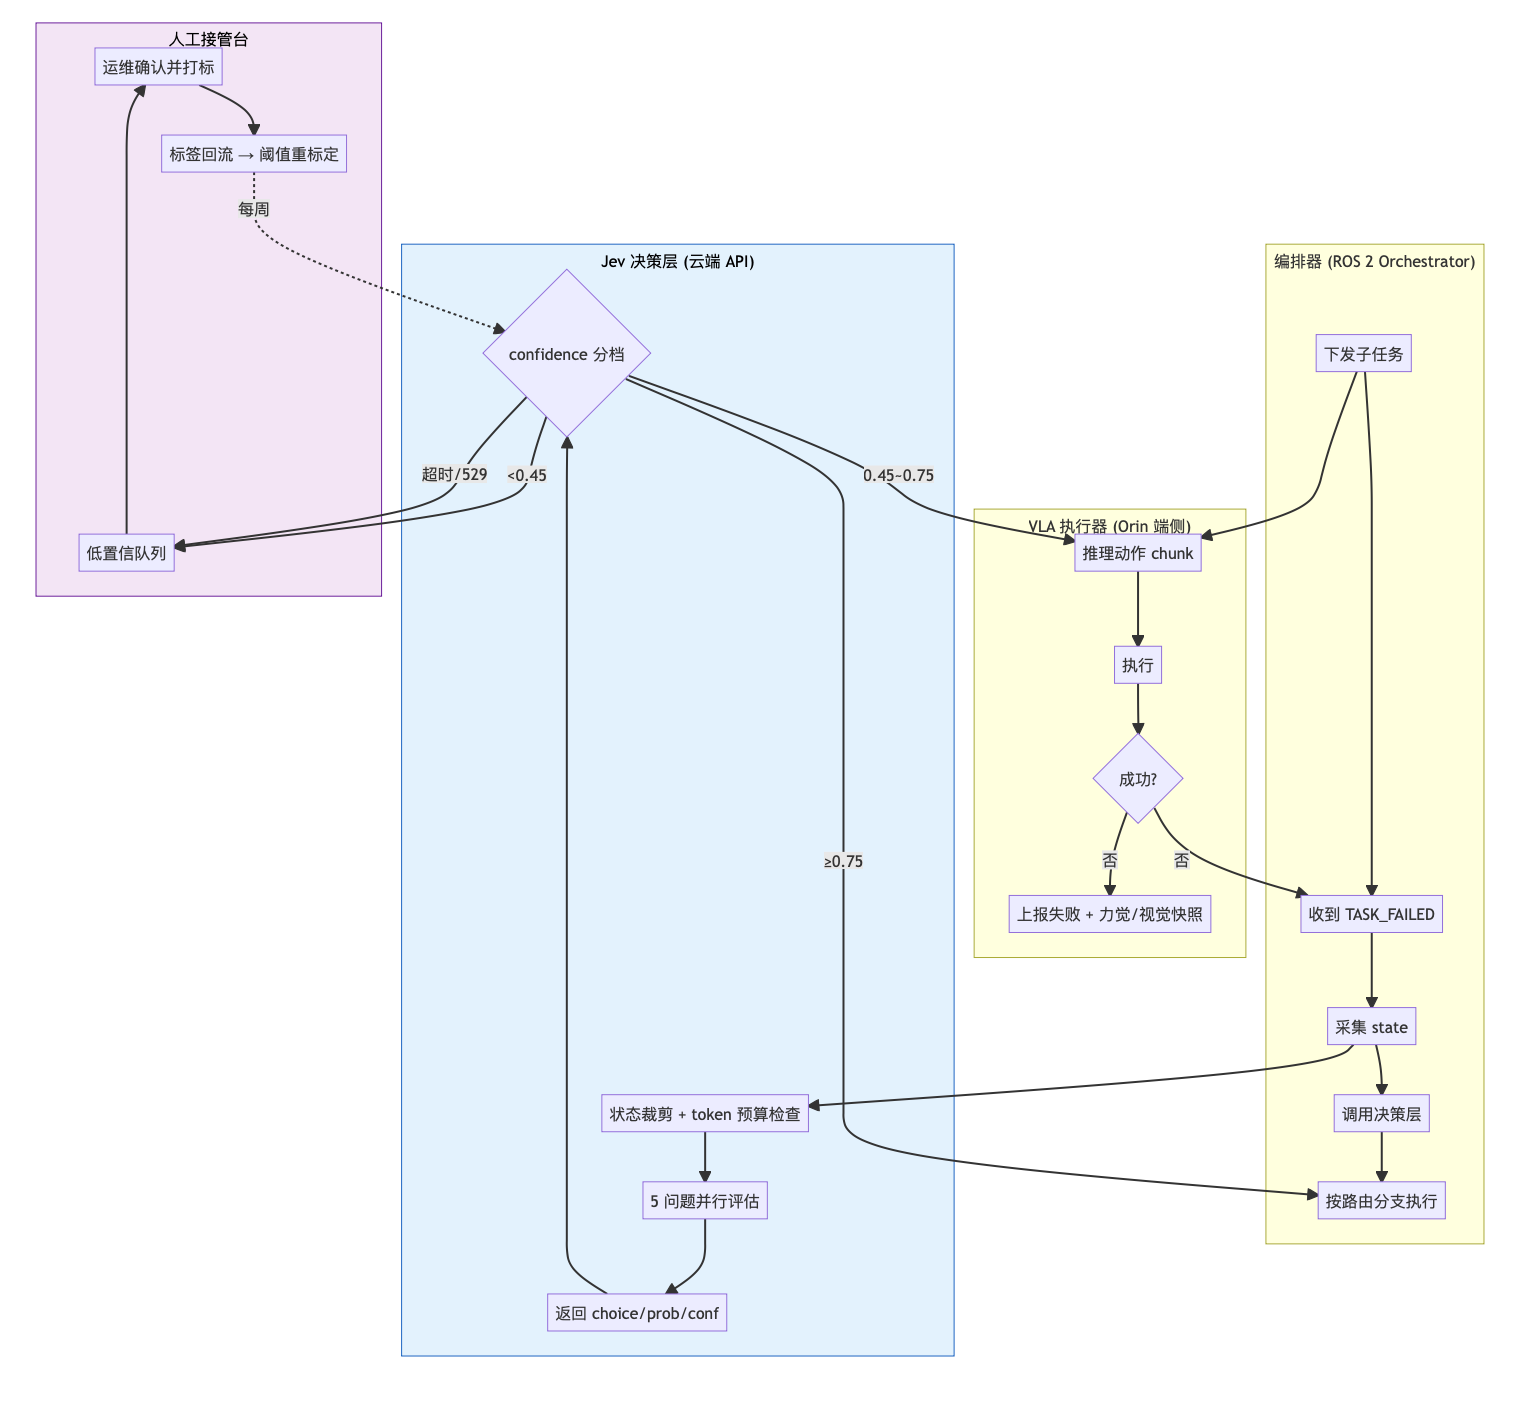
任务时许序道图
这张图里最容易被忽略的一条线:H3 → J4(人工标签回流)。置信度阈值不是拍脑袋定的,是靠人工接管的标注数据每周重标定。没有这条线,整套系统的阈值会随时间漂移。
3.4 步骤四:关键代码
4.4.1 客户端封装(超时、重试、降级)
# jev_client.py
import os, time, logging
from dataclasses import dataclass
from typing import Any
import httpx
from typesafe_sdk import TypeSafeClient

log = logging.getLogger("jev")

@dataclass
class DecisionBudget:
    """所有超时/重试都从这里走,禁止在业务代码里硬编码。"""
    timeout_s: float = 1.2          # 单次超时:> 此值走降级
    max_retries: int = 2            # 只重试可重试错误
    retry_backoff: float = 0.15
    rtt_alert_s: float = 1.5        # 超过此 RTT 触发降级标记

RETRYABLE = {429, 529, 500, 502, 503, 504}

class JevDecisionLayer:
    def __init__(self, budget: DecisionBudget | None = None):
        self.budget = budget or DecisionBudget()
        self.client = TypeSafeClient()          # 读 TYPESAFE_API_KEY
        self._degraded = False

    @property
    def degraded(self) -> bool:
        return self._degraded

    def decide(self, state: dict, questions: dict) -> dict | None:
        """返回原始 answers dict;失败返回 None(由调用方降级)。"""
        last_err = None
        for attempt in range(self.budget.max_retries + 1):
            t0 = time.perf_counter()
            try:
                resp = self.client.system_one(
                    state=state,
                    questions=questions,
                    # ⚠️ SDK 是否原生支持 timeout 参数请以官方文档为准;
                    # 若不支持,请改用 httpx 直连端点并设置 timeout,见下方 fallback_call()
                    timeout=self.budget.timeout_s,
                )
                rtt = time.perf_counter() - t0
                if rtt > self.budget.rtt_alert_s:
                    log.warning("Jev RTT %.3fs exceeds budget", rtt)
                    self._degraded = True
                else:
                    self._degraded = False
                return resp.answers

            except Exception as e:                       # noqa: BLE001
                last_err = e
                status = getattr(e, "status_code", None) or getattr(e, "status", None)
                if status not in RETRYABLE:
                    log.error("Jev non-retryable error: %s", e)
                    break
                if attempt < self.budget.max_retries:
                    time.sleep(self.budget.retry_backoff * (2 ** attempt))
                    continue

        log.error("Jev decision failed after retries: %s", last_err)
        self._degraded = True
        return None

    # —— 若 SDK 不支持 timeout,用这个直连版本 ——
    def fallback_call(self, state: dict, questions: dict) -> dict:
        r = httpx.post(
            "https://api.typesafe.ai/v1/systemone",
            headers={"Authorization": f"Bearer {os.environ['TYPESAFE_API_KEY']}"},
            json={"state": state, "model": "jev-latest", "questions": questions},
            timeout=self.budget.timeout_s,
        )
        r.raise_for_status()
        return r.json()["answers"]
4.4.2 置信度路由 + 代价矩阵
# router.py
from dataclasses import dataclass

@dataclass(frozen=True)
class CostMatrix:
    """每种错误的代价(元)。阈值由这张表反推,不是拍脑袋。"""
    auto_wrong: float      = 120.0   # 自动执行但判断错(可能撞机/损坏)
    ask_human: float       = 8.0     # 转人工的成本(运维时间)
    retry_wasted: float    = 3.0     # 白重试一次的电耗+时长

    def threshold(self) -> float:
        """
        当 p 为模型给出的置信度:
          自动执行期望代价 = (1-p) * auto_wrong
          转人工期望代价   = ask_human
        令二者相等 → p* = 1 - ask_human / auto_wrong
        """
        return 1.0 - self.ask_human / self.auto_wrong

@dataclass(frozen=True)
class RouteBands:
    auto: float      # ≥ 自动执行
    review: float    # ≥ 保守重试一次;低于此值转人工

def derive_bands(cost: CostMatrix) -> RouteBands:
    p_auto = cost.threshold()                       # 1 - 8/120 = 0.933
    p_review = 1.0 - cost.retry_wasted / cost.ask_human   # 1 - 3/8 = 0.625
    return RouteBands(auto=p_auto, review=p_review)

def route(answers: dict, bands: RouteBands) -> str:
    mode = answers["failure_mode"]
    sev  = answers["severity"]
    conf = mode.confidence
    score = sev.score                    # 可落在等级之间,如 1.035

    # ① 安全闸门优先于一切:Noul 无 confidence,概率本身就是信念
    if answers["hardware_risk"].noul > 0.5:
        return "escalate_human"
    # ② 严重度落在 2.0 以上("较严重"及更差)直接人工
    if score >= 2.0:
        return "escalate_human"
    # ③ 归因与恢复应当一致,不一致说明模型自己也没把握 → 交叉校验
    if mode.choice == "other" or answers["recovery"].choice == "escalate_human":
        return "escalate_human"
    # ④ 按代价矩阵推导的阈值分档
    if conf >= bands.auto and answers["worth_retry"].noul > 0.5:
        return f"auto:{answers['recovery'].choice}"
    if conf >= bands.review:
        return f"retry_once:{answers['recovery'].choice}"
return "escalate_human"思维链:CostMatrix.threshold() 是整篇文章最实用的一段。把"阈值定多少"从玄学变成算术——你只需要填三个数字:撞一次机器损失多少、叫一次运维多少钱、空跑一次多少钱。这三个数字你们运维台账里就有,别去问模型。
按上表默认值算出来:自动执行阈值 0.933、保守重试阈值 0.625。注意这比官方文档示例里常见的"0.75 / 0.45"要保守——因为机器人撞一次的代价远大于客服工单分错类。这就是"阈值要随错误代价缩放"的具体含义。
4.4.3 交叉校验(用并行性白赚的可靠性)
# crosscheck.py
INCOMPATIBLE = [
    # (failure_mode, recovery) 组合不合理 → 说明本次判断不可信
    ("perception_miss",  "change_tool"),
    ("ik_unreachable",   "clear_occlusion"),
    ("hardware_fault",   "retry_same"),
    ("collision",        "re_perceive"),
]

def sanity_check(answers: dict) -> tuple[bool, str]:
    mode = answers["failure_mode"].choice
    act  = answers["recovery"].choice
    if (mode, act) in INCOMPATIBLE:
        return False, f"归因({mode})与恢复动作({act})互斥"
    if answers["failure_mode"].confidence < 0.3:
        return False, "归因置信度过低"
    # Noul 与 Choice 的隐含一致性:判硬件故障却建议原样重试 → 矛盾
    if answers["hardware_risk"].noul > 0.6 and act == "retry_same":
        return False, "安全风险与恢复动作矛盾"
return True, ""这是并行隔离带来的额外红利:你可以在多个答案之间做一致性检查,而不用担心它们互相"抄"。在单 prompt 的 LLM 方案里,这种检查毫无意义,因为答案是同一个上下文生成的,天然自洽。
4.4.4 ROS 2 节点集成
# jev_decider_node.py
import rclpy
from rclpy.node import Node
from std_msgs.msg import String
from atexit import register

class JevDeciderNode(Node):
    def __init__(self):
        super().__init__("jev_decider")
        self.layer  = JevDecisionLayer()
        self.bands  = derive_bands(CostMatrix())
        self.sub = self.create_subscription(String, "/task/failed", self.on_failed, 10)
        self.pub = self.create_publisher(String, "/task/decision", 10)
        self.get_logger().info("Jev decider up")

    def on_failed(self, msg: String):
        state = RobotFailureState.from_ros(msg).to_state()   # 见 3.1
        answers = self.layer.decide(state, build_questions(state))

        if answers is None or self.layer.degraded:
            # 网络不可用 → 端侧 4B 兜底,或直接保守升级
            self.pub.publish(String(data="escalate_human:degraded"))
            return

        ok, why = sanity_check(answers)
        if not ok:
            self.get_logger().warn("crosscheck failed: %s", why)
            self.pub.publish(String(data="escalate_human:crosscheck"))
            return

        decision = route(answers, self.bands)
        self.get_logger().info(
            "mode=%s(p=%.3f conf=%.3f) sev=%.2f -> %s",
            answers["failure_mode"].choice,
            answers["failure_mode"].probabilities[answers["failure_mode"].choice],
            answers["failure_mode"].confidence,
            answers["severity"].score,
            decision,
        )
        self.pub.publish(String(data=decision))
3.5 步骤五:降级路径(必做,不是可选项)
def decide_with_fallback(state, questions):
    ans = jev.decide(state, questions)
    if ans is None:
        # 端侧 4B 量化模型 + grammar 约束解码,只输出 failure_mode 枚举
        local = local_model.classify(state, allowed=list(FAILURE_MODES))
        # 端侧模型置信度未校准 → 一律按"需人工复核"处理,不允许自动执行
        return f"review:{local.label}"
return route(ans, bands)原则:降级路径产出的结果一律不允许自动执行,只进复核队列。因为端侧小模型的置信度是未校准的,拿它做自动决策等于把系统的安全边界交给一个不可信的数字。
4. 关键代码:一次完整调用的可运行骨架
# main.py —— 端到端最小闭环
import logging, os
from jev_client import JevDecisionLayer, DecisionBudget
from questions import build_questions
from router import CostMatrix, derive_bands, route
from crosscheck import sanity_check
from state_contract import RobotFailureState

logging.basicConfig(level=logging.INFO)

def decide_once(state: RobotFailureState) -> str:
    layer = JevDecisionLayer(DecisionBudget(timeout_s=1.2, max_retries=2))
    bands = derive_bands(CostMatrix(auto_wrong=120.0, ask_human=8.0, retry_wasted=3.0))

    s = state.to_state()
    answers = layer.decide(s, build_questions(s))
    if answers is None:
        return "escalate_human:api_unavailable"

    ok, why = sanity_check(answers)
    if not ok:
        return f"escalate_human:{why}"

    return route(answers, bands)

if __name__ == "__main__":
    demo = RobotFailureState(
        task_id="T-2041", task_goal="把桌上的马克杯放进洗碗机",
        failed_step="grasp", elapsed_ms=8400,
        detected_objects=[{"label": "mug", "conf": 0.91, "bbox_cx": 322, "bbox_cy": 241}],
        target_object="mug", depth_valid_ratio=0.62,
        gripper_force_peak_n=18.4, joint_torque_spike=None, slip_detected=True,
        ik_success=True, collision_flag=False, approach_axis="top",
        retry_count=1, last_failure_mode=None,
    )
    print(decide_once(demo))
    # 期望输出形如:auto:change_approach   (因为有 slip_detected=True)
5. 坑点(按被踩概率排序)
坑 1:把"零幻觉"理解成"答案正确"
[官方] 明说:0% 幻觉指的是 schema 匹配是构造性保证的(返回的一定是你定义的选项之一),不是经验意义上的准确率。Jev 完全可能高置信度地选错。
→ 对策:confidence 高 ≠ 对。必须保留人工标签回流与定期准确率评估。
坑 2:Choice 不给 other 选项
没有 other,模型被迫在 N 个错项里挑一个最接近的。[官方] 明确建议加显式 other。
→ 对策:other 是强制项,且路由里把 other 直接判为转人工。
坑 3:Score 的 level index 从 0 开始,且 score 会落在等级之间
score=1.035 是合法返回值,不是 bug。你写 if score >= 2 判断"较严重"时,1.035 会被正确排除,但如果你写成 int(score) == 1 就要小心边界。
→ 对策:阈值比较一律用浮点比较,不要用 int() 截断。
坑 4:Noul 没有 confidence 字段
很多同学习惯性写 answers["hardware_risk"].confidence → AttributeError。Noul 的 noul 值本身就是信念强度。
→ 对策:封装一层统一的 get_confidence(ans),Noul 返回 abs(noul - 0.5) * 2 作为替代置信度。
坑 5:state 塞太多,钱白花
点云、图像 base64、完整轨迹 → 几百美元/天打水漂,还会稀释有效信号。
→ 对策:3.1 的 state 契约 + 上线前做一次 token 审计:
def audit_tokens(state: dict) -> int:
    """用官方 usage 回读,别自己估"""
    resp = client.system_one(state=state, questions={"probe": Noul(instructions="state 非空")})
    return resp.usage.input_tokens
坑 6:阈值抄官方示例的 0.75 / 0.45
客服工单的错误代价和机器人撞机的错误代价差两个数量级。抄过来会让你在严重故障上也自动重试。
→ 对策:用 4.4.2 的代价矩阵自己算。改一个数字,全链路阈值自动跟着变。
坑 7:529 / 429 没做指数退避
[官方] 错误码:401 密钥错、422 校验失败、429 限流、529 过载。429 和 529 都可重试,但不做退避会把限流打成雪崩。
→ 对策:见 4.4.1 的 RETRYABLE + 2**attempt 退避。401/422 绝不重试(重试也是错)。
坑 8:把 Jev 塞进实时控制回路
见 2.3。云端 API 的 P99 抖动会直接变成机器人的抖动。
→ 对策:架构层面禁止 L2 及以下调用,代码层面加装饰器硬拦截。
坑 9:忘了做标签回流
阈值上线时是准的,半年后场景变了就不准了。
→ 对策:泳道图里 H3 → J4 那条线必须有 owner。人工接管的每一次标注都要进数据集,每周重跑一次阈值推导。
坑 10:没有 waitlist 就排期
Jev 目前是 waitlist 早期访问,无权重、无自托管。如果你的产品有"私有化部署"硬要求,现在排期会卡住。
→ 对策:架构上把决策层做成可替换接口(JevDecisionLayer / LocalDecisionLayer / LLMFallbackLayer 同签名),waitlist 没过就先上本地层。
6. 验证
6.1 延迟(怎么测,不是我替你测的数)
# bench_latency.py
import time, statistics
from collections import deque

def bench(n=500):
    lat = deque(maxlen=n)
    for _ in range(n):
        t0 = time.perf_counter()
        try:
            jev.decide(STATE_SAMPLE, QUESTIONS)
        except Exception:
            continue
        lat.append((time.perf_counter() - t0) * 1000)
    lat = sorted(lat)
    return {
        "n": len(lat),
        "p50": lat[len(lat)//2],
        "p95": lat[int(len(lat)*0.95)],
        "p99": lat[int(len(lat)*0.99)],
        "mean": statistics.mean(lat),
}验收门槛:P50 ≤ 800ms、P99 ≤ 2.5s(1.3 节)。
[推算] 若厂区 RTT P50 ≈ 25ms,则 API 侧 70–500ms + RTT → 端到端 95–525ms,P50 大概率落在 200–300ms。
注意:[官方] 的 70–500ms 是 API 侧口径,不含你的网络 RTT。别拿官方数当你的 P99。
6.2 置信度校准度(这个必须测,否则整套方案不成立)
Jev 的全部价值建立在"confidence 是可信的概率"。验证方法:可靠性图 + ECE。
# calibration.py
import numpy as np

def expected_calibration_error(samples, bins=10):
    """samples: [(confidence: float, is_correct: bool), ...]"""
    conf = np.array([s[0] for s in samples])
    corr = np.array([float(s[1]) for s in samples], dtype=float)
    ece, edges = 0.0, np.linspace(0, 1, bins + 1)
    for i in range(bins):
        m = (conf > edges[i]) & (conf <= edges[i+1])
        if m.sum() == 0:
            continue
        ece += m.sum() / len(conf) * abs(corr[m].mean() - conf[m].mean())
return ece验收门槛:ECE ≤ 0.10。
如果 ECE > 0.15:说明在你这个场景上置信度不可信,此时不要按 confidence 自动路由,退回"全部进复核队列"模式,直到积累足够标注数据重标定。
对照组要一起测:同样跑一遍端侧 4B 小模型的 ECE。我预期会看到明显差距——这正是 Jev 的核心卖点,也是你要在文章/汇报里拿出去的那张图。
6.3 成本
# 从 usage 回读,别估算
total_in = sum(r.usage.input_tokens for r in all_responses)
cost_usd = total_in * 0.042 / 1_000_000        # 输出免费,不计
print(f"{len(all_responses)} calls, {total_in} tok, ${cost_usd:.6f}")验收门槛:单步 ≤ $0.0002。
6.4 A/B 对照(对照基准必须写明)
组 | 方案 | 样本 | 归因准确率 | P50 延迟 | 解析失败 | 单步成本 |
|---|---|---|---|---|---|---|
A | LLM + JSON mode + 重试 | ≥300 次真实失败 |
|
|
|
|
B | Jev | 同分布 ≥300 次 |
|
| 0 |
|
对照基准必须声明:[官方] TypeSafe 的 benchmark 以 GPT-6 Astra 与 Claude Fable 5.1 输出的平均值作为参考答案,且 eval 由 TypeSafe 团队自己编写。你自己的 A/B 要用你们运维的人工标注作 ground truth,否则不可比。
7. 常见问题
Q1:Jev 能替代我们的 VLA 模型吗?
不能,也不该。VLA 输出连续动作,Jev 输出离散决策。它们是 L2 与 L4 的关系,不是替代关系。
Q2:输出真的完全免费吗?
[官方] 是。原因是输出体积极小(一个枚举 + 几个浮点数),不是几千 token 的文本。
Q3:能私有化部署吗?
目前不能。无权重、无参数量、无自托管。有合规要求的场景先把接口抽象出来,用本地层顶上。
Q4:255 个选项真的都能用吗?
[官方] Choice 支持到 255。但选项越多,每个选项分到的注意力越薄,且每个选项消耗几个 token。实际建议 5~15 个,超过 30 个就该先做一层粗分。
Q5:能让它做多步推理吗?
不能,这是设计使然。问题之间是隔离的,不存在链式推理。需要"先 A 再 B"的逻辑,请在你的代码里编排,别指望模型。
Q6:为什么我的 confidence 一直很低?
通常是两个原因:(1) criteria 描述有重叠("技术问题"和"bug"会分不掉);(2) 少了 other,模型在两个都不合适的选项间摇摆。先检查这两条。
Q7:和"约束解码 / grammar-based generation"有什么区别?
约束解码保证输出格式合法;Jev 额外保证输出概率是校准过的。前者解决"能不能解析",后者解决"能不能信"。这是本质差异。
Q8:网络抖动会不会让机器人卡住?
不会,前提是 3.5 的降级路径做了。超时预算 1.2s,超时即转保守路径,绝不阻塞主任务线程。
Q9:已有的失败日志能直接用吗?
可以做冷启动评测,但注意分布漂移——历史日志里的失败模式和换新传感器后的失败模式不一样。用历史数据做回归测试,用新数据做阈值标定。
Q10:值不值得现在就上?
取决于你的错误代价结构。如果你的场景是"分错类无所谓,重试很便宜",那 LLM 也够用;如果是"自动重试一次可能撞坏设备",Jev 的校准置信度是刚需。先填 CostMatrix 那三个数字,再决定。
8. 结论
- Jev 解决的是"能不能信",不只是"快不快"。193x 提速、444x 降价是官方自测数、未复现,真正稳定的收益是结构化输出 0 解析错误和可用的校准置信度。
- 它只该进 L4(秒级任务层),不该进 L2 及以下。云端 API 的 P99 抖动是硬约束,架构上就要拦死。
- 阈值不许拍脑袋。用代价矩阵从三个真实的钱数反推(本文默认参数下:自动 0.933 / 复核 0.625),比抄官方示例的 0.75/0.45 保守得多,因为机器人撞一次的代价是客服工单的十几倍。
- 校准度要自己测。ECE > 0.15 就别自动路由。Jev 的价值建立在置信度可信这个前提上,这个前提必须验证,不能假设。
- 降级路径是必选项不是加分项。waitlist 没过、网络断了、529 了,系统都得继续跑——降级路径产出的结果一律不允许自动执行。
- 把决策层做成可替换接口。Jev 现在无自托管、无权重,架构上留好
LocalDecisionLayer / LLMFallbackLayer的同签名实现,是今天唯一正确的工程决策。
附录 A:BOM 表
A.1 硬件
类别 | 型号/规格 | 数量 | 单价(参考) | 小计 | 用途 |
|---|---|---|---|---|---|
端侧主控 | NVIDIA Jetson Orin Nano Super Dev Kit (8GB / 67 TOPS) | 1 | ¥1,900 | ¥1,900 | VLA 推理、状态采集 |
深度相机 | Intel RealSense D455 | 1 | ¥2,800 | ¥2,800 | 目标位姿、深度有效率 |
腕部相机 | 全局快门 USB3 相机 640×480@60fps | 1 | ¥600 | ¥600 | 接触状态判断 |
机械臂 | 6-DOF,力控分辨率 ≥0.1N | 1 | ¥35,000 | ¥35,000 | 执行本体 |
末端夹爪 | 二指自适应,带力/滑移检测 | 1 | ¥6,500 | ¥6,500 | 力觉证据来源 |
上行链路 | 5G CPE(厂区)/ Wi-Fi 6 | 1 | ¥1,200 | ¥1,200 | Jev API 硬依赖 |
工控机 | x86,16GB RAM(编排器 + 兜底模型) | 1 | ¥5,000 | ¥5,000 | ROS 2 编排、端侧 4B 兜底 |
硬件合计 | ¥53,000 |
价格为公开渠道参考价,以实际采购为准。机械臂可按现有本体替换,此项可归零。
A.2 软件与服务
项目 | 说明 | 成本 |
|---|---|---|
| Python 3.10+, | 免费(SDK) |
Jev API | 输入 $0.042/MTok,输出免费 |
|
端侧兜底模型 | Qwen3-4B-Int4 或同级,本地部署 | 硬件摊销 |
ROS 2 Humble | 开源 | 免费 |
人工接管台 | 复用现有运维工单系统 | 现有 |
A.3 单步成本对比(5000 次/天)
方案 | 单步成本 | 月成本 |
|---|---|---|
LLM + JSON mode |
| ≈ $2,100 |
Jev |
| ≈ $3.8 |
端侧小模型(兜底) | ≈ $0(硬件摊销) | ≈ $0 |
附录 B:参考与术语
官方资源
- 控制台与 Playground:
console.typesafe.ai(Playground 可先不写代码直接试问题) - API Key:
console.typesafe.ai/settings/keys,也可走 Vercel AI Gateway - Primitives 文档:
docs.typesafe.ai/primitives - Eval traces:
evals.typesafe.ai - 端点:
POST https://api.typesafe.ai/v1/systemone
术语
术语 | 含义 |
|---|---|
System One Model | TypeSafe 对 Jev 品类的命名,借自卡尼曼"快思考" |
RLCD | Reinforcement Learning for Calibrated Decisions,对标 RLHF 的训练方法 |
Mode dropping | 模型忽略冷门但正确答案的倾向,RLHF 的已知副作用 |
Noul | Jev 的布尔原语,返回 0~1 概率,无独立 confidence |
ECE | Expected Calibration Error,置信度校准度指标 |
泳道图 | 本文 3.3 节的多角色时序图 |
本文引用的公开第三方实践(截至 2026-09-22)
- Vercel CEO Guillermo Rauch:命令安全场景,p95 比 GPT Luna 快最高 18x,最终复核仍跑 Luna
- Bryo AI CTO Nikhil Mudholkar:邮件分类,Gemini 略准但贵 10–20x
- Browser Use
jev-ultrafast:Zürich→London 航班搜索 7.1 秒 - Droidrun
mobile-jev:真机 Android 操作 Uber,9 动作约 21 秒 jev-guard:Agent 护栏,工具调用评 deny/ask/allowpg-jev:为 Postgres 加自然语言过滤
本文所有 [官方] 数据来自 TypeSafe AI 公开资料,未经第三方复现;[推算] 为基于公开架构信息的估算;[实测] 需按第 6 节方法自行验证后填入。涉及成本与收益的判断不构成投资建议。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号