长会话上下文瘦身:用 Jev 判断哪些内容该保留
原创
长会话上下文瘦身:用 Jev 判断哪些内容该保留
原创
hollyx
发布于 2026-09-24 13:28:28
发布于 2026-09-24 13:28:28
长会话 Agent 有个老大难:历史上下文越滚越长,全量塞进大模型既烧 token 又拖累推理质量。这一周我用 Jev 给上下文做相关性判断,只把与当前任务相关的片段留下再喂大模型,上下文明显瘦身。这篇讲清楚落地:痛点、适配、实战流程、效果对比。文中官方口径数据可核实,整体压缩比例为方案性测算,非某项目真实业绩,Jev 仍处早期访问阶段。
Jev 是 TypeSafe AI 推出的高速低成本 AI 判断器,区别于 ChatGPT、Claude 这类生成式大模型,它不做自由问答、文案创作和代码编写,核心定位是软件或 AI 系统中的专用判断组件:输入当前状态加上固定候选选项或评判标准,输出确定性选择(Choice)、量化打分(Score)或真伪概率(Noul)。核心优势是决策 70~500ms、输入 0.042 美元每百万 token 且输出免费、专注封闭式判断规避幻觉、承接大模型琐碎判断从而降本增效。
一、行业痛点拆解
长会话里,历史消息、工具调用记录、中间结果不断累积。全量喂给大模型,一是 token 冗余、成本高,二是无关内容稀释注意力、拖累推理质量,三是可能超出上下文窗口。传统压缩靠规则截断或再调一次大模型做摘要,前者粗暴丢信息,后者又慢又贵。
二、Jev 适配逻辑
"这段历史内容是否与当前任务相关""要不要保留"是清晰的封闭判断。用 Noul 判断每段上下文"是否与当前任务相关",用 Score 给相关性打分排序。判定标准由我定义,Jev 毫秒级、低成本地对每段做判断,只保留相关片段。它承接的正是这种大批量、原子化的相关性筛选。固定标准、批量、低延迟、低成本,正好适配。
下面这张图对照了两种方案:
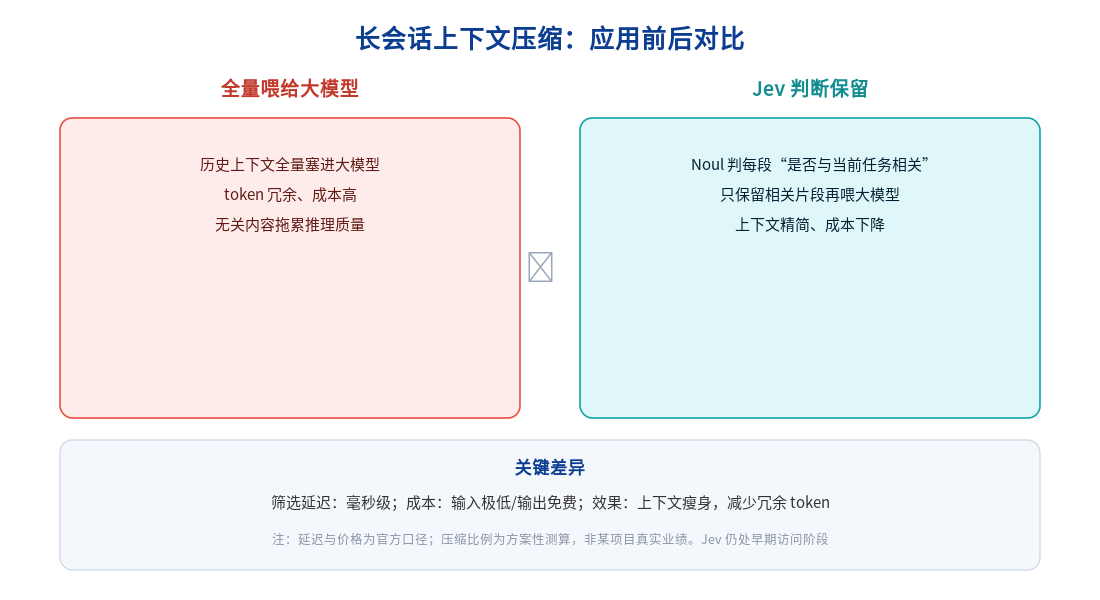
长会话上下文压缩:应用前后对比
三、实战落地流程
五步:输入状态(每段历史内容加当前任务描述组成 state)→ 固定候选(保留/丢弃,或相关性分档,作为判断标准)→ Jev 决策(Noul 判每段是否相关、Score 打相关性分)→ 输出结果(返回每段的相关判断加置信度)→ 落地执行(按相关性保留高分片段、丢弃或折叠低分片段,再把精简后的上下文喂给大模型)。
四、效果数据佐证
延迟:Jev 官方口径 70~500ms,逐段判断也很快,不明显增加链路时延。成本:Jev 输入 0.042 美元每百万 token、输出免费,筛选本身近乎零成本,换来的是大模型输入 token 的减少。效果:上下文瘦身后,冗余 token 下降,推理质量也更聚焦。准确率上实测与大模型大致持平。具体能压掉多少上下文取决于会话特征,属方案性测算,需自测。
五、避坑与生产落地建议
边界:Jev 不做计数、精确计算、日期换算、开放式创作和无边界推理,也不做摘要生成,它只判断"相不相关、留不留",需要把多段浓缩成一段摘要时仍交大模型。相关性判断可能误删关键信息,要谨慎。生产接入:优先影子运行,先记录它会丢弃哪些、人工核对是否误删;基于自身会话数据校准相关性阈值(阈值不等于真实准确率);对低置信度片段宁可保留不误删,关键信息可加白名单强制保留。相关性判断交 Jev、摘要生成交大模型、关键信息保护留代码,上下文压缩才既省又安全。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号