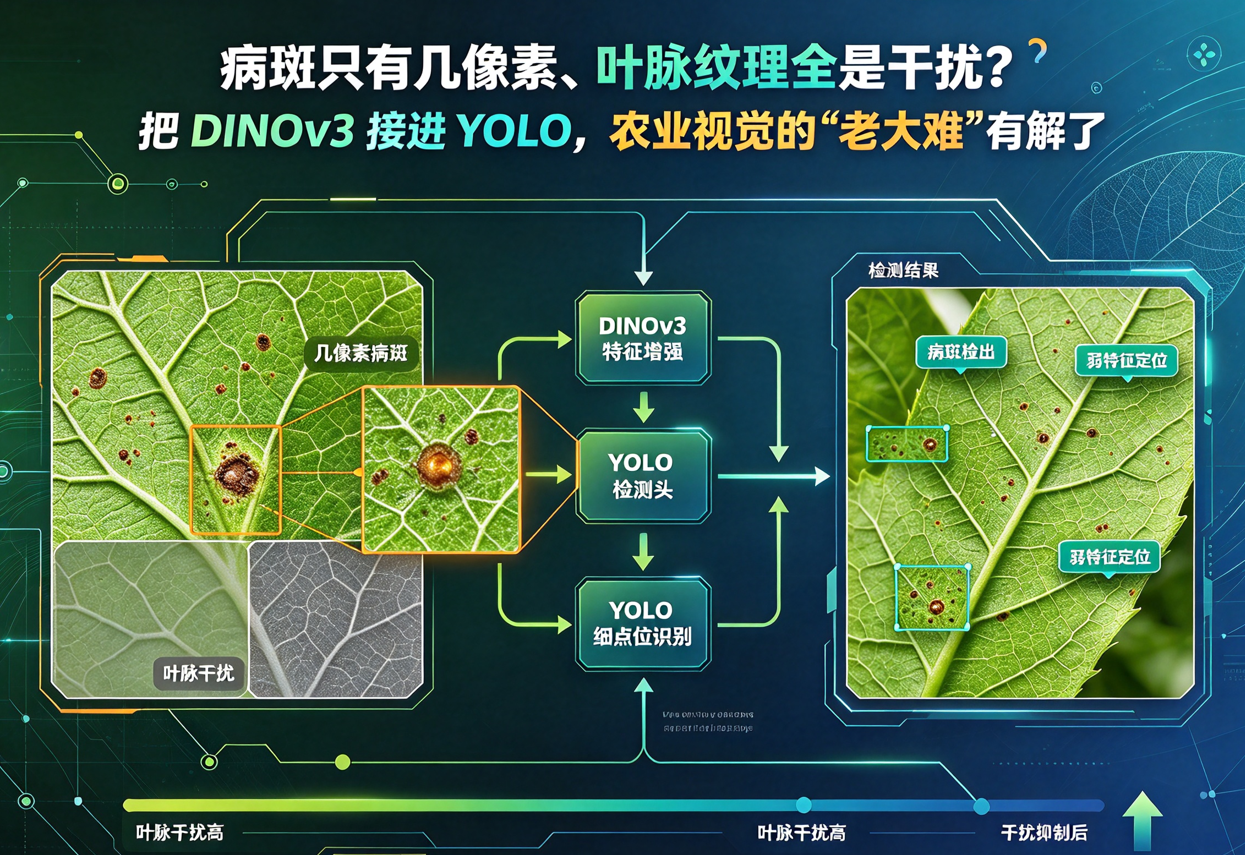
病斑只有几像素、叶脉纹理全是干扰?把 DINOv3 接进 YOLO,农业视觉的“老大难“有解了
原创
病斑只有几像素、叶脉纹理全是干扰?把 DINOv3 接进 YOLO,农业视觉的“老大难“有解了
原创
AI小怪兽
发布于 2026-10-16 14:04:04
发布于 2026-10-16 14:04:04
病斑只有几像素、叶脉纹理全是干扰?把 DINOv3 接进 YOLO,农业视觉的"老大难"有解了
农业 AI 圈有个心照不宣的现实:模型在公开榜单上跑得欢,一到田间地头就"犯迷糊"。早期的稻瘟病斑只有几个像素,混在叶脉纹理里肉眼都难分辨;玉米去雄后残留的雄穗夹在植株间,无人机拍下来豆大一点;再叠加光照变化、水田反光、杂草遮挡,"复杂背景"的干扰一环扣一环。
这类任务的共同难点在于:CNN 的归纳偏置(局部性 + 平移等变)在低对比、弱纹理、小尺度下容易失效;而农业标注数据往往只有几百到几千张,从头训练一个大模型并不现实。
一个更划算的思路是:借一个已经在亿级无标注图片上学过"什么是物体、什么是边界"的视觉基座,把它当成一个冻结的特征提供者,接进 YOLO 的骨干里。本文的主角,就是 Meta 的 DINOv3。
01 | 为什么是 DINOv3,而不是别的"大模型"
DINOv3 是 Meta 在 2025 年 8 月发布的自监督视觉基座模型(DINO 系列第三代)。与需要人工标注的分类预训练不同,它在 LVD-1689M(16.89 亿张无标注图片)上做自蒸馏训练,核心目标是产出高质量的密集特征(dense features)——每个 patch 位置都有语义清晰、可直接用于检测/分割的向量。
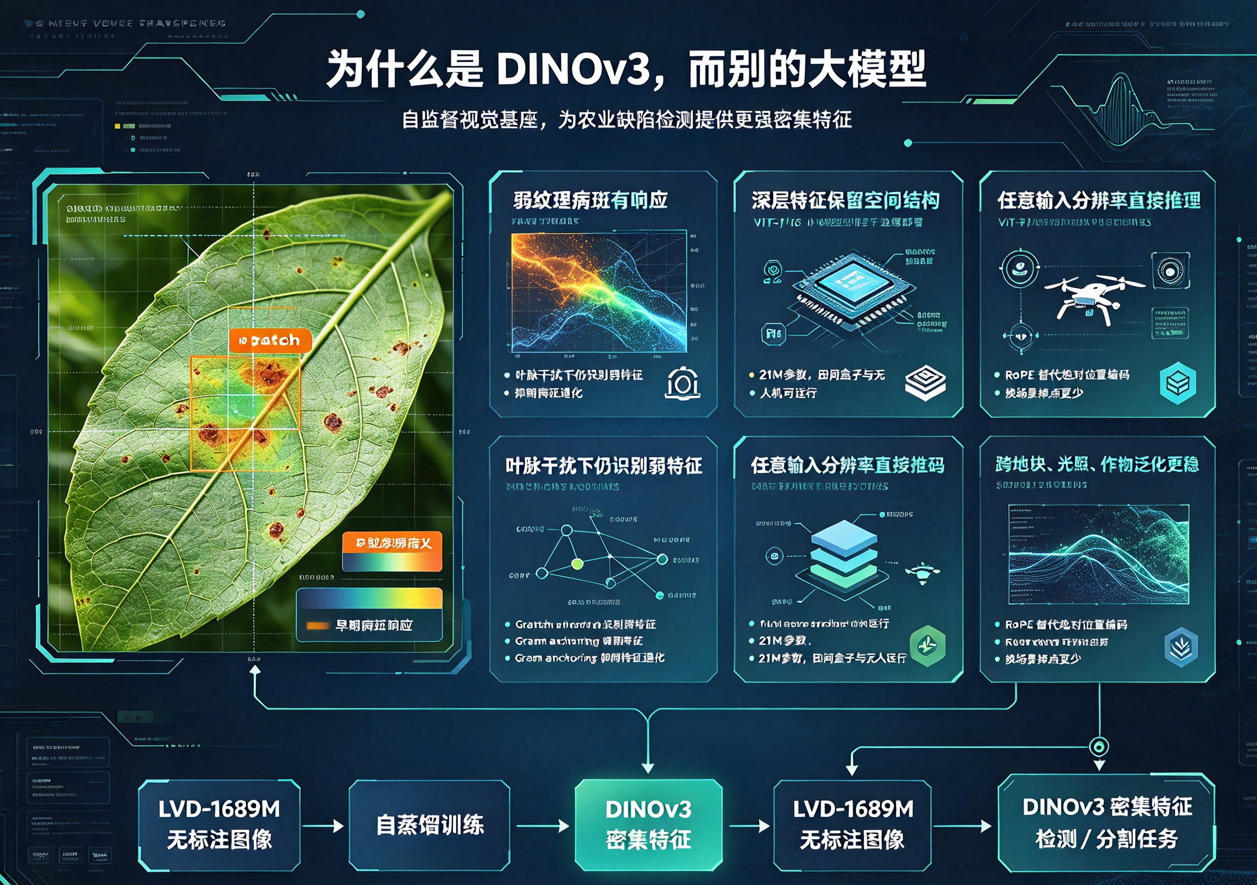
几个对农业检测关键的特性:
- patch 级特征自带边界语义。弱纹理、低对比的早期病斑也有响应,这正是"病斑混在叶脉里"的场景最需要的;
- Gram anchoring 抑制长训练下的密集特征退化,深层特征仍保留空间结构,上采样后依然有定位能力;
- 官方蒸馏出 ViT-S/16 小模型(21M 参数),边缘部署成为可能——田间盒子、无人机、手机都跑得动;
- 无绝对位置编码(RoPE),640/1280 任意输入分辨率直接跑,不需要插值位置编码;
- 跨域泛化强,换地块、换光照、换作物时掉点更少——农业场景最吃这一点。
有人会问:为什么不直接用 CLIP?核心区别在特征粒度。CLIP 类弱监督模型强调图文对齐的全局语义,密集特征偏弱;而检测任务要回答的是"这张图里哪个位置有东西"——密集特征才是关键。这也是选 DINOv3 而非 CLIP 的原因。
代价也要说清楚:ViT 算力与 token 数成二次关系,vits16 在 640×640 上约 8~10 GFLOPs;权重需向 Meta 官网申请下载;部分国产 NPU 对注意力、RoPE 等算子支持度一般,导出后务必实测。这些在后文都有对应的"减负开关"。
02 | 融合方案:并行不替换,yaml 几行搞定
伪代码如下:
# =============================================================================
#  dino_yolo_agri.py
# -----------------------------------------------------------------------------
#  DINOv3 + YOLO 农业病害检测 伪代码骨架
#
#  解决的问题:
#    1) 病斑只有几像素  → ViT 的高分辨率 patch token + P2 检测头 + 滑窗切片推理
#    2) 叶脉纹理全是干扰 → DINOv3 自监督语义先验 + CLS-attention 显著性门控
#    3) CNN 主干感受野固定,对"语义异常"不敏感 → 换 DINOv3 做 backbone
#
#  本文件是"伪代码":所有 nn.Module 的结构/形状/数据流都是真实可跑的,
#  但 DINOv3 权重加载、YOLO 的 loss/decode/NMS 用占位函数表示,
#  实际落地时替换为 timm/transformers + ultralytics 即可。
# =============================================================================

import torch
import torch.nn as nn
import torch.nn.functional as F
from dataclasses import dataclass


# =============================================================================
# 0. 配置
# =============================================================================
@dataclass
class Config:
    img_size: int = 640          # 训练输入尺寸
    patch: int = 16              # DINOv3 patch 大小
    vit_dim: int = 1024          # DINOv3 特征维度 (ViT-L 量级)
    num_classes: int = 1         # 病害类别数
    reg_max: int = 16            # DFL 分箱数
    lambda_sal: float = 0.1      # 显著性辅助损失权重
    small_ratio_thr: float = 0.005   # "病斑像素占比 < 0.5%" 视为小目标样本
    tile: int = 640              # 推理滑窗尺寸
    overlap: int = 64            # 滑窗重叠
    conf_thr: float = 0.25
    iou_thr: float = 0.6


# =============================================================================
# 1. DINOv3 主干 (占位)
# -----------------------------------------------------------------------------
#  真实实现:
#     from transformers import AutoModel
#     self.vit = AutoModel.from_pretrained("facebook/dinov3-vitl16-pretrain-lvd1689m")
#  这里用随机张量模拟其输出契约:
#     tokens: (B, N, C)   N = (H/P) * (W/P)   最后一层 patch token
#     attn:   (B, N)     CLS → 每个 patch 的注意力 (已 softmax)
# =============================================================================
class DINOv3Backbone(nn.Module):
    def __init__(self, dim: int = 1024, patch: int = 16, depth: int = 24):
        super().__init__()
        self.patch = patch
        self.dim = dim
        self.depth = depth
        # 真实实现中这里是 24 层 ViT Block
        self.blocks = nn.ModuleList([nn.Identity() for _ in range(depth)])

    def forward(self, x: torch.Tensor, return_attn: bool = True):
        B, _, H, W = x.shape
        hp, wp = H // self.patch, W // self.patch
        N = hp * wp
        # —— 占位输出 ——
        tokens = torch.randn(B, N, self.dim, device=x.device)
        attn = torch.rand(B, N, device=x.device)
        attn = attn / attn.sum(dim=-1, keepdim=True)
        return tokens, (attn if return_attn else None)


# =============================================================================
# 2. ViT → 多尺度适配器 (ViTDet / SimpleFPN 风格)
# -----------------------------------------------------------------------------
#  ViT 只有单尺度 (stride = patch = 16),YOLO 需要 P2~P5 多尺度金字塔。
#  这里用 1x1 投影 + 反卷积/步长卷积生成四个尺度:
#     P2: stride 4   ← 小病斑的关键层
#     P3: stride 8
#     P4: stride 16  ← 与 ViT 原生尺度一致
#     P5: stride 32
# =============================================================================
class ViTAdapter(nn.Module):
    def __init__(self, in_dim: int = 1024,
                 out_channels=(96, 192, 384, 768),
                 patch: int = 16):
        super().__init__()
        self.patch = patch
        self.out_channels = out_channels

        c2, c3, c4, c5 = out_channels
        # 原生尺度 P4
        self.proj = nn.Conv2d(in_dim, c4, kernel_size=1)
        # 上采到 P3 / P2
        self.up_p4_to_p3 = nn.ConvTranspose2d(c4, c3, 2, 2)
        self.up_p3_to_p2 = nn.ConvTranspose2d(c3, c2, 2, 2)
        # 下采到 P5
        self.down_p4_to_p5 = nn.Conv2d(c4, c5, kernel_size=3, stride=2, padding=1)

        # 每层加一个 3x3 平滑,减轻反卷积棋盘效应
        self.smooth = nn.ModuleList([
            nn.Conv2d(c, c, 3, 1, 1) for c in out_channels
        ])

    def forward(self, tokens: torch.Tensor, H: int, W: int):
        B, N, C = tokens.shape
        hp, wp = H // self.patch, W // self.patch
        x = tokens.transpose(1, 2).reshape(B, C, hp, wp)   # (B,C,hp,wp)

        p4 = self.proj(x)
        p3 = self.up_p4_to_p3(p4)
        p2 = self.up_p3_to_p2(p3)
        p5 = self.down_p4_to_p5(p4)

        feats = [p2, p3, p4, p5]
        feats = [self.smooth[i](f) for i, f in enumerate(feats)]
        return feats


# =============================================================================
# 3. 显著性门控 (核心创新点)
# -----------------------------------------------------------------------------
#  动机:叶脉纹理在 DINOv3 的 CLS-attention 上是"低显著性"的,
#        病斑是"语义异常" → 高显著性。
#  做法:把 patch 级 attention 上采到特征图分辨率,
#        作为空间门控乘到颈部特征上;再叠加一个通道注意力。
#  效果:叶脉响应被压低,病斑响应被保留/放大。
# =============================================================================
class SaliencyGate(nn.Module):
    def __init__(self, channels: int, patch: int = 16):
        super().__init__()
        self.patch = patch
        self.channel_reduce = nn.Conv2d(channels, 1, kernel_size=1)

    def forward(self, feat: torch.Tensor, dino_attn: torch.Tensor,
                H: int, W: int) -> torch.Tensor:
        B, C, h, w = feat.shape
        hp, wp = H // self.patch, W // self.patch

        # patch attention → 特征图尺寸的显著性图
        attn = dino_attn.reshape(B, 1, hp, wp)
        attn = F.interpolate(attn, size=(h, w), mode="bilinear",
                             align_corners=False)
        # 归一化到 [0,1],避免 attention 尺度漂移
        attn = attn / (attn.amax(dim=(2, 3), keepdim=True) + 1e-6)
        attn = torch.sigmoid(attn * 4.0 - 2.0)     # 锐化:>均值放大,<均值压低

        # 通道注意力
        ca = torch.sigmoid(self.channel_reduce(feat))

        # 残差式门控:即使门控为 0 也保留 50% 原始响应,防止梯度消失
        return feat * (0.5 + attn) * (0.5 + ca)


# =============================================================================
# 4. YOLO 检测头 (P2~P5 四尺度)
# =============================================================================
class YOLOHead(nn.Module):
    def __init__(self, in_channels=(96, 192, 384, 768),
                 num_classes: int = 1, reg_max: int = 16):
        super().__init__()
        self.num_classes = num_classes
        self.reg_max = reg_max
        self.stems = nn.ModuleList(
            [nn.Conv2d(c, 128, 3, 1, 1) for c in in_channels]
        )
        self.cls_branch = nn.ModuleList(
            [nn.Conv2d(128, num_classes, 1) for _ in in_channels]
        )
        self.reg_branch = nn.ModuleList(
            [nn.Conv2d(128, 4 * reg_max, 1) for _ in in_channels]
        )

    def forward(self, feats):
        outs = []
        for i, f in enumerate(feats):
            s = self.stems[i](f)
            outs.append((self.cls_branch[i](s), self.reg_branch[i](s)))
        return outs


# =============================================================================
# 5. 完整模型
# =============================================================================
class DINOv3YOLO(nn.Module):
    def __init__(self, cfg: Config):
        super().__init__()
        self.cfg = cfg
        self.backbone = DINOv3Backbone(dim=cfg.vit_dim, patch=cfg.patch)
        self.adapter = ViTAdapter(in_dim=cfg.vit_dim, patch=cfg.patch)
        # 只对 P2 做门控:小病斑最需要压制叶脉干扰
        self.gate = SaliencyGate(channels=96, patch=cfg.patch)
        self.head = YOLOHead(num_classes=cfg.num_classes, reg_max=cfg.reg_max)

    def forward(self, x: torch.Tensor):
        B, _, H, W = x.shape

        # 1) DINOv3 提取语义 token + CLS-attention
        tokens, attn = self.backbone(x, return_attn=True)

        # 2) 单尺度 → 多尺度金字塔
        feats = self.adapter(tokens, H, W)         # [P2,P3,P4,P5]

        # 3) 显著性门控(只作用于 P2)
        feats[0] = self.gate(feats[0], attn, H, W)

        # 4) 检测头
        preds = self.head(feats)
        return preds, feats, attn


# =============================================================================
# 6. 损失函数
# =============================================================================
def yolo_loss(preds, targets, cfg: Config):
    """占位:真实实现用 ultralytics 的 v8DetectionLoss(分类 BCE + CIoU + DFL)。"""
    loss = 0.0
    for cls_logit, reg_pred in preds:
        loss = loss + cls_logit.mean() + reg_pred.mean()
    return loss * 0.0 + torch.tensor(0.0, requires_grad=True)


def saliency_loss(attn: torch.Tensor, lesion_mask: torch.Tensor) -> torch.Tensor:
    """
    显著性辅助损失:
      让 DINOv3 的 CLS-attention 与 GT 病斑 mask 对齐。
      直觉:模型必须学会"病斑在哪",叶脉自然被推到低注意力区。
    """
    B, N = attn.shape
    hp = wp = int(N ** 0.5)          # 假设方形 patch 网格
    pred = attn.reshape(B, 1, hp, wp)
    gt = F.interpolate(lesion_mask.float(), size=(hp, wp), mode="area")
    pred = pred.clamp(1e-4, 1 - 1e-4)
    return F.binary_cross_entropy(pred, gt)


def compute_loss(preds, targets, attn, cfg: Config):
    loss_det = yolo_loss(preds, targets, cfg)
    loss_sal = saliency_loss(attn, targets["lesion_mask"])
    return loss_det + cfg.lambda_sal * loss_sal


# =============================================================================
# 7. 训练
# =============================================================================
def train_one_epoch(model, loader, optimizer, device, cfg: Config):
    model.train()
    total = 0.0

    for imgs, targets in loader:
        imgs = imgs.to(device)
        targets = {k: (v.to(device) if torch.is_tensor(v) else v)
                   for k, v in targets.items()}

        # --- 小目标增强:病斑像素占比过低时,放大输入,等效于"放大病斑" ---
        if targets["lesion_ratio"].mean() < cfg.small_ratio_thr:
            imgs = F.interpolate(imgs, scale_factor=1.5,
                                 mode="bilinear", align_corners=False)
            targets["lesion_mask"] = F.interpolate(
                targets["lesion_mask"], scale_factor=1.5,
                mode="nearest"
            )
            # 注意:boxes 也要同步缩放(此处略)

        preds, feats, attn = model(imgs)
        loss = compute_loss(preds, targets, attn, cfg)

        optimizer.zero_grad()
        loss.backward()
        torch.nn.utils.clip_grad_norm_(model.parameters(), 10.0)
        optimizer.step()

        total += loss.item()
    return total / max(len(loader), 1)


def build_optimizer(model, lr_backbone=1e-5, lr_head=1e-3):
    """ViT 主干用极小 lr(避免破坏自监督语义),检测头用大 lr。"""
    backbone_params, other_params = [], []
    for n, p in model.named_parameters():
        (backbone_params if n.startswith("backbone.") else other_params).append(p)
    return torch.optim.AdamW([
        {"params": backbone_params, "lr": lr_backbone},
        {"params": other_params,    "lr": lr_head},
    ], weight_decay=0.05)


# =============================================================================
# 8. 推理:滑窗 + 跨窗 NMS
# -----------------------------------------------------------------------------
#  为什么必须滑窗?
#    4000x3000 的原图直接 resize 到 640,几像素病斑会缩到 0.1 像素,
#    信息被彻底抹掉。滑窗保持原始像素尺度,让病斑"活着"进入网络。
# =============================================================================
def decode_yolo(preds, conf_thr: float):
    """占位:把 head 输出解码成 (boxes[N,4], scores[N])。"""
    boxes = torch.tensor([[10., 10., 30., 30.]])
    scores = torch.tensor([0.9])
    return boxes, scores


def nms(boxes: torch.Tensor, scores: torch.Tensor, iou_thr: float = 0.6):
    """占位:真实实现用 torchvision.ops.nms。"""
    if boxes.numel() == 0:
        return torch.empty(0, dtype=torch.long)
    return torch.arange(boxes.shape[0])


@torch.no_grad()
def predict(model, img: torch.Tensor, cfg: Config):
    model.eval()
    B, C, H, W = img.shape
    step = cfg.tile - cfg.overlap

    all_boxes, all_scores = [], []

    for y in range(0, H, step):
        for x in range(0, W, step):
            patch = img[:, :, y:y + cfg.tile, x:x + cfg.tile]
            ph, pw = patch.shape[-2:]
            if ph < cfg.tile or pw < cfg.tile:
                patch = F.pad(patch, (0, cfg.tile - pw, 0, cfg.tile - ph))

            preds, _, _ = model(patch)
            boxes, scores = decode_yolo(preds, cfg.conf_thr)

            # 坐标从"切片坐标系"平移回"原图坐标系"
            boxes[:, [0, 2]] += x
            boxes[:, [1, 3]] += y
            all_boxes.append(boxes)
            all_scores.append(scores)

    boxes = torch.cat(all_boxes, dim=0)
    scores = torch.cat(all_scores, dim=0)
    keep = nms(boxes, scores, cfg.iou_thr)
    return boxes[keep], scores[keep]


# =============================================================================
# 9. main —— 最小可跑 demo
# =============================================================================
def main():
    cfg = Config()
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

    model = DINOv3YOLO(cfg).to(device)

    # ---- 伪造一个 batch,验证前向 shape 是否通 ----
    imgs = torch.randn(2, 3, cfg.img_size, cfg.img_size).to(device)
    targets = {
        "lesion_mask": (torch.rand(2, 1, cfg.img_size, cfg.img_size) > 0.98).float(),
        "lesion_ratio": torch.tensor([0.002, 0.003]),   # 典型的"几像素病斑"
    }

    preds, feats, attn = model(imgs)
    print("[OK] P2 shape:", feats[0].shape)   # 期望 (2, 96, 160, 160)
    print("[OK] P3 shape:", feats[1].shape)   # 期望 (2, 192, 80, 80)
    print("[OK] P4 shape:", feats[2].shape)   # 期望 (2, 384, 40, 40)
    print("[OK] P5 shape:", feats[3].shape)   # 期望 (2, 768, 20, 20)
    print("[OK] attn shape:", attn.shape)     # 期望 (2, 1600)

    loss = compute_loss(preds, targets, attn, cfg)
    print("[OK] loss:", float(loss))

    # ---- 推理 demo ----
    boxes, scores = predict(model, imgs[:1], cfg)
    print("[OK] predict boxes:", boxes.shape, "scores:", scores.shape)


if __name__ == "__main__":
    main()


# =============================================================================
# 设计要点速记 (放正文里可当"为什么这样做"的答案)
# -----------------------------------------------------------------------------
# 1. 为什么 DINOv3 能扛叶脉干扰?
#    DINOv3 是自监督训练的 ViT,"叶脉纹理"是低层重复纹理,在高层语义
#    token 里被自然压缩;而"病斑"是与健康组织不同的语义异常 → 更突出。
#
# 2. 为什么还要 SaliencyGate?
#    ViT 的 attention 是全局的,直接接到 CNN 头上,病斑信号会被大量
#    叶脉 patch 稀释。用 CLS→patch attention 当"空间先验"做门控,
#    等于强行告诉网络"先看哪块",把小病斑的信噪比拉起来。
#
# 3. 为什么必须有 P2?
#    640 输入下 P3=stride8,一个 4px 病斑在 P3 上只剩 0.5 格;
#    stride4 的 P2 是它唯一能被 anchor-free head 采到的机会。
#
# 4. 为什么推理要滑窗?
#    resize 是"像素级信息湮灭",滑窗是"原始像素尺度采样"。
#    几像素病斑这个任务上,滑窗 + 跨窗 NMS 是硬性要求。
#
# 5. 为什么显著性损失权重只有 0.1?
#    它是"软先验"不是硬约束。权重太大 → 网络只学 attention 不学检测;
#    0.05~0.2 之间是典型的"引导而不绑架"区间。
# =============================================================================方案的核心是并行融合,而不是替换骨干:DINOv3 作为一条完全冻结的分支与原图并行,抽取中间层 patch token 后经轻量投影(1×1 卷积降通道 + 可选上采样 + 3×3 深度可分离卷积),注入骨干的 P4 或 P3+P4,Concat 后再用 1×1 卷积降回原通道数,后面的 neck 和检测头完全不动。
整套方案是 yaml 驱动的:不改代码、不破坏 ultralytics 原生训练/推理/导出链路,检测/分割/分类共用同一套接法。以 Dual P3+P4 为例,骨干部分的关键几行:
两种融合形态,对应农业上的不同打法:
形态 | 注入位置 | 特征来源 | 适用场景 | 新增可训练参数 |
|---|---|---|---|---|
Single P4 | 仅 P4(stride 16) | DINOv3 末层 block,语义强 | 目标偏中大、算力紧张;作为第一步验证 | 约 +0.05M |
Dual P3+P4 | P3(stride 8)+ P4 | P3 取浅层 block(细节强),P4 取末层(语义强) | 小目标/小缺陷为主、背景复杂 | 约 +0.09M |
Dual 方案中,P3 与 P4 的特征来自不同的 transformer block:浅层 block 保留更多空间细节,适合喂给高分辨率的 P3;深层 block 语义更强,喂给 P4。这是 Simple Feature Pyramid 的思路,代价几乎为零——ViT 本来就要跑完,只是多取一次中间输出。
参数账值得单独说:以 YOLO26n 为例,原始 2.57M 参数,接上 Dual 融合后总参数 24.26M,但 DINOv3 的 21.6M 是冻结参数,不进优化器、不占梯度显存;真正新增可训练的只有两个小投影头和两处融合卷积。冻结分支走 torch.no_grad() 前向,训练显存几乎不变。切换 Single/Dual/原始基线只需改 yaml,不写额外代码。
03 | 落到农田:三个数据集,三种打法
场景 | 数据集规模 | 类别 | 核心难点 | 推荐形态 |
|---|---|---|---|---|
水稻病害检测 | 1448 张 | 稻褐斑病、稻瘟病、白叶枯病(3 类) | 早期病斑微小,与叶脉、水田反光混淆 | Dual P3+P4 |
玉米雄蕊定位 | 244 张 | 残留雄穗(tas,1 类) | 小样本,田间植株遮挡、尺度变化大 | Single P4 起步,必要时上 Dual |
番石榴果实/叶片病害 | 9000 + 1125 + 1125 张 | 藻斑病、黑霉、果实/叶片健康、虫咬、果锈、疮痂、焦枯、黄叶病(9 类) | 类别多、形态细粒度,语义判别要求高 | Dual + vitb16 或 LoRA 微调 |
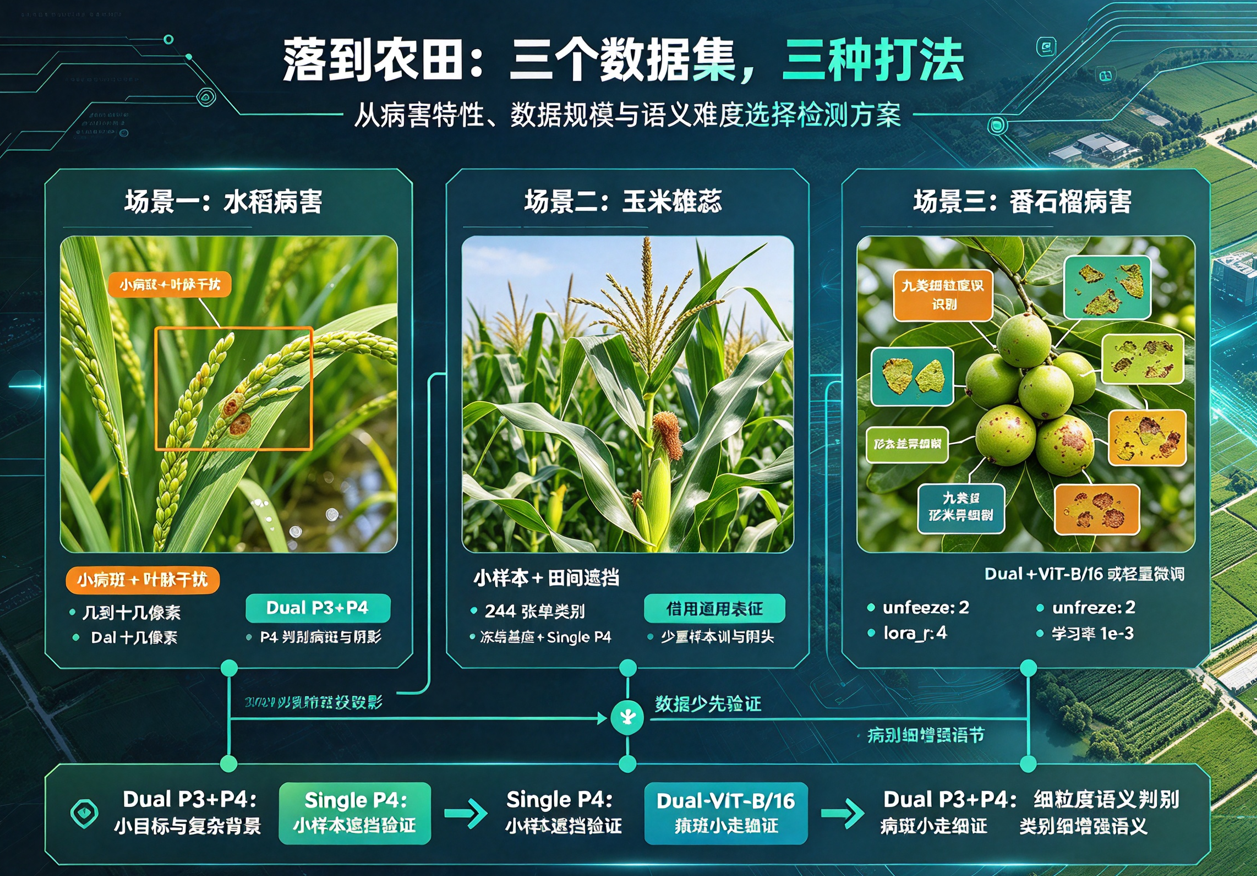
场景一:水稻病害——小病斑 + 叶脉干扰的典型考场。 早期病斑只有几到十几像素,混在叶脉纹理与水田反光里。这类"小目标 + 复杂背景"正是 Dual P3+P4 的主场:P3 的高分辨率分支直接拿到 ViT 的细节响应,专抓早期微病斑;P4 的深层语义负责判别"这是病斑还是叶脉阴影",抑制背景误检。
场景二:玉米雄蕊——小样本 + 田间遮挡。 玉米制种中,母本去雄后残留雄穗的识别是种子纯度保障的关键环节,但数据集只有 244 张、单类别——这恰恰是冻结基座方案的甜区:不从头训练大模型,借 DINOv3 学过的通用表征,只用几百张样本训投影头。田间遮挡严重、目标尺度变化大,建议先用 Single P4 验证特征有效性,再决定是否上 Dual。
场景三:番石榴病害——九类细粒度识别。 藻斑病、黑霉、果锈、疮痂、焦枯、黄叶病等九类病害,不少类别形态差异细微(比如果锈与疮痂都是表皮斑块),需要更强的语义判别。可以在 Dual 基础上换更大的 arch: vitb16,或对 DINOv3 开 unfreeze: 2 / lora_r: 4 做轻量微调,代价是显存上升、学习率需降到 1e-3 量级。
第三方公开实验也为这条路线提供了佐证:中山大学的 AD-DINOv3 在工业微小缺陷零样本异常检测上取得平均 AUROC 94.2%,其消融实验显示"多层特征融合比只用最后一层高约 1.2 个百分点";DEIMv2 则证明"DINOv3 冻结特征 + 轻量多尺度适配头"能在实时检测上跑到 SOTA。"多点、多尺度地把冻结特征接出去",与 Dual P3+P4 的思路同源。
04 | 上手路径:从数据到田间设备
环境就三件事:安装 ultralytics、克隆 Meta 官方 dinov3 仓库、把申请到的权重放进 weights/。工程结构中新增 ultralytics/nn/modules/dinov3.py 融合模块和 cfg/models/dinov3/ 下的 yaml 配置(YOLO26 / YOLO11 各四个,覆盖检测/分割/分类)。
训练时一个 --fusion 开关切换三种模式,同一脚本即可跑对照实验:
想确认"融合是否真的起作用",用可视化三件套:
--mode det:同一张复杂背景图,基线的误检框 vs 融合版结果,直观对比;--mode feat:原图 + DINOv3 P3/P4 响应热力图 + 融合后骨干特征热力图——典型现象是病斑区域在 CNN 特征里几乎无响应,而 DINOv3 特征上有明显激活;--mode attn:CLS token 注意力热力图,展示 ViT 已经"看"到了前景/病斑区域。
部署到田间的 checklist:导出 ONNX 时固定 imgsz、关闭 dynamic、opset 用 17+(RoPE 与 SDPA 需要较新算子);TensorRT FP16 建议 TRT ≥ 10.6,上线前用真实田间图对一遍数值。延迟不达标时,yaml 里改 depth: 8 + scale: 0.5,ViT 侧算力约降到 1/3。最终模型可部署到手机或无人机,实现田间秒级病害识别与严重程度评估,支撑早期精准干预、减少作物损失与农药滥用。
05 | 边界与展望
这不是一张"免费午餐"券,适用边界要说清楚:
- 如果数据里目标大、纹理清晰、标注充足,融合收益可能小于新增的 ViT 延迟,先用
benchmark.py量一遍延迟再投入训练; - 极度受限的 MCU / 老 NPU 上,ViT 算子支持度是主要风险,先导出验证再决定;
- 权重需要申请、算力成本真实存在,建议小步快跑:先 Single P4 验证,再 Dual 加码。
后续值得继续的方向:蒸馏更小的 ViT(参考 DEIMv2 从 DINOv3-S 蒸馏出 ViT-Tiny 的做法,可把 ViT 侧算力压到 1/5 以下);离线缓存 DINOv3 冻结特征,把训练速度拉回接近原版 YOLO;导出时 INT8 量化进一步压缩边缘延迟;系统对比 LoRA 与 unfreeze 的性价比,找出最小代价的最优配置。
从水稻病斑到玉米雄穗,从番石榴果园到更大的田野——把学过大千世界的视觉基座"冻"进田间的相机里,让每一棵作物都被更清楚地"看"见。这或许就是智慧农业该有的样子。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号