零样本时序预测:Mistral Timestral 本地实测
原创
零样本时序预测:Mistral Timestral 本地实测
原创
陈文茂
发布于 2026-10-16 20:21:59
发布于 2026-10-16 20:21:59
零样本时序预测,2 亿参数也能在本地毫秒级推理——Mistral 把时间序列基础模型的门槛拉到了前所未有的低。
4 个尺寸 | 21 个分位数 | 32K 上下文 | ≈20ms GPU 推理 |
|---|---|---|---|
5M~209M | 自带区间 | 历史步长 | 209M 实测 |
时间序列预测,一直是数据科学里既常见又难搞的问题——电力负荷、气象、水位、流量、传感器指标,到处都需要。传统做法要么针对每个数据集重新训练模型,要么在数据漂移时频繁微调,成本高、周期长。
Mistral 前几天开源了一个时间序列基础模型家族 Timestral:不做语言任务,专门读一串历史数字,预测它下一步往哪走,还自带不确定性区间。官方说最大的 2.09 亿参数版本,在三个主流基准上都排第一(预训练与零样本模型中)。
我第一时间把它部署到了本地,用真实的气象时序数据做了完整测试。这篇文章把模型介绍和实测结果一起给你。
01 模型概览
Timestral 是 Mistral 的第一个时间序列基础模型(TSFM),提供四个尺寸:500 万、2800 万、1.23 亿、2.09 亿参数。
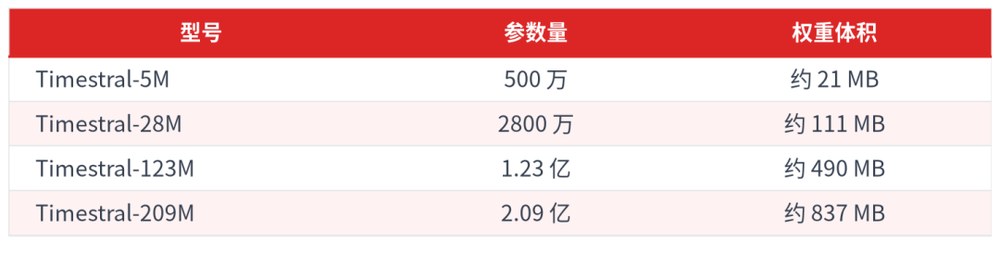
四个型号,权重最小仅 21 MB
它的核心定位是零样本预测:不用针对你的数据重新训练,直接给历史数据就能预测未来。和传统做法的区别,一张图就能看清:
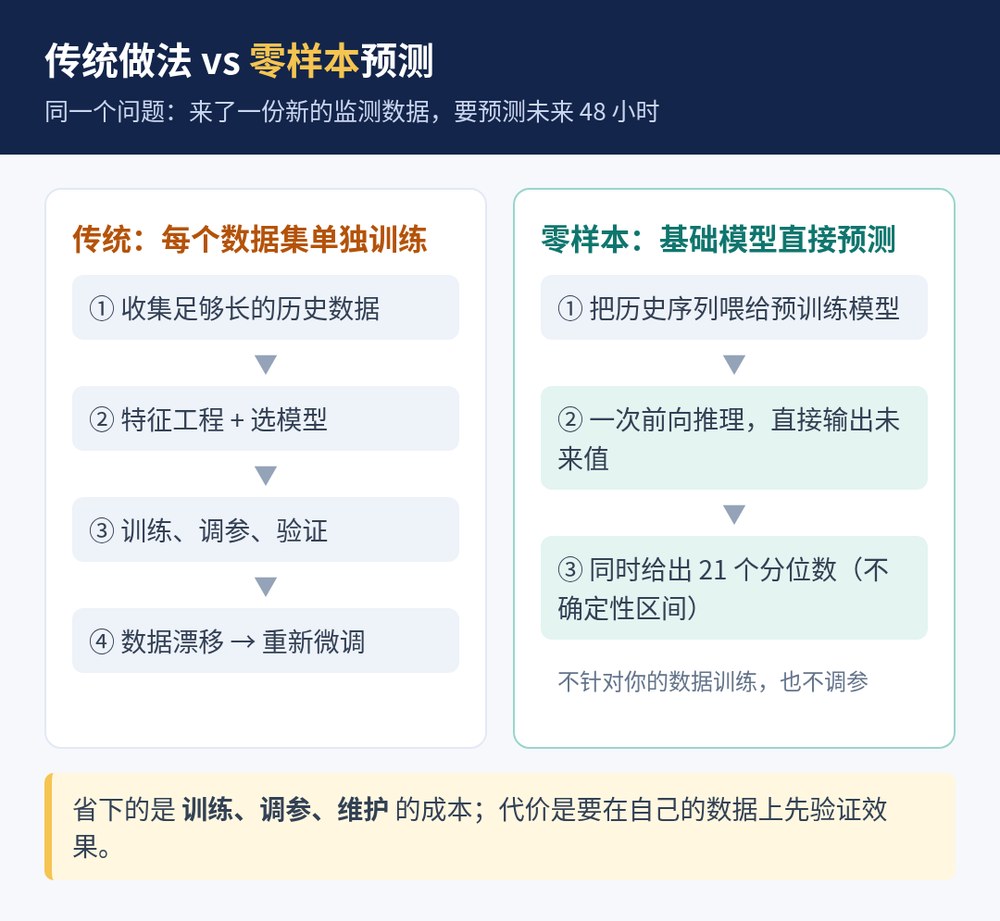
传统逐数据集训练 vs 零样本直接预测
几个关键能力
- 多变量联合预测:一个序列里的多个变量(气温、湿度、降水)一起预测,捕捉变量间耦合关系
- 协变量支持:可传“过去已知”和“未来已知”的辅助信息,如节假日、计划事件、周期特征
- 21 个分位数输出:每个时间步输出 0.01 到 0.99 的 21 个分位数,直接给出预测不确定性范围
- 长上下文 + CPU 可跑:最多接收 32768 个历史时间步,CPU / GPU 都能推理
许可证方面:源代码 Apache 2.0,模型权重 Modified MIT。要注意的是,按 Hugging Face 上的许可证原文,如果你所在公司(或雇主)上个月的全球合并收入超过 2000 万美元,就不能使用这份许可授予的任何权利(不只是商用),需要另向 Mistral 申请商业授权;个人和绝大多数中小企业不受影响。
02 本地部署
部署过程出乎意料地简单。代码仓库只依赖 PyTorch、NumPy、safetensors 和 huggingface_hub,没有花哨的框架。两种装法任选其一:
# 方式一:直接 pip 安装
pip install git+https://github.com/mistralai/timestral.git

# 方式二:克隆源码,可编辑安装
git clone https://github.com/mistralai/timestral.git
cd timestral && pip install -e .
权重从 Hugging Face 下载,四个模型加起来约 1.4 GB。下载后,用 TimestralForecaster 一行加载:
from timestral import TimestralForecaster

forecaster = TimestralForecaster.from_pretrained("mistralai/Timestral-209M")
预测调用也非常简洁:
import numpy as np

context = np.random.randn(2, 1, 2000).cumsum(-1)
forecast = forecaster.forecast(context, prediction_length=96)

forecast.quantiles.shape   # (2, 1, 96, 21)
forecast.median            # 中位数预测
forecast.quantile(0.9)     # 90% 分位数
整个依赖极简、API 清晰,从下载到跑通,一杯咖啡的功夫。
03 真实数据测试
为了验证它的零样本能力,我没有用官方 benchmark 数据,而是取了一段真实的气象观测数据(某西南城市的逐小时气温序列),用前 600 小时预测后 48 小时,再跟真实观测值对比。
测试配置
- 上下文:600 个历史时间步(25 天)
- 预测目标:未来 48 小时(2 天)
- 数据:真实气象观测,含明显日周期和趋势
- 评价:MAE、90% 区间覆盖率、CRPS
看结果之前,先用一张图说清楚“分位数”和“覆盖率”是什么意思:
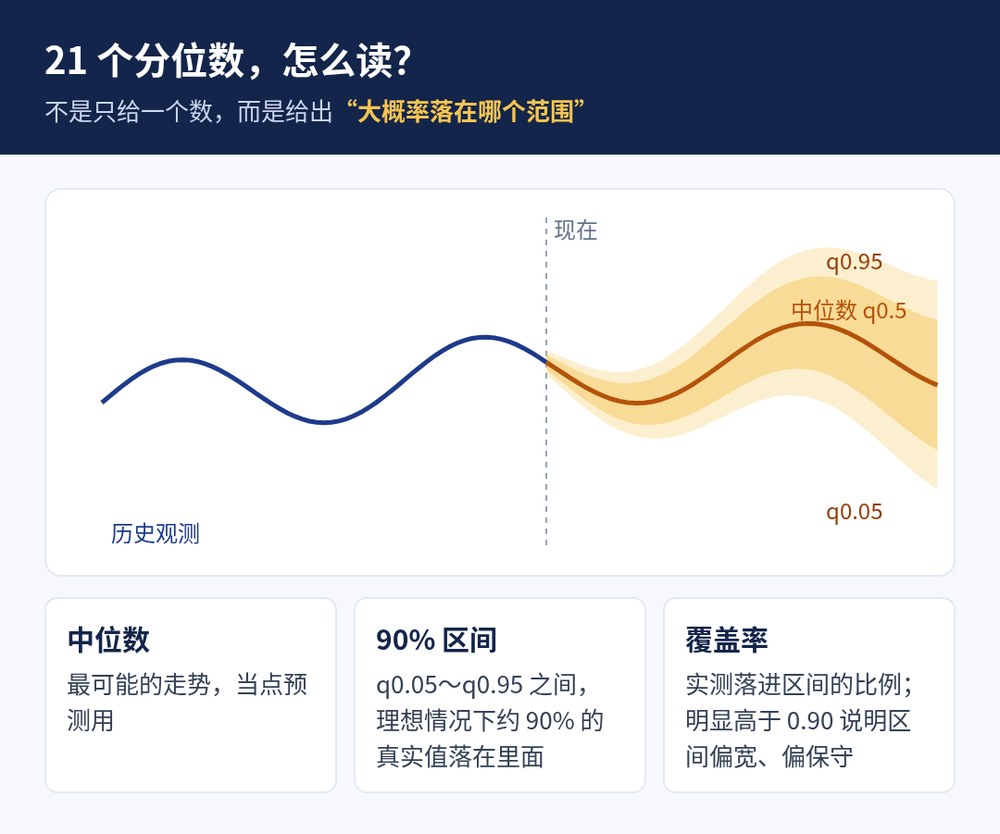
21 个分位数与 90% 区间覆盖率的读法
四模型精度对比
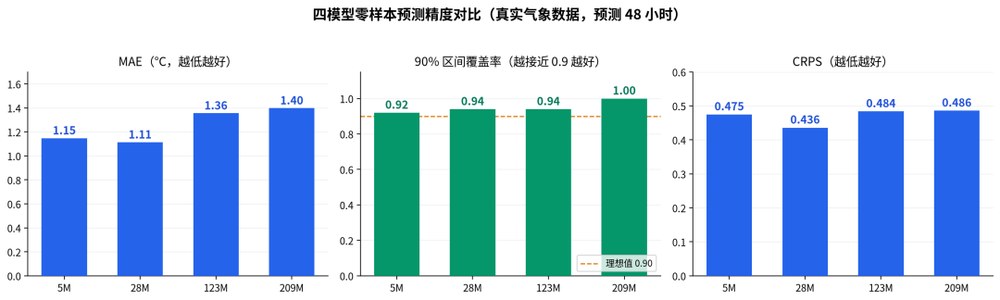
四模型精度对比:MAE、90% 区间覆盖率、CRPS
- 四个模型的 MAE 都在 1.1~1.4°C 之间,对一个含日周期、有趋势、还带噪声的冬季气温序列来说,这个精度相当不错
- 90% 预测区间覆盖率 0.92~1.00,都不低于理想值 0.90,没有出现区间过窄、漏掉真实值的情况;其中 209M 达到 1.00,说明它的区间偏宽、偏保守
- 模型并不是越大越好:这组数据上 28M 的 MAE(1.11)和 CRPS(0.436)都是最好的,209M 的 MAE(1.40)反而最高;最小的 5M(1.15)也和 28M 很接近,小模型在简单场景下完全够用
实测结论:这只是一条序列、一次 48 小时预测,不能代表官方基准排名;但它至少说明:在自己的数据上,先从小模型试起,不一定要直接上 209M。
预测效果可视化
下面这张图是 209M 模型的预测效果。黑色虚线是真实未来值,红色实线是中位数预测,红色阴影是 80% 和 90% 分位数区间:
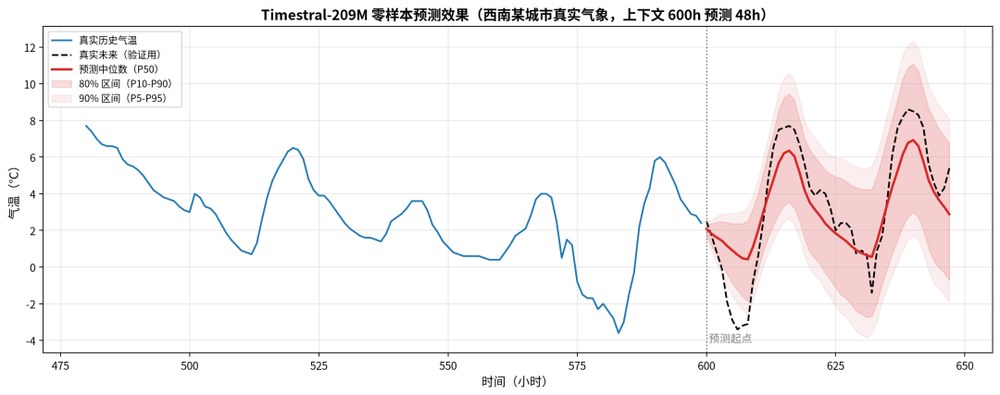
209M 模型预测效果:中位数 + 分位数区间带
- 中位数预测紧跟真实值的变化趋势,日周期的相位也基本对上了
- 分位数区间把真实值完整包在里面;结合 1.00 的覆盖率看,209M 的区间偏宽,略显保守
- 越往后预测,区间越宽——这是符合直觉的,不确定性随时间累积
多变量联合预测
我又测了气温 + 湿度两个变量联合预测。模型同时输出两个变量的预测,且能捕捉它们之间的耦合关系:
- 气温中位数和真实值吻合良好
- 湿度虽然波动更大,但预测的中位趋势也基本合理
- 输出形状 (1, 2, 48, 21),两个变量各有一套分位数
这在实际业务里很有用——监测站点同时上报多个指标,可以一次性联合预测,而不是每个指标单独建模。
04 性能表现
Timestral 官方强调“CPU 也能跑”,实测确实如此。我在本地机器上测了四个模型在 CPU 和 GPU 上的推理延迟(预测 48 步,warmup 后取多次中位数):
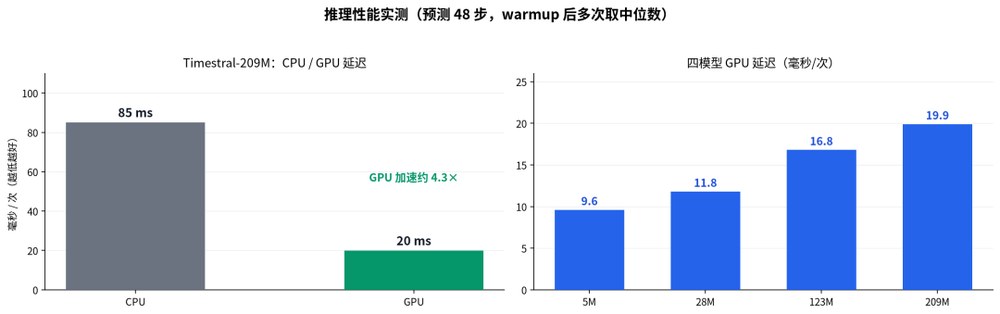
推理性能:209M 的 CPU/GPU 对比 + 四模型 GPU 延迟
- GPU 上四个模型都在 10~20 ms/次,最大的 209M 也只有约 20 毫秒,完全够做实时预测服务
- CPU 上 209M 约 85 ms,也是毫秒级,普通服务器甚至边缘设备都能跑
- 最小的 5M 在 GPU 上约 10 ms,大约是 209M 的一半;结合上一节的精度结果(28M 最准、延迟约 12 ms),日常场景优先选 5M / 28M 更划算,209M 留到在自己数据上确认有提升时再用
💡 测试机器为普通消费级工作站,未做服务器级调优;不同硬件环境下绝对值会有差异,但量级和趋势一致。
05 价值与场景
综合实测,Timestral 的价值可以概括为三点:
- 零样本 = 省掉大量训练成本。传统时序预测要针对每个数据集训练、调参、验证,Timestral 直接给历史数据就能出预测 + 置信区间。
- 概率预测 = 给决策提供不确定性。21 个分位数不是给一个单点预测,而是告诉你“最可能的范围”,对风险评估很有价值。
- 轻量可落地。最大模型才 837 MB,CPU 就能实时推理,封装成 API、放进边缘盒子、内嵌到现有监测系统都毫无压力。
结合我的行业背景(生态环境监测与智慧环保),几个典型的适用场景:
场景 | 怎么用 |
|---|---|
水质/空气监测 | 对未来几小时到几天的污染物浓度做趋势预判和预警 |
排口流量预测 | 结合降雨等协变量,预判排水负荷高峰 |
设备异常预警 | 用预测区间判断实时值是否偏离正常范围 |
能源负荷预测 | 光伏、用电负荷的短期预测,辅助调度 |
写在最后
Timestral 是时间序列基础模型领域一个很务实的新选择。它没有堆砌超大参数,而是用 2 亿参数做到三榜第一,把重点放在零样本、概率输出、轻量部署上——这些恰恰是实际工程里最需要的。
模型已开源,代码 Apache 2.0,权重 Modified MIT。如果你也做时序预测相关的工作,非常建议在自己的数据上跑一轮零样本测试,说不定能直接省掉一套训练流程。
参考链接
- 官方博客:https://mistral.ai/news/timestral
- GitHub:https://github.com/mistralai/timestral
- Hugging Face 模型合集:https://huggingface.co/collections/mistralai/timestral
- 权重许可证:https://huggingface.co/mistralai/Timestral-209M/blob/main/LICENSE
我是文茂,热衷于分享 AI 工具与开发者生态观察。
如果你觉得今天这篇有收获,欢迎点赞、收藏、关注三连,我们下篇见。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号