机动车登记证识别技术通过AI实现高效、准确的“大绿本”识别,克服版式复杂、拍摄环境差、防伪干扰等难题,提升车辆信息管理效率
原创
机动车登记证识别技术通过AI实现高效、准确的“大绿本”识别,克服版式复杂、拍摄环境差、防伪干扰等难题,提升车辆信息管理效率
原创
中科逸视OCR
发布于 2026-10-23 17:07:45
发布于 2026-10-23 17:07:45
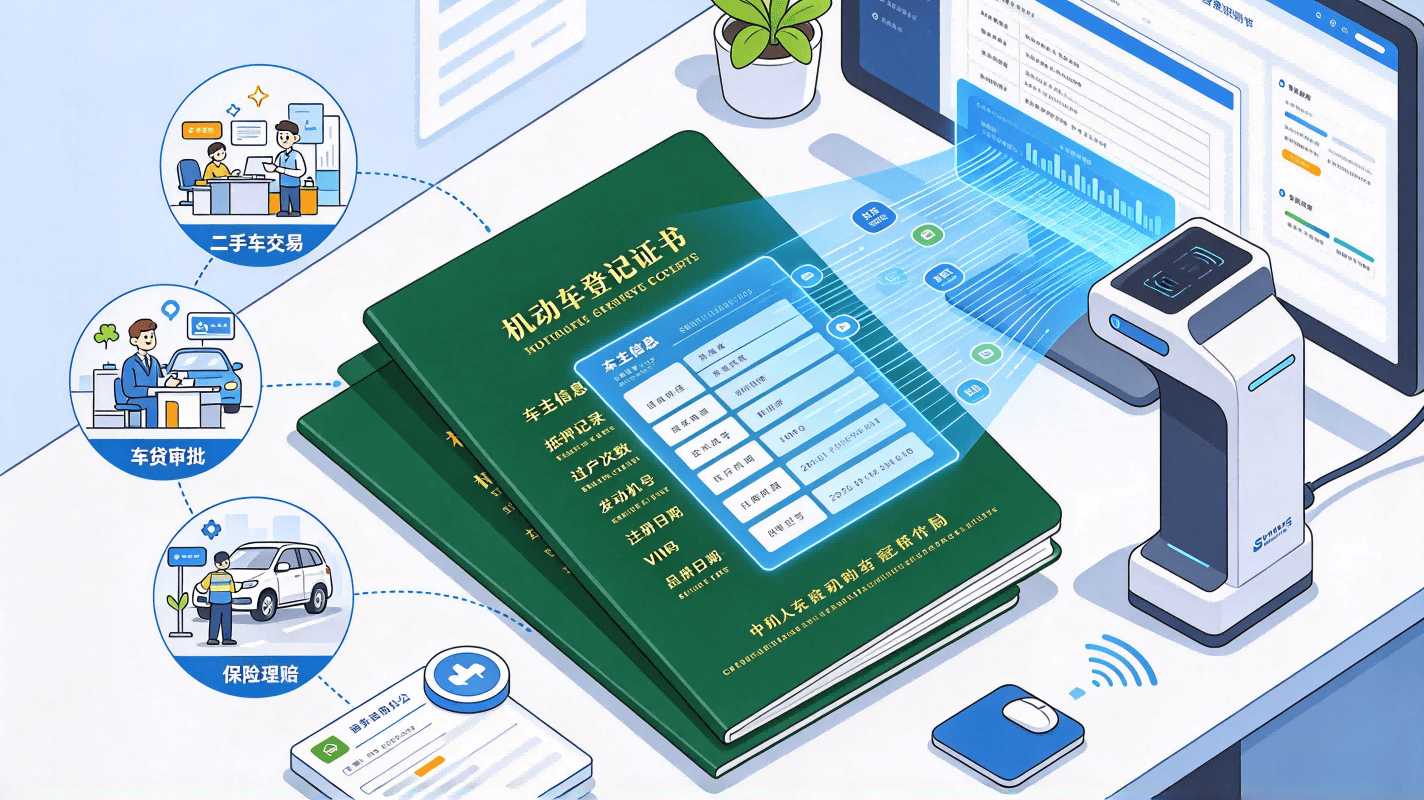
如果你买过二手车、办过车贷,大概率见过那本墨绿色的小册子——机动车登记证书,江湖人称"大绿本"。它是车辆的"户口本",车主是谁、过过几次户、有没有抵押,全记在上面。
问题在于:这么重要的一本证,长期以来全靠人工往电脑里敲。一页纸上几十个字段,车架号17位一个不能错,发动机号、日期、品牌型号……敲错一个字符,轻则返工,重则引发金融纠纷。
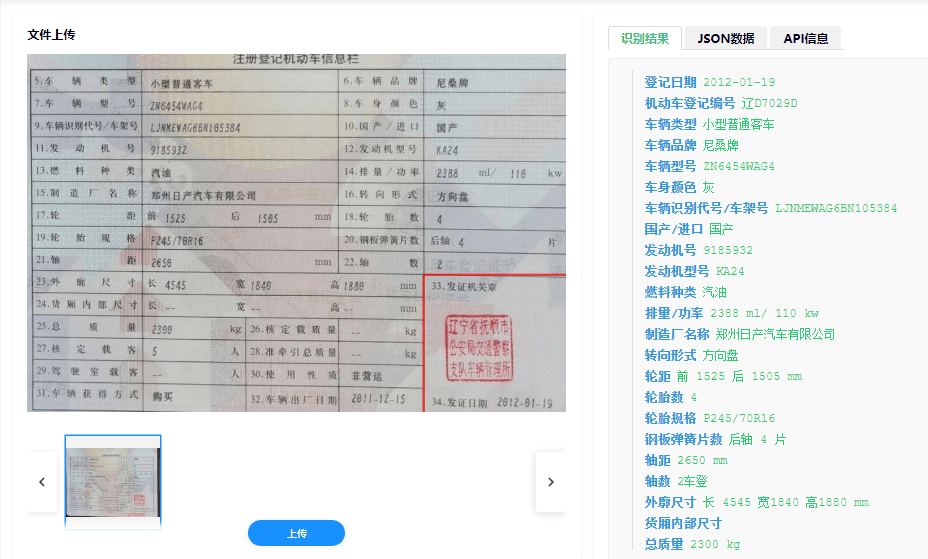
机动车登记证识别技术,就是让机器代替人"读"这本证——拍张照片,不到1秒,全本信息自动变成结构化数据,关键字段准确率可达99%以上。听起来像魔法,拆开看其实是三层"黑科技"。
先说难处:为什么机器认大绿本比认人脸还难?
在讲原理之前,先得明白这事为什么不容易。大绿本对AI来说,算得上"地狱难度"的阅读理解:
- 版式复杂:既有表格又有段落,还有手写签名和红色公章,字段标签和内容挤在一起;
- 拍摄环境随缘:用户拿手机随手一拍,光线不均、角度歪斜、反光、折痕都是家常便饭;
- 防伪元素捣乱:底纹、水印、微缩文字本来是防假证的,结果也容易让普通OCR系统"眼花"。
传统OCR遇到一张歪斜、盖着章的绿本照片,基本就开始"胡言乱语"了。机动车登记证识别系统的思路是:不是简单"认字",而是让机器先"理解"这张纸。
技术原理:一套"视觉感知 + 语义理解"流水线
整个机动车登记证识别过程,可以拆成四步。每一步单拎出来都不算全新技术,难的是把它们串成一条又快又稳的流水线。
第一步:图像矫正——先"扶正眼镜"
用户上传的照片往往是歪的。系统第一步不是认字,而是用深度学习模型做文档检测与透视矫正:像人眼找书本边缘一样,精准锁定证书的四个角点(哪怕画面里有手指遮挡、背景杂乱),再通过透视变换把倾斜、变形的图像"拉直",还原成一张平整的纸。
同时还会做图像增强——滤波去噪、调整对比度,把昏暗、模糊的照片修到"可读"状态。相当于先给机器配了副矫正眼镜。
第二步:版面分析——画出"网格地图"
这是最难的一步。大绿本不是一篇纯文本,而是一个由字段标签(如"所有人")、内容区、表格线、印章组成的混合体。
系统采用文档版面分析模型,不仅认字,还认"框线"和"区块":
- 通过目标检测模型,自动定位"车架号""发动机号""注册日期"等几十个关键字段的位置,统计表格的行列结构,搭出文档的"骨架";
- 通过空间关系推理理解字段间的逻辑——知道"这一行左边是'车主姓名',右边对应的值才是要提取的内容";
- 对红色公章,用印章分离技术把它从黑色文字下方"剥离"出去,避免公章糊在字上导致识别出错。
效果就像把一张复杂的表格拆成一个个独立单元格,每个格子里装着确定的信息。
第三步:高精度OCR——真正开始"认字"
到了核心识别环节,系统采用基于深度卷积神经网络的OCR引擎,在海量证件、文档数据上训练过,对打印体、手写体(有限范围内)的汉字、数字、字母都有很强的辨识力,尤其是相似字符——0和O、8和B——的区分能力远超传统方法。
针对模糊、低分辨率的图像,还会用超分辨率重建技术先把字迹"变清晰"再识别。
第四步:业务逻辑校验——自带"查册员"的第二大脑
这是真正体现功力的一步。识别出来的结果,还要过一遍机动车管理的业务规则:
- 车架号(VIN)必须是17位字母数字组合,且不含I、O、Q这类易混淆字符——如果识别出16位或出现非法字符,系统会自动触发二次确认,而不是硬着头皮输出错误结果;
- VIN自带校验码规则,可以验证号码本身对不对;
- 日期、证号等字段也会做逻辑合理性判断。
相当于机器不只是"读"完了这本证,还像一位资深查册员一样核了一遍账。
功能特点:五个看得见的本事
- 全字段覆盖:不只读车辆参数,连登记栏里的过户历史、抵押记录、变更备注也能完整提取,整本绿本一网打尽;
- 高抗干扰:褶皱、磨损、反光、印章遮挡、手写备注、照片倾斜,都能稳定应对,关键字段准确率99%以上;
- 秒级速度:单本识别不到1秒,对比人工录入几分钟一本的节奏,效率提升数十倍,批量高峰也不卡顿;
- 部署灵活:云端API、移动端SDK、企业内网私有化部署三种方式,能接进APP、小程序和线下审批系统;
- 金融级安全:支持识别运算本地化,车辆产权信息不必外传,数据全程加密,满足金融机构和政务部门的安全要求。
谁在用?这些场景你可能已经遇到过
- 二手车平台:买家拍一张大绿本,秒级读出这台车的"前世今生"——过户几次、有没有抵押、是否频繁转手,过户表单自动填充;
- 银行与汽车金融:办理车贷抵押时,抵押人信息、抵押日期自动录入,并与外部数据交叉验证,防范重复抵押、虚假资料;
- 保险公司:车险续保、理赔定损时快速采集排量、座位数、初登日期等参数,自动匹配费率表,减少录入差错引发的纠纷;
- 车管所与政务窗口:柜台扫描一下,信息自动进系统,工作人员告别手敲键盘;自助终端也因这项技术而成为可能;
- 车务类APP:用户拍照即可完成估价、保险报价、违章查询。
写在最后
机动车登记证识别技术,表面看是一个很小的技术环节,实际是数字化社会里"信任基础设施"的一块砖。它把一本纸质证上的信息,可靠地搬进了数字世界——搬得快、搬得准、还搬得安全。
以后再去二手车市场或银行办车贷,当工作人员"扫一下"就办完业务时,你大概知道背后发生了什么:一整套计算机视觉的流水线,在半秒钟内读完并核对完了那本厚厚的绿本。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号