TokenGate:端到端可训练的 Token 剪枝机制,让大模型 Prefill 提速 11.3 倍
原创
TokenGate:端到端可训练的 Token 剪枝机制,让大模型 Prefill 提速 11.3 倍
原创
七牛开发者
发布于 2026-10-27 16:11:38
发布于 2026-10-27 16:11:38
代码仓库、PDF及检索到的多份文档,常在请求到达后才交给 LLM。由于内容事先未知,对应的 KV Cache 无法预计算,每次请求都要重新完成预填充。标准 Transformer 会让全部输入 Token 逐层参与注意力和前馈网络计算,并生成对应 KV Cache。随着上下文变长,注意力计算快速增加,前馈网络计算和 KV Cache 占用也随 Token 数增长。
一种优化思路是在模型内部提前判断哪些 Token 后面还值得继续计算,把剩余部分提前停下来。这样就会遇到剪得越早,能省掉的后续计算越多;模型层数越浅,又越难判断一个 Token 后面是否还有用。Stanford 与 UC Berkeley 的研究者提出 TokenGate,把 Token 剪枝变成一个可训练的问题,让已有模型学习哪些 Token 应该继续进入后续层,同时解决 Top-K 离散选择带来的训练困难。
TokenGate 提前筛选 Token
TokenGate 保留完整输入。N 个 Token 会先按标准方式经过前面的模型层,作者预先选定一个模型层作为门控位置,并将这个位置记作 L。模型在这一层完成注意力计算后,评分网络读取每个 Token 当前的表示,为其生成重要性分数,再由 Top-K 选择器保留其中 K 个。只有被选中的 Token 会继续进入这一层的前馈网络和后续模型层;被剪掉的 Token 从这里停止计算,后续层也不会再为它们生成 KV Cache。
在 Qwen3-1.7B 主实验中,作者将门控位置设为 L=1。L 表示门控所在的层索引,并非 TokenGate 新增的一类模型层。这套机制让所有 Token 先完成前部计算,再让其中一部分继续进入更深的模型层。用户问题等指定 Token 可以设置为不可剪枝;训练阶段的目标 Token 和解码阶段新生成的 Token 也不会被门控淘汰。
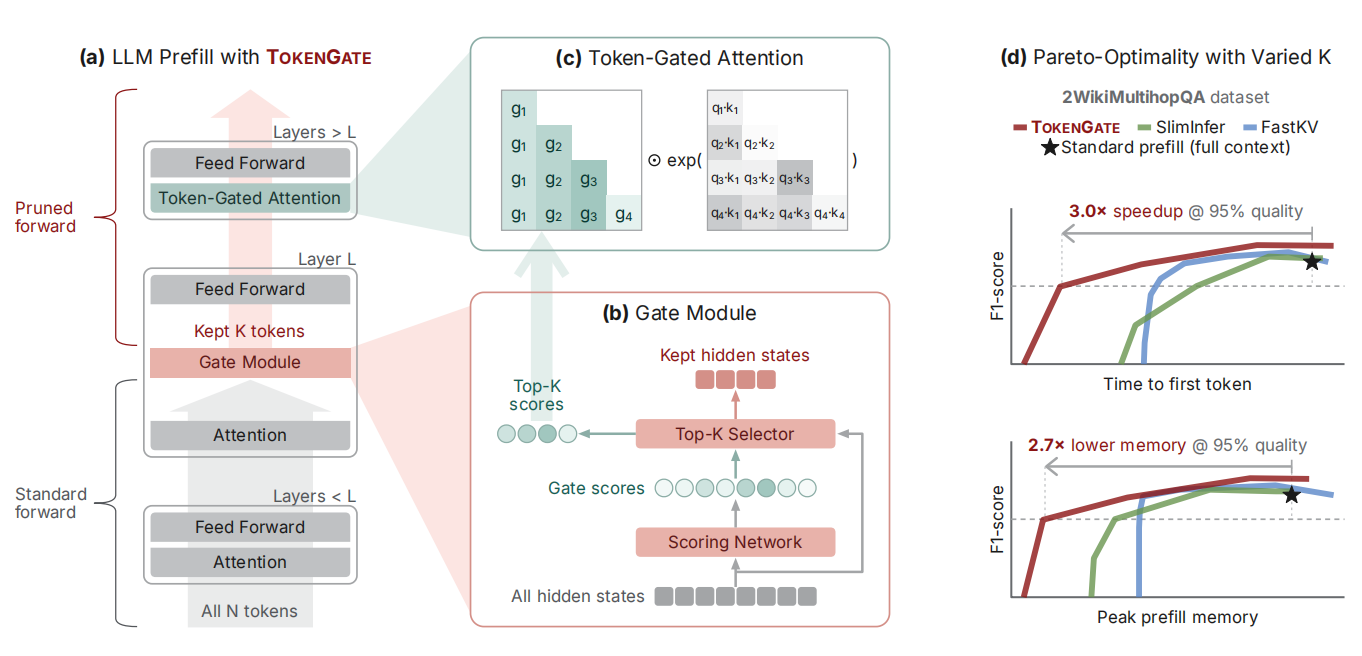
图 1:TokenGate 的整体机制。
门控机制为评分网络建立梯度路径
Top-K 属于离散选择。任务损失无法直接通过“某个 Token 是否进入 Top-K”这一步更新评分网络。TokenGate 为此引入了 Token 门控注意力。Top-K 决定哪些 Token 被留下,被选中 Token 的重要性分数还会继续进入后续注意力计算,影响注意力权重。
因此,虽然“是否入选”仍是离散操作,被选中 Token 的门控分数仍处于可微计算图中。任务损失可以沿着下面这条路径反向传播:
任务损失 → 上层注意力 → 门控分数 → 评分网络论文将这一机制与 MoE Router 类比,MoE 在专家维度上做稀疏选择,TokenGate 在输入 Token 维度上做选择。只要保留预算 K > 1,任务损失仍可以通过被选中 Token 的门控值更新评分网络。
剪枝还会改变注意力分布。不同注意力头对门控分数的敏感度不同,Token 数减少也会让 Softmax 分布变得更尖锐。TokenGate 因此加入逐注意力头的可学习增益和温度缩放。在 BioDEX 的设计消融中,去掉其中任一项都会使任务表现与首字延迟之间的权衡变差。TokenGate 让 Token 选择规则可以通过任务训练得到。
选择器与模型主干共同适应剪枝
只让评分网络学会选 Token 还不够,因为后续模型层接收到的上下文也发生了变化。在 Qwen3-1.7B 实验中,作者同时训练门控模块、Token 门控注意力参数和模型主干上的 LoRA 参数。训练仍使用标准的下一个 Token 预测交叉熵损失,不需要额外标注哪些 Token 重要。
下图分别验证了选择器和模型主干的作用。固定 TokenGate 训练后的模型主干时,学习得到的选择器在不同 Token 预算下都优于 Random-K,也优于 FastKV 的启发式选择器。反过来,都使用 Random-K 时,经过 TokenGate 联合训练的模型主干仍然优于普通 LoRA 微调模型。
这说明 TokenGate 的收益来自两个部分:一方面,评分网络学会了更有效地选择 Token;另一方面,模型主干也在联合训练中逐渐适应剪枝后的上下文。作者推测,这种适应可能与 Token 之间的信息重新分布有关,但论文没有继续验证这一内部机制。
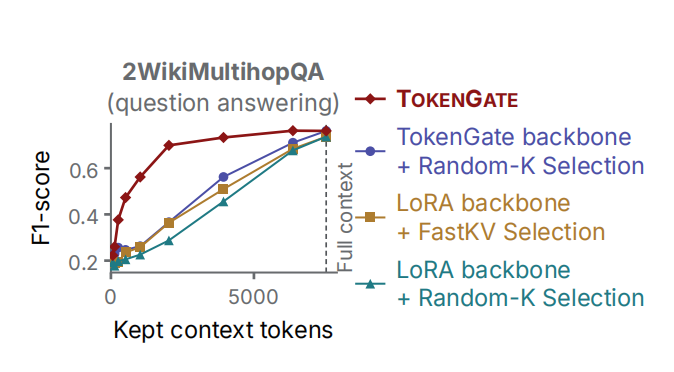
图 2:选择器与模型主干的解耦实验。
训练时,K 也不是固定值。每一步同时使用完整上下文预算和一个随机采样的小 Token 预算,让同一个任务模型训练后可以覆盖多个 K,无需为每种剪枝比例重新训练。
这种训练会增加单步成本。TokenGate 每个训练 step 平均约为普通 SFT 的 1.3×;论文五个任务中有四个以更少的 step 收敛,因此最终总训练时间有升有降,五项平均约为 SFT 的 0.8×,整体仍与标准参数高效微调处于相近量级。
Token 剪枝降低预填充成本
作者在 Qwen3-1.7B 上测试了代码补全、多跳问答、多文档摘要、医疗信息抽取和长上下文检索,并与 FastKV、SlimInfer、GemFilter、DASH 以及稀疏注意力方法比较。为控制比较条件,免训练剪枝基线运行在同一个任务级 LoRA/SFT 模型上,并使用与 TokenGate 相同的保留 Token 预算;TokenGate 使用相同训练数据和 LoRA 配置另行联合训练。对于 SlimInfer、DASH 等方法,作者还进行了更适合 torch.compile 的重实现,并报告更快的版本。推理计时统一使用 batch size 1、单张 A100。
下图比较了任务指标与首字延迟(TTFT)、峰值预填充显存之间的帕累托前沿。在各任务指标不低于同任务 LoRA 完整上下文基线的工作点上,TokenGate:
- TTFT 获得 1.4~11.3× 加速;
- 峰值预填充显存缩小 1.5~3.4×;
- 相比下一最佳方法,TTFT 最多再快 6.4×;
- 峰值预填充显存最多约再缩小 2×。
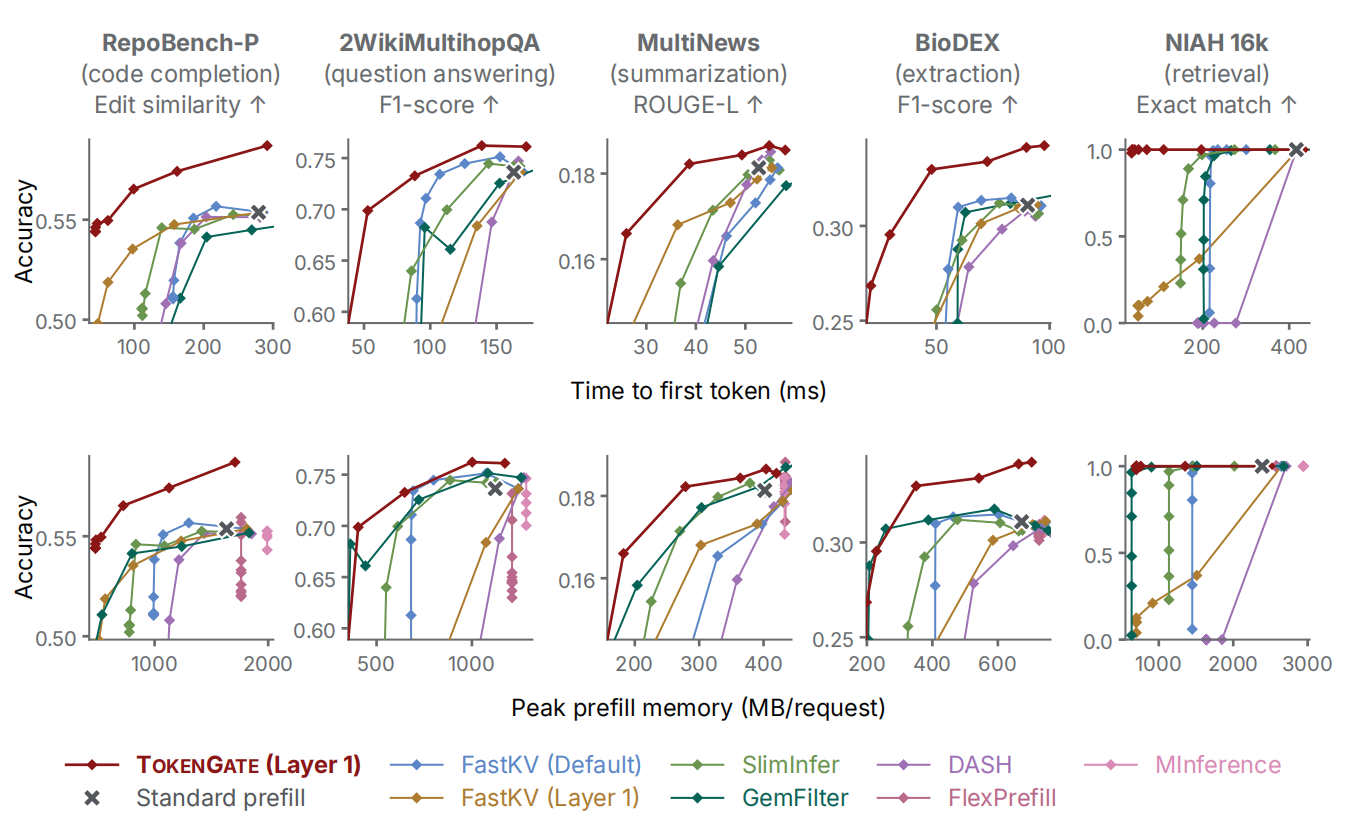
图 3:Qwen3-1.7B 在五类任务上的任务指标—TTFT 与任务指标—峰值预填充显存帕累托前沿。
五个任务使用的指标并不相同,分别包括 Edit Similarity、F1、ROUGE-L、Set F1 和 Exact Match。因此论文中的 “no accuracy degradation” 对应的是:各任务自己的评测指标不低于完整上下文基线。前文图 1 中的“95% quality 下 3.0× speedup”属于另一种实验口径,它允许任务指标下降到完整上下文结果的 95%,不能与上述结果混用。
论文附录还将在 NIAH 16K 上训练的模型直接用于 32K、64K 和 128K 上下文测试,TTFT 加速最高约 13×,峰值预填充显存约缩小 3.4×。这一结果说明 TokenGate 在 NIAH 上具备上下文长度外推能力。
门控位置影响剪枝效果
TokenGate 的门控位置本身也是一个需要选择的超参数。作者在 BioDEX 上比较了 Layer 0、1、2。Layer 0 的任务表现—TTFT 权衡明显劣于 Layer 1 和 Layer 2。作者认为,Layer 0 的注意力后残差表示可能还没有包含足够信息,评分网络难以据此判断 Token 重要性;到 Layer 1 和 2 后,这些表示已经能够支撑更有效的选择。
这里形成了一个直接的工程权衡:位置太晚,前面的计算已经花掉;位置太早,Token 表示不足以支撑可靠选择。
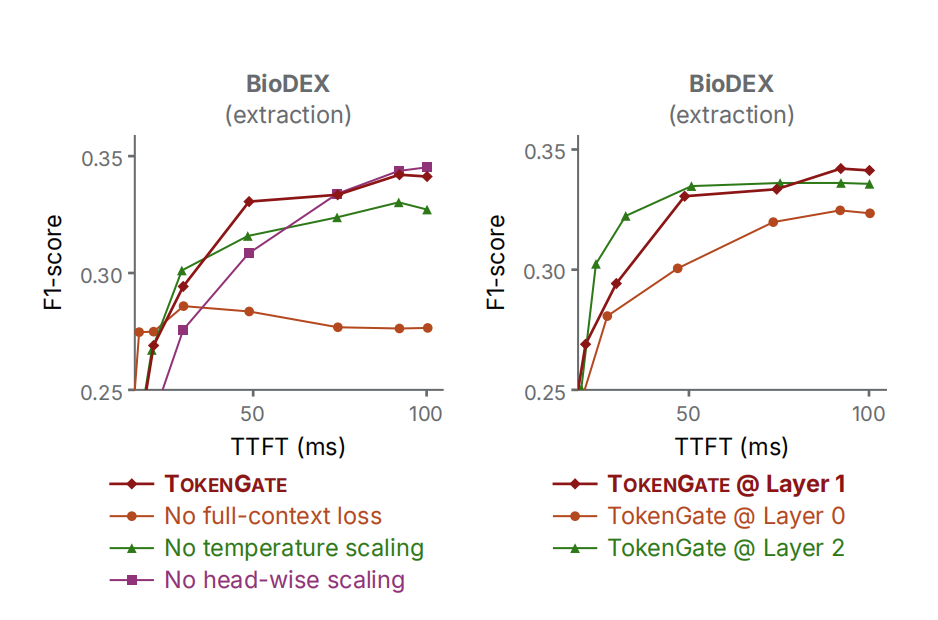
图 4:BioDEX 上的设计与门控层消融。
作者把 TokenGate 扩展到了 Qwen3.5-2B。该模型只有部分层使用完整注意力,其余使用 Gated DeltaNet。FastKV 依赖注意力分数,只能在完整注意力层执行剪枝;TokenGate 的评分网络读取隐藏状态,因此门控也可以放在 Gated DeltaNet 层。
Token 门控注意力只作用于后续完整注意力层。Gated DeltaNet 没有注意力 Logit,门控后的 Gated DeltaNet 直接在保留下来的 Token 上运行。
在 NIAH 32K 上,门控位于第 3 层时,TokenGate 在匹配完整上下文任务表现的条件下获得 3.8× TTFT 加速,相比同任务表现下最好的 FastKV 再快 2.1×。门控前移到 Layer 1 或 2 后,最高达到 7.8×,此时任务指标与标准预填充基线相差不超过 6%。
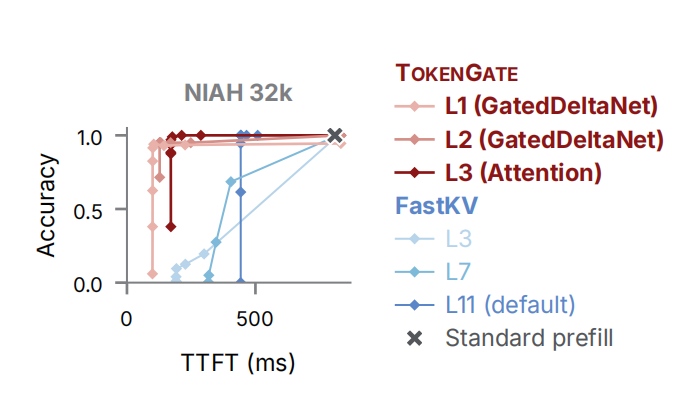
图 5:TokenGate 在 Qwen3.5-2B 混合注意力架构上的结果。
不同任务呈现不同的 Token 保留模式
除了基准测试,论文还在附录 E 中可视化了门控最终保留的 Token。这些样本中,保留 Token 分布在上下文的不同位置,不同任务也出现了不同的选择模式。
在 NIAH 的一个 15,843 Token 样本中,模型只保留 K=64。位于 78% 深度处的 Needle Sentence 有 24 个 Token,其中 21 个被保留,模型最终给出了完全正确的答案。
MultiNews 的一个样本则展示了失败情况。门控保留了大量功能词和部分事件词,人名、地点等首字母大写的 Token 保留不足。模型仍概括出了“抢劫银行并被捕”的事件,但人物身份、年龄和地点出现错误。
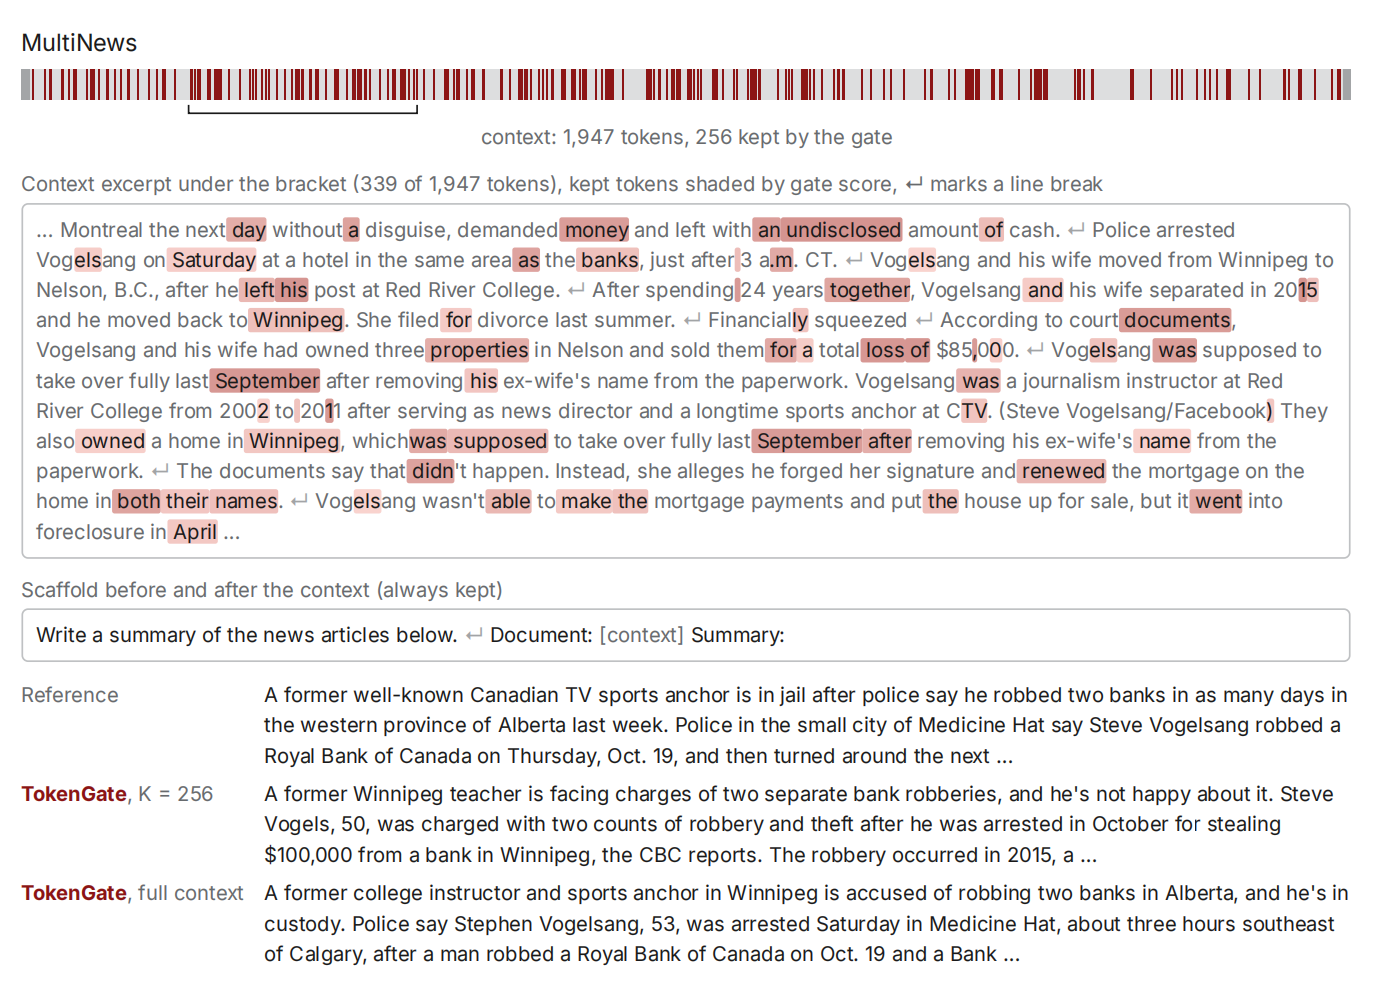
图 6:MultiNews 样本中的 Token 保留结果。
这些属于少量真实样本的定性观察,不能代表各任务都会形成固定的 Token 选择规律。它们说明,学会剪 Token 之后,仍然可能漏掉影响生成结果的信息。
TokenGate 的工程验证仍有限
TokenGate 需要对已有模型进行适配训练,同时涉及推理内核改动。Token 门控注意力需要给注意力 Logit 加入每个 Key 对应的偏置,标准融合注意力内核并不直接支持。作者修改了 FlashAttention-2,修改后的调用成本约为普通调用的 1.0~1.1×。解码阶段,已经确定的门控偏置可以预先折进注意力掩码,后续继续使用标准注意力。
主实验还关闭了门控以下层的 KV Cache 剪枝。默认情况下,门控上方层只保存被选中 Token 的 KV,门控及以下层仍保留完整提示词的 KV。作者用这一设置单独测量预填充 Token 剪枝带来的收益。
因此论文中的显存结果主要反映预填充阶段,不能直接推导为整个解码阶段的 KV Cache 都缩小到了 K 个 Token。
实验范围也比较明确:主实验集中在 Qwen3-1.7B 和 Qwen3.5-2B;代码任务是 RepoBench-P 的下一行代码补全,没有覆盖完整 Coding Agent。论文也没有报告连续批处理、多用户并发吞吐或完整请求端到端延迟实验。
论文验证了一条具体路径:把“哪些 Token 继续进入后续层计算”变成可训练的选择,并让模型主干一起适应剪枝后的上下文。
现有实验表明,这套方法能够在多个受控任务上改善任务表现与预填充成本之间的权衡。更大模型、真实 Agent 和生产推理服务中的收益,还需要进一步验证。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号