从变声器到 AI 语音转换:中文实时变声入门与项目选型
原创
从变声器到 AI 语音转换:中文实时变声入门与项目选型
原创
buzzfrog
发布于 2026-11-09 12:26:16
发布于 2026-11-09 12:26:16
变声器可以把一句普通的问候变成虚拟角色的声音,也可以让同一段表演呈现不同人物的音色。它既是容易体验的应用,也是理解语音表示、生成模型和实时系统取舍的一个切入点。
本文从变声器的用途和分类出发,介绍实时语音转换的评价方法,再比较 StreamVC、RVC、MeanVC 2、X-VC 等代表工作,重点分析中文场景中音质、延迟与训练成本之间的关系。
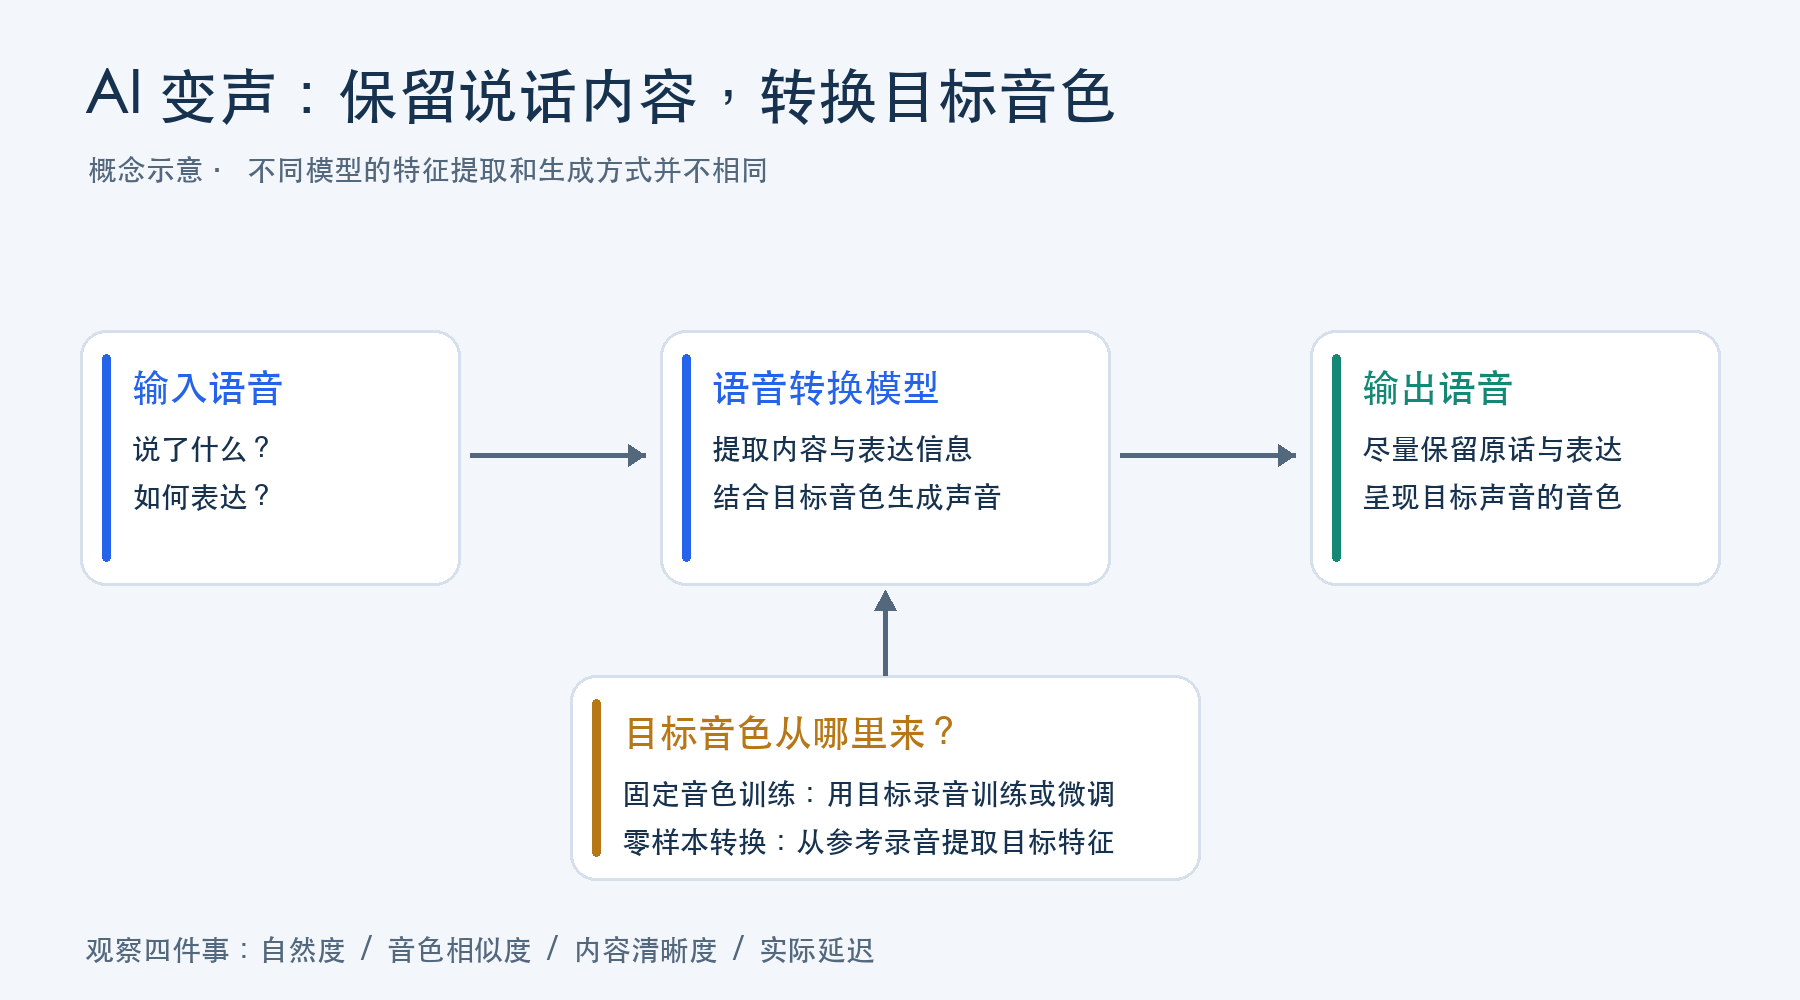
AI 变声的输入、音色条件与输出
图 1:AI 音色转换的概念示意,不代表某个模型的具体内部架构。
一、认识变声器:改变的究竟是什么
什么是变音器?
变音器,也常称为“变声器”,是一类改变人声听觉特征的软件或设备。它接收麦克风声音或已有录音,经过处理后输出另一种声音。变化可以很简单,例如让声音更高、更低或带有机器人效果;也可以更复杂,例如保留说话内容,让音色听起来像另一个人。
例如,你对麦克风说“大家好,欢迎来到直播间”,变音器输出的仍然是这句话,但声音可以变得更低沉,或呈现某个虚拟角色的音色。
理解变音器时,可以先区分三个概念:
- 内容:说了什么。例如“今天下午三点开会”。
- 音色:声音具有怎样的辨识特征。即使两个人说同一句话、音高接近,我们通常仍能分辨是谁。
- 韵律:怎么说。包括音高起伏、语速、停顿和重音等。
AI 音色转换,希望在尽量保留内容和表达的同时改变音色。只把音调升高或降低,不一定能产生自然、可信的另一种人声。
变音器能解决什么问题?
使用场景 | 希望解决的问题 | 更关注的效果 |
|---|---|---|
游戏、语音聊天和直播 | 用另一种声音实时交流,塑造角色或个人风格 | 低延迟、自然度和长时间稳定运行 |
虚拟主播、虚拟角色 | 让操作者的声音与角色设定匹配 | 音色一致、表情和语气保留 |
配音与内容制作 | 将已有表演转换成目标音色,尝试不同角色声音 | 音质、目标相似度和表达细节 |
歌声转换 | 保留歌词、旋律和演唱节奏,改变歌声音色 | 音准、连贯性和歌唱细节 |
声音隐私保护 | 降低原始声音身份的暴露程度 | 身份信息抑制与内容可懂度 |
娱乐和声音特效 | 制作机器人声、怪兽声等特殊效果 | 效果可控、操作方便 |
不同场景的要求并不相同:聊天时不能等待整句话说完才输出,录音后期则通常可以用更长处理时间换取音质。普通变声也不等于可靠的匿名化,听起来不像原声并不能保证无法识别说话人。
有哪几种变音器?
变音器没有唯一的分类方式。最容易理解的是按技术方式和使用方式分别看;两者可以交叉组合。
按技术方式,可以分为以下几类:
类型 | 大致如何工作 | 优点与局限 |
|---|---|---|
传统信号处理型 | 调整音高、共振峰,叠加滤波、失真或调制等效果 | 计算量通常较小、容易实时运行;精确模仿某个人和保持自然度的能力有限 |
AI 固定音色训练型 | 用目标人物的录音训练或微调模型,学习其声音特征 | 可以针对固定音色优化;新增目标声音通常需要准备数据和训练。RVC 是典型代表 |
AI 零样本型(Zero-shot) | 使用已经训练好的通用模型,根据参考录音生成目标音色 | 新声音接入方便;对未见人物的相似度和稳定性需要验证。MeanVC 2、X-VC 是代表方法 |
这不是互斥的技术边界:AI 系统也会使用传统信号处理,零样本模型也可能支持针对固定音色微调。“零样本”指使用新目标声音时不必再次训练,而不是模型从未训练过。
按使用方式,可以分为两类:
- 实时变声:边说边转换,输出到耳机、直播或通信软件。重点是等待时间短,而且连续运行不卡顿。
- 录音后处理:先有完整录音,再进行转换。可以利用更长上下文和更多计算,不必满足即时交流的延迟要求。
此外,软件运行在本机还是云端、提供桌面界面还是音频插件,是部署和接入方式的区别,并不直接决定模型音质。
二、怎样判断一个变声系统是否好用
一个系统是否适用,需要同时考察四个方面:声音是否自然、是否像目标人物、原话是否准确清楚、响应是否足够及时。只看一段精选演示或某个分数,容易忽略实际使用中的问题。
音质与相似度是不同的问题
声音可以很自然,却不像目标人物;也可以音色很像,却带有金属感、断续或咬字模糊。常见评测指标各有侧重:
指标 | 主要衡量什么 | 阅读时的注意事项 |
|---|---|---|
CER/WER | 字符/词识别错误率,用于辅助评价内容保留 | 通常越低越好;识别器和文本处理流程会影响结果 |
NMOS | 听者对自然度的平均评分 | 听者、样本和测试方法不同,分数不宜直接跨论文比较 |
SMOS | 听者对目标声音相似度的平均评分 | 相同分数不代表相同听感 |
SIM/SSIM | 声音表征之间的相似度;此处用于说话人相似度评价 | 依赖所用说话人模型,不等于人的主观判断 |
DNSMOS/UTMOS | 模型预测的语音质量或自然度分数 | 不同指标不能直接比较,也不能代替听测 |
实时性既取决于计算,也取决于等待
流式系统把连续音频分成小块逐步处理。如果模型需要看到后面的声音才能生成当前输出,就会产生前瞻等待;如果计算速度跟不上输入,缓冲还会不断累积。
指标 | 含义 | 常见误读 |
|---|---|---|
分块大小 | 每次处理或输出的音频长度 | 40 ms 分块不等于总延迟 40 ms |
算法等待/前瞻 | 为输出当前音频而等待输入上下文 | 零前瞻不等于零延迟 |
计算时间 | 编码、转换、解码的运行时间 | 更快显卡不能消除输入等待 |
管线首包延迟 | 模型链路产生首段输出所需时间 | 不一定包含声卡、应用和网络 |
实际端到端延迟 | 从音频输入到最终播放 | 必须明确设备与测量方式 |
RTF | 计算时间与音频时长之比 | RTF < 1 表示可跟上实时输入,不代表延迟很低 |
不同论文使用不同硬件、缓冲和评测流程,不能直接按一个毫秒数排序。
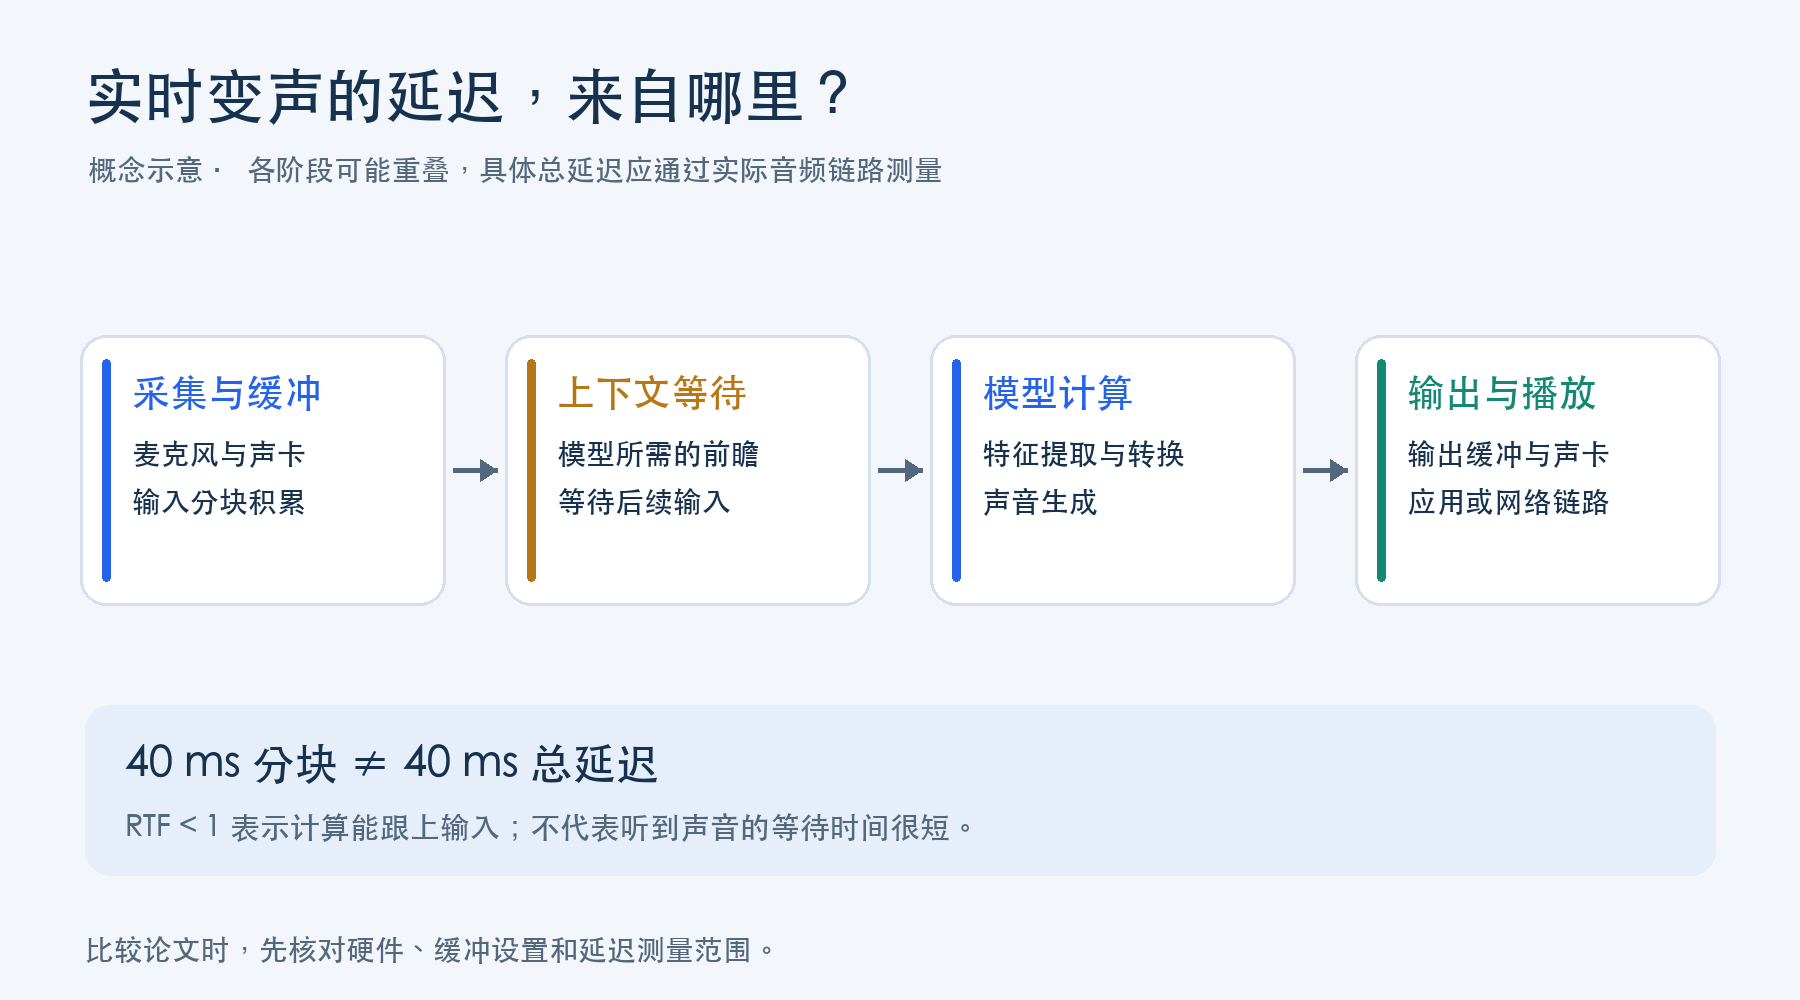
实时变声延迟的组成
图 2:实际延迟涉及输入缓冲、上下文等待、模型计算与播放链路;各阶段可能重叠。
三、从 StreamVC 看实时语音转换的发展
StreamVC 的代表性贡献,是把保留内容与韵律的音色转换带到低延迟移动端场景。之后的工作继续探索更低的算法等待、更轻量的合成方式、更好的目标音色适配,以及更广的风格控制。因此,它仍是理解这个方向的重要基线,但不宜被视为当前所有场景下的统一最优方案。
工作 | 公开结果或特点 | 当前定位 |
|---|---|---|
StreamVC,ICASSP 2024 | 论文报告移动端延迟 70.8 ms | 移动端流式转换的重要基线 |
RT-VC,ACL 2025 Demo | 发音器官特征与 DDSP;报告 CPU 延迟 61.4 ms | 低延迟技术路线参考,有官方仓库 |
Zero-VC,Interspeech 2026 | 严格因果、零前瞻,算法延迟 20 ms;CPU RTF 0.063 | 极低算法延迟候选;所引用资料未确认可用的官方代码和权重 |
MeanVC 2,2026 预印本 | 40 ms 分块,约 110 ms 管线首包延迟 | 中文、CPU 实时和低延迟重点候选 |
TVTSyn,ICLR 2026 | 随内容变化的音色表示,约 79 ms GPU 延迟 | 音色迁移与匿名化研究,有 PyTorch、ONNX 发布路径 |
X-VC,2026 预印本 | 编码器潜在空间单步转换,中英文与跨语言评测 | 中文内容保真值得测试,模型链路约 298 ms |
StyleStream 2.0,2026 年 10 月预印本 | 音色、口音、情绪及文本控制;消费级 GPU 约 520 ms | 声音风格控制,任务范围更广 |
Zero-VC 的 20 ms 不包括推理计算;其质量实验主要与开源非流式模型比较,不能据此推断所有质量指标均超过 StreamVC、RT-VC。TVTSyn 的约 79 ms 是特定 GPU 配置结果,也不能直接代表发布的所有运行配置。
这些工作也存在任务范围上的区别。语音转换(Voice Conversion,VC)通常以语音为输入,保留内容并改变音色;声音风格转换还可能改变口音与情绪;文本转语音(Text-to-Speech,TTS)则从文字生成声音。StyleStream 2.0 研究的目标比单纯音色转换更广,不能直接按同一标准与 StreamVC 比较。
代表论文:StreamVC、RT-VC、Zero-VC、TVTSyn、StyleStream 2.0。
四、两种零样本方案:MeanVC 2 与 X-VC
MeanVC 2 与 X-VC 都能根据参考录音转换为新的目标音色,但设计侧重点不同。MeanVC 2 强调短分块和轻量流式运行;X-VC 在音频编码器的潜在表示中进行转换,并提供中英文与跨语言实验。选择时,应将语言覆盖、音质与延迟预算结合起来考虑。
维度 | MeanVC 2 | X-VC |
|---|---|---|
中文基础 | 约 1 万小时普通话数据训练,以中文评测为主 | 中英混合训练,包含跨语言评测 |
中文内容保真 | 论文 CER 7.44% | 论文中文 WER 2.65% |
目标相似度 | SSIM 0.710;SMOS 3.89 | SIM 0.72;中文 SMOS 3.89 |
输出采样率 | 16 kHz | 16 kHz |
报告延迟 | 109.88 ms 全管线首包延迟 | 240 ms 输入上下文等待 + 58.17 ms 计算 |
测速硬件 | AMD EPYC 7542,单核单线程 | NVIDIA RTX 3090 |
实时计算证据 | ASR、VC、声码器合计 RTF 0.633 | GPU 流式评测;不能由离线 RTF 推断实时链路延迟 |
接入路径 | 麦克风流式脚本、Windows CPU 可执行包、微调工具 | 在线实时演示;本地文档主要提供文件与分块推理 |
主要定位 | 中文低延迟互动、轻量部署 | 中文清晰度、跨语言与较宽松延迟预算 |
这些质量数字不是同条件横向比较。两篇论文的评测流程不同,自然度指标也不同。X-VC 比较的是第一代 MeanVC,而不是 MeanVC 2;相同的 SMOS 数字也来自不同听测。
MeanVC 2 的 Windows 包文档注明 Windows 10+、8 GB 内存、约 4 GB 磁盘空间,但这不保证所有 CPU 均达到论文延迟。X-VC 的 RTX 3090 是测试设备,不能据此认定最低要求为 24 GB 显存。
所引用的资料未提供足以判断两者在 Mac/Apple Silicon 上实时表现的官方基准。Windows 可执行包也不能直接在 macOS 上使用。
音质问题不能全部归因于零样本
试听中出现的音质问题需要分别分析。以 MeanVC 2 为例,它同时追求零样本适配、低延迟和低计算成本,效果受到多种因素影响。
听感问题 | 更值得排查的方向 |
|---|---|
不像目标人物,残留原音色 | 零样本适配、参考录音与音色解耦 |
金属感、毛刺、发音模糊 | 重建能力、声码器、短分块与上下文 |
声音闷、缺少高频细节 | 输出带宽、录音与合成链路 |
口音、语气不像目标 | 模型是否只迁移音色,而未转换风格 |
MeanVC 2 论文中,部分自然度和中文错误率指标没有超过使用更长上下文的第一代 MeanVC;作者承认了上下文带来的质量取舍。其 16 kHz 输出限制高频范围,但不能解释所有机械感。
官方提供目标说话人微调,适合验证“像不像”的提升;不能承诺微调会消除架构和低延迟配置造成的所有失真。可以先测试官方标为质量优先的 120 ms + 40 ms 配置;若其基础质感仍不能接受,再考虑其他模型。
数据与配置来源:MeanVC 2 论文及项目、X-VC 论文及项目。
五、固定音色训练:RVC 与可选路线
如果目标是长期使用同一个虚拟角色或少量固定声音,就不必把零样本能力作为首要要求。投入一次数据准备和训练,可能换来更适合目标人物的声音;是否值得,需要与通用模型在相同条件下比较。
RVC:固定音色转换的实用基线
RVC 通常需要目标录音和训练。官方 FAQ 推荐约 10–50 分钟干净、音色一致的数据。目标声音越多,数据整理、训练、模型与索引管理的负担越明显。
零样本方法在这一点上优势明确:一个通用模型加不同参考音频即可尝试新声音。
固定目标上的音质与零样本能力
RVC 可以针对目标训练并调节检索比例。特征检索帮助减轻源音色残留,但如果训练数据质量不好,提高检索比例也可能降低输出质量。
本文引用的 MeanVC 2、X-VC 论文没有提供足以证明全面超越“充分训练、认真调参的 RVC”的中文实时对照。因此不能从 SOTA 字样推导出实际替换价值。
实时运行与参数设置
RVC 官方 README 报告 170 ms 端到端延迟,特定 ASIO 条件下可达到 90 ms,并强调硬件与驱动影响。
截至资料核查日期,RVC 实时界面代码默认分块为 250 ms,另有交叉淡化和上下文参数。因此官方报告的最佳结果不能直接当作默认运行体验;缩小分块需要验证持续计算能力、边界伪影与稳定性。
Beatrice 2:面向低延迟和表达保留
- 公开训练工具与预训练组件,训练后可加载到 VST、VCClient 或 beatrice-client 实时使用。
- 官方文档围绕表达保留、自然度、低延迟和低负载设计,列出官方 VST 外部录音测量约 50 ms 延迟、开发者 i7-1165G7 单线程 RTF < 0.2 的目标与条件。
- 推理不要求 GPU;默认训练文档约 9 GB 显存,RTX 4090 示例约 40 分钟。实际训练时长取决于配置。
- 缺少充分的中文同条件质量评测,不能宣称已全面胜过 RVC。
应从原项目官方入口和官方训练工具进入,区分同名第三方封装;第三方客户端的延迟不能直接继承官方 VST 的测量结果。
DDSP-SVC:从歌声转换出发
项目提供训练与实时转换,使用 DDSP 配合音质增强,当前介绍包含 rectified-flow 增强。作者的表述是在部分数据集上可达到不逊于 RVC 和 so-vits-svc 的质量,而非全面超过。
它以歌声转换为主要背景,中文口语中的辅音、短促发音、句首句尾和快速语流都需要另测。实时资源开销也可能略高于 RVC。
MeanVC 2 微调:通用模型的定向适配
有中文基础、流式推理和微调路径,但目前没有“微调后优于 RVC”的充分证据。如果质量优先配置下的输出仍有明显机械感,应先判断问题来自音色适配还是基础重建能力,再决定是否投入微调。
LLVC:低资源实时转换
LLVC 面向 any-to-one(任意输入说话人到固定目标说话人)转换,提供训练推理代码,强调 CPU 低延迟与低资源。论文使用 RVC 生成转换训练数据,实验主要基于英文。它适合部署研究,尚不足以推荐为中文音质升级首选。
相关文档:RVC、 Beatrice 训练工具、 DDSP-SVC、 LLVC。
六、根据应用需求选择项目
需求 | 可以优先测试的方案 | 选择依据 |
|---|---|---|
固定中文音色,允许训练,音质优先 | RVC,并加入 Beatrice 2 对照 | 可以定向优化;新候选需要通过中文盲听验证 |
频繁添加新的目标声音 | MeanVC 2、X-VC | 零样本方式减少逐个训练的成本 |
中文互动、CPU 运行、低延迟优先 | MeanVC 2 | 有明确的 CPU 全管线实时评测 |
中英跨语言,允许更高延迟 | X-VC | 有直接的跨语言评测依据 |
歌声转换或愿意探索不同合成质感 | DDSP-SVC | 有训练与实时路径,但中文口语需单独验证 |
低资源系统研究 | LLVC、Beatrice 2 | 适合研究计算负载与实时运行;不能据此预设中文音质领先 |
这些是实验起点,而不是已经验证的音质排名。尤其在固定音色场景中,目前所引用的公开资料还不足以证明某个方案在中文自然度、目标相似度和实时延迟上全面替代训练良好的 RVC。
七、设计一次有意义的对照实验
对于允许固定音色训练的中文实时变声实验,可以先比较 RVC 与 Beatrice 2,再根据音质与资源预算决定是否加入 DDSP-SVC。比较应使用相同的数据、硬件和评价流程。
- 统一目标录音。使用同一批干净中文数据,保持录音条件与音色一致,覆盖常见音素和不同表达。
- 保留独立测试录音。测试输入不得与训练录音混用,包含快语速、轻声、儿化、平翘舌、句首尾、情绪变化及实际会用到的中英夹杂。
- 先看质量上限。在各自质量优先配置下盲听,判断模型基础质感是否达标。
- 再限制延迟预算。在同一台机器、同一音频设备与应用链路中测实际输入到输出延迟,避免只比较模型耗时。
- 同时评估四项。自然度、目标相似度、内容清晰度、持续运行稳定性。识别错误率可以辅助,但不能代替听感。
- 以实际收益决定替换。只有当新模型在可接受延迟下显著更符合要求,才承担迁移成本。
这样的实验能够把“模型更新”“指标更高”和“实际更适合使用”区分开。对于本科阶段的课程项目,清楚说明比较条件、保留失败样例并分析原因,比单纯复现一个漂亮的演示更有学习价值。
参考资料与项目入口
论文与研究项目
- StreamVC 论文
- StreamVC 官方试听页
- RT-VC 论文
- RT-VC 官方仓库
- Zero-VC 论文
- Zero-VC 试听页
- MeanVC 2 论文
- MeanVC 2 官方仓库
- X-VC 论文
- X-VC 官方仓库
- TVTSyn 论文
- TVTSyn 官方仓库
- StyleStream 2.0 论文
固定音色训练与实用工具
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号