万卡国产芯要装的那层外挂,关键不在算力在调度
原创

十万卡不是堆出来的,是调度出来的。这条消息里的卡数只是表层,真正决定成败的是那层把万卡编排成一台机器的软件外挂,公开信息里恰恰这一块最薄。
图 1 本文配图:文章主题场景示意
先说结论,卡数是给人看的
一看到「万卡」「十万卡」这种词,我第一反应不是兴奋,是警惕。
因为过去几年里,卡数是最容易被拿来做标题的数字,也是最难被验证的数字。你买得到卡,不代表你连得起卡;你连得起卡,不代表你喂得饱卡。
这条消息的核心其实有两句话,一句是给万卡国产芯装个超级外挂,一句是联合华为昇腾五年冲刺十万卡。前一句讲软件,后一句讲规模。
我的判断很直接,前一句才是这件事真正的分量,后一句是它愿意对外承诺的野心。
公开信息只到这一层,具体那层外挂叫什么、用什么协议、跑在什么框架上,没有披露。所以下面我讲的,是基于同类大规模训练集群的通用规律做的推断,我会把推断和事实分开标。
万卡这事的难点,从来不在单卡
很多人对大规模训练的理解停在一个画面,一万张卡一起算,算得飞快。
真实的画面更像一万个人被关在一个房间里做同一道题,每个人算完一小步都要跟其他人对答案。谁说话慢一点,谁听错一句,整道题就得从头再来。
推演调度失败路径(示意代码,说明单卡抖动如何被放大成整批重算)
# 伪代码,推演万卡规模下一次抖动的影响
def train_step(ranks, batch):
    results = {}
    for rank in ranks:
        try:
            results[rank] = rank.compute(batch)  # 每张卡各算一小步
        except TimeoutError:
            # 一张卡超时,同步栅栏就卡住,整批无法继续
            return {"status": "abort", "culprit": rank.id}
    # 全部到齐才能进入下一步
    if len(results) != len(ranks):
        return {"status": "abort", "culprit": "unknown"}
    return {"status": "ok", "next": aggregate(results)}
所以规模上去之后,瓶颈会从算力密度转移到通信和调度。卡越多,对答案的次数越多,等待的时间越长,任何一张卡掉线或者变慢,都会把整批人拖住。
这就是为什么我说,单卡强不强,在万卡这个尺度上已经不是决定性的变量了。
决定性的变量是,你能不能把一万张卡的失败当成常态来设计,而不是当成事故来处理。
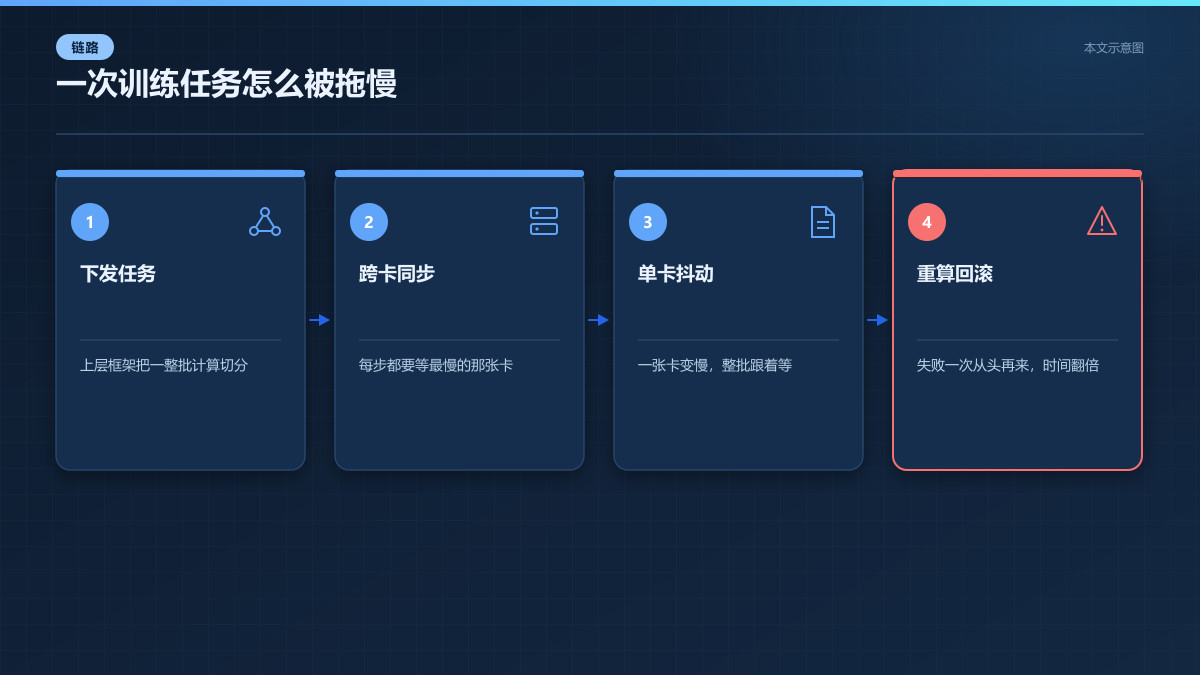
图 2 本文示意图:万卡规模下,等待和重试的成本会盖过单卡算力的优势
那层外挂,本质是个翻译加调度器
国产芯真正的门槛,不在晶体管,在生态。
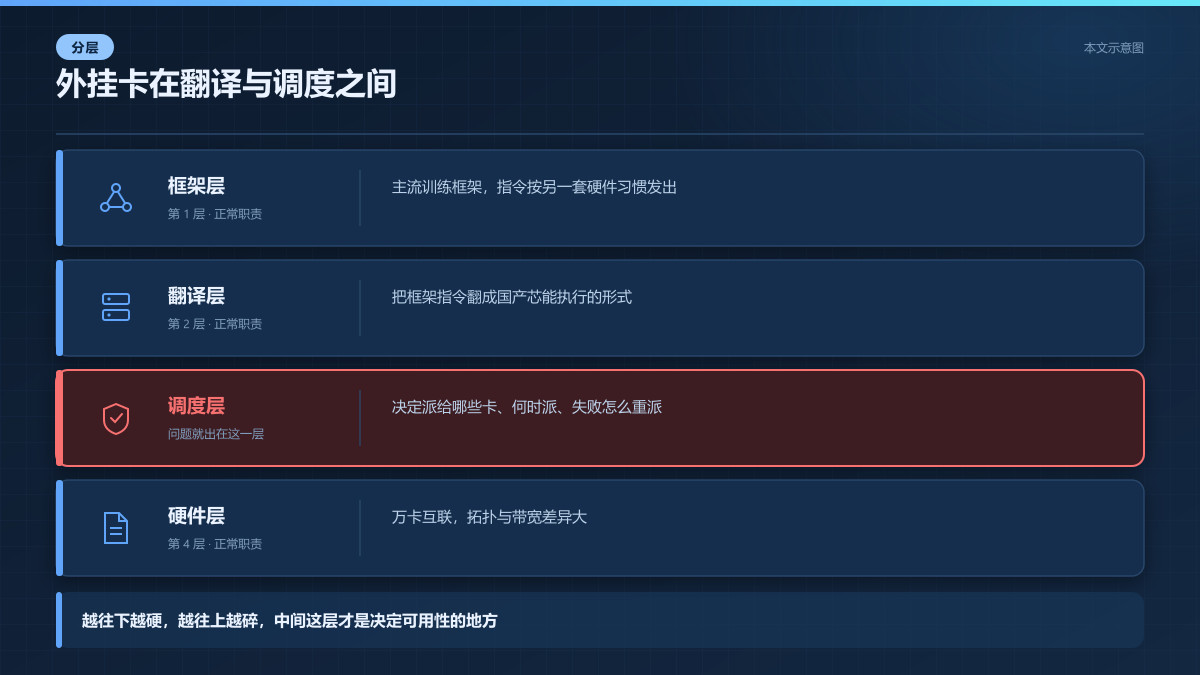
图 3 本文示意图:国产算力的短板不在芯片层,而在把上层框架接到国产芯上的那一层
主流训练框架、算子库、通信库,多年来都是围绕另一套硬件长出来的。你换一套硬件,等于让所有上游软件重新学一门方言。
所以我理解这个超级外挂,干的是两件事。一件是把上层框架的指令翻译成国产芯听得懂的话,另一件是在翻译的同时决定这一批活派给哪些卡、什么时候派、失败了怎么重派。
这两件事里,第二件更难,也更值钱。
翻译做不好,性能打折。调度做不好,集群直接不可用。
这里我要说清楚,这是我从「外挂」这个词和国产算力的现实处境推出来的,不是官方披露的架构。真实实现可能比这复杂,也可能比我说的更聚焦在某一个环节。
为什么以前没人把它做成通用件
不是没人想做,是做出来的东西很难跨硬件复用。
调度逻辑和硬件拓扑绑得太死。你的卡怎么连、带宽多少、哪几张卡之间通信便宜,这些细节直接决定调度策略。换一批卡,策略就得重写。
这也是为什么大厂的集群方案往往是自研自用,很难变成一个别人拿去就能跑的通用件。
清华团队这次的价值,可能恰恰在于它站在一个相对中立的位置上,有动力去做一层不绑定单一硬件的抽象。
但中立也有代价。越抽象,越难榨干某一种硬件的极限性能。这是一个必须做的取舍,不是能绕过去的问题。
公开信息没说他们怎么取舍,这条我保留意见。
五年十万卡,时间表比技术更值得看
五年这个数字,我觉得比十万卡更值得琢磨。
如果外挂这一层已经成熟,冲刺十万卡不需要五年,一两年铺开就行。给五年,说明这中间还有硬骨头要啃,而且啃骨头的时间被算进去了。
我猜至少有三块。一块是软件栈的稳定性,万卡规模下连续跑几周不出问题,这件事本身就极难。一块是国产芯产能和交付节奏,这个不完全由团队决定。还有一块是真实业务能不能持续喂饱这么大的集群。
第三块最容易被忽略。集群建起来之后闲置,是比建不起来更常见的浪费。
所以我把这个五年读成一个诚实的信号,而不是一个营销数字。
当然,这也可能只是对外表述时留的余量,我没法证实。
对写代码的人意味着什么
有读者会问,这跟我有什么关系,我又不训大模型。
关系在于,如果这层外挂真的做成通用件,未来你调用的推理服务、你部署的私有模型,背后的硬件选项会变多。
选项变多,价格和供给才有得谈。现在很多团队被单一供应链卡着,不是因为别的硬件不能用,是因为迁移成本太高。
迁移成本里最大的一块,就是这层调度和翻译。
所以这件事短期看不出变化,中期会体现在你敢不敢换一家算力供应商上。
这是一个慢变量,但它决定的是整个行业的议价结构。
我怎么验的,以及这次没查到什么
先说验的部分。我没有拿到这套外挂的任何代码或接口,所以我没有做性能测试,也没有跑过 PoC。我的验证方式是交叉比对同类大规模训练集群的公开论文和工程博客,看调度层在万卡规模下通常怎么设计、常见瓶颈在哪。
具体来说,我翻了近两年几篇讲万卡集群稳定性的公开材料,重点看它们怎么处理慢节点和故障恢复。这些材料来自不同团队,但规律很一致,就是调度层必须把失败当常态。
再说没查到的部分。第一,这套外挂的具体形态没有公开。它是编译器、是调度框架、还是两者都有,我不知道。
第二,万卡这个规模目前跑到什么程度,是实验室环境还是生产环境,公开信息没披露。
第三,十万卡的目标里,有多少是新建、有多少是整合现有资源,也没说。
第四,性能数据一条都没有。没有吞吐、没有线性加速比、没有故障恢复时间。没有这些,任何关于「最强」的评价都只能算愿景。
我把这些缺口列出来,不是唱衰,是因为我知道这类项目最容易在宣传期被讲成一个已经完成的东西。
它现在是一个方向,不是一个结果。
我的态度,等数据不等口号
国产算力这件事,我从来都是支持的,但支持的方式不是看到万卡就转发。
真正值得追的节点有三个。第一次公开的万卡规模稳定性数据,第一次跨硬件迁移的实际案例,第一次有外部团队用上这套外挂。
这三个节点出现之前,我会把它记在「值得关注」而不是「已经领先」。
说到底,算力这件事的胜负不在发布会上,在连续跑三十天不出故障的机房里。
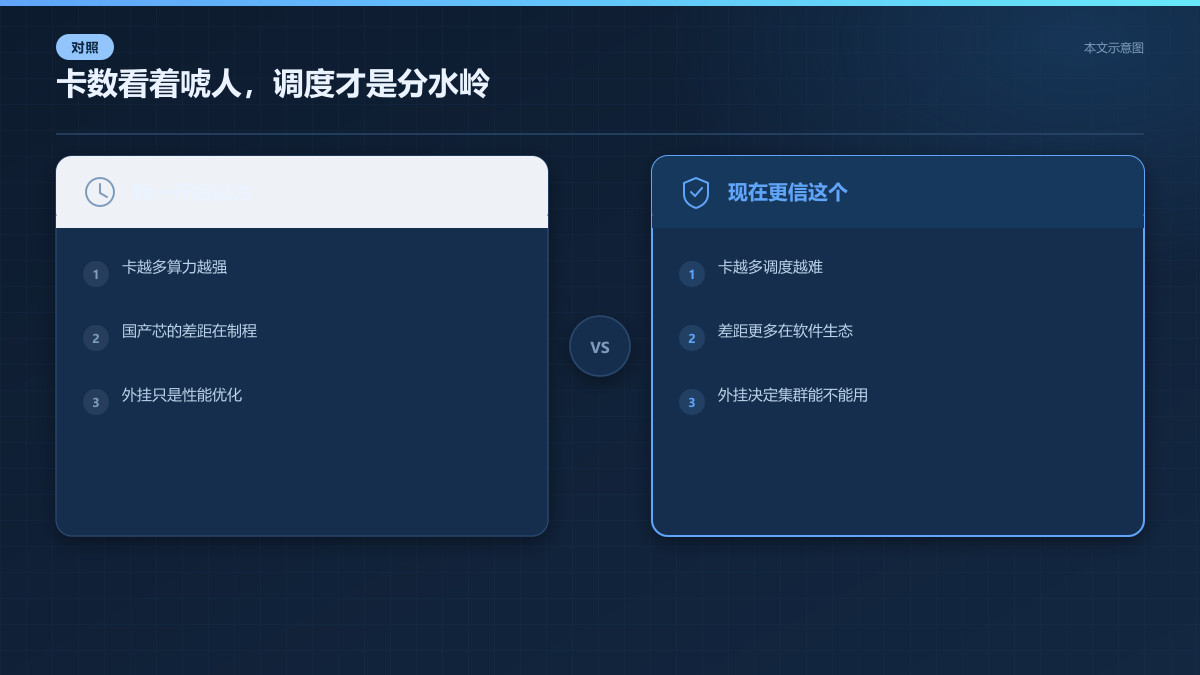
图 4 本文示意图:同样是万卡,调度做得好与做不好,可用性差一个量级
那句话我想留给所有做基础设施的人,能跑通一次的叫演示,能跑一年的才叫产品。
如果你也在盯这件事,我建议你盯这三个节点,而不是盯卡数。
想跟的人,今天先做这三件事
光说等数据,听着像风凉话。我自己会做三件具体的事,如果你也关心这条线,可以照着做。
第一件,把你手里正在跑的推理服务做一次硬件可替换性盘点。不用真换,只列清单,哪些算子绑死了CUDA,哪些通信库只有一家实现,哪些依赖是编译期写死的。这份清单就是你未来的迁移成本表。
第二件,在你的训练或推理代码里加一个慢节点检测的钩子。哪怕只是记录每一步的耗时分布,找出每次同步里最慢的那张卡。这件事今天就能做,不需要等任何新框架。
第三件,关注这个项目的后续公开材料,重点看它有没有放出跨硬件迁移的案例,而不是看它又宣布了多少卡。案例比数字难造,也更有信息量。
这三件事的共同点是,都不依赖那层外挂落地。它们是在为选项变多的那一天提前做准备。
如果你现在就在用国产芯跑训练,我特别想知道你踩过的坑,尤其是通信库和算子适配那一段。公开信息里这块几乎是空白,你的经验比任何发布会都实在。
写在最后
基础设施这行的价值,从来不体现在发布当天的数字上,而体现在第三十天凌晨三点,集群还在安静跑着的那一刻。万卡、十万卡都是路上的里程碑,真正要造的是那条能一直走下去的路。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章,我们,下次再见。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号