AI 写掉八成代码,公司为什么还要留你
原创

被 AI 替掉的从来不是「写代码的人」,是「只负责把需求翻译成代码」的那一段工序。这篇不谈行业大势,只讲一件事在团队里到底落在哪一层,以及一个工程师这周该动哪一步。
图 1 本文配图:文章主题场景示意
先说我不同意的那部分
InfoQ 中文今天这篇《AI 来了,团队究竟怎么变?》,我点进去之前大概猜到会写什么。
无非是效率提升、组织扁平、人要学新工具。这类稿子过去两年我看了不下五十篇,结构都差不多。
但看完之后我有一种不太一样的感觉。它真正在问的不是「团队怎么变」,是「团队里哪一层还在起作用」。
这两个问题差很远。前一个指向编制,后一个指向工序。
我的判断先放在这里,AI 压掉的不是人,是工序里那段「把别人的判断翻译成可执行动作」的中间层。
这一段过去由初级和中级工程师承担,量大、可度量、也最容易被误认为就是「写代码」本身。
所以当有人说「AI 能写 80% 的代码了」,我第一反应不是慌,是想问一句,那 80% 具体是哪 80%。
如果指的是模板代码、胶水代码、单元测试骨架、接口适配层,那这句话成立,而且三年前就成立了。
如果指的是「决定这个系统该长什么样」,那这句话到今天为止,我一次都没见它成立过。
先把话说死,后面几节我再解释为什么我敢这么讲。
被压掉的是翻译工序,不是工种
我在团队里带过项目,也被人带过,见过最典型的协作断裂长这样。
产品说一句「这个按钮点下去要快」,中间要经过三层翻译,产品翻译成需求文档,技术负责人翻译成任务拆分,工程师翻译成代码。
每一层翻译都会掉一点信息,也都会加一点自己的假设。
AI 现在吃掉的是第三层翻译里最标准化的那部分,就是把一个已经想清楚的任务写成代码。
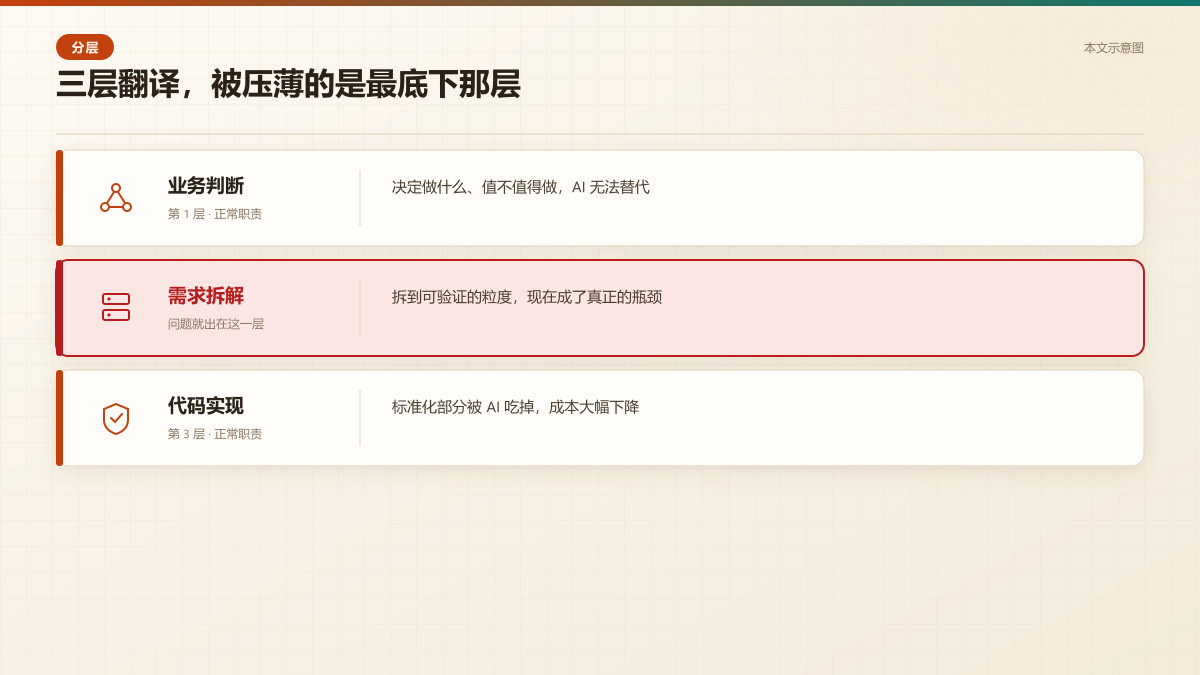
图 2 本文示意图:同一个需求要经过三层翻译才变成代码,AI 让第三层变便宜,瓶颈反而上移到前两层。
这一层确实被压得很薄。我见过一个接口适配的任务,过去要半天,现在描述清楚二十分钟能出初稿。
但注意,「描述清楚」这四个字本身,就是第一层和第二层翻译的产物。
AI 没有让这两层变简单,反而让它们变成了瓶颈,因为下游变快了,上游一旦含糊,整条链路就卡在需求那一端。
这就是我读那篇稿子时最强烈的感受,变慢的地方和变快的地方不是同一处。
团队真正要重新分配的,是把人从第三层往第一层和第二层挪。
挪得动,效率是真提升;挪不动,就是一堆人在等需求想清楚。
为什么以前没人觉得这是问题
因为以前第三层太贵了。
写代码贵,所以团队默认把最聪明的人放在第三层,让技术最强的人去写最难的代码。
这个默认在人力稀缺的年代是对的。
AI 把这个价格打下来之后,同一个默认就变成了浪费,你把最强的判断力用在了一件已经变便宜的事上。
我在自己项目里试过反向操作,让最熟业务的人不写代码,只负责把需求拆到 AI 能一次吃下去的程度。
结果比我预想的好,也比我预想的难。
好在产出速度确实上来了,难在拆需求这件事本身需要极高的领域理解,不是谁都能干。
所以「AI 来了团队怎么变」这个问题的答案,我认为不在工具选型上,在人的重新排布上。
这里我得说清楚,这是我从有限几个项目的观察里推出来的,不是行业统计。
公开信息没有给出团队规模、职能配比这些数字,我也不打算编一个。
三个前提,缺一个这套就转不起来
第一个前提,需求侧要能被拆到可验证。
AI 生成的东西你必须能判断对错,判断不了就等于没生成。
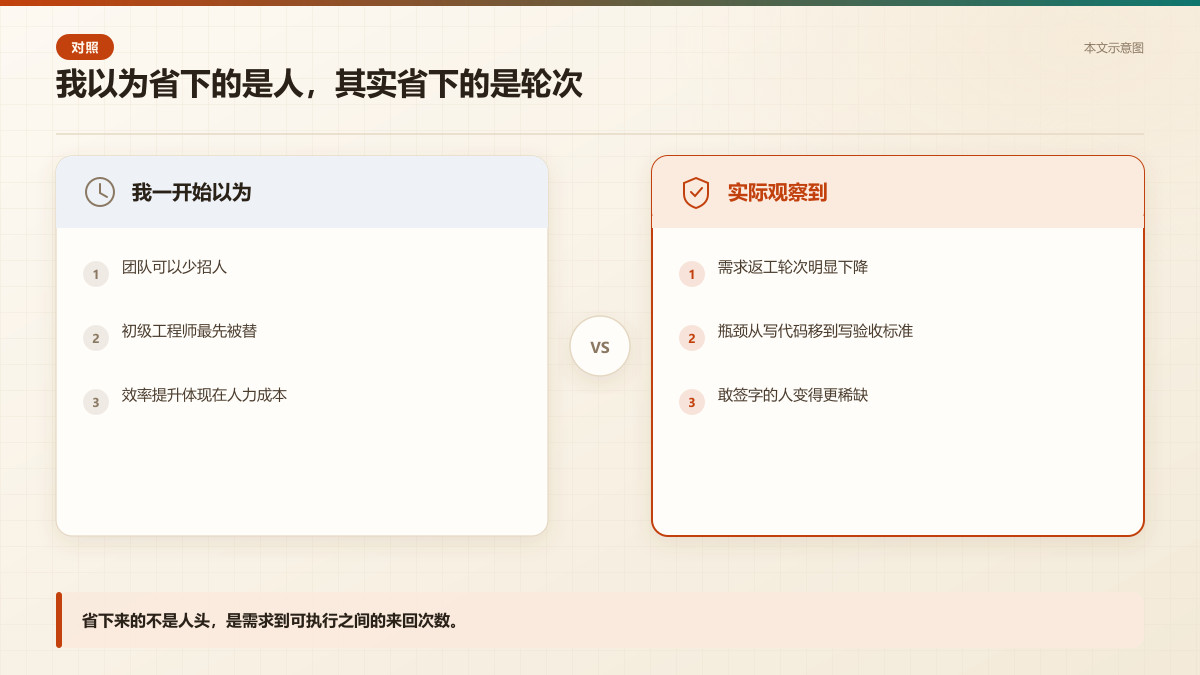
图 3 本文示意图:左边是多数人对 AI 进团队的预期,右边是我在项目里实际观察到的变化落点。
所以团队里得有人能写出验收标准,这件事比写代码难,也比写代码值钱。
第二个前提,代码库要有足够的上下文可读性。
AI 在陌生仓库里表现差,不是模型不行,是它拿不到足够的约束。命名混乱、分层不清的项目,AI 进去就是放大混乱。
第三个前提,责任要能落到具体的人头上。
这条最容易被忽略。AI 写的代码出了事故,谁签字,谁回滚,谁写复盘。
如果团队里没人愿意为 AI 的产出担责,那这套协作迟早会停,因为没人敢让它上生产。
三个前提我按重要性排了序,第三个最硬。
前两个可以靠时间和工具补,第三个只能靠制度,而制度不是工程师一个人能改的。
这也是我对那篇稿子保留意见的地方,它谈变化谈得挺多,谈担责谈得太少。
这周就能动的一步,先量一下你的翻译损耗
与其讨论团队怎么变,不如先量一下自己团队的翻译损耗在哪。
方法很土,把最近十个需求拉出来,看每一个从「提出」到「AI 或人能一次做对」之间改了几轮。
改三轮以上的,问题基本不在实现,在需求描述。
我拿这个方法在一个小项目上跑过,十个需求里六个卡在描述不清,只有两个是实现难度问题。
这个比例我当时有点意外。
量出来之后动作就很明确了,把改轮次最多的那类需求挑一个,让最懂业务的人重写一遍描述,再交给 AI。
量一下翻译损耗(示意代码,统计需求返工轮次,找出瓶颈在上游还是实现)
#!/usr/bin/env bash
# 用法,把最近的需求按行写进 reqs.txt,格式为 需求名,返工轮次
# 只做统计,不接任何外部系统

file="reqs.txt"
if [ ! -f "$file" ]; then
  echo "先建一个 reqs.txt,每行写 需求名,轮次"
  exit 1
fi

total=0
count=0
over=0

while IFS=',' read -r name rounds; do
  [ -z "$name" ] && continue
  total=$((total + rounds))
  count=$((count + 1))
  if [ "$rounds" -ge 3 ]; then
    over=$((over + 1))
    echo "返工偏多 $name $rounds 轮"
  fi
done < "$file"

if [ "$count" -eq 0 ]; then
  echo "没有可统计的需求"
  exit 0
fi

echo "共 $count 个需求,平均返工 $((total / count)) 轮"
echo "其中 $over 个超过三轮,先查这几个的描述"
对比一下轮次有没有降。
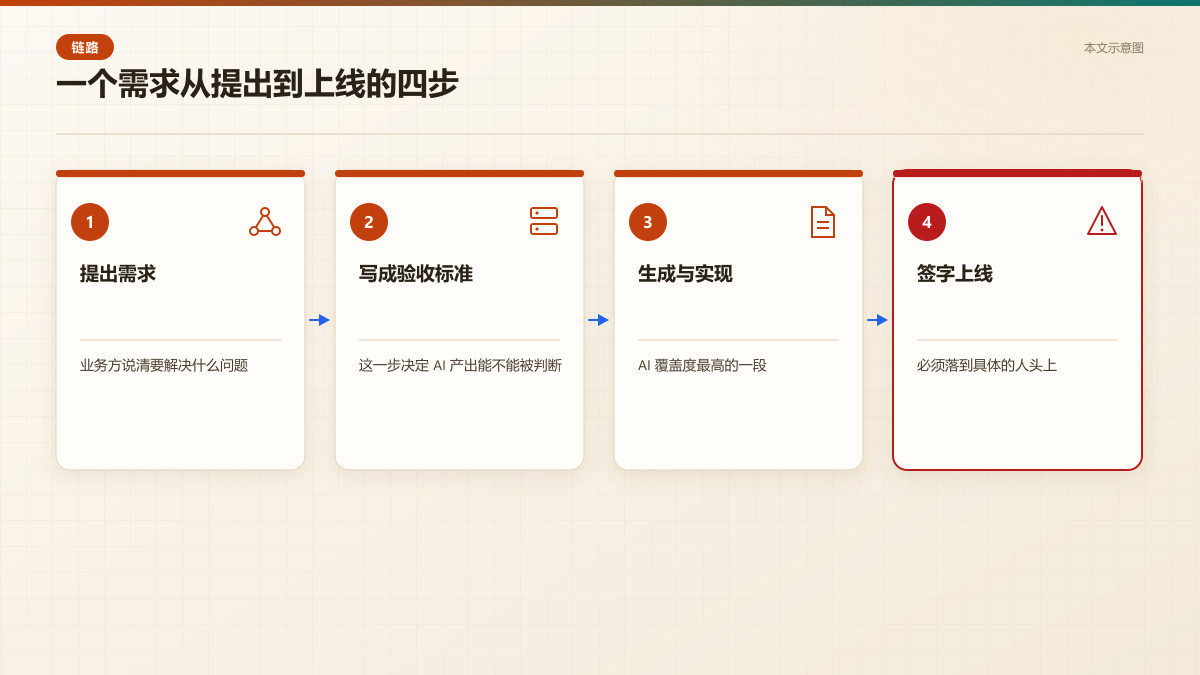
图 4 本文示意图:把链路摊开看,AI 只覆盖了第三步,前三步任何一步含糊都会让整条链路停住。
降了,说明瓶颈确实在上游,接着往上游投人。
没降,说明问题在代码库结构或者验收标准,换方向查。
我不建议一上来就改组织架构、改汇报线,那些动作太大,反馈太慢,量不出来对错。
先量一个需求,再谈团队。
我没查到的那部分,和我不敢下的结论
公开信息里没有这篇报道的完整正文可核,我手上只有标题和发布渠道。
所以上面所有关于「团队怎么变」的判断,建立在我自己带项目和观察同行的经验上,不是从原文推出来的。
这一点必须标清楚,不然就成了借别人的标题讲自己的话。
另外,团队规模这个变量我没法处理。
五个人的团队和五十人的团队,翻译损耗的分布完全不同,小团队里技术负责人一个人就能兼任前两层,大团队里这两层是分开的部门。
我的判断更适用于十到三十人这个区间,再大我不敢讲。
还有一个我确实没验证的,AI 在长期维护型项目里的表现。
我试的都是新建项目,代码库干净、上下文短。
老项目里那些历史包袱会不会让这套协作失效,我没有数据。
留下来的人,是因为能替结果签字
回到那个面试问题,AI 能写 80% 的代码了,公司为什么还需要你。
我的答案不是「因为你会用 AI」,那太浅了。
是因为你能替那 80% 的结果签字。
签字这件事包含三样东西,判断它该不该这么写,验证它写对没有,出事之后扛下来。
这三样 AI 一样都干不了,不是能力不够,是它没有位置。
团队真正在变的,是把人从「生产代码」往「定义正确」上挪。
挪过去的人会越来越贵,挪不过去的人会发现自己和工具在抢同一件事做。
这个分化不会在一天内发生,但它已经在发生了。
所以我不太担心 AI 写掉八成代码,我担心的是有人到今天还以为,那八成代码就是自己的全部价值。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章,我们,下次再见。
写在最后
工具变便宜之后,稀缺的从来不是产出,是判断和担责。团队要变的不是编制表,是把人往「定义正确」那一端挪的决心,挪得动就还有位置,挪不动就只是在和工具抢同一件事做。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号