16 项任务成功率翻倍,具身智能的瓶颈其实不在模型参数
原创
16 项任务成功率翻倍,具身智能的瓶颈其实不在模型参数
原创
Lethehong
发布于 2026-11-21 21:55:48
发布于 2026-11-21 21:55:48
16 项任务,成功率较上一代翻倍,可变形物体操控全球首次打通。这几个数字摆在一起,说明的不是模型又变强了,是训练范式换了一茬。我想聊清楚,翻倍到底翻在哪,这条路线对做具身的人意味着什么,以及如果你今天就想动手,第一步该落在哪。
图 1 本文配图:文章主题场景示意
先别急着喊具身智能成了
11 月 21 日,量子位报了一条消息,GPT-6.2 Astra 在 16 项具身任务上,成功率较 GPT-6 Astra 翻倍,同时实现了可变形物体操控的全球首次打通。
我第一反应不是兴奋,是警惕。翻倍这个词在 AI 新闻里被用得太廉价了,基数是 10% 翻到 20% 也叫翻倍,基数是 70% 翻到 95% 也叫翻倍,两者的含义差了一个量级。
公开信息里没有给每一项任务的绝对成功率,只给了「较上一代翻倍」这个相对值。这就是这次报道最要命的信息缺口。
所以我先把话说在前面,这篇不是来宣布具身智能拐点到了的。我想做的是,把「翻倍」这个说法拆开,看看它背后可能对应哪几种技术路径,每种路径的现实约束又是什么。
可变形物体操控首次打通这句话,含金量比翻倍更高。翻倍是量的变化,首次打通是质的变化,因为它意味着模型开始处理一类之前处理不了的状态空间。
但「打通」不等于「稳定」。机器人叠一件软衣服,成功一次叫打通,连续一百次成功八十次才叫能用,这两件事之间的距离,往往比从零到打通还远。
这句话也是我后面所有判断的底色。方向值得认真对待,程度必须打问号,这两件事不矛盾。
翻倍翻的是数据,不是参数量
我的判断是,这次进步的主因不在模型架构,在训练数据的组织方式。
理由很直接。从 GPT-6 到 GPT-6.2,版本号只跳了一个小位,如果架构有代际变化,命名不会是 6.2 这种小数点后一位的增量。这更像是同一套底座上的一次训练配方升级。
具身任务的成功率,长期卡在三个地方,动作空间的连续性、长程任务的误差累积、以及物体状态的不确定性。前两个是算法问题,第三个是数据问题。
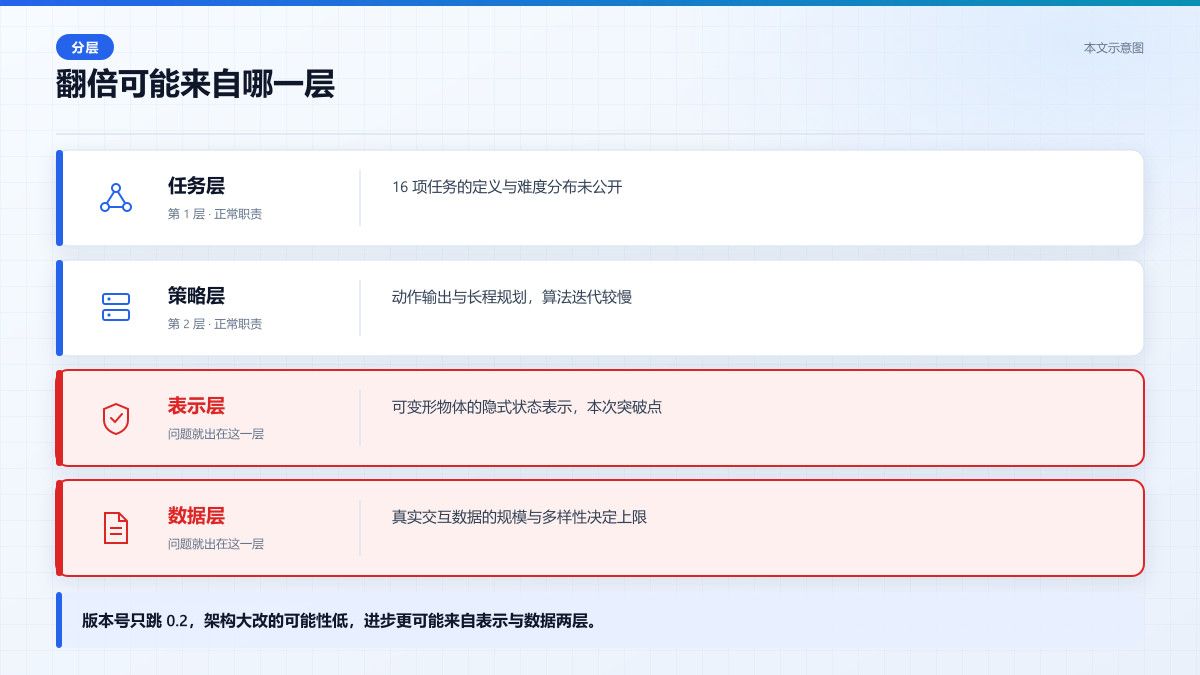
图 2 本文示意图:把具身模型的进步拆成四层,数据层是最可能解释这次翻倍的地方。
可变形物体操控恰好是第三类的极端案例。一块布、一根绳子、一袋米,它们的形状在每一帧都在变,你没法用刚体物理去建模,也没法用几个关键点去标注。
这类任务想做好,靠的是大规模、多样化的真实交互数据。模型见过的布料形态越多,泛化到没见过的那块布上就越稳。
所以我把这次翻倍理解为,数据侧的投入开始出效果了。至于具体是仿真数据、真机数据还是视频预训练,公开信息未披露,我不猜。
这里有个反常识的点。大家习惯把具身智能的进展归因于模型变大,但真机数据采一条要几分钟,一天采不了几百条,这个瓶颈用堆参数是绕不过去的。
参数可以一夜之间翻倍,数据不行。 这就是为什么具身智能的曲线一定比纯语言模型慢,也是为什么每次数据侧的突破,带来的相对提升会显得特别猛。
顺着这个逻辑往下推,如果翻倍真是数据驱动的,那它就不是一次可以等来的进步,是一件必须自己动手攒的事。这也是我后面给动作建议的出发点。
成功率翻倍这件事,得看分母
回到那个信息缺口。16 项任务,每项任务的难度不一样,有的是抓取,有的是装配,有的是折叠,把它们平均成一个「翻倍」,这个数字的参考价值要打折扣。
我做过类似的评测统计,最怕的就是把不同难度的任务混在一起算总成功率。一个简单任务从 90% 到 95%,一个难任务从 5% 到 10%,平均下来也是「显著提升」,但对实际部署的意义完全不同。
真正有信息量的口径是按任务类型分组,抓取类多少、装配类多少、可变形物体类多少,各自的前后对比。这次没给。
按任务类型分组统计(示意代码,演示总成功率如何掩盖不同难度任务之间的真实差异,脚本内数字为构造示例,不是官方结果)
tasks = [
    {'name': 'grasp_cup', 'type': 'rigid', 'before': 0.90, 'after': 0.95},
    {'name': 'fold_towel', 'type': 'deformable', 'before': 0.05, 'after': 0.10},
    {'name': 'insert_peg', 'type': 'rigid', 'before': 0.60, 'after': 0.66},
    {'name': 'knot_rope', 'type': 'deformable', 'before': 0.02, 'after': 0.05},
]

def overall(rows, key):
    return sum(r[key] for r in rows) / len(rows)

def by_type(rows, t, key):
    picked = [r for r in rows if r['type'] == t]
    return sum(r[key] for r in picked) / len(picked)

print('overall before', round(overall(tasks, 'before'), 3))
print('overall after ', round(overall(tasks, 'after'), 3))
for t in ('rigid', 'deformable'):
    print(t, 'before', round(by_type(tasks, t, 'before'), 3),
          'after', round(by_type(tasks, t, 'after'), 3))
还有一种可能,翻倍来自任务集合的调整。如果这一代的 16 项任务和上一代的 16 项不是同一批,那这个对比就不成立。公开信息没说是不是同一套 benchmark。
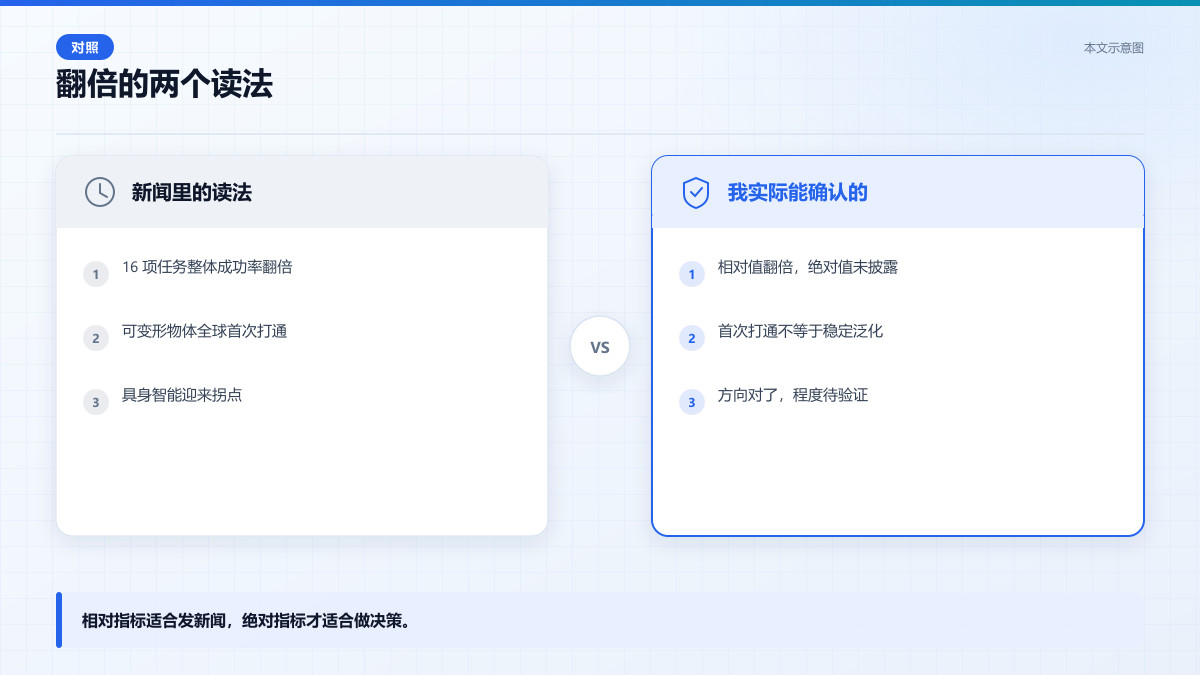
图 3 本文示意图:同一句「成功率翻倍」,在两种口径下指向完全不同的结论。
这不是挑刺,是评估任何模型发布时的基本纪律。我自己看这类新闻,第一件事就是找 benchmark 的名字和版本,找不到就先存疑。
所以我的态度是,翻倍这个信号值得重视,但它证明的是方向对了,不是程度到了。方向对了已经很重要,因为具身智能过去几年最大的问题就是不知道哪条路能走通。
下面这段代码是我自己常用的分组统计小工具,纯粹用来演示「总成功率会骗人」这件事,不是复现任何官方结果。
可变形物体,为什么是分水岭
我想单独说说可变形物体这件事,因为它是判断具身智能是否真的进步的最好试金石。
刚体操控,比如拿一个杯子、拧一个螺丝,状态空间是有限的,物体的位姿可以用六个自由度描述,规划和控制都有成熟的方法。
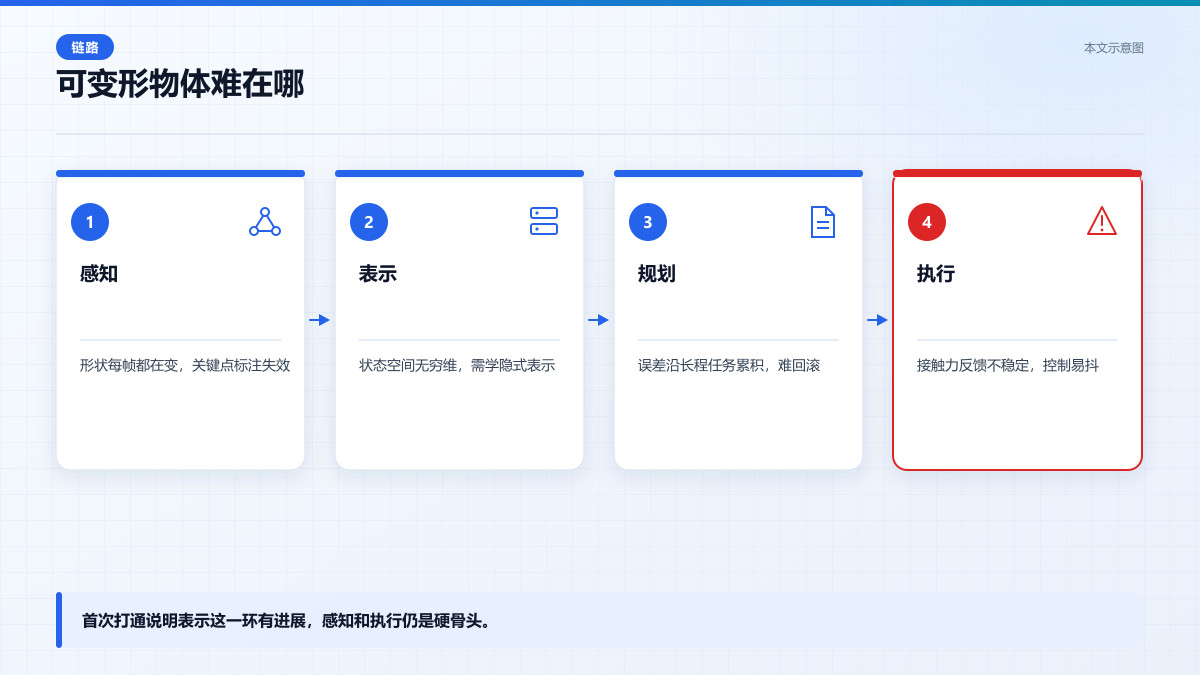
图 4 本文示意图:从感知到执行的四个环节,每一环在可变形物体上都比刚体多一层不确定性。
可变形物体的状态空间是无穷维的。一块布在某一时刻的形状,理论上需要每个点的位置来描述,你没法把它压缩成几个数字喂给控制器。
传统做法是用简化模型,比如把布近似成质点弹簧网络,但这类模型的精度在复杂交互下会崩。
学习类方法的思路不一样,它不去显式建模形状,而是从大量交互里学一个隐式的状态表示。这个表示怎么构造、怎么和动作策略对齐,是这个方向的核心难点。
首次打通说明这个难点被啃下了一块。但打通的具体含义,是单一物体、单一任务的成功,还是多物体、多任务的泛化,公开信息没有细说。
这两者的差别很大。单一任务打通,可能只是过拟合了一个场景;多任务泛化,才说明表示本身学到了东西。
我倾向于认为这次是前者偏多,因为从首次打通到稳定泛化,行业里还没有谁真正跨过去。这个判断是推断,等后续的技术报告出来才能验证。
如果这个推断成立,那对做具身的人来说,可变形物体这块的能力现在还处在「能演示」的阶段,离「能交付」还有距离,排期上不能按成熟能力来算。
这条路线对做具身的人意味着什么
如果你的团队在做具身智能,这次发布最该带走的不是「赶紧换模型」,是「重新审视数据策略」。
过去两年,很多团队把资源压在模型选型和微调上,数据采集靠外包或者小规模自采。如果这次翻倍真是数据驱动的,那这个资源分配就是错的。
具体来说,我会先问三个问题。第一,我的任务里有多少涉及可变形物体或者高不确定性状态?第二,这类任务的数据我有没有,有多少,多样性够不够?第三,我的评测口径能不能分辨出数据带来的提升?
第三个问题最容易被忽略。很多团队有数据,但没有能反映数据价值的评测集,结果数据加了,指标没动,就以为数据没用。
还有一个现实约束,真机数据采集的成本。一台机械臂加一个操作员,一天的有效采集时间可能就四五个小时,这个产能决定了数据规模的天花板。
所以更现实的路径是仿真加真机的混合,仿真里刷多样性,真机上做校正。这条路不新鲜,但这次事件可能会让更多人认真对待它。
真要动手,第一步落在哪
前面几节都是判断,这一节说我自己的动作建议。空话说「及时跟进」没有意义,我给的是能今天就排进日程的三件事。
第一件,今天就做,重跑一次你自己的基线评测。 别管 GPT-6.2 Astra,先把手上模型的评测结果按任务类型拆开,刚体、柔性、长程各算各的成功率。这件事一个人一天能干完,产出的是一张你后面所有决策都要用的底表。没有这张表,任何新模型发布你都只能凭感觉判断要不要跟。
第二件,这周做,盘一遍数据资产。 列清楚你手上有多少条柔性物体交互数据、多少条长程任务数据、覆盖了多少种物体形态。如果柔性物体那栏是零或者个位数,那这次发布对你的直接价值就很低,因为就算模型能力到了,你也没有能喂给它的东西。
第三件,这个月做,改评测集。 把总成功率拆成分类型成功率,再加一列失败模式分类,是抓空、是滑脱、还是中途状态丢失。这一步做完,你才有能力分辨下一次发布里哪些是真提升、哪些是口径游戏。
如果这三件都做不了,比如团队就两个人、机器还在路上,那过渡办法是,先只做第一件里最轻的那一半,找三个你最有把握的任务,手工跑二十次,记下成功次数。样本小,但比没有强,而且能立刻暴露你对自家系统到底有多不了解。
至于要不要现在就换模型,我的判断是,如果你在做可变形物体相关的任务,今天就该去看自己数据集的覆盖度;如果做的是标准抓取装配,这次发布的直接冲击有限,不用慌,把评测口径补齐比追新版本更值。
这三件事有个共同点,全都不依赖你能不能拿到 GPT-6.2 Astra。这也是我建议先做它们的原因,外部模型的访问权限你控制不了,自己的评测和数据盘你控制得了。
我怎么验的,以及我没查到什么
这一节我得把话说透,不然前面那些判断就成了没有地基的房子。
先说验证。这篇里没有一个数字是我自己跑出来的。我手上没有 GPT-6.2 Astra 的访问权限,也没有配套的机器人平台,所以翻倍这个结论我无法独立复核。我做的只有两件事,一是把公开报道里的表述逐句拆开,看哪些是可核验的、哪些是转述;二是用自己写的分组统计脚本演示「总成功率会掩盖难度差异」这个统计现象,脚本里用的数字是我构造的示例,不是任何官方结果,这一点必须标清楚。
核对评测集版本(示意代码,确认两代模型报的是不是同一套任务集合,否则对比不成立)
#!/usr/bin/env bash
# 假设评测结果以 json 存放在本地 results 目录
set -euo pipefail

for f in results/gpt6-astra.json results/gpt6.2-astra.json; do
  if [[ ! -f "$f" ]]; then
    echo "missing: $f"
    continue
  fi
  echo "== $f"
  # 抽出 benchmark 名称、版本、任务数量
  python3 - "$f" <<'PY'
import json, sys
p = sys.argv[1]
d = json.load(open(p))
print('benchmark', d.get('benchmark'))
print('version  ', d.get('version'))
print('num_tasks', len(d.get('tasks', [])))
print('task_ids ', sorted(d.get('tasks', {}).keys())[:5], '...')
PY
done
再说查不到的部分。第一,16 项任务的具体清单、每项任务的绝对成功率、benchmark 的名称和版本,公开信息都没有。所以我没法判断翻倍的分母是多少。
第二,GPT-6.2 Astra 的训练数据构成、模型规模、是否用了新的架构组件,都没有披露。我说「主因在数据」,是从版本号命名和任务特性推出来的,不是从技术细节读出来的。
第三,可变形物体操控的「全球首通」,具体通的是什么任务、什么物体、什么评测条件,没有细节。这个说法的分量,要等复现或者第三方评测才能坐实。
按同类组件的通用规律推断,具身模型的发布往往先给相对指标,等技术报告出来才会补绝对数字和失败案例。这条规律是我从过去几年的发布节奏里总结的,不是这次事件的官方说明。
所以如果你要拿这次发布做决策依据,我的建议是,把「翻倍」当成一个待验证的信号,而不是结论。信号足够强,值得你今天就去做第六节里的第一件事;结论还不够硬,不值得你为此改路线图。
说到底,具身智能这个领域最不缺的就是漂亮的 demo 和惊人的相对数字,最缺的是能复现的绝对指标和诚实的失败率。这次发布有没有跨过这条线,我现在不敢下结论。
写在最后
具身智能这些年最不缺的就是惊人的相对数字,最缺的是能复现的绝对指标和诚实的失败率。这次翻倍是不是拐点,我不急着下结论,但我会先去做那三件不依赖任何外部模型的事,重跑基线、盘数据、改评测口径。你也可以从第一件开始,跑完再回来看这句话对不对。以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章,我们,下次再见。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号