纯离线安装大模型推理引擎,部署量化大模型

大家好,我是 Ai 学习的老章
继续介绍大模型推理引擎+Llama.cpp,前文我写了# 内网部署 llama.cpp,运行量化大模型,详细介绍了 llama.cpp 这个推理引擎,内网离线 cmake 编译安装、开启 GPU 加速、Llama.cpp 的使用及核心参数深度解析等。
文中我也说了:源码编译其实蛮看运气的,比如我生产环境的一台 RHEL 系统的服务器,yum 源很不给力,仅仅是升级 GCC 都费老大劲,各种依赖安装到吐血。
本文我们用个更省事儿的内网离线部署方式——Docker,然后用其部署量化大模型,其中踩坑若干,才有如此精炼、极简教程
1、联网环境拉取 llama.cpp 镜像并保存
选择镜像最好是官方,比如 llama.cpp 提供的有不同版本,不同用途的镜像
我选择的是 ghcr.io/ggml-org/llama.cpp:server-cuda
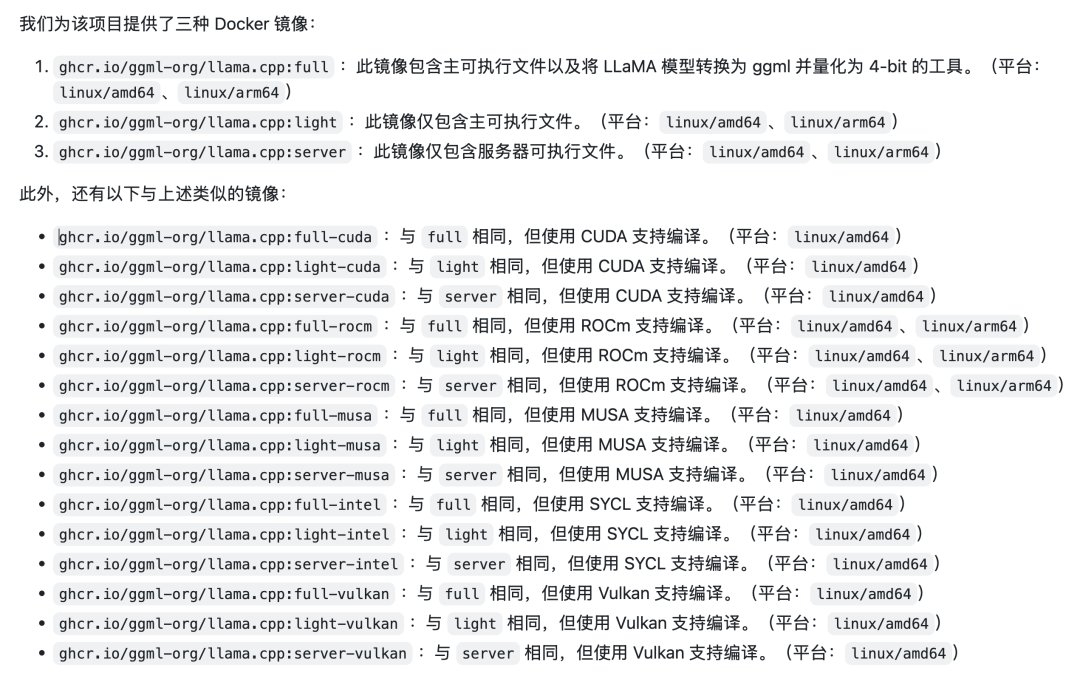
https://github.com/ggml-org/llama.cpp/blob/master/docs/docker.md
https://github.com/ggml-org/llama.cpp/blob/master/docs/docker.md
市面上有很多个人打包的镜像,大多都是阉割版
费老大劲搞进去,发现大模型无法加载
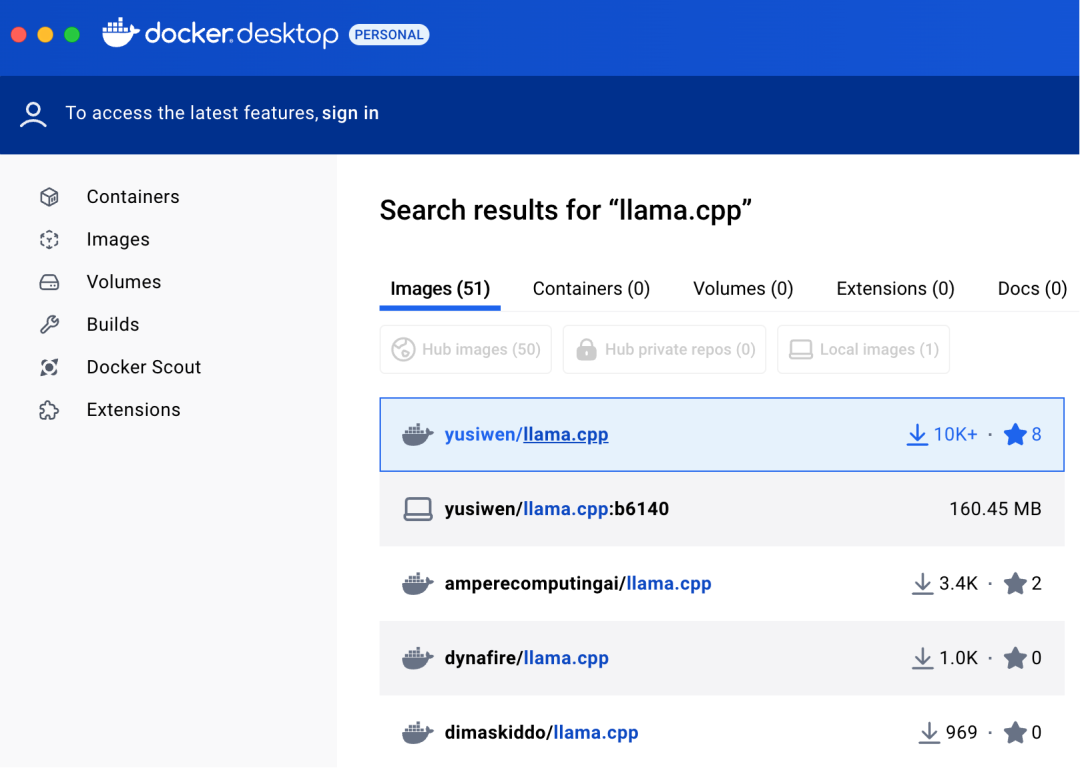
当然,你也可以自己构建 docker
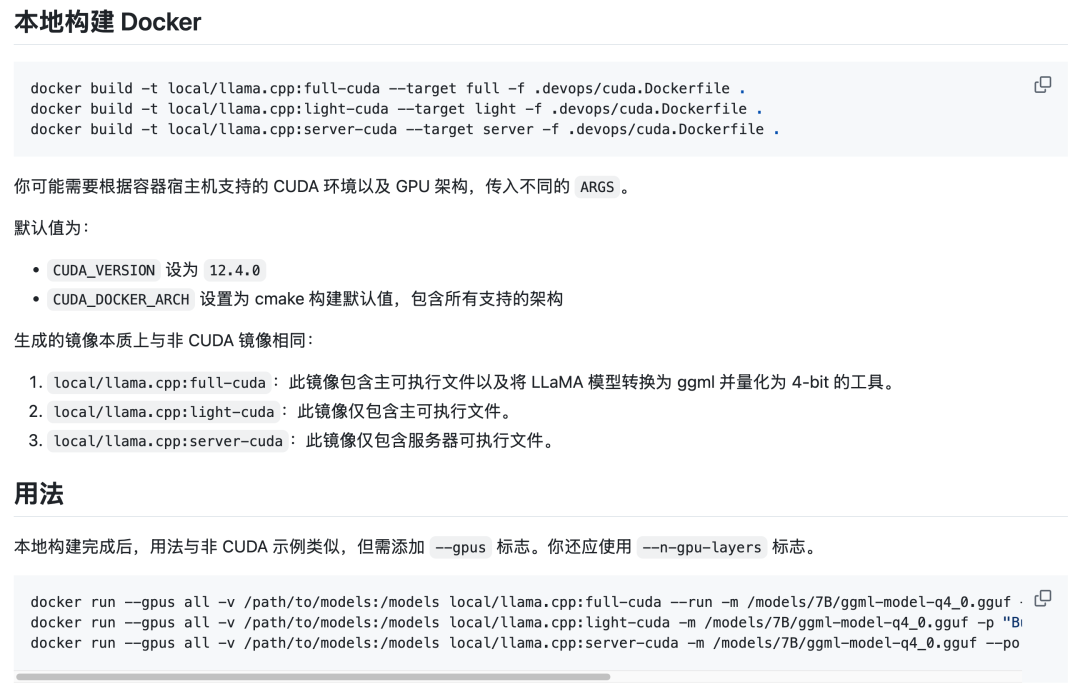
下载及保存镜像命令:
# 下载核心服务镜像(指定 linux/amd64 平台)

docker pull --platform linux/amd64 ghcr.io/ggml-org/llama.cpp:server-cuda

# 保存镜像到tar文件
docker save ghcr.io/ggml-org/llama.cpp > llama.cpp.tar
2、镜像传入内网
不赘述,不同公司有不同工具可以在办公网与生产内网传输数据。
3、**在内网服务器(x86)加载镜像
# 加载镜像,加载过程需要一些时间,完成后,Docker 会输出加载的镜像信息。
docker load i llama.cpp.tar
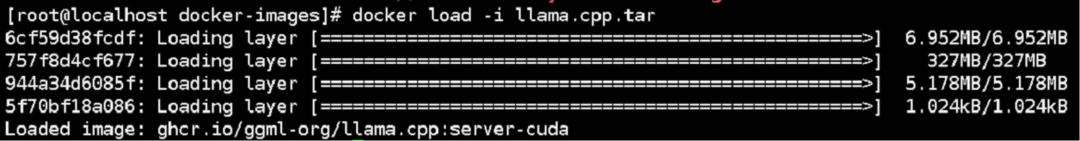
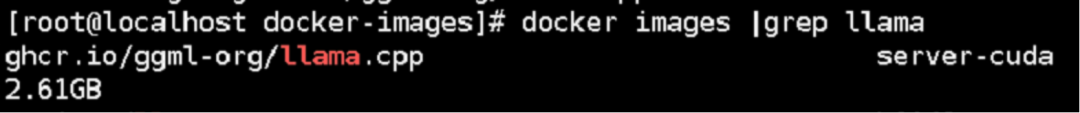
# 运行 docker images 命令来查看本地镜像列表,确认llama.cpp已经成功加载。

docker images
4、准备模型文件
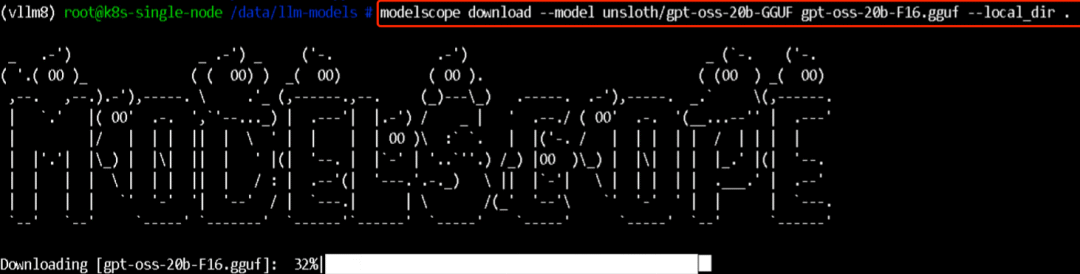
这个也需要办公网下载好(我一般去 modelscope 下载)
pip install modelscope 之后,即可使用 modelscope download 下载模型
下载完整模型库
modelscope download --model unsloth/gpt-oss-120b
下载单个文件到指定本地文件夹(以下载 README.md 到当前路径下“dir”目录为例)
modelscope download --model unsloth/gpt-oss-120b README.md --local_dir ./dir
再传入内网:
llama.cpp 服务需要模型文件才能运行,在你的 Linux 服务器上创建一个目录,用来存放 GGUF 格式的模型文件。
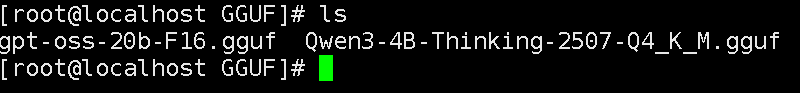
5、启动大模型
docker run --rm --runtime nvidia -e TZAsia/Shanghai --gpus "device=2" -v /opt/data/ai/GGUF:/models --name oss-20b-server -p 8005:8000 ghcr.io/ggml-org/llama.cpp:server-cuda -m /models/gpt-oss-20b-F16.gguf --port 8000 --host 0.0.0.0 -c4096 -n 1024 -ngl 999
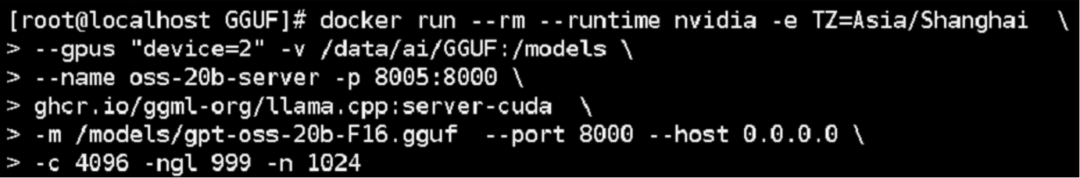
可以看到已经启动成功

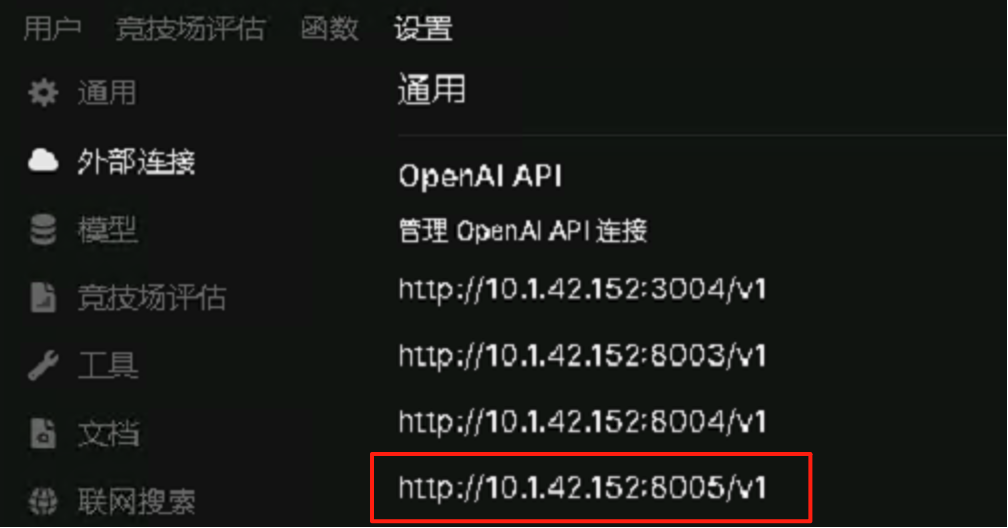
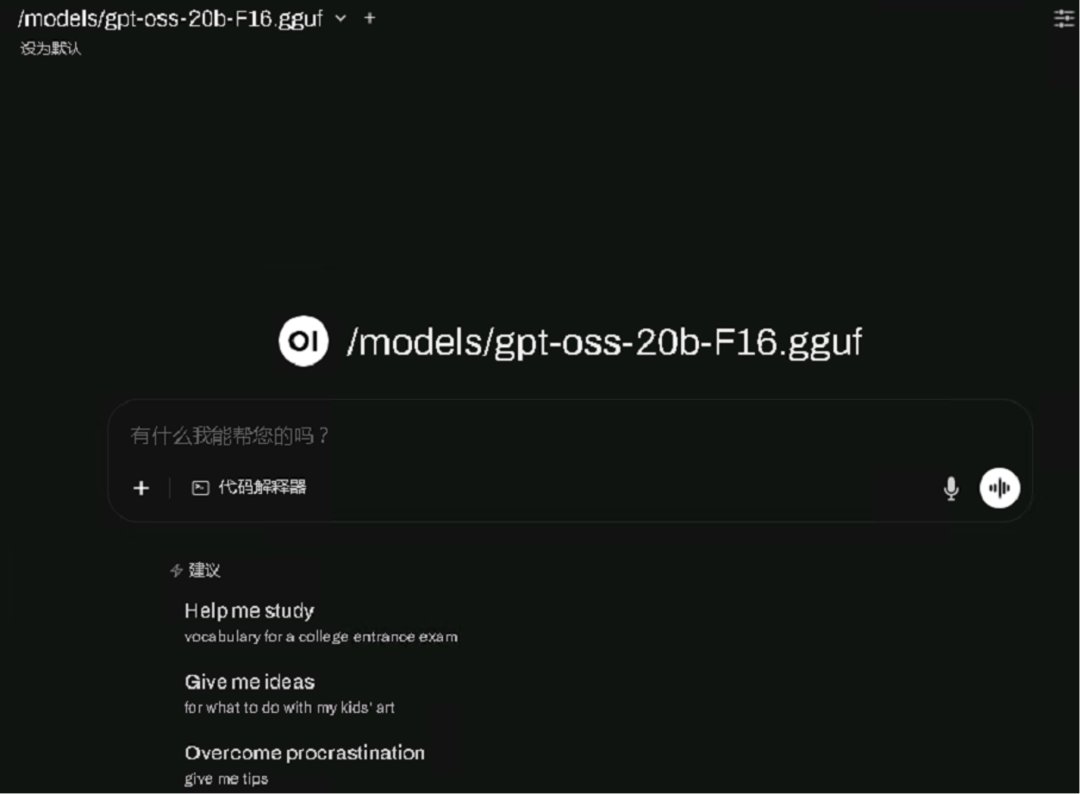
6、接入 open-webui
最后再推荐一个我正在学习的课程
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2025-08-25,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号