DeepSeek V4.1 Flash 推理强?看它如何和 Astra 做论文实现答辩
原创
DeepSeek V4.1 Flash 推理强?看它如何和 Astra 做论文实现答辩
原创
七牛开发者
发布于 2026-09-11 17:29:23
发布于 2026-09-11 17:29:23
昨天 DeepSeek V4.1 Flash 发布后,我们想来做个测评,但是鹈鹕骑车、放烟花之类的测试 case 太常见了,现有代码仓库又比较敏感。所以,思前想后,我们这次换了一个稍微麻烦点的测试。
把一篇论文 PDF 放进空项目,让 DeepSeek V4.1 Flash 自己读论文、理解公式、实现核心算法、写测试,再设计实验验证自己的实现。
等它认为任务完成后,再换 GPT-6 Astra 上场锐评。Astra 会重新阅读论文,对照 V4.1 Flash 写出的代码、测试和实验结果进行 Review。随后把 Review 交回 V4.1 Flash 答辩和修订,再让 Astra 继续复审。
最后一共跑了三轮。
当然喜闻乐见的 DeepSeek V4.1 Flash 不堪一击没发生,结果是:Astra 三轮都没有推翻 V4.1 Flash 的核心算法实现。被一轮轮修正的,主要是 V4.1 Flash 自己搭建的实验、统计方式,以及它对实验结果的解释。
实验任务
这次使用的是论文:LibraSpec: Dynamic Diffusion-Based Speculative Decoding via Marginal-Gain-Driven Optimization。
LibraSpec 研究的是基于扩散模型的推测解码中的动态推测长度选择。
在推测解码中,草稿模型会先生成一批候选 token,再交给目标模型验证。候选长度太短的话,并行验证能力会利用不足;长度太长的话,如果前面的 token 较早被拒绝,后面的验证计算也可能被浪费。
LibraSpec 把这个问题转成期望加速比优化,并根据增加候选 token 带来的边际收益判断是否继续延长。论文最终给出算法 1,根据草稿模型的置信度迭代决定当前解码轮次的推测长度。
为什么选 LibraSpec
这篇论文适合把“读论文”和“写代码”放进同一个可验证任务。
它既有理论推导,也给出了可以落到代码里的算法 1。模型需要先理解公式、变量和停止条件,再把这些内容映射成实现。
同时,它有比较明确的验证空间。完成实现后,可以通过单元测试、穷举对照和模拟置信度输入检查算法行为;代码能够运行以后,还可以继续检查测试、统计与结论之间有没有脱节。
这样 Astra 的 Review 也有明确依据:论文、代码和实验结果都放在同一个项目里,可以逐项核对。
V4.1 Flash 初版
我们通过 dsh 接入 DeepSeek V4.1 Flash,把论文放进项目目录。
第一轮没有让它马上写代码,而是先要求它整理 LibraSpec 要解决的问题、核心公式和变量、marginal gain 的作用、算法 1 的完整流程,以及论文明确规定和没有交代清楚的实现细节。完成论文分析后,再让它做一个最小复现。
这里没有搭建完整的大模型推理系统,也没有复现论文里的端到端性能实验。任务范围被限制在 LibraSpec 的核心 speculative-length selection。
V4.1 Flash 最后自己实现了核心选择器(selector)、目标函数(objective)、穷举基线(brute-force baseline)、实验脚本和测试。
实验使用模拟置信度分布,并设置 q=p,再通过穷举搜索枚举当前目标函数下的最优推测长度,与 LibraSpec 算法 1 的选择结果比较。
第一版跑出了 82 项测试,全部通过。然而,Exact Match 的数值让我们有点吃惊。这里的 Exact Match,是指 LibraSpec 选出的推测长度,与穷举搜索得到的最优长度完全一致的案例比例:
实验 | Exact Match | Within-1 | Mean Ratio |
论文预设参数 | 8.89% | 20.00% | 0.876 |
随机 Confidence | 11.04% | 29.79% | 0.868 |
随机配置 | 10.30% | 22.80% | 0.795 |
8.89%、11.04%、10.30% 意味着,在这几组实验中,只有大约 8%~11% 的案例,LibraSpec 选出的推测长度与穷举搜索得到的最优长度完全一致。
两边的长度差这么多,第一反应很容易是:V4.1 Flash 是不是把论文里的算法 1 实现错了?
于是 Astra 上场。
Astra 一审
第一轮 Review 从穷举基线、核心算法实现、测试和实验设计几个方向展开。
Astra 的结论是:当前 8%~11% 的 exact match,不能据此判定 V4.1 Flash 把 LibraSpec 的核心算法写错了。它重新核对算法 1 后认为,V4.1 Flash 对后缀收益计算、逐位置长度上界、取各位置约束的最小值、初始化、扩展、停止和单次回退等主要流程的转写基本符合论文。
低 exact match 的一个重要来源,是论文的实用算法 1 使用固定 α、当前窗口和单次回退;穷举搜索的则是给定完整概率序列和成本函数下的全局最优。两者没有建立严格等价关系。
来看一个直观的例子:在 FastdLLM 预设 n=10、d_max=60、α=2,并使用仿射成本 T(d)=1+0.05d 时,设 q=p=0.9:
- LibraSpec 算法 1 选择
d=14; - 穷举搜索最优长度为
d=15; - exact match 为 False;
- 两者目标值之比约为 0.999756。
换一种成本函数,穷举搜索的最优长度也会随之变化。这个例子同时暴露出另一个问题:实验使用了多种 cost model,算法 1 的固定 α 却没有与这些成本环境建立对应关系。
把符合 Eq.(15) 假设的三组仿射成本单独拿出来,一审重新计算后,81 个案例的 exact match 依然只有 8/81,也就是 9.88%。
Astra 同时找出了实现外围的问题。
例如 V4.1 Flash 构造的 ConstantCost 认为总成本不会随长度增加,但又给新增位置设置了非零边际成本,这两个定义彼此矛盾;平均长度误差又使用了最优集合的上端点,没有计算到最近最优长度的距离。82 项测试全部通过,也无法证明最终推测长度达到了全局最优。
问题开始从“代码有没有写对”延伸到了另一个层面:模型自己搭出来的验收体系,可信吗?
V4.1 Flash 答辩
我们把 Astra 的完整评审交还给 V4.1 Flash,要求它逐条判断:接受、部分接受、拒绝,或者论文信息不足。
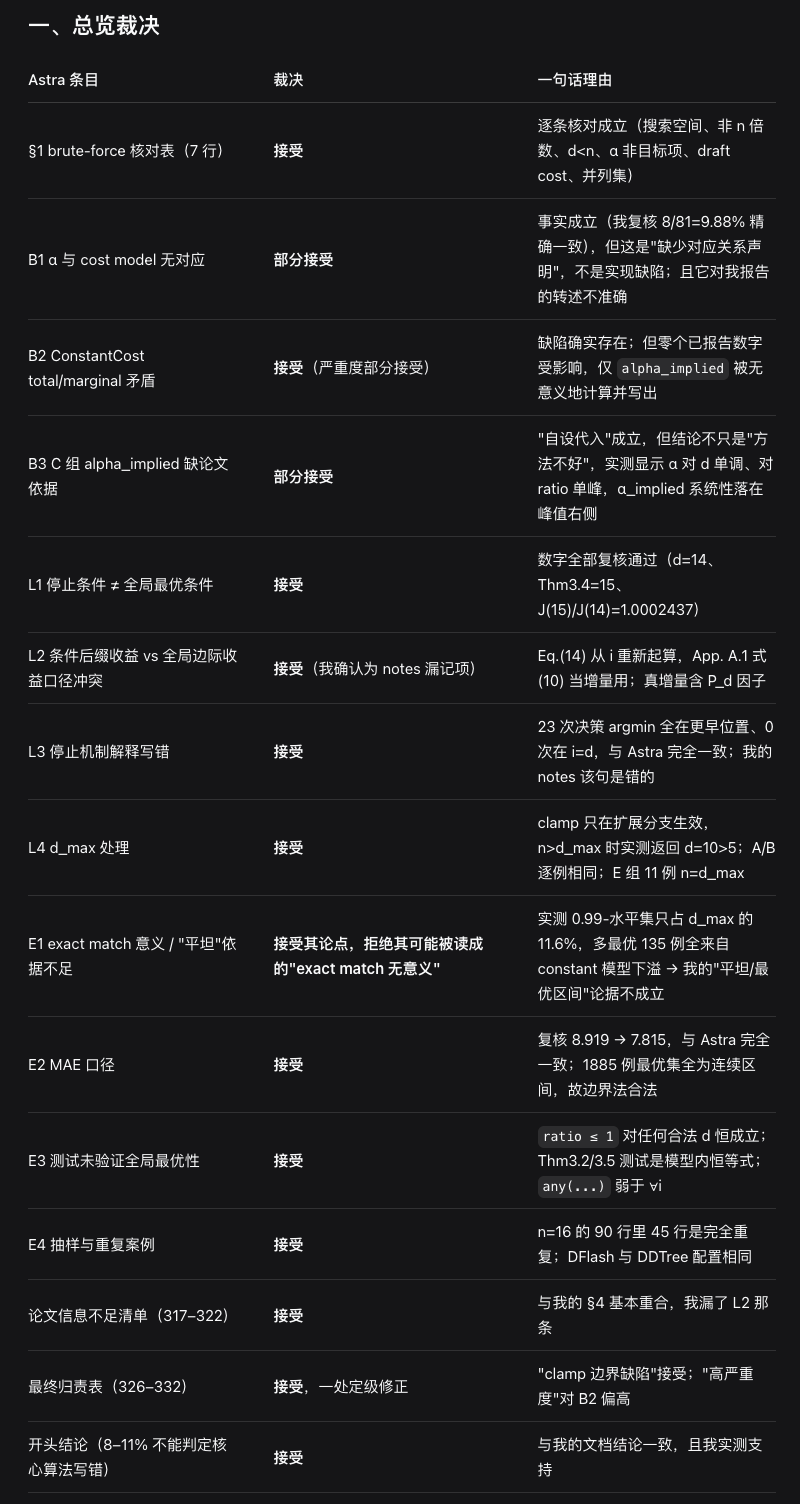
这一轮开始出现真正的模型分歧。其中一处分歧围绕 α。
Astra 一审指出,实验使用了多种成本模型,但选择器对同一个置信度分布仍使用同一组固定 α。这样一来,LibraSpec 的输出不会随着成本模型改变,穷举搜索得到的最优长度却会发生变化。Astra 把这一项归为对照模型与实验设计问题。
V4.1 Flash 接受“当前实验没有建立 α 与成本模型对应关系”这一事实,但拒绝把“α 与成本模型绑定”作为修复方式。它认为,只要让 α 依赖成本,就会改变论文中的算法 1。
除了回应 Astra,V4.1 Flash 还继续检查了几处相关问题,包括停止机制的解释、定理 3.2(Theorem 3.2)测试使用的区间定义,以及线性成本下最优集合的说明。
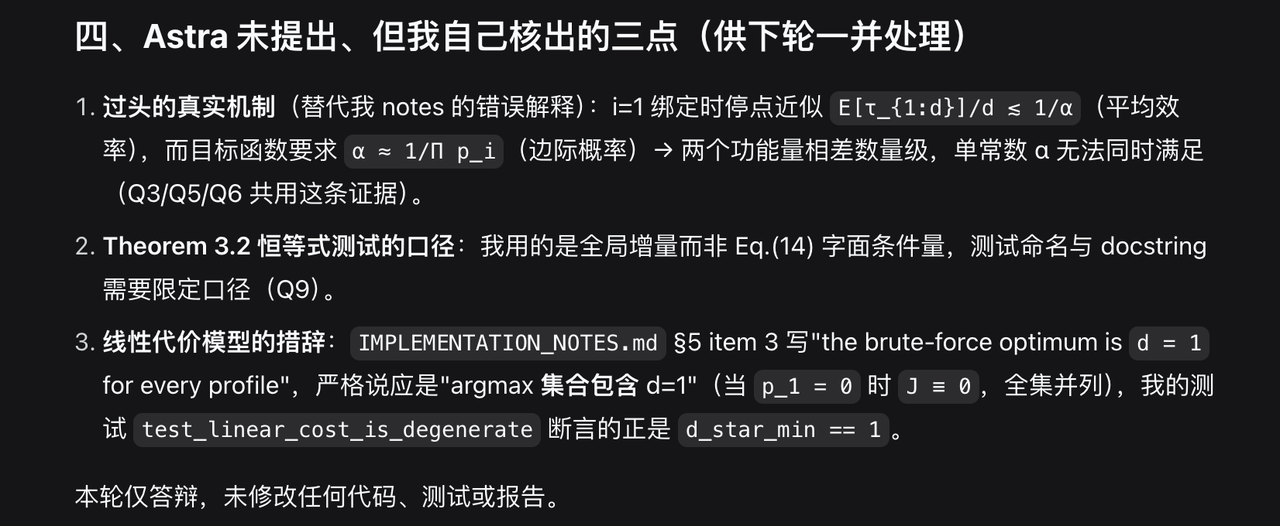
这些答辩和自查随后一起进入第一次修订,再交给 Astra 复审。
第一次修订
根据一审和答辩结果,V4.1 Flash 完成了第一次修订。测试从 82 项增加到 97 项,全部通过。
这一轮确实修改了 core.py。
针对 Astra 一审指出的 L4,当 clamp_to_d_max=True 时,初始长度被改成:
d = min(n, d_max)这条路径在实验中确实被使用。1,858 个共有案例中,有 1,723 个案例开启了最大长度限制(clamp)。
不过这些案例都没有出现 n>d_max,因此新增的初始 clamp 条件没有改变实际取值。修订前后 1,858 个共有案例依然保持 0 个推测长度决策变化。
更多修改集中在成本模型、统计、测试和实验解释上。
例如平均长度误差修正后:
- A 组从 8.919 降到 7.815;
- E 组从 9.357 降到 8.307。
C 组的平均目标值比(Mean Ratio)从 0.674 变成 0.800,原因是排除了 27 个不适用的常数成本案例,因此不能把这个变化理解成选择器性能提升。
第一次修订还单独统计了 A 组中的仿射成本案例:81 个案例的完全匹配率(Exact Match)为 9.88%,平均目标值比为 0.9638。
Astra 二审
97 项测试全过,实验结果也能从当前代码重新复现。但二审继续发现:计算能够复现,围绕这些计算给出的解释依然存在问题。这一轮,Astra 维持“算法 1 核心实现基本符合论文”的判断,同时继续找出四类问题。
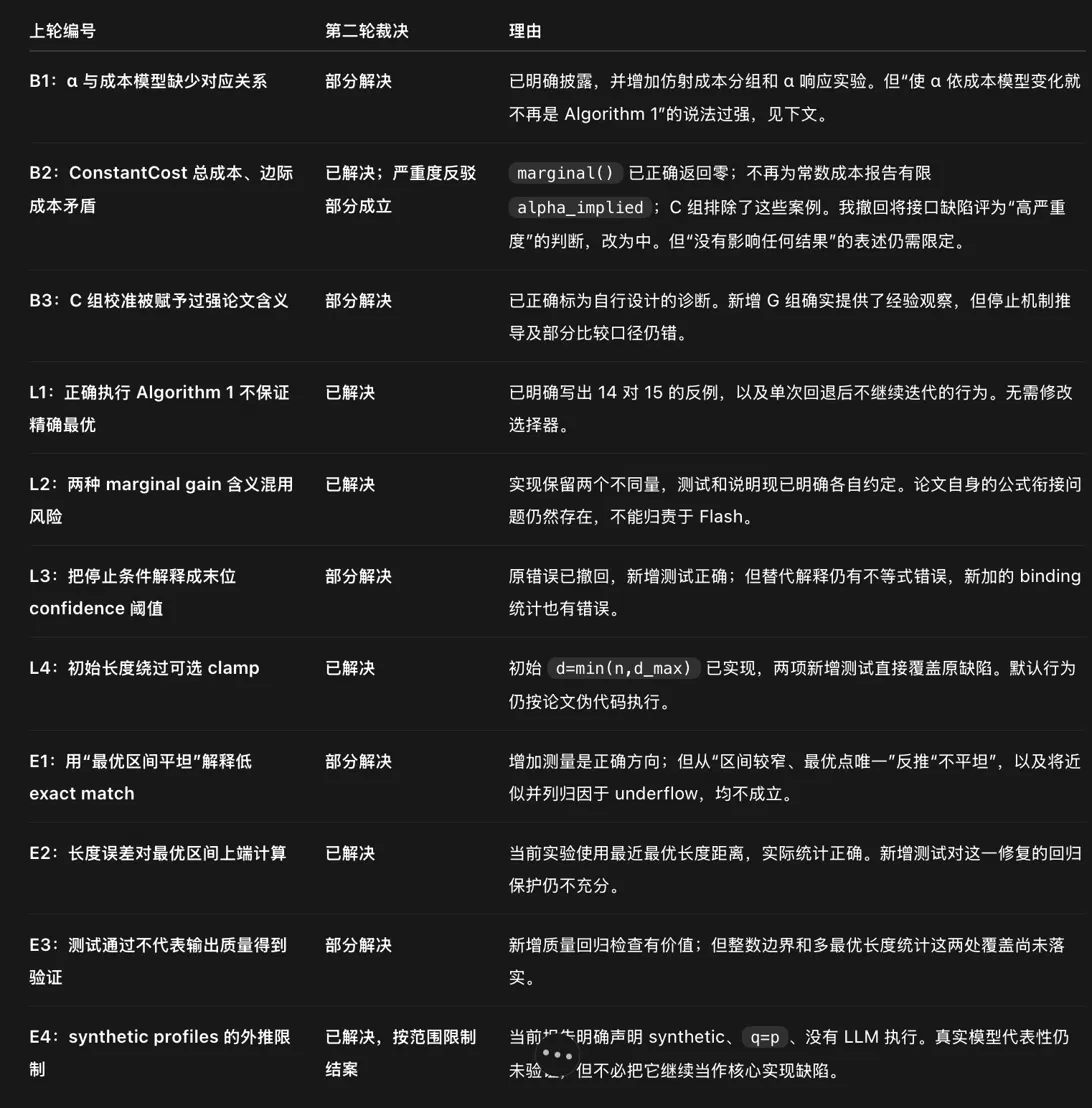
第一类是停止条件和 α 的数学解释。第一次修订撤回了原来的末位置信度解释,并提出新的推导。Astra 二审认为,这一部分还有三处问题。
首先,停止与回退条件中的不等式写错了。
其次,V4.1 Flash 又进一步得出了一个过强结论:单一固定 α 无法让实用规则与目标最优对齐。Astra 给出了反例。仍然使用前面的 q=p=0.9、FastdLLM 配置和 T(d)=1+0.05d,把 α 改成 2.05 后,算法 1 会选择 d=15=d*,目标值比也达到 1。这个反例说明,固定 α 在特定配置下可以命中穷举搜索得到的最优长度,因此原来的普遍结论不成立。
第三处问题来自式(7)。V4.1 Flash 把式(7)右侧的阈值写成固定的 1/α。Astra 指出,只有定义一个随当前状态变化的 α_d = T(d) / (cF(d)) 时,式(7)的阈值才能写成 1/α_d。这里的 α_d 与算法 1 一次选择中使用的固定 α 不是同一个量。
第二类是统计。V4.1 Flash 新增了“哪个位置起约束作用”的诊断,但代码只记录并列最小位置中的一个位置。Astra 重新计算后发现:
- A 组末位约束从
10/135变成20/135; - E 组从
80/989变成133/989。
这个错误不会改变推测长度,却会影响对停止机制的解释。
第三类是浮点和最优集合。第一次修订把 126 个多成员最优集合归因为下溢。Astra 复查后发现,这些前缀概率并没有下溢到 0,其中还包含容差分组和浮点舍入等因素。
与此同时,“最优点唯一”或者“0.99 水平集较窄”,也不足以推出最优点附近的目标函数不平。在前面的 q=0.9 仿射案例中:
- 最优长度只有 15;
- 0.99 水平集是 13~17;
- 算法 1 选择 14;
- 目标值损失只有约 0.0244%。
唯一最优、小范围和很小的值损失可以同时出现。
二审还发现,第一次修订中新写的线性成本说明本身存在错误。V4.1 Flash 声称只有 E[τ_d]=0 时才会出现多个最优长度,但 Astra 给出了 p=(0.5,1,1,0.5) 的反例:在线性成本下,最优集合可以是 {1,2,3},目标值均为正数 0.5。
第四类是报告数字和比较范围。Astra 发现四处统计数字或比较口径没有对齐,例如 C 组 0.800 与 A 组比较时用了不同的样本范围,仿射组中位数、扩展收益提升和一个 alpha_implied 示例的数字也需要重新计算。
测试覆盖
二审还有一个挺有意思的部分:Astra 开始 Review V4.1 Flash 为第一轮问题新增的测试。
第一次修订新增了 15 项测试。其中不少确实覆盖了原问题,比如初始 d_max clamp、ConstantCost 的边际成本,以及末位置信度不能单独决定停止。
但 Astra 继续检查后发现两个覆盖缺口。一个号称检查整数边界的测试,实际执行了 153 次扩展检查,整数边界分支 0 次。
另一个用于防止“多最优长度距离统计”回归的随机测试,抽到的 50 个案例全部只有单一最优长度,恰好没有覆盖原来出问题的情况。
“补了测试”本身,也需要接受 Review。
V4.1 Flash 第三轮
我们把二审结果再次交给 V4.1 Flash。
这次它修正了停止条件推导、式(7)的阈值解释、并列最小位置统计、容差最优集合说明和四处实验数字,同时补齐了二审指出的两个测试缺口。测试数量从 97 增加到 110,全部通过。
这一轮没有再修改 core.py。与第一次修订相比,1,858 个共有案例依然保持 0 个长度决策变化。第二次修订主要集中在诊断、统计、测试和报告层。
同时,V4.1 Flash 撤回了两项此前的过强判断。一项来自 Astra 给出的 α=2.05 反例,“单一固定 α 无法对齐”的普遍结论被撤回。
另一项来自 B1。V4.1 Flash 也撤回了“α 只要依赖成本环境就会改变算法 1”的说法。
第二次修订进一步把范围划清:如果在一次选择过程中,用各位置动态变化的 α 替换算法 1 中的固定 α,会改变论文里的实用算法;如果根据模型、硬件或成本环境,在一次选择开始前选定一个固定 α,则仍然符合算法 1 的形式。
对于停止机制,V4.1 Flash 还保留了另一层区分:当 i=1 起约束作用时,实用规则比较的是平均接受长度,而式(7)描述的是边际接受概率。与此同时,式(7)一侧原来写成固定 1/α 的阈值,也改成了对应状态下的 1/α_d。
Astra 三审
最后一次,我们让 Astra 只做验收,不再扩大 Review 范围。它给出的最终 verdict 是:
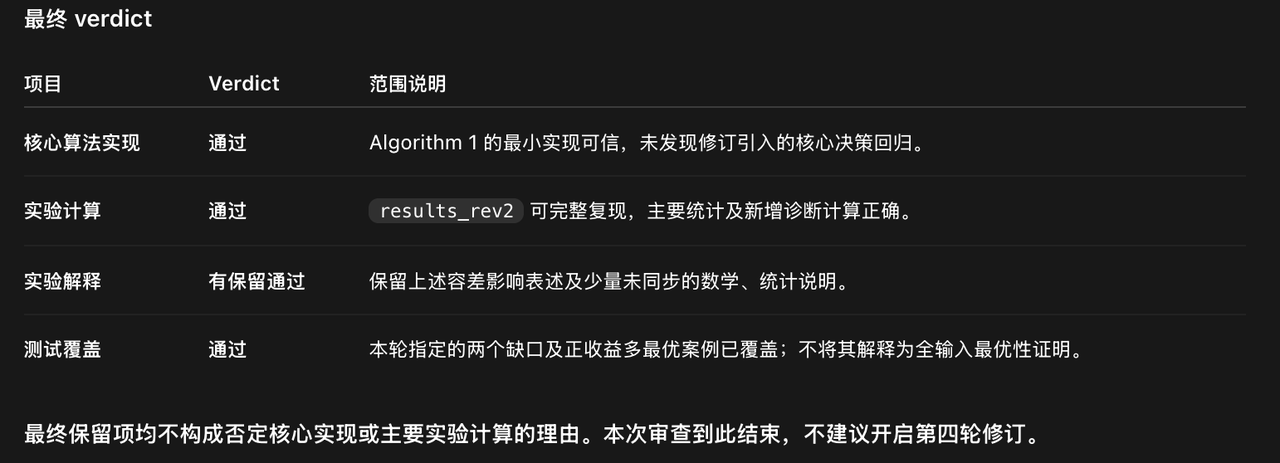
二审指出的并列最小位置统计、整数边界测试、多最优长度聚合链路,以及线性成本下正收益多解等问题,都在第二次修订中得到处理。
三审仍保留了少量解释层问题。其中影响相对大的一项来自最优集合的容差定义:切换“容差内最优集合”和“严格浮点最优集合”不会改变这批数据的 Exact Match、Within-1 和 Ratio,但会改变最近最优距离。例如,A 组 MAE 会从 7.815 变成 8.163。因此,第二次修订中“不会影响任何报告数字”的表述范围过宽。
另外还有几处低影响残留。停止条件说明仍把 αF(d) ≤ d−1 称为回退条件,实际回退条件应为 αF(d) < d−1。测试注释中还保留着旧的 0.447 统计数字,以及“0.99 水平集较窄,因此长度差不能用平坦性解释”这一旧推论;对历史 0/23 起约束结果的原因描述也不够准确。
Astra 最终认为,这些残留不会改变核心算法 1 的实现和主要实验计算,因此三审到这里结束,没有再开启第四轮。
三轮之后
这个实验最初想回答的问题是:DeepSeek V4.1 Flash 能不能读一篇论文,把算法写出来?到最后,答案分成了三层。
第一层是代码。在这次 LibraSpec 最小复现中,V4.1 Flash 第一版写出的算法 1 主体经受住了 Astra 三轮检查。第一次修订修改了初始 clamp 行为,但没有改变本次 1,858 个共有实验案例的长度决策;第二次修订没有再修改 core.py,长度决策依旧全部保持一致。
第二层是验证。V4.1 Flash 能给自己写测试,也能设计穷举基线和实验,但后续 Review 陆续发现了成本模型、统计口径、测试覆盖和比较范围等问题,测试数量也从 82 → 97 → 110 一路增加。
第三层是解释。这一层反复出现的问题最多。算法输出可以正确,测试可以全部通过,实验也可以重复跑出来,模型依然可能在“为什么得到这个结果”上给出证据不足、范围过大,甚至数学条件不成立的结论。V4.1 Flash 会这样,Astra 的判断同样需要接受后续证据检验。
例如,一审把 ConstantCost 的接口问题评为高严重度。V4.1 Flash 根据调用链提出反驳后,Astra 在二审中把严重度下调到中等,并确认错误的 marginal() 没有进入主要目标函数计算。不过 Astra 同时加上了限定:旧版有限的 alpha_implied 确实影响了 C 组 27 个常数成本案例,因此也不能概括成“完全没有影响结果”。
所以三轮下来,V4.1 Flash 给出实现和解释,Astra 用论文、代码和实验提出质疑;V4.1 Flash 再逐条回应,Astra 继续复核。
最终裁决这些争议的材料,始终还是论文原文、实际代码、可以执行的测试和能够复现的实验结果。
实验边界
最后,说明下这次实验的边界。我们复现的是 LibraSpec 算法 1 的核心推测长度选择,使用模拟置信度分布,并设置 q=p。
这里没有运行真实大语言模型,也没有搭建完整的基于扩散模型的推测解码系统,也没有尝试复现论文报告的端到端性能结果。
因此,这次实验不能用来评价 LibraSpec 在真实模型上的实际性能,也不能根据一个案例概括 V4.1 Flash 在所有论文复现任务中的表现。
它只做这件事:在这一次从论文到代码的任务里,V4.1 Flash 把核心算法主体写了出来;三轮外部 Review 没有推翻这份核心实现,却连续修正了围绕它建立的实验、统计和解释体系。
顺便看了一眼 Harness 统计:
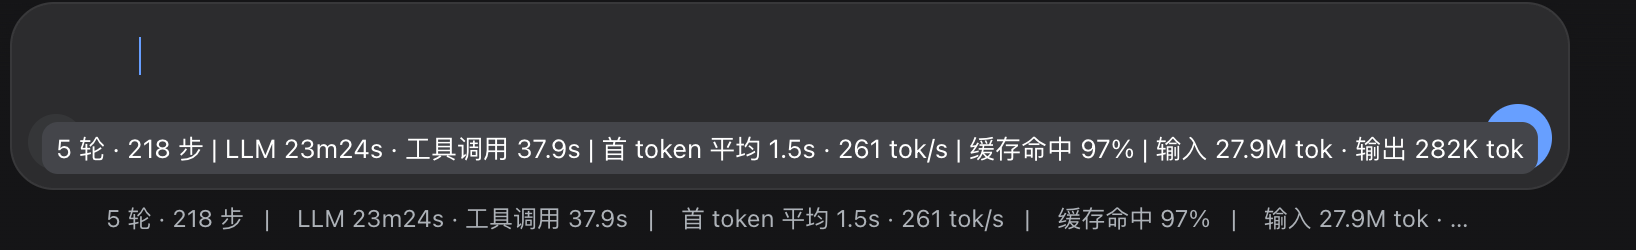
累计跑到 5 轮、218 步时,输入达到 2,790 万 token,输出 28.2 万 token。这次 Battle 到这里结束。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号