Hermes Agent 记忆系统:AI 老忘事?搞懂 4 层记忆,效率翻倍

Hermes Agent 记忆系统:AI 老忘事?搞懂 4 层记忆,效率翻倍

用户12724357
发布于 2026-09-15 18:59:10
发布于 2026-09-15 18:59:10
最近我使用Hermes Agent,叫它重复做一件事情,让它记住我的偏好和习惯。过一段时间发现它又糊里糊涂,老是做错,又让我从头说一遍。
这不是 AI 笨,而是大多数 AI 助手的"记忆"设计就没考虑过长期对话的需求。在我们长期使用Hermes Agent,不时会根据需要做一些不同的要求,它会把这些记忆下来,时间长了,做同一件事情,就会在记忆上发生一些分叉,会干扰Agent的判断,这时候我需要动手整理一下它的记忆。
为了弄清楚Hermes Agent的记忆系统,我直接和它聊了聊。它有一套完整的四层记忆架构,从短期会话到长期知识,从本地存储到外部同步,每一层都有明确的分工。今天这篇文章,带你彻底搞懂这套系统,让你知道哪些数据存哪、为什么这么存、怎么让它记住更多有用的东西。
Hermes Agent 四层记忆架构 Layer 1: 持久化文件 MEMORY.md + USER.md Layer 2: 会话数据库 state.db (SQLite + FTS5) Layer 3: 技能库 SKILL.md × 73 个技能 Layer 4: 外部 Provider 可选(当前未启用) 数据流向 启动注入 检索触发 扩展能力 对话开始 → 加载 Layer 1 对话中 → 写入 Layer 2 检索 → 搜索 Layer 2 技能 → 匹配 Layer 3 同步 → 可选 Layer 4 会话结束 → Layer 2 保留
Layer 1:持久化文件记忆——Agent 的"长期记忆"
这是最基础的一层,也是你最容易理解的一层。它就是Agent主文件夹里两个 Markdown 文件:
MEMORY.md——存"Agent 知道的事实",比如:
· 模型配置(用的是哪个 AI 模型、API 地址在哪)
· 硬件环境(你的电脑是什么配置、有什么限制)
· 工具使用经验(哪些命令好用、哪些会踩坑)
USER.md——存"关于你的信息",比如:
· 你是谁(名字、身份、职业)
· 你的偏好(喜欢简洁还是详细、喜欢中文还是英文)
· 你的硬件历史(之前用过什么设备、现在用什么)
· 硬性规则(比如"禁止替用户做决定")
这两个文件用 § 符号分隔,每个 § 是一个独立的记忆条目。这样设计的好处是:想删哪条就删哪条,不用动整个文件。
但有个问题你可能已经发现了——这两个文件有容量上限:
文件 | 容量上限 | 当前使用 | 使用率 |
|---|---|---|---|
MEMORY.md | 2,200 字符 | 1,898 字符 | 86.3% |
USER.md | 1,375 字符 | 1,167 字符 | 84.9% |
为什么要设上限?因为这两个文件的内容会在每次对话开始时注入到系统提示词中。如果文件太大,会挤占对话的上下文空间——AI 能记住的东西就少了。
所以,Layer 1 的设计哲学是只存真正重要的长期知识。那些一次性的对话细节、临时的工作进度,都不应该放在这里。
Layer 2:会话数据库——Agent 的"工作记忆"
如果说 Layer 1 是长期记忆,那 Layer 2 就是短期工作记忆——记录每一次对话的完整过程。
它存在一个 SQLite 数据库文件里:state.db。我查了一下当前系统的实际数据:
指标 | 数值 |
|---|---|
总会话数 | 274 个 |
总消息数 | 21,689 条 |
来源分布 | 飞书 194 / CLI 50 / Cron 30 |
模型分布 | MiniMax 154 / GLM 101 / SenseNova 16 / 其他 3 |
数据库里有三个核心表:
sessions 表——记录每个会话的元数据(ID、来源、模型、标题、开始/结束时间)。
messages 表——记录每条消息的内容(谁说的、说了什么、调了什么工具、工具返回了什么)。
messages_fts 表——这是 SQLite 的FTS5 全文搜索引擎,让你可以用关键词搜索过去的对话。
怎么用?比如你想找回之前讨论过的"公众号算法"相关内容,只需要问hermes:
session_search"公众号 算法"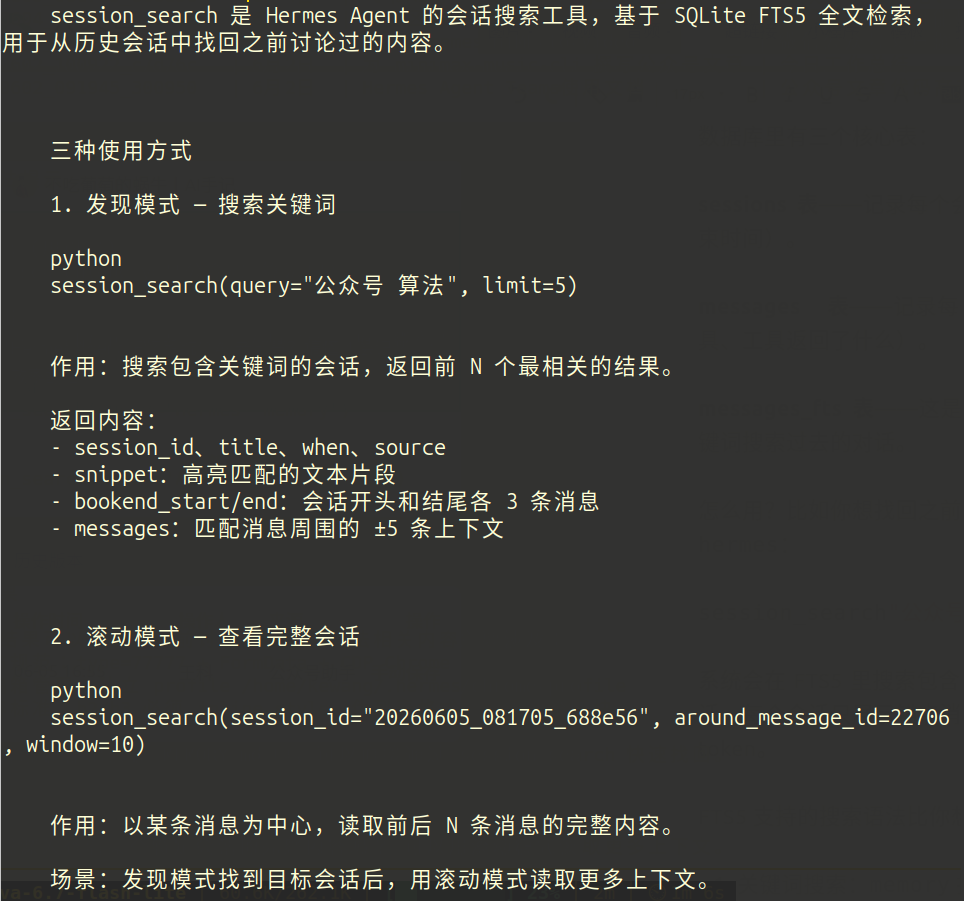
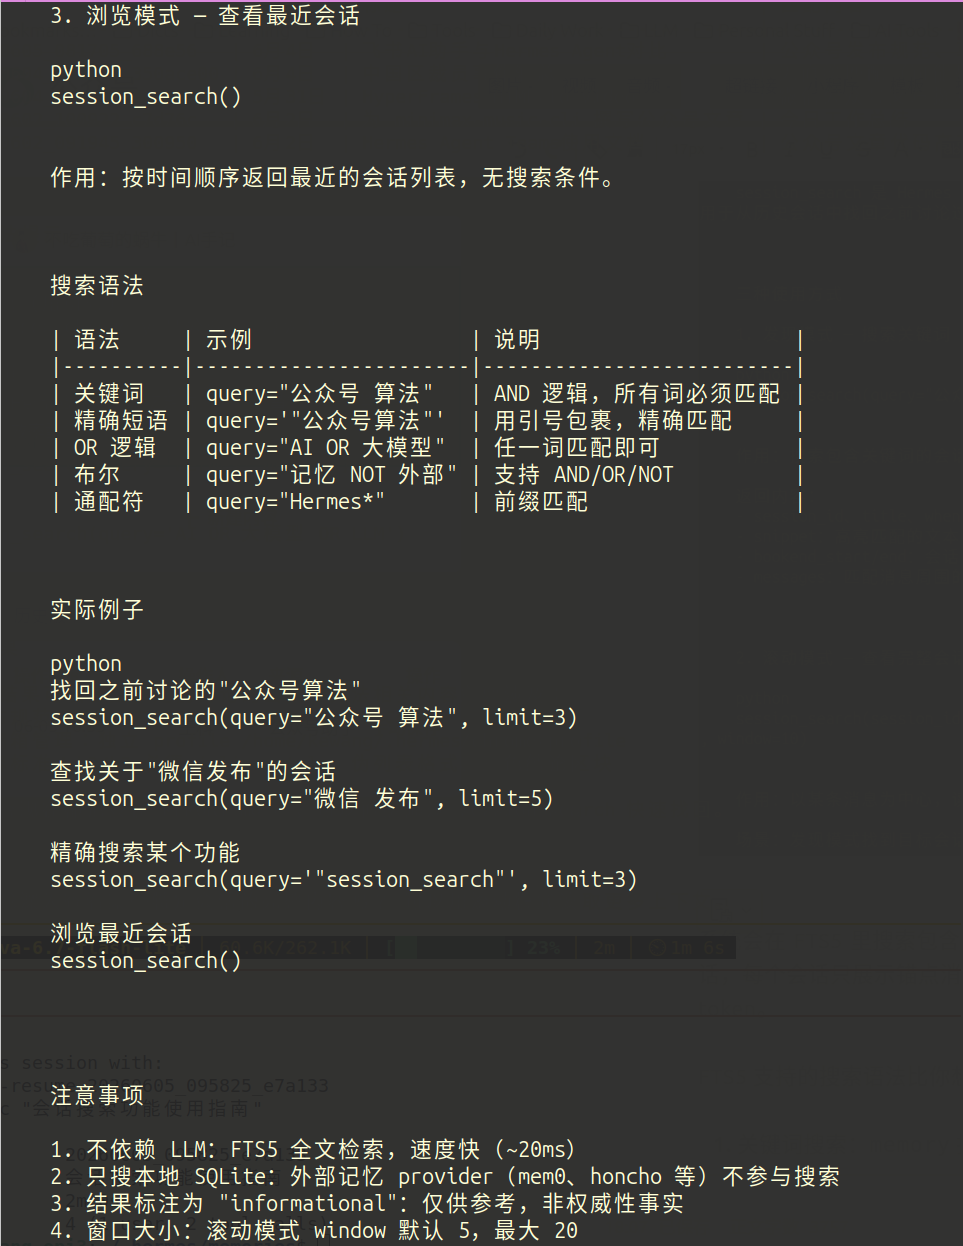
系统会在 FTS5 里搜索包含"公众号"和"算法"的会话,返回最相关的 3 个会话,每个会话只展示锚点消息 ±5 条的窗口——不是加载整个会话,节省 token。
FTS5 支持的搜索语法比你想的强:
1. 关键词搜索:memory 找到所有含 memory 的会话
2. 短语精确匹配:"session search" 只匹配这两个词连在一起的情况
3. 布尔搜索:memory AND skill 找到同时含两个词的会话
4. 通配符搜索:skill* 匹配 skill、skills、skilling 等
Layer 2 的设计哲学是会话隔离 + 滚动窗口。每个会话独立存储,搜索时只返回相关片段,不是加载整个历史。这样既保证了可追溯性,又控制了 token 消耗。
⚠️ v0.15 的记忆系统变更
本文描述的 4 层架构是 Hermes Agent 的基础设计,在 v0.15 之前就已存在。v0.15("The Velocity Release")在记忆系统方面的实际变更是:
变更项 | v0.14 | v0.15 |
|---|---|---|
session_search 延迟 | ~90 秒 | ~20 毫秒(4,500 倍提升) |
session_search 实现 | 依赖辅助 LLM | 无 LLM,纯 FTS5 搜索 |
检索记忆标注 | 未标注 | 标注为"informational"(信息性),非权威性 |
run_agent.py 大小 | 16,083 行 | 3,821 行(-76%) |
函数调用次数(31 轮对话) | 399,000 | 213,000(-47%) |
冷启动(--version) | 701ms | 258ms(-63%) |
核心架构未变:
· Layer 1(MEMORY.md + USER.md):扁平文本文件,字符限制,分隔符条目 — 未变
· Layer 2(state.db SQLite + FTS5):会话数据库 — FTS5 搜索性能大幅优化
· Layer 3(技能库):SKILL.md 集合 — 未变
· Layer 4(外部 Provider):可选 — 未变
未来方向:结构化记忆系统
GitHub Issue #346 提出了"结构化记忆系统"(Structured Memory System)的规划,但尚未在 v0.15 中实现:
· 8 种类型记忆节点——区分事实、偏好、技能、会话等不同类型
· 6 种图边类型——表达记忆之间的关系(包含、依赖、替代等)
· 混合向量 + FTS + 图搜索——语义搜索 + 关键词搜索 + 关系遍历
· 重要性衰减——自动降低过时记忆的重要性
· 记忆公告板——定期知识合成注入所有对话
如果你期待更强大的记忆系统,可以关注这个 Issue 的进展。但目前的扁平文本 + FTS5 方案已经足够应对大多数场景。
Layer 3:技能库——Agent 的"程序化知识"
如果说 Layer 1 存的是"事实",Layer 2 存的是"对话",那 Layer 3 存的就是"怎么做某事"。
技能(Skill)是一个可复用的工作流程,每个技能都有一个 SKILL.md 文件,里面写着:
· 这个技能什么时候触发(触发词)
· 具体操作步骤(编号步骤)
· 常见错误和避坑指南
· 验证步骤(怎么确认做对了)
我当前系统有 73 个技能,其中商汤数据智能团队的 sn-da-* 系列占了 11 个,覆盖了深度研究、Excel 分析、报告生成等复杂工作流。
技能是怎么被触发的?靠触发词匹配。比如:
· 你说"深度研究一下 XXX" → 触发 sn-deep-research
· 你说"帮我配置 Hermes" → 触发 hermes-agent
技能的设计哲学是把经验固化为可复用的流程。第一次做某件事可能需要 10 次尝试,做成技能后,下次直接调用,一步到位。
Layer 4:外部记忆 Provider——可选的"云同步"
这是可选的一层,我的系统未启用。
如果你需要在多台设备之间同步记忆,或者想让记忆存到云端而不是本地文件,可以配置外部 Provider。可选的有:
· honcho、mem0、hindsight、holographic、retaildb、byterover、supermemory、openviking
但要注意一个已知缺陷:外部 Provider 不参与 session_search 查询。也就是说,你用关键词搜过去的对话,搜到的永远是本地 SQLite 里的内容,不是外部 Provider 的。
所以,如果你主要用 session_search 来追溯历史,那 Layer 4 对你来说意义不大。它更适合需要跨设备同步记忆的场景。
四层如何协同工作
理解了每一层存什么,接下来看它们是怎么配合的。整个流程是这样的:
对话开始 加载 MEMORY.md 对话进行中 写入 state.db 需要知识检索 session_search / 技能匹配 每 6 条消息 触发 memory flush 每 10 轮对话 触发 memory nudge 会话结束 关键机制 flush_min_turns = 6 nudge_interval = 10 记忆写入非实时
几个关键机制你可能不知道:
memory flush(每 6 条消息)——不是每次对话都立刻写入记忆文件,而是攒够 6 条消息再批量写入。这样减少文件 I/O 次数,也避免把临时对话都存进去。
memory nudge(每 10 轮)——Agent 会主动提醒你:"嘿,这次对话里有些新东西值得记住,要不要存到 MEMORY.md 里?" 这是让你来决定什么该长期保存,而不是 AI 自己决定。
记忆修改机制——用 memory add、memory replace、memory remove 命令来增删改记忆条目。这些命令用子串匹配来定位条目,所以写的时候要注意唯一性——如果匹配到两条以上的条目,会报错让你重新指定。
当前系统的实际问题与修复
今天这篇文章不仅是理论讲解,我还实际检查并修复了当前系统的记忆文件。以下是发现的问题和修复方案:
问题 1:MEMORY.md 和 USER.md 都超容量上限
修复前:
文件 | 容量上限 | 修复前 | 使用率 |
|---|---|---|---|
MEMORY.md | 2,200 字符 | 3,494 字符 | 159% ⚠️ |
USER.md | 1,375 字符 | 2,106 字符 | 153% ⚠️ |
问题出在哪里?主要是重复条目:
· 模型信息在 MEMORY.md 里出现了 3 次(第 1 行、第 9 行、第 17 行)
· 微信发布规则出现了 2 次(第 20 行、第 34 行)
· MiniMax Token Plan 出现了 2 次(第 26 行、第 30 行)
· 用户身份在 USER.md 里出现了 3 次(第 1 行、第 13 行、第 19 行)
· RTX 4090 硬件信息出现了 3 次
修复后:
文件 | 容量上限 | 修复后 | 使用率 |
|---|---|---|---|
MEMORY.md | 2,200 字符 | 1,898 字符 | 86.3% ✅ |
USER.md | 1,375 字符 | 1,167 字符 | 84.9% ✅ |
修复方法:合并重复条目、精简冗余描述、删除外部知识(如 DeepSeek 第三方 Agent 信息,这不是系统事实)。现在两个文件都有约 15% 的余量,可以安全添加新条目。
问题 2:Layer 2 与 Layer 4 割裂
这是一个已知设计限制:session_search 只搜索本地 SQLite,不搜索外部 Provider。短期无改进计划。如果你依赖关键词搜索追溯历史,那当前设计已经够用。
知道这些,对你有什么用?
认知层面:AI 不是"忘了你",而是记忆系统有分层设计。短期对话存在 Layer 2(会话数据库),长期知识存在 Layer 1(记忆文件)。如果你发现 AI 不记得某件事,先判断这件事应该属于哪一层——如果是长期偏好,检查 MEMORY.md/USER.md 有没有存;如果是临时对话,用 session_search 搜一下。
能力层面:学会管理你的记忆文件。定期清理 MEMORY.md 和 USER.md 中的重复条目,保持容量在 80% 以内。用 memory add 主动存下重要的新发现,用 memory remove 清理过时的信息。让记忆文件真正成为你的"第二大脑",而不是越积越多的垃圾场。
判断层面:不要把所有东西都存进记忆文件。记忆文件有容量上限,而且每次对话都要注入到系统提示词中。只存真正重要的、跨会话反复用到的知识。临时的、一次性的、可能很快过时的信息,让它们留在 Layer 2(会话数据库)里就好——需要的时候用 session_search 搜出来,不需要的时候让它自然沉淀。
欢迎交流与转载,注明出处即可。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-06-05,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号