改了3行配置,我的Claude Code Token消耗降了75%

改了3行配置,我的Claude Code Token消耗降了75%

用户12724357
发布于 2026-09-15 19:08:45
发布于 2026-09-15 19:08:45
一个月烧掉5亿Token,我打开账单一看,97%的钱花在了最贵的模型上
Claude Code 是目前最强的终端 AI 编程工具。不过Anthropic的大模型不叫咱用,我也用不起。
我的方案是接智谱 GLM 模型替代,价格只有原来的七分之一。这两天我打开 Token 用量一看——517M Token,其中 97% 全部打在了最贵的 GLM-5.2 上。
问题出在哪?三行配置改完,成本直降 75%。下面是我的完整的诊断过程和优化方案。
先看账单:5亿Token花在了哪

我拉了一下智谱 Coding Plan 后台近一个月的 Token 消耗数据,结果触目惊心:
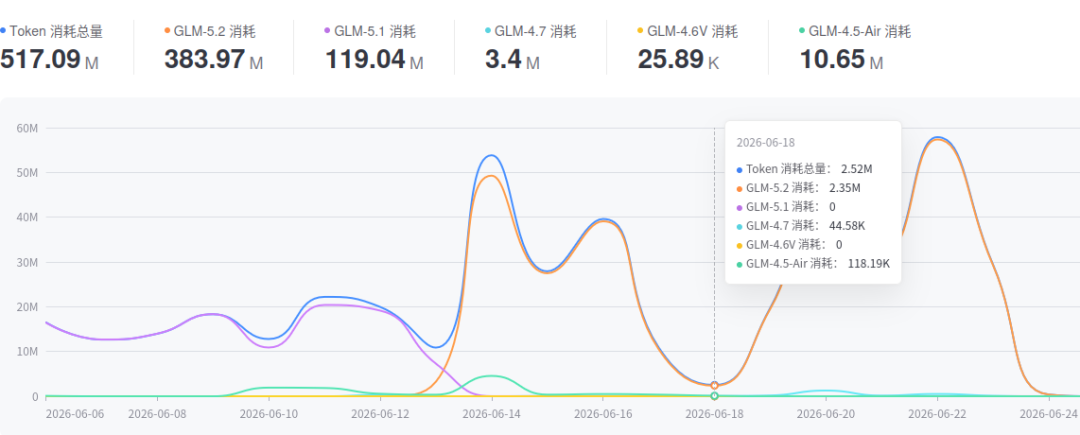
GLM-5.2:383.97M Token,占比 74.3%
GLM-5.1:119.04M Token,占比 23.0%
GLM-4.5-Air:10.65M Token,占比 2.1%
GLM-4.7:3.4M Token,占比 0.7%
GLM-4.6V:25.89K Token,几乎为零
总计 517.09M Token。翻译一下:97% 的 Token 烧在了最贵的两个旗舰模型上(GLM-5.2 和 GLM-5.1),而便宜模型和免费模型的占比加起来只有 2.8%。
虽然我用的是智谱的Token Plan,但是浪费是可耻的。
我用了最高级架构师干所有活,包括写周报、整理文档、跑测试;而实习生和免费劳动力坐冷板凳。问题不在模型贵,而在没有做分层路由。这就导致我时不时活干到一半的时候,就告诉我达到5小时用量上限了,只好停下来。

根因:三行配置消灭了分层
Claude Code 内部有三个模型角色:
Opus(最难的推理、架构设计,占调用量约 10%)
Sonnet(日常编码主力,工具调用、文件读写,占约 90%)
Haiku(后台杂活:git diff 解析、文件摘要、命令描述)
我原来的配置是这样的:
ANTHROPIC_MODEL="glm-5.2[1m]"
ANTHROPIC_DEFAULT_SONNET_MODEL="glm-5.2[1m]"
ANTHROPIC_DEFAULT_OPUS_MODEL="glm-5.2[1m]"
CLAUDE_CODE_AUTO_COMPACT_WINDOW="1000000"
问题就在这,Opus、Sonnet、默认主模型,三个角色全映射到了同一个 GLM-5.2[1m]。Claude Code 内置的分层路由机制——用 Opus 做规划、用 Sonnet 做执行——完全失效了。两边是同一个模型,分层等于没做。
更要命的是 [1m] 后缀。GLM-5.2 的定价分两档:上下文 < 32K 时输入 ¥6/M、输出 ¥24/M;上下文 ≥ 32K 时输入 ¥8/M、输出 ¥28/M。[1m] 意味着每次请求都按高价档计费,即使你的对话只有 5000 个 Token。
还有那个 AUTO_COMPACT_WINDOW="1000000"。这意味着上下文要堆到接近 100 万 Token 才触发自动压缩。Agent 每次工具调用都要重发完整历史——上下文 50 万时,10 步循环就是 500 万 Token 级别的消耗。
三行改动,成本降75%
改动一:Sonnet 从 GLM-5.2[1m] 降到 GLM-4.7
这是省钱的绝对主力。Claude Code 90% 的调用走 Sonnet 档——日常编码、工具调用、文件读写,这些任务 GLM-4.7 完全够用。GLM-4.7 输入约 ¥2/M、输出约 ¥6/M,比 GLM-5.2[1m] 便宜 3-4 倍。
ANTHROPIC_DEFAULT_SONNET_MODEL="glm-4.7"改动二:Opus 保留 GLM-5.2,但去掉 [1m] 后缀
真正需要旗舰模型推理的复杂任务(架构设计、跨文件重构)只占 10%。这些留给 GLM-5.2,但去掉 [1m],让短上下文请求按便宜档计费。需要超长上下文时,临时用 /model 命令切换即可。不用去考虑设置GLM-5.1, 自动路由到GLM-5.2了。
ANTHROPIC_DEFAULT_OPUS_MODEL="glm-5.2"改动三:Haiku 和 Subagent 换成 GLM-4.7-Flash(完全免费)
智谱有一个很多人不知道的福利:GLM-4.7-Flash 完全免费,200K 上下文,输入输出都不收钱。git diff 解析、文件摘要这些后台杂活走免费模型,等于零成本。
ANTHROPIC_DEFAULT_HAIKU_MODEL="glm-4.7-flash"
CLAUDE_CODE_SUBAGENT_MODEL="glm-4.7-flash"
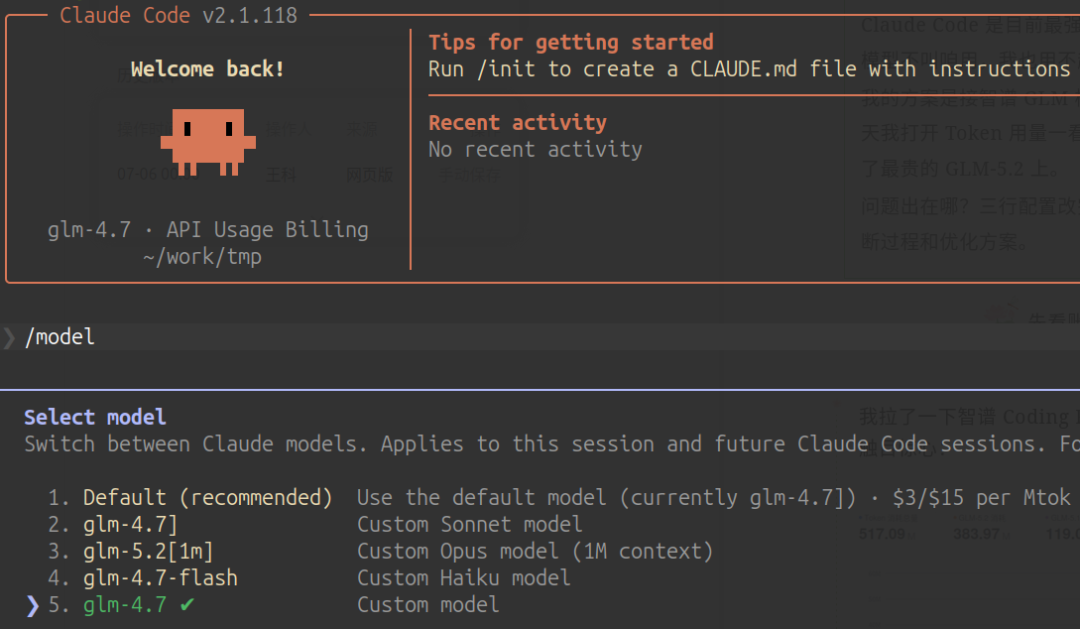
下面是我Claude Code使用质谱模型的配置:
隐形杀手:上下文滚雪球
模型分层之外,还有一个被忽视的隐形杀手:AUTO_COMPACT_WINDOW。原来设成 100 万,意味着 Agent 循环中上下文可以无限堆积。
理解这个问题,你需要知道 Agent 的一个本质特征:大模型是无状态的。为了让它记住你 5 分钟前说的话,系统必须把之前的对话历史、引用的代码文件、系统提示词全部打包,作为每一次的新 Input 重新发送。
假设每次工具调用让上下文增长 1 万 Token,50 步循环的累计输入量是 1+2+3+...+50 = 1275 万 Token。这不是线性增长,是 O(n²) 的二次方增长。
把压缩窗口从 100 万降到 15 万后,上下文到 15 万就触发自动压缩,回到 2-3 万。总输入量降到原来的 1/3 到 1/4。
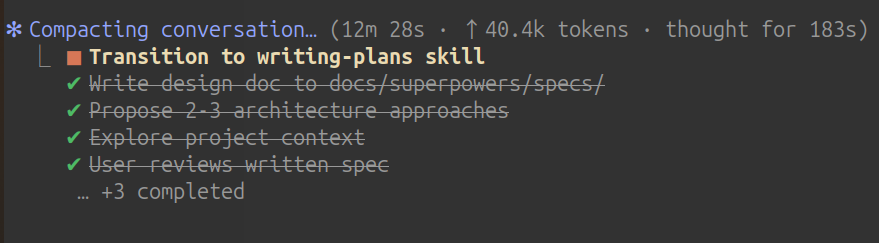
CLAUDE_CODE_AUTO_COMPACT_WINDOW="150000"这个参数在开发的时候已经生效了:
优化前后成本对比
按月消耗 517M Token 的使用习惯,假设 input:output = 7:3,流量分布 90% 走 Sonnet 档、10% 走 Opus 档:
优化前月成本(按量口径)约 ¥6,300。GLM-5.2 独占 ¥4,800,GLM-5.1 约 ¥1,500。
优化后月成本约 ¥1,638。GLM-5.2 降到 ¥650(只剩 Opus 档),GLM-4.7 约 ¥988,GLM-4.7-Flash 零成本。
综合省幅约 75%。三行配置改动,每月省下约 ¥4,600。
我用的是 Coding Plan 订阅制(按额度扣减),效果同样显著。GLM-5.2 按高峰期 3 倍系数扣额度。优化前 384M 的 5.2 消耗相当于 960M 额度;优化后 52M 的 5.2 加 380M 的 4.7(1 倍系数)只消耗 510M 额度。额度消耗降 47%,如果 之前 Pro 套餐不够用,优化后 我的Lite Coding plan 可能就够了,至少不会老是出现活干到一半,因为没有tokens可用,撂挑子。
结语
省 Token 的本质不是少用 AI,而是让贵的模型干难活,便宜的模型干杂活。
Claude Code的三层模型架构(Opus/Sonnet/Haiku)本身就是分层路由的设计,但如果你把三个角色全指向同一个旗舰模型,这个设计就形同虚设。
三个核心认知:
第一,90% 的日常编码不需要旗舰模型。GLM-4.7 在 SWE-bench 等基准测试中已经对齐 Claude Sonnet 4.5 水平,处理日常编码绰绰有余。
第二,Agent 的 Token 成本是 O(n²) 增长。上下文不压缩,50 步循环就是 1275 万 Token。AUTO_COMPACT_WINDOW 设成 15 万,是性价比最高的刹车。
第三,免费模型别浪费。GLM-4.7-Flash 完全免费、200K 上下文,后台杂活走它等于零成本。
工具好不好用,不光看你选了什么模型,更看你怎么分配它们。好钢用在刀刃上,省下来的都是利润。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-07-07,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号